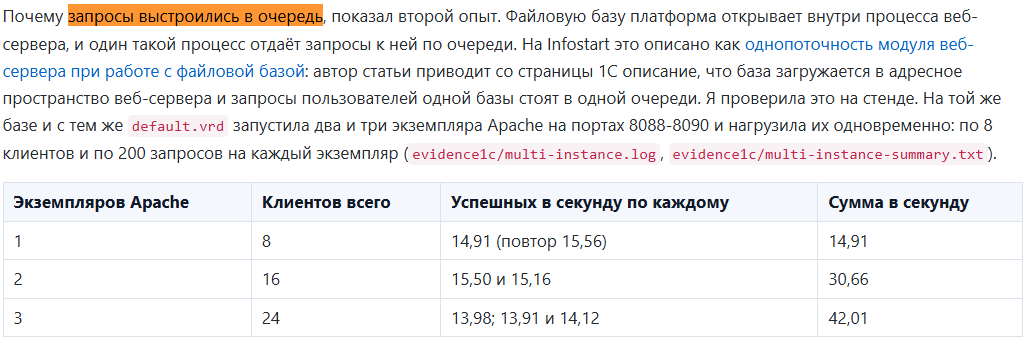
Сколько запросов в секунду выдержит HTTP-сервис 1С на файловой базе: проверила скриптом на Python
База данных - HighLoad оптимизация

Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Сколько запросов в секунду выдерживает HTTP-сервис 1С на файловой базе за Apache и как скрипт нагрузки отличает работу сервиса от потока ошибок: отдельный счёт успешных ответов, проверенные процентили и сравнение настоящего сервиса с учебным сервером.
- Число запросов в секунду вместе с ошибками растёт и от отказов: смотрите на успешные запросы в секунду.
- Учебный сервер на HTTPServer обслуживает соединения по одному, поэтому «5 потоков» на нём не параллельны.
- Файловая база за Apache на этом стенде отвечала по одному запросу: скорость не росла с числом клиентов.
- Процентили времени ответа проверяются на выборках с известным ответом, а не по наличию поля в результате.
Общее число запросов в секунду не отличает работу сервиса от потока ошибок; серия с растущим числом клиентов показывает потолок.
Для кого: разработчики и администраторы 1С, которые проверяют HTTP-сервисы под нагрузкой на тестовой базе.
Если к HTTP-сервису 1С обращаются сразу несколько программ, сколько запросов в секунду он успеет обработать? Обычно это проверяют так: запускают десять параллельных вызовов и смотрят на число «запросов в секунду». Такое число легко вводит в заблуждение: в него попадают и ошибки, а среднее время ответа прячет очередь. Для честной проверки хватает скрипта на стандартной библиотеке Python, если он отдельно считает успешные ответы, правильно считает процентили времени ответа и проверен на сервере, поведение которого известно заранее.
Я взяла архив из первого варианта этой статьи: скрипт нагрузки, учебный сервер для отладки и проверочный сценарий «3 из 3». Запустила его 22 октября 2026 года, нашла три недостатка и исправила. Потом опубликовала настоящий HTTP-сервис в файловой базе «Нано-УТ» (платформа 8.3.27.2130, веб-сервер Apache 2.4) и прогнала по нему ту же серию, что и по учебному серверу. Результат для файловой базы за Apache: запросы обрабатывались по одному, число запросов в секунду оставалось на месте при любом числе клиентов, а время ответа росло прямо пропорционально числу клиентов. Что из этого следует и чего не следует, написано ниже.
Стенд
| Условие | Значение |
|---|---|
| Дата | 22.10.2026 |
| Платформа | 1С:Предприятие 8.3.27.2130 (x86); база файловая, копия «Нано-УТ» с добавленным HTTP-сервисом |
| Веб-сервер | Apache 2.4.66 Win32 (сборка Apache Lounge), запущен обычным процессом без прав администратора, порт 8088. С 1С его связывает модуль веб-расширения wsap24.dll из каталога платформы |
| Python | 3.12.10, только стандартная библиотека |
| Компьютер | Intel Core i5-2400 3,1 ГГц (4 ядра, 2011 год), 7,9 ГБ ОЗУ, SSD Samsung 850 EVO (SATA), Windows 11 Pro 10.0.22631. Компьютер рабочий: во время прогонов были открыты браузер и приложение Claude |
| Клиент и сервер | На одной машине (127.0.0.1): скрипт нагрузки и Apache делят четыре ядра |
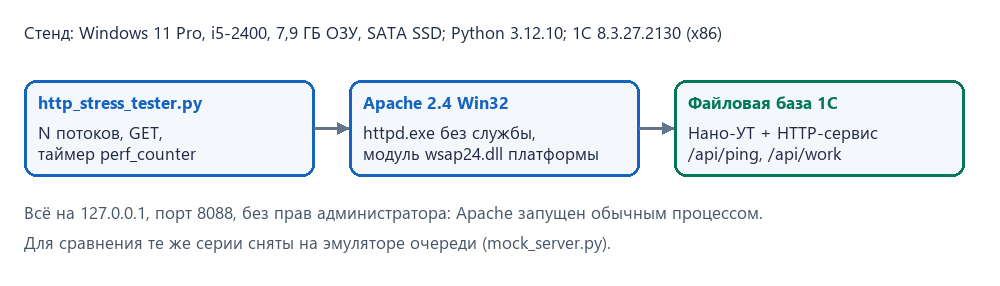
Времена в статье получены на старом процессоре, и клиент с сервером на нём конкурируют друг с другом. Прогоны можно сравнивать между собой, переносить миллисекунды на другое железо нельзя.
Что показал архив из первого варианта
Проверочный сценарий verify.py из первого варианта проходит:
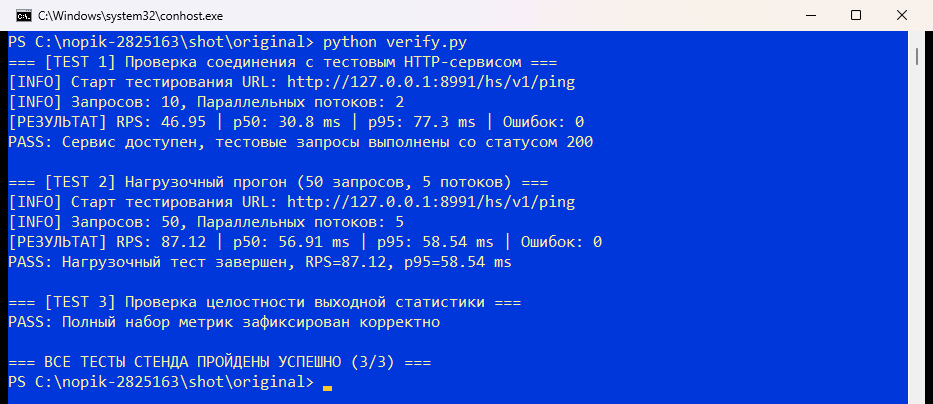
Три проверки подтверждают, что запросы выполнены и поля результата на месте. Учебный сервер при этом построен на HTTPServer из стандартной библиотеки, он обслуживает соединения по одному. Я проверила на сервере с потоками: при пяти параллельных клиентах исходный сервер отдаёт 83,6 запроса в секунду, ThreadingHTTPServer с тем же обработчиком - 381. Поэтому «50 запросов, 5 потоков» из сценария параллельной работы не дают. Число из журнала описывает однопоточный HTTPServer, платформа 1С к нему отношения не имеет.
Нашлись ещё два недостатка в самом скрипте нагрузки:
- Число запросов в секунду делилось на время вместе с ошибками. Против перегруженного сервера исходный скрипт показал 102,5 запроса в секунду и «Ошибок: 63» (журнал
logs/original-tester-on-saturated.log), но не сказал, какие это ответы: 504 от очереди, обрыв клиента или что-то иное. Читать такую строку как пропускную способность нельзя. - Процентиль времени ответа считался как
latencies[int(len(latencies) * 0.95)]. На выборке из 100 значений это 96-е значение вместо 95-го, и в сценарии нет ни одной проверки на выборке с известным ответом.
Скрипт нагрузки
Один вызов возвращает код ответа, время ответа и текст ошибки. Время включает чтение тела: без response.read() время до конца ответа не попадает в замер.
Код 0 означает сетевую ошибку или таймаут клиента, код 504 приходит от сервера. Они попадают в разные строки распределения статусов, и по ним видно, кто оборвал вызов.
Серия вызовов запускается пулом потоков. Результат считается отдельно по всем ответам (rps) и только по ответам 200 (rps_ok), то есть «запросов в секунду» и «успешных запросов в секунду»:
Процентили времени ответа
Процентиль считается по методу ближайшего ранга: берётся значение с номером ceil(q / 100 * n) в отсортированной выборке.
Проверка в verify.py берёт выборки, ответ на которых известен без программы: для чисел от 1 до 10 время у половины запросов (медиана, в таблицах «p50») равно 5, а 95-й и 99-й процентили равны 10; для чисел от 1 до 100 они равны 95 и 99. Медиана показывает типичное время ответа, 95-й и 99-й процентили показывают хвост, который теряется в среднем. Когда медиана стоит на месте, а хвост уходит вверх, часть запросов ждёт чего-то общего: очереди или блокировки.
Учебный сервер с очередью
Учебный сервер mock_server.py я переписала на ThreadingHTTPServer. Он повторяет только устройство очереди и настоящим сервером 1С не является. У него три параметра: время обработки одного запроса, число одновременно работающих обработчиков (пул обработчиков) и сколько запрос ждёт в очереди до ответа 504. Число обработчиков ограничивает семафор.
Учебный сервер нужен там, где настоящего сервиса нет или нужен повторяемый опыт. Серия на нём: четыре обработчика по 50 мс на запрос, очередь 200 мс, по 200 запросов на каждое число клиентов.

| Клиентов | Запросов в секунду | Успешных в секунду | Время ответа у половины запросов, мс | Ответы |
|---|---|---|---|---|
| 1 | 16,59 | 16,59 | 52,5 | 200: 200 |
| 2 | 35,87 | 35,87 | 52,6 | 200: 200 |
| 4 | 70,18 | 70,18 | 52,5 | 200: 200 |
| 8 | 78,31 | 78,31 | 101,3 | 200: 200 |
| 16 | 78,26 | 77,09 | 203,1 | 200: 197, 504: 3 |
| 32 | 119,10 | 76,82 | 246,0 | 200: 129, 504: 71 |
Пока клиентов не больше, чем обработчиков, скорость растёт почти линейно. На 8 клиентах все обработчики заняты: успешных запросов около 78 в секунду (предел четырёх обработчиков по 50 мс - 80). На 32 клиентах общее число запросов в секунду выросло до 119, а успешных осталось 77: прирост дали 71 быстрый отказ. Исходный скрипт показал бы это как рост производительности.
HTTP-сервис 1С за Apache
Для настоящего замера я добавила в копию «Нано-УТ» (оригинал только читался, копия лежит вне OneDrive) HTTP-сервис «Нагрузка» с корневым адресом api и двумя шаблонами. GET /api/ping отвечает сразу. GET /api/work?ms=N&rows=K читает запросом до K элементов справочника Номенклатура, затем N миллисекунд занимает процессор циклом:
Цикл занимает процессор без пауз, поэтому 50 мс - полная занятость. Сервис добавляется в XML-выгрузку скриптом add_http_service.py, загружается командой /LoadConfigFromFiles с /UpdateDBCfg, проверка /CheckConfig -ExtendedModulesCheck -Server даёт «Ошибок не обнаружено».
Публикация обошлась без прав администратора. Утилита webinst попросила администратора для записи в настройки Apache, но каталог публикации и default.vrd создала. Остальное я написала сама: минимальный httpd.conf с подключением wsap24.dll и обработчиком 1c-application для адреса /nano, httpd.exe запускается обычным процессом. В default.vrd понадобился элемент <httpServices publishByDefault="true"/>. Вариант с атрибутом reuseSessions на уровне httpServices платформа отвергла: страница «1C:Enterprise 8 application error» с ошибкой XDTO. Скрипт run_stand1c.ps1 собирает настройки из шаблона и поднимает Apache. Архив Apache я скачала с сайта Apache Lounge и сверила SHA-256 с опубликованным там значением.
Серия прогонов на сервисе 1С
Сервис GET /api/work?ms=50&rows=2 (в базе два элемента справочника), по 200 запросов на каждое число клиентов, те же числа, что на учебном сервере:
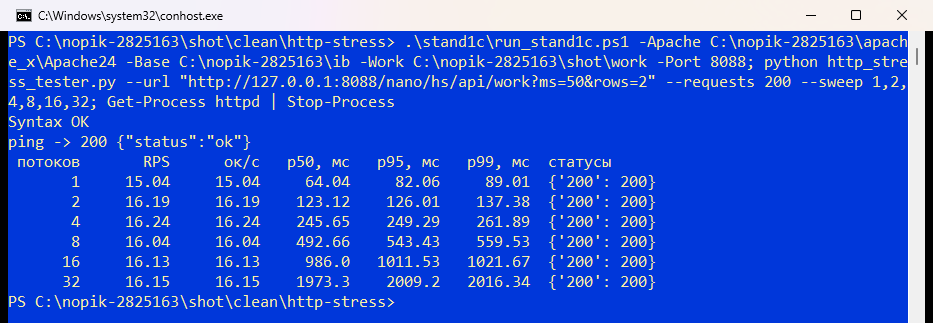
Сравнение с учебным сервером на один обработчик (--workers 1 --delay-ms 50, очередь 10 с, чтобы ответы 504 не появлялись):
| Клиентов | 1С: успешных в секунду | 1С: время ответа у половины запросов, мс | Учебный сервер, 1 обработчик: в секунду | Учебный сервер: время, мс |
|---|---|---|---|---|
| 1 | 15,04 | 64,0 | 13,03 | 52,4 |
| 2 | 16,19 | 123,1 | 19,36 | 101,4 |
| 4 | 16,24 | 245,7 | 19,63 | 202,6 |
| 8 | 16,04 | 492,7 | 19,59 | 405,4 |
| 16 | 16,13 | 986,0 | 19,37 | 813,4 |
| 32 | 16,15 | 1973,3 | 19,65 | 1622,9 |
На сервисе 1С скорость осталась в пределах 15-16,3 запроса в секунду при любом числе клиентов, а время ответа у половины запросов выросло почти ровно во столько раз, во сколько выросло число клиентов: 64 мс при одном клиенте, около 1973 мс (почти 2 секунды) при 32. Запросы обрабатывались по одному. Ответов 504 не было: клиентский таймаут в 10 с не достигнут (у 99 процентов запросов время ответа при 32 клиентах не превышало 2,0 с), Apache в моей настройке ничего не обрывает. Форму кривой повторяет учебный сервер с одним обработчиком, цифры отличаются примерно на 20 процентов: у настоящего сервиса запрос длиннее 50 мс примерно на 14 мс, а клиент на старом процессоре мешает серверу. На /api/ping без работы картина та же: от 69 до 91 запроса в секунду при любом числе клиентов, время ответа у половины запросов от 12 мс при одном клиенте до 355 мс при 32 (evidence1c/sweep-ping.log).
Почему запросы выстроились в очередь, показал второй опыт. Файловую базу платформа открывает внутри процесса веб-сервера, и один такой процесс отдаёт запросы к ней по очереди. На Infostart это описано как однопоточность модуля веб-сервера при работе с файловой базой: автор статьи приводит со страницы 1С описание, что база загружается в адресное пространство веб-сервера и запросы пользователей одной базы стоят в одной очереди. Я проверила это на стенде. На той же базе и с тем же default.vrd запустила два и три экземпляра Apache на портах 8088-8090 и нагрузила их одновременно: по 8 клиентов и по 200 запросов на каждый экземпляр (evidence1c/multi-instance.log, evidence1c/multi-instance-summary.txt).
| Экземпляров Apache | Клиентов всего | Успешных в секунду по каждому | Сумма в секунду |
|---|---|---|---|
| 1 | 8 | 14,91 (повтор 15,56) | 14,91 |
| 2 | 16 | 15,50 и 15,16 | 30,66 |
| 3 | 24 | 13,98; 13,91 и 14,12 | 42,01 |
Каждый экземпляр по-прежнему отдаёт 14-15,5 запроса в секунду, а сумма растёт вместе с их числом: два экземпляра дали вдвое больше одного, три - в 2,8 раза. Третий прибавил меньше второго, потому что цикл на 50 мс держит ядро занятым, а у процессора четыре ядра, и клиенты работали на том же компьютере. Значит, очередь возникает внутри одного процесса веб-сервера: база, сеть и скрипт нагрузки с этим одинаково справлялись при любом числе экземпляров. Элемент service с poolSize="10" в default.vrd картину не изменил (evidence1c/sweep-work-pool.log): ограничение не лежит в настройках публикации. Вывод относится к файловой базе: запись в базу из нескольких экземпляров в опыте не выполнялась, клиент-серверную базу с кластером серверов 1С я не измеряла и выводов для неё не делаю. Скрипт с отдельным счётом успешных ответов и медианой показывает такую картину за несколько минут, а число запросов в секунду на одном процессе веб-сервера можно поднять только запуском нескольких процессов.
Проверка скрипта
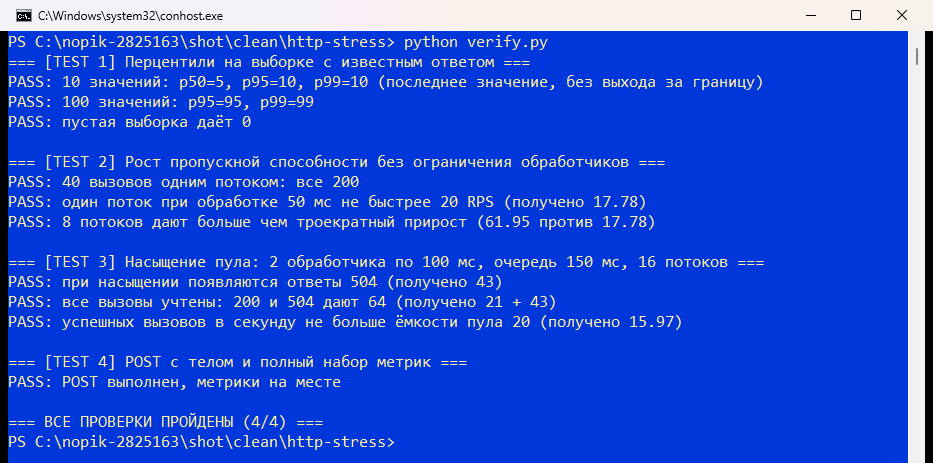
Исправленный verify.py содержит четыре проверки с известными ответами: процентили, рост скорости между одним и восемью клиентами (больше чем втрое), перегрузка пула с ответами 504 и потолок успешных запросов, POST с телом и полный набор показателей.
Что не проверено
Не проверялись: клиент-серверная база и кластер серверов 1С, IIS, Linux, другие версии платформы и Python, серии больше 32 клиентов, запись в базу из HTTP-сервиса и из нескольких экземпляров Apache сразу. Всё, что в первом варианте статьи говорилось про устройство кластера, настройки таймаутов веб-сервера, события технологического журнала и кэш, я убрала: чисел для этих утверждений у меня нет. Выводы о файловой базе за Apache не переносятся на рабочую базу.
Итог
- Сценарий «3 из 3» из первого варианта проходил, но параллельность не проверял: учебный сервер обслуживал соединения по одному, а число запросов в секунду считалось вместе с ошибками.
- В исправленной версии есть отдельный счёт успешных ответов, процентили по ближайшему рангу с проверкой на известных выборках и учебный сервер с ограниченным числом обработчиков.
- На настоящем HTTP-сервисе в файловой базе за Apache запросы шли по одному: 15-16 в секунду при любом числе клиентов, время ответа растёт пропорционально числу клиентов. Причина в том, что один процесс веб-сервера обслуживает файловую базу по очереди: два экземпляра Apache на той же базе дали 30,7 запроса в секунду, три - 42,0.
- Учебный сервер с одним обработчиком повторяет эту кривую; с четырьмя обработчиками он показывает другой случай: перегрузку с ответами 504.
Источники
- «Решение проблемы однопоточности модуля веб-сервера при работе с файловой базой», Infostart - описание однопоточности модуля веб-сервера для файловой базы и обхода несколькими экземплярами Apache (страницу открыла, прочитала вступление и описание скрипта; скрипт из статьи не запускала).
- Apache HTTP Server для Windows, сборки Apache Lounge: https://www.apachelounge.com/download/ - архив
httpd-2.4.66-251206-win32-vs17.zip, SHA-256 сверена с опубликованной на сайте. - Документация Python: модули
concurrent.futures,http.server,urllib.request,threading(https://docs.python.org/3/library/).
Файл к статье
Архив http-stress-companion.zip, версия 3 от 22.10.2026: скрипт нагрузки http_stress_tester.py, учебный сервер mock_server.py, проверка verify.py, README.md, папка stand1c (добавление HTTP-сервиса в конфигурацию, выгрузка сервиса, default.vrd, шаблон настроек Apache, run_stand1c.ps1) и папки evidence, evidence1c с журналами прогонов и журналами окон консоли, с которых сняты рисунки. python verify.py запускается на любой системе с Python 3.9+. Тест 2 в нём измеряет время и на загруженной машине может упасть: тогда повторите прогон, один провал этого теста не означает ошибку в скрипте. Для стенда с 1С нужны Windows, платформа 8.3 и Apache из Apache Lounge, порядок описан в README. Направляйте нагрузку на тестовую базу, не на рабочую.

Вступайте в нашу телеграмм-группу Инфостарт