Шпаргалка для ИИ: проверяем ответы о конфигурации 1С по общей базе знаний
Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Разработчики команды проекта задают ИИ-помощнику вопросы о своей конфигурации 1С: какие реквизиты у документа, какая процедура записывает движения, как в команде принято проводить документ. Без контекста модель отвечает тем, что обычно встречается в типовых конфигурациях, и называет объекты, которых в конфигурации нет. Размер контекста не позволяет передать помощнику всю выгрузку; подбирать нужные фрагменты вручную перед каждым вопросом команда не будет. Для этого я написала kb_pack.py: он собирает из выгрузки конфигурации и коротких правил команды общую базу знаний, разбитую на куски с указанием файла и строки, и под каждый вопрос подбирает несколько кусков в готовый запрос. Он же отправляет запрос модели, проверяет полноту базы и пересобирает её после новой выгрузки.
Общая база знаний команды для ИИ-помощника - это куски выгрузки конфигурации и короткие правила, которые подставляются в запрос под каждый вопрос. Её собирает скрипт из выгрузки, и вся команда пользуется одним источником. Чтобы база не отставала от конфигурации, её пересобирают после каждой выгрузки.
- Без базы модель отвечает на вопросы о конфигурации проекта правдоподобно и неверно: из 25 ответов 17 содержали несуществующие имена, часто с оговоркой «обычно».
- С базой в ответах появились ссылки для проверки: все 108 ссылок «файл:строка» из ответов ведут на существующие файлы, и все строки в пределах файла.
- Правила команды по коду восстанавливаются не всегда: без них 5 из 7 вопросов о правилах получили отказ, с ними 6 из 7 верных ответов.
- Слабое место - подбор кусков. На одном вопросе поиск не выбрал нужную процедуру, и модель ошиблась во всех 10 запусках; для вопросов-перечней шести кусков недостаточно.
- Проверка базы показывает, где описания могут быть неполными: на УТ 11.5 у 12 396 экспортных процедур из 61 359 нет комментария над объявлением.
В этом опыте база из выгрузки и коротких правил команды подняла число верных ответов у обеих моделей. Одинаковые ли ответы получат все участники команды, я не проверяла. Пересобирать базу следует после каждой выгрузки, а качество проверять собственным набором вопросов с ключами.
Для кого: ведущие разработчики и руководители команд 1С, которые подключают ИИ-помощника к работе, и которым нужно, чтобы он отвечал по конфигурации проекта.
Что из конфигурации команды попало в обучающие данные моделей, неизвестно. Чтобы измерить влияние базы, я собрала её из выгрузки «Нано-УТ 2.0» и нескольких командных правил, задала двум моделям 25 вопросов с заранее записанными ответами, без базы и с ней, и подсчитала верные ответы и несуществующие имена в ответах.
Стенд
| Условие | Значение |
|---|---|
| Конфигурация | «Нано-УТ 2.0», учебная: из 293 файлов исходного каталога прочитаны 93, собрано 199 кусков базы; командных правил 8 в 3 файлах |
| Большая конфигурация | УТ 11.5.22.77, прочитано 13 945 файлов выгрузки, 87 927 кусков (только сборка и проверка базы) |
| Модели | openai/gpt-4o-mini и meta-llama/llama-3.3-70b-instruct через OpenRouter, температура 0 |
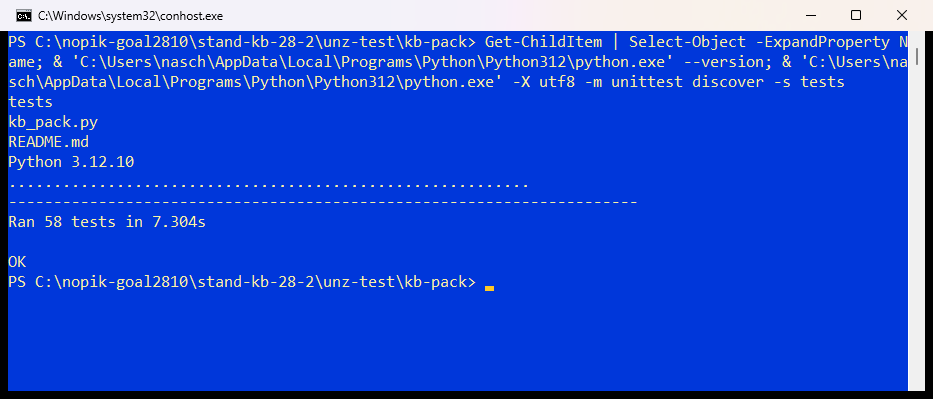
| Инструмент | kb_pack.py, Python 3.12.10, только стандартная библиотека |
| Компьютер | Windows 11 Pro, Intel Core i5-2400, 7,9 ГБ ОЗУ, SATA SSD |
Как устроена база
Дообучение модели не применялось: нужные куски знаний подставляются непосредственно в запрос. Способ проверен на двух моделях из таблицы выше; для остальных моделей результат не проверялся.
kb_pack.py build читает выгрузку конфигурации и каталог правил и раскладывает их на куски:
| Кусок | Откуда | Что в нём |
|---|---|---|
| объект | <Вид>/<Имя>.xml |
имя, синоним, реквизиты и табличные части с типами; у документа регистры движений, у регистра измерения и ресурсы |
| процедура | модули .bsl | сигнатура, комментарий над ней, какие общие модули вызывает, какие регистры упоминает, тексты исключений |
| правило | *.md команды |
один кусок на заголовок правила |
| связь | вычисляется при сборке | кто пишет движения в регистр, состав общего модуля |
Каждый кусок хранит свой файл и строку. По вопросу pack выбирает куски поиском BM25 с дополнительным весом точного имени и синонима и печатает готовый запрос: инструкция «отвечай только по кускам, после каждого утверждения укажи файл:строка, если ответа нет - так и скажи», затем куски, затем вопрос. Для build, pack и lint сеть не нужна. Готовый запрос можно передать любому помощнику вручную с учётом размера его контекста и правил работы с исходниками. Команда ask отправляет его в OpenRouter и сохраняет запрос с ответом в журнал.

pack: куски базы с источниками под вопрос разработчика
Опыт: 25 вопросов с ключом
Вопросы трёх видов. Про метаданные: «какие измерения и ресурсы у регистра ТоварыНаСкладах». Про код: «какая процедура записывает накопленные движения в регистры». Про правила команды: «как у нас принято записывать движения документа при проведении». Ключ к каждому вопросу, правильный ответ и файл со строкой, где это видно, я записала до первого запроса к модели и отдельно сверила с выгрузкой; такой порядок исключает подгонку ключа под полученный ответ.
Режим без базы: вопрос и фраза «это конфигурация 1С Нано-УТ». Режим с базой: вопрос, шесть кусков от pack и инструкции отвечать только по ним, указывать источники и отказываться, если ответа нет. Сравнивается совместный эффект кусков и этих инструкций: режима «те же инструкции без кусков» в опыте нет. Оценка скриптом по ключу: верно, частично, неверно, «не знаю». Ответом с несуществующим именем считается ответ, где названо имя объекта, реквизита, значения, регистра или процедуры, которого нет в выгрузке, даже с оговоркой «обычно». Определение строгое: такой ответ верным не засчитывается.
| Запуск | Верно | Частично | Неверно | «Не знаю» | С несуществующими именами |
|---|---|---|---|---|---|
| gpt-4o-mini без базы | 1 | 13 | 11 | 0 | 17 |
| gpt-4o-mini без базы, повтор | 1 | 11 | 13 | 0 | 18 |
| gpt-4o-mini с базой | 21 | 1 | 1 | 2 | 0 |
| gpt-4o-mini с базой, повтор | 21 | 1 | 1 | 2 | 0 |
| llama-3.3-70b без базы | 2 | 7 | 16 | 0 | 13 |
| llama-3.3-70b с базой | 20 | 2 | 1 | 2 | 0 |
Пример на одном вопросе. Про регистр ТоварыНаСкладах модель без базы перечислила Номенклатуру, Склад и «Партию, если это предусмотрено». Партии в этом регистре нет. С базой ответ уложился в две строки: измерения Склад и Номенклатура, ресурсы Количество и Стоимость, с типами и ссылкой на AccumulationRegisters/ТоварыНаСкладах.xml. Про запись движений модель без базы предположила процедуру ЗаписатьНакопленныеДвижения «или аналогичную». С базой назвала ДвиженияУчета.Записать и строку 24 общего модуля.
Ссылки в ответах с базой проверены отдельно. В трёх запусках их 108: файл существует у всех, строка в пределах файла у всех, 101 взята из кусков запроса. Разработчик может открыть указанное место и проверить утверждение. Однако существующий файл и правильный номер строки ещё не означают, что утверждение верно по смыслу. Время такой проверки я не измеряла.
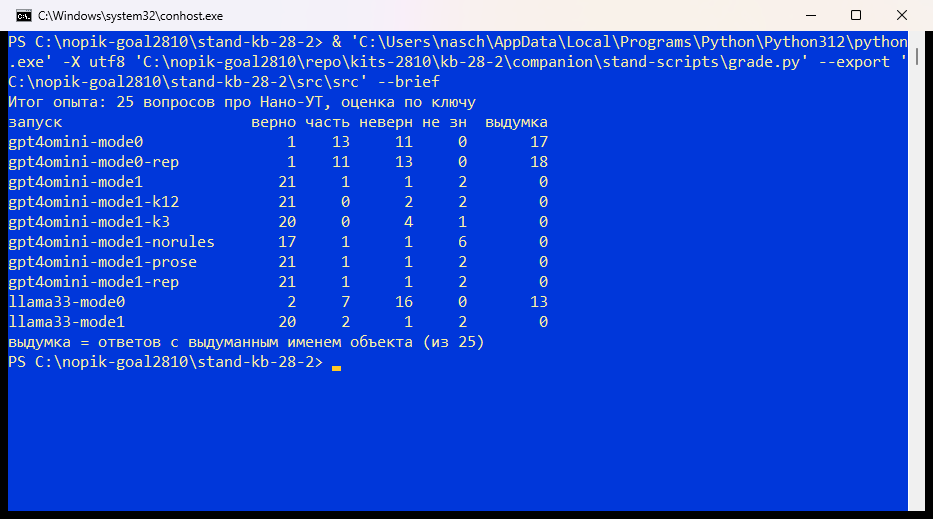
Сводка опыта: все запуски, оценка по ключу
Правила команды: чего нет в выгрузке
Семь вопросов из 25 касались командных правил: кто пишет движения документа, кто считает сумму документа, когда допустима нулевая цена, как устроен обработчик в форме. В выгрузке это видно только косвенно. Правила я записала коротко: заголовок, одно-три предложения, строка «Пример: файл:строка» на реальное место в коде, и каждое сверила с выгрузкой.
В базе без правил модель на 5 из 7 таких вопросов ответила, что в базе ответа нет, и 2 восстановила по коду. С правилами верных ответов 6 из 7. Дополнительно проверен вариант со сплошным текстом: заголовки и строки «Пример» убраны, сами правила оставлены. Верных ответов получено столько же, поэтому влияние одних заголовков этот вариант не изолирует. Разница в деталях: с заголовками ссылка в ответе ведёт на строку нужного правила, у сплошного текста всегда на первую строку файла, и проверка базы у сплошного текста находит правила без примера.
Где база не помогла
| Вопрос | Что произошло |
|---|---|
| какая процедура общего модуля применяет документ УстановкаЦен при пересчёте учёта | поиск не выбрал ЦеныУчет.Применить, модель назвала другую процедуру; неверно во всех 10 запусках |
| как у нас устроен обработчик в форме документа | поиск не нашёл правило о формах, модель с базой отказалась отвечать |
| сколько в конфигурации документов | во всех запусках с базой отказ: в шесть кусков список всех документов не помещается |
| перечислить все регистры накопления (их 8) | при шести кусках найдено 5 из 8, при двенадцати все 8 |
Промахи поиска из сохранённых запусков я оставила в отчёте без изменений. Число кусков на этом наборе меняло оценку слабо: при трёх кусках верных 20, при шести 21, при двенадцати 21. Нужный файл из ключа попал в первые шесть кусков в 16 вопросах из 25, а все группы слов ключа скрипт нашёл в тексте кусков в 22 из 25. Совпадение слов ключа смысловую проверку не заменяет.
Устаревание
В копии выгрузки я добавила документу реквизит НомерДоговора и переименовала процедуру СкладСервер.ПолучитьОстаток в ПолучитьСвободныйОстаток, затем задала три вопроса про изменённое.
| База | Верных из 3 | Что ответила модель |
|---|---|---|
| старая | 0 | без нового реквизита; «в базе ответа нет»; прежнее имя процедуры |
| пересобранная | 3 | НомерДоговора, Строка(30), ПолучитьСвободныйОстаток |
Пересборка разобрала 2 изменённых файла, остальные 94 взяла из кэша и заняла 0,15 с по внутреннему таймеру команды. Изменённая копия выгрузки в платформу 1С не загружалась, XML проверен только разбором. Вывод для команды: базу не ведут вручную, её собирают после выгрузки, как любой другой артефакт сборки.
Большая конфигурация: сборка и проверка базы
На УТ 11.5 модели не опрашивались; там замерены только сборка и проверка базы.
| Замер | УТ 11.5.22.77 | Нано-УТ 2.0 |
|---|---|---|
| холодная сборка | 129, 326 и 408 с (три запуска, кэш ОС не контролировался) | 0,56 с |
| повторная без изменений | 29 и 30 с | 0,41 с |
| размер базы | 205 МБ, с кэшем сборки около 480 МБ | меньше мегабайта |
| пик рабочего набора процесса при повторной сборке без изменений | 2085 МБ | - |
kb_pack.py lint отмечает признаки, на которые следует обратить внимание при подготовке базы. Как каждый из них влияет на точность поиска, отдельно не измерялось:
| Проверка | УТ 11.5 | Нано-УТ |
|---|---|---|
| объекты без синонима | 6 из 7 209 | 2 из 61 |
| экспортные процедуры без комментария над объявлением | 12 396 из 61 359 | 45 из 45 |
| карточки, разрезанные на части | 235 из 7 209 | 0 |
| куски длиннее 800 условных токенов (оценка: символы / 3) | 966 из 87 927 | 0 |
Все 6 объектов без синонима подтверждены чтением XML. Слепая сверка 50 процедур (30 «без комментария» и 20 «с комментарием») совпала с отчётом в 50 случаях из 50. Процедура без комментария из базы не выпадает: в кусок попадают сигнатура, первые шесть непустых строк кода и извлечённые упоминания вызовов, регистров и ошибок. Улучшается ли поиск после добавления комментариев, я отдельно не сравнивала.
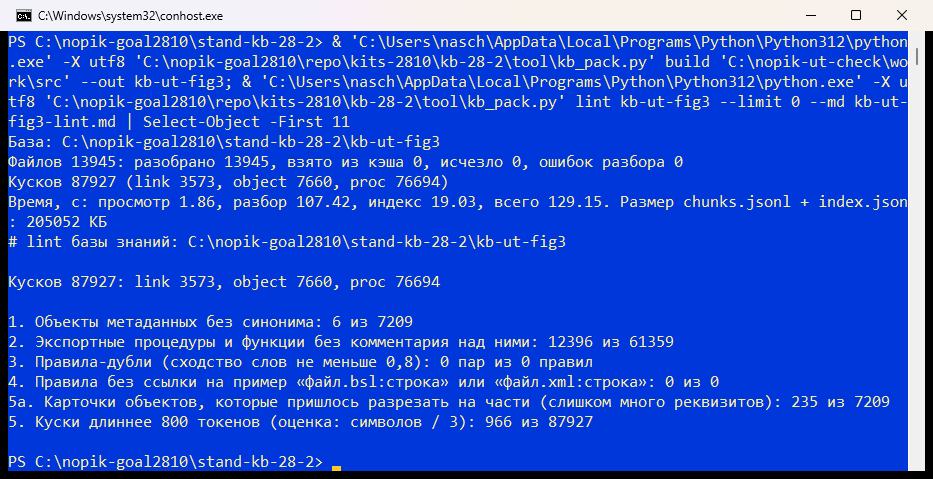
build и lint на выгрузке УТ 11.5
Пределы
- Вопросы составлены по той же конфигурации, из которой собрана база, а правила для 7 вопросов писала я. Это проверка механизма; точность на конфигурации проекта покажет только собственный набор вопросов команды.
- Из учебной конфигурации инструмент читает 93 файла, это не весь состав выгрузки. На УТ 11.5 замерены сборка и проверка базы, ответы моделей там не проверялись.
- Модели недорогие, по одному прогону каждого режима и повтор у gpt-4o-mini. Сильные модели без базы могут отвечать лучше.
- Оценка автоматическая по словам ключа с двумя сохранёнными ручными поправками. Несуществующие имена ищутся эвристически (CamelCase, кавычки, жирный шрифт), кандидаты разобраны в сохранённом журнале. Ноль в графе «с несуществующими именами» означает, что эта методика имён не нашла; это не доказательство отсутствия фактических ошибок. Полная независимая смысловая переоценка всех 256 ответов при приёмке не выполнялась.
- Формат EDT, расширения и формы в базу не входят.
Что проверить на конфигурации проекта
- Выгрузите конфигурацию в файлы и соберите базу:
kb_pack.py build <выгрузка> --rules <правила> --out <база>. - Запишите 15-25 вопросов, которые команда задаёт в действительности, и к каждому ключ с файлом и строкой. Ключ пишется до первого вопроса к модели.
- Задайте вопросы без базы и с базой через
askили через своего помощника с запросом отpack. Подсчитайте верные ответы и несуществующие имена. - Запишите 5-10 правил команды в формате «заголовок, 1-3 предложения, Пример: файл:строка» и проверьте, сколько вопросов о правилах перестали получать отказ.
- Выполните
lintи решите, какие синонимы и комментарии следует добавить. Изменилось ли качество поиска после этих правок, измерьте на вопросах команды. - Включите пересборку базы в сборку после выгрузки, чтобы база не отставала от конфигурации.
Файлы к статье
Инструмент kb-28-2-tool.zip. kb_pack.py с командами build, pack, ask и lint, 58 тестов (сеть в тестах не нужна, ask проверяется на подставном сервере) и README с форматом базы, поиском и пределами. Тесты из чистой распаковки:
Архив к статье kb-28-2-companion.zip. Командные правила опыта в проверенном формате с объяснением, почему они записаны именно так; 25 вопросов с ключами и ответы всех запусков целиком; шаблон запроса; чек-лист гигиены базы знаний; скрипты оценки ответов и поиска несуществующих имён; команды повторения опыта; расширенная PDF-версия статьи с полными таблицами ответов.
Расширенная PDF-копия статьи (50 страниц) входит в тот же архив. В ней полный текст статьи и тринадцать приложений: заполненный чек-лист гигиены базы знаний, команды повторения опыта по шагам, командные правила «Нано-УТ», шаблон запроса pack, вопросы с ключами, оценки и ответы целиком, сводка оценок по всем запускам, проверка поиска без модели, устаревание базы, проверка ссылок «файл:строка» в ответах, находки lint на «Нано-УТ» и на УТ 11.5 с их проверкой, время, память и расход, журналы прогонов. Она нужна, чтобы прочитать статью без сайта и проверить приведённые числа по первичным данным.
Итог
Без контекста у gpt-4o-mini получен 1 верный ответ из 25 и 17 ответов с несуществующими именами. С шестью кусками общей базы и инструкциями по источникам верных по ключу ответов стало 21, и проверка несуществующих имён не нашла. У второй модели верных стало 20 вместо 2. Ссылки в ответах помогают открыть источник, но существующий файл и правильный номер строки ещё не подтверждают смысл каждого утверждения.
Метаданные и фрагменты кода обновляются пересборкой базы после свежей выгрузки. В пробе с тремя вопросами это дало 3 верных ответа вместо 0, но правильного ответа на любой вопрос не гарантирует. Команде остаётся вести правила, следить за свежестью выгрузки и проверять поиск и ответы собственным набором вопросов с ключами.

Вступайте в нашу телеграмм-группу Инфостарт

