Code Index — структурный поиск по выгрузке кода 1С через MCP
Разработка - Инструментарий разработчика
Code Index — структурный поиск по коду 1С через MCP
Зачем это нужно
Когда работаешь с конфигурацией 1С через LLM-агента (Claude Code, Cursor, любой MCP-совместимый клиент) — самая дорогая операция это поиск по коду. Агент гоняет grep по гигабайтам выгрузки, забивает контекст сырыми строками, и через пару итераций ты упираешься в лимит окна. А поиск по BSL осложняется тем, что обычные индексаторы (ctags, ripgrep) не понимают структуру модулей 1С — они ищут текст, а не функции.
Code Index решает обе проблемы: парсит BSL (и ещё 7 языков) в SQLite-индекс, отдаёт по MCP-протоколу готовые функции, классы, граф вызовов. Агент получает не «строки 1234–1267 файла Х», а структурированный ответ: имя процедуры, путь, тело, кто её вызывает.
Что умеет (общие инструменты)
- Поиск функций и классов по имени — найти
ОбработкаПроведенияво всей конфигурации за миллисекунды - Граф вызовов — кто вызывает эту процедуру (
get_callers), что вызывает она сама (get_callees) - Получение тела функции по точному имени — без чтения всего модуля
- Карта файла — список всех функций/классов модуля без открытия исходника
- grep по телам функций — поиск подстроки или regex именно внутри процедур (не в комментариях документации)
- Полнотекстовый поиск через SQLite FTS5 — мгновенный по любому объёму
Специальные инструменты для XML-выгрузки 1С
Поверх обычного BSL-парсера в code-index подключается отдельное расширение bsl-extension, которое разбирает не только модули, но и XML-файлы выгрузки конфигуратора. Эти инструменты появляются в MCP автоматически, если хотя бы один репо помечен language = "bsl".
Что разбирается из XML:
- Configuration.xml — корневой файл конфигурации (состав, версия, совместимость)
- <Объект>.xml (справочники, документы, регистры…) — реквизиты, табличные части, синонимы, типы
- Form.xml — управляемые формы: реквизиты, элементы, обработчики событий
- EventSubscription.xml — подписки на события (источник → обработчик)
- ConfigDumpInfo.xml — UUID объектов конфигурации
И на основе этих данных — четыре MCP-инструмента, которых нет в обычных индексаторах:
| Инструмент | Что делает |
|---|---|
get_object_structure |
Структура объекта по full_name (например Справочник.Контрагенты): meta_type, синоним, все реквизиты с типами, табличные части. Заменяет ручное чтение XML-файла объекта |
get_form_handlers |
Все обработчики события формы: (событие → имя процедуры) для указанной формы. Сразу видно где сидит ПриОткрытии, ПередЗаписью и т.д. |
get_event_subscriptions |
Все подписки на события репо (с фильтром по модулю-обработчику). Полезно когда нужно понять «кто подписан на запись справочника» — обычно эту информацию приходится искать вручную по всем подпискам |
find_path |
Путь вызовов от одной процедуры к другой через граф proc_call_graph (recursive CTE в SQLite). Отвечает на «как ОбработкаПроведения доходит до СформироватьДвижения» — реальная цепочка через все промежуточные модули |
Плюс есть enrichment-режим — необязательное обогащение индекса через LLM: для каждой функции генерируется сигнатура и краткое описание, которые потом попадают в FTS-поиск. Запрашивая «найди процедуру, которая считает курсовые разницы» — агент находит её даже если в имени нет ни слова «курс», ни «разниц».
Поддерживаемые языки
BSL (1С), Python, Rust, Java, Go, JavaScript, TypeScript, XML. Один индекс — все языки разом.
Архитектура
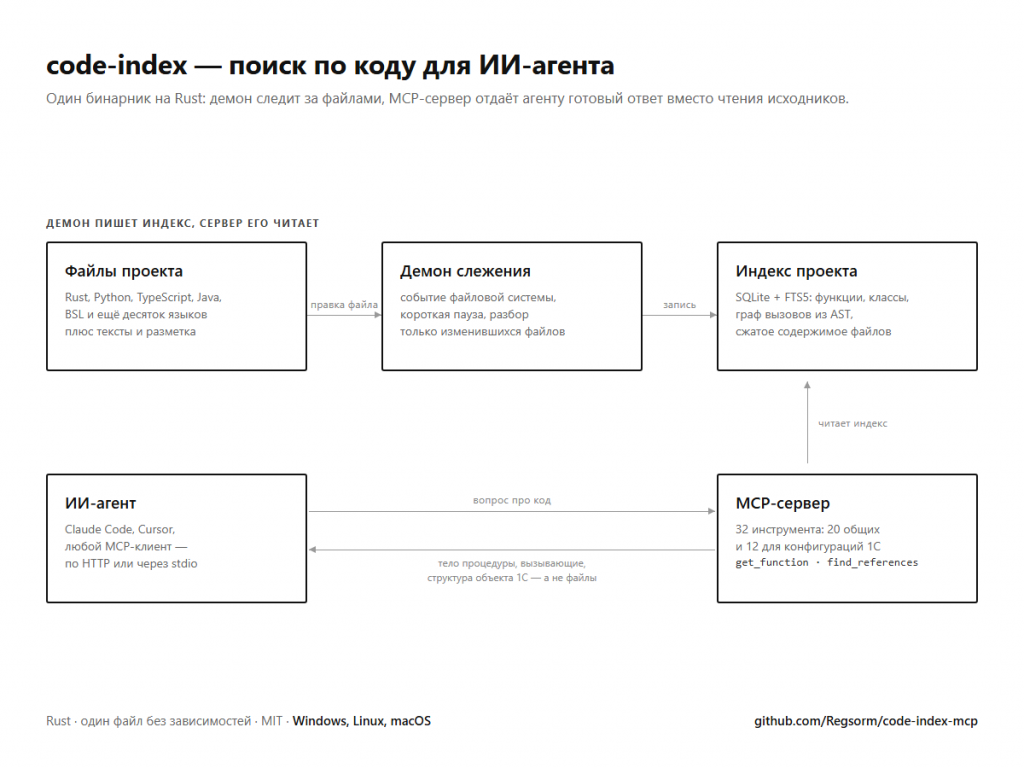
Два процесса:
- Daemon индексации — отслеживает изменения файлов через mtime, переиндексирует только изменённое
- HTTP MCP-сервер на
127.0.0.1:8011/mcp— один на все клиенты, читает SQLite в режиме read-only
Подключение к Claude Code / Cursor / любому MCP-клиенту — три строки в .mcp.json:
"code-index": { "type": "http", "url": "http://127.0.0.1:8011/mcp" }
В каждом вызове передаётся алиас репо — один сервер обслуживает сколько угодно конфигураций.
Преимущества перед grep / ripgrep / встроенным поиском Конфигуратора
- Структурный поиск: возвращает функции, а не строки. Агент сразу понимает контекст
- Граф вызовов из коробки — никаких сторонних утилит
- Понимает выгрузку 1С как структуру — формы, объекты, подписки, а не просто XML
- Инкрементальная индексация — после первого прохода обновления почти бесплатные
- Один индекс на все репо — переключение между конфигурациями без перенастройки
- Read-only SQLite — несколько агентов параллельно не мешают друг другу
- Федеративный режим — один MCP-сервер может проксировать запросы к индексам на других машинах
Производительность — реальный замер
Прогон на типовой бухгалтерии (выгрузка XML), Linux VM, режим in-memory, NVMe:
- Файлов в репо: 93 648 (из них ~19 300 .bsl)
- Размер итогового индекса: 5.2 ГБ
- Пик RAM: ~14 ГБ (in-memory режим всю БД держит в RAM до финального сброса)
Разбивка по фазам:
| Фаза | Время | Что делается |
|---|---|---|
| Сбор кандидатов | 5.6 сек | walkdir по 93K файлам + stat() — около 17 000 stat-операций в секунду |
| Парсинг + запись данных | 19 сек | tree-sitter парсит каждый BSL-файл, извлекает функции/классы/переменные/импорты; батчи по 2000 в SQLite. ~5 000 файлов/сек |
| Создание B-tree индексов + FTS5 rebuild | 78.7 сек | строятся индексы на колонки (для join/lookup) и перестраивается полнотекстовый индекс через FTS5 — самая долгая фаза |
| Финальный flush на диск | ~29 сек | сброс in-memory БД (5.2 ГБ) на NVMe |
| Wall-clock итого | 2 мин 31 сек |
Почему B-tree + FTS5 занимают 78 секунд — это последовательная операция: для каждой записи в таблицах functions/classes выполняется токенизация и вставка в виртуальную FTS5-таблицу. На объёме 92K+ функций фрагментация во временных структурах вынуждает много random I/O даже на NVMe. Это плата за то, что после индексации поиск работает за миллисекунды.
Инкрементальные обновления — на порядки быстрее: при повторном запуске на тех же 93K файлах daemon сравнивает mtime+size без чтения содержимого и обрабатывает только реально изменённые файлы — обычно секунды вместо минут.
Скорости запросов после индексации
- Поиск функции по имени: <10 мс
- get_callers / get_callees: <20 мс
- grep_body по regex с фильтром по языку: <100 мс на репозитории УТ
- get_object_structure / get_form_handlers: <5 мс (одиночный SELECT по индексу)
Установка
Бинарник под Windows / Linux собирается через cargo build --release. Подробная инструкция и release-сборки — в репозитории.
Ссылка
Вступайте в нашу телеграмм-группу Инфостарт
1С:Предприятие 8.3 BSL MCP Claude Code Cursor AI-ассистент поиск по коду индексация конфигурации граф вызовов разбор XML 1С tree-sitter open source
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Разработка Инструментарий разработчика Групповая разработка (Git, хранилище) Разработчик Платные (руб)
Практический курс по работе с AI-агентами для разработчиков 1С уровня middle и senior, а также тимлидов команд: от постановки задач и передачи контекста до создания расширений, интеграций, MCP-инструментов, тестов и проверки готового решения.
50000 руб.
10.09.2026 14280 123 0
Инструментарий разработчика Чистка данных Свертка базы Инструменты администратора БД Системный администратор Разработчик Руководитель проекта 1С:Предприятие 8 1С:ERP Управление предприятием 2 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 Россия Платные (руб)
Инструмент представляет собой обработку для проведения свёртки или обрезки баз данных. Работает на ЛЮБЫХ конфигурациях (УТ, БП, ERP, УНФ, КА и т.д.). Поддерживаются серверные и файловые базы, управляемые и обычные формы, интерфейс 8.5. Может выполнять свертку одновременно в несколько потоков, а также без непосредственного участия пользователя. Решение в Реестре отечественного ПО.
24900 руб.
20.08.2024 83722 432 171
Инструментарий разработчика Роли и права Запросы СКД Разработчик Руководитель проекта 1С:Предприятие 8 Платные (руб)
Инструменты для разработчиков 1С 8.3 и 8.5: Infostart Toolkit. Автоматизация и ускорение разработки на управляемых формах. Легкость работы с 1С.
16500 руб.
02.09.2020 286348 1611 423
Пакетная печать Печатные формы Инструментарий разработчика Разработчик 1С:Предприятие 8 Платные (руб)
Расширение для создания и редактирования печатных форм в системе 1С:Предприятие 8.3. Благодаря конструктору можно значительно снизить затраты времени на разработку печатных форм, повысить качество и прозрачность разработки, а также навести порядок в многообразии корпоративных печатных форм. Обновление версии от 21.04.26
22570 руб.
06.10.2023 44425 123 54
Инструментарий разработчика Нейросети Платные (руб)
Первые попытки разработки на 1С с использованием больших языковых моделей (LLM) могут разочаровать. LLMки сильно галлюцинируют, потому что не знают устройства конфигураций 1С, не знают нюансов синтаксиса. Но если дать им подсказки с помощью MCP, то результат получается кардинально лучше. Далее в публикации: MCP для поиска по метаданным 1С, справке синтакс-помощника и проверки синтаксиса.
15250 руб.
25.08.2025 77413 147 41
Инструменты администратора БД Инструментарий разработчика Роли и права Разработчик 1С:Предприятие 8 1C:Бухгалтерия Россия Платные (руб)
Расширение позволяет без изменения кода конфигурации выполнять проверки при вводе данных, скрывать от пользователя недоступные ему данные, выполнять код в обработчиках. Не изменяет данные конфигурации, легко устанавливается практически на любую конфигурацию на управляемых формах.
17000 руб.
10.11.2023 28857 104 46
Инструментарий разработчика Инструменты администратора БД Системный администратор Разработчик Аналитик 1С:Предприятие 8 1С 8.3 1С 8.5 1C:ERP 1С:УТ 1С:ДО 1С:Бухгалтерия 3.0 1С:ERP. Управление холдингом 1С:Зарплата и Управление Персоналом 3.x 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 Россия Платные (руб)
Универсальный инструмент программиста для администрирования конфигураций. Сборник наиболее часто используемых обработок под единым интерфейсом.
5000 руб.
14.01.2013 217511 1256 0
Задачи пользователя Инструментарий разработчика Корректировка данных Закрытие периода Разработчик Аналитик Бухгалтер Пользователь Руководитель проекта Стажер 1С 8.3 1С:ERP Управление предприятием 2 1С:Управление нашей фирмой 3.0 Управленческий учет Платные (руб)
Обработка предназначена для поиска, анализа и исправления отрицательных остатков во всех регистрах накопления информационной базы 1С.
6100 руб.
27.02.2026 3281 19 3
EDT можно бесплатно скачать создать в нем проект пустой и импортировать из любой ИБ. После чего в каталоге проекта появятся файлы.
т.е. формат edt не правильно назвать "выгрузкой в формате EDT" так как для edt это не выгрузка а рабочий проект.
Я недавно только начал использовать ИИ с 1С и удивлен тем как много инструментов для ИИ используют формат XML и Конфигуратор, постоянно выполняя сборку/разборку cf.
На мой взгляд связка EDT+AI работает значительно лучше.
А где их нет :)
Но именно для работы с ИИ тот факт что "исходники там правятся прямо "на лету"" как раз решает очень сильно.
Плюс встроенный автокомплит умеет извлекать типы данных из кода + понимает типы из BSL DOC комментариев.
Т.е. пишешь что то типа:
// Получает объект отчета по ссылке на вариант отчета.
//
// Параметры:
//   Параметры - см. ПараметрыФормированияОтчета
//
// Возвращаемое значение:
//   Структура:
//       * СсылкаОтчета - Произвольный     - ссылка отчета.
//       * ПолноеИмя    - Строка           - полное имя отчета.
//       * Метаданные   - ОбъектМетаданных - метаданные отчета.
//       * Объект       - ОтчетОбъект
//                      - ВнешнийОтчет - объект отчета:
//           ** КомпоновщикНастроек - КомпоновщикНастроекКомпоновкиДанных - настройки отчета.
//           ** СхемаКомпоновкиДанных - СхемаКомпоновкиДанных - схема отчета.
//       * КлючВарианта - Строка           - имя предопределенного или идентификатор пользовательского варианта отчета.
//       * АдресСхемы   - Строка           - адрес временного хранилища, по которому размещена схема отчета.
//       * Успех        - Булево           - Истина, если удалось подключить отчет.
//       * ТекстОшибки  - Строка           - текст ошибки.
//
Функция ПодключитьОтчетИЗагрузитьНастройки(Знач Параметры) Экспорт ПоказатьИ дальше EDT тебе подсказывает ключи структуры в любой переменной куда присвоишь результат.
Если везде писать такие комментарии то крайне упрощается разработка так как он не только подсказывает но и проверяет если ты например удалил какой то ключ а он где то используется.
Получается как в языках со строгой типизацией, но при этом не так "строго" :)
Плюс в EDT есть встроенный ИИ агент "Напарник", он тоже умеет шуршать по проекту, искать, править, умеет читать ошибки и.т.п. Так же удобно всякую рутину автоматизировать в 80% угадывает код который надо написать.
Бывает по 5 минут сидишь и только TAB нажимаешь (принять подсказку ИИ).
Ну и опять же интеграция с git тоже удобная, переключение между фичами, затягивание изменений коллег, привязка к задачам, gitlens и.т.п.
На мой взгляд если нет прям нужды сидеть в конфигураторе в 2026, то надо перебираться на EDT.
На больших проектах по сути все упирается в производительность ПК, на 9700х + 48 DDR5 он достаточно шустро работает даже с ERP, если говорить о режиме: "Запустили утром и весь день пишем код".
Ну и опять же после того как EDT начинаешь пользоваться конфигуратор никуда не исчезает, он так же точно доступен, нажимаешь ПКМ на приложении и открывается конфигуратор. Можно что то сделать в конфигураторе и как правило результаты легко затягиваются обратно (только изменения).
Если использовать с внешними ИИ то однозначно могу рекомендовать плагин:
Он добавляет много полезного, и что для меня очень удобно:
Систему тэгов и своих групп. Можно разложить объекты метаданных по группам и раздать им тэги.
Но вот среди MCP нет прямого аналога вашему варианту с графом связей поэтому и заинтересовался.
[daemon]
http_port = 0                  # 0 = выбрать свободный порт автоматически
max_concurrent_initial = 1     # папки обрабатываются последовательно при initial reindex

[[paths]]
path = "C:\\RepoUT"

[[paths]]
path = "C:\\RepoBP_1"
debounce_ms = 500              # per-папка переопределение: быстрее чем дефолт 1500 мс
batch_ms = 1000 ПоказатьДвойные квадратные скобки в paths не опечатка? Реально так надо?
[daemon]
http_port = 0 # 0 = выбрать свободный порт автоматически
max_concurrent_initial = 1 # папки обрабатываются последовательно при initial reindex
[[paths]]
path = "C:\\RepoUT"
[[paths]]
path = "C:\\RepoBP_1"
debounce_ms = 500 # per-папка переопределение: быстрее чем дефолт 1500 мс
batch_ms = 1000
Показать
Двойные квадратные скобки в paths не опечатка? Реально так надо?
Да. Это штатный синтаксис TOML., элемент "массива таблиц"
но, не удалось запустить "Дополнительные инструменты для репозиториев 1C "
Мой кусок из daemon.toml:
# 0 = автоматически выбрать свободный порт
http_port = 0
# Количество папок, индексируемых одновременно
max_concurrent_initial = 1
language = "bsl"
# Укажите ВАШИ проекты (замените пути на реальные)
[[paths]]
Структура проекта:
|-- .ai
|-- .code-index
|-- .codex
|-- scripts
|-- src <---------------- тут выгруженная база из 1с
|-- .env
|-- .gitignore
|-- AGENTS.md
|-- dumpcfg.cmd
|-- loadcfg.cmd
`-- README.md
mcp не видит дополнительных инструментов:
get_object_structure, get_form_handlers и т.д.
Что может быть не так?
• code-index-windows-x64.zip — универсальный индексатор без 1С-специфики
• bsl-indexer-windows-x64.zip — то же самое плюс инструменты для конфигураций 1С
«Дополнительные инструменты для репозиториев 1С» (get_object_structure, get_form_handlers, get_event_subscriptions, find_path, search_terms) физически линкуются только во второй бинарник. На code-index.exe они никогда не появятся, какой бы конфиг ни написать.
Минимальный рабочий конфиг:
[daemon]
http_port = 0
max_concurrent_initial = 1
[[paths]]
path = "C:\\полный\\путь\\к\\проекту"
После старта вызовите get_stats() — ваш репо должен быть с language: "bsl", и в tools/list появятся пять дополнительных инструментов.
Коллега, спасибо.
Все понятно, кроме этого:
Расшифруйте пожалуйста как вызвать get_stats() и где должно именно быть прописано language: "bsl"
(9)
Коллега, спасибо.
Все понятно, кроме этого:
После старта вызовите get_stats() — ваш репо должен быть с language: "bsl",
Расшифруйте пожалуйста как вызвать get_stats() и где должно именно быть прописано language: "bsl"
А вы как намерены это использовать? Это MCP-сервер, у него есть метод get_stats().Вызовите его через модель или через curl
Добрый день! Ну, частично граф у меня уже есть, но это граф вызова кода, "граф вызовов", если можно так сказать. Что касается "графа связи объектов"...
Интересно, может быть, не знаю, граф вызовов и так редко используется моделью, но в качестве базы связей вместе с выгрузкой структуры. Сделать-то можно, это не проблема. Смысл в том, будет ли это использоваться моделью.
Небольшой апдейт по инструменту:
Граф связей данных (data-graph)
Раньше был только граф вызовов кода («кто кого вызывает»). Теперь добавился отдельный граф связей ДАННЫХ — рёбра «объект → объект» по ссылочным типам реквизитов, измерений регистров и реквизитов табличных частей. То есть модель видит, какой справочник/документ на что ссылается, не обходя структуру вручную.
Два новых инструмента:
• get_data_links(object, direction=out|in|both, depth=1..4) — окрестность объекта: на что ссылается (out), кто ссылается на него (in), на нужную глубину.
• find_data_path(from, to) — цепочка ссылочных связей между двумя объектами.
Зачем: типичный кейс вроде «схлопнуть остатки по ГТД» раньше требовал десятки запросов структуры подряд — теперь это один обход графа. На реальной конфигурации (УТ/БП/ЗУП) это десятки тысяч рёбер связей, парсинг ~1.5 сек на конфигурацию.
Важно не путать: find_path/get_callers — это про ВЫЗОВЫ кода, а get_data_links/find_data_path — про СВЯЗИ данных. Это два разных графа.
Раньше сервер всегда отдавал клиенту все 25 инструментов (18 универсальных + 7 для 1С/BSL). Теперь в конфиге daemon.toml можно указать секцию [tools] с полем enabled и оставить только нужное подмножество — например, поиск по коду и чтение файла, без остального.
Зачем это нужно:
— меньше токенов на описание инструментов при каждом подключении модели (экономия контекста);
— слабые модели меньше путаются при выборе инструмента, когда их немного;
— сильным моделям ничего не мешает — для них полный набор остаётся доступен.
Поведение по умолчанию не изменилось: если секции [tools] нет или список пуст — доступны все инструменты, как и раньше (полная обратная совместимость). Если в списке опечатка — сервер при старте выдаёт предупреждение, но не падает.
Да, нашёл наиболее вероятное место ровного удвоения.
СгенерироватьРеализации
-> СгенерироватьИЗаписатьРеализацию
-> ЗаполнениеДокументов.СоздатьРТУ
-> ЗаполнениеДокументов.ЗаполнитьПоОстаткам
-> цикл по ДокументРН.Товары
-> ПриИзмененииНоменклатурыТовары
-> ПриИзмененииНоменклатурыТоваров
-> ОбработкаТабличныхЧастей.ЗаполнитьЕдиницуЦенуПродажиТабЧасти
...
Отличная программа и потребление памяти и скорость
Попробовал индексацию большого расширения и в ламма срр, модель гемма 4, находит правильно запросы типа - "используй кодекс_индекс репозиторий бла-бла найди всю цепочку команд где пользователь нажимает меню "Привязать документ" вплоть до самой записи в базу данных", контекст конечно быстро забивается, также происходит перебор подходящих инструментов (агент ИИ, наверное сможет скилл создать в итоге) , возможно из ответов инструментов можно убрать ответах всякие /t /n, может быть теги убрать/заменить на более короткие, может быть ответы оформить в MD. Но вот в настройках МСП серверов добавляются только 18, что отвечает за выдачу 7 дополнительных инструментов?
*** Сам нашел причину - хоум нужно было указать где бинарник лежит, как и было в инструкции указано)
export CODE_INDEX_HOME="$HOME/bsl_index/.code-index"
#./bsl-indexer index /mnt/syno/xml_doki # одноразовая индексация
pkill -f "bsl-indexer"
sleep 2
./bsl-indexer daemon run > lol.log 2>&1 & # фоновая индексация по daemon.toml
./bsl-indexer serve --host 0.0.0.0 --transport http --port 8011 --config ./.code-index/daemon.toml
[daemon]
http_host = "0.0.0.0"
[[paths]]
path = "/mnt/syno/xml_doki"
language = "bsl"
alias = "doki"
Слабая модель которую гугл выкатил на днях гемма 4 12б, она уже не шмогла) хотя кванты Q8 были. Кстати свежее обновление ллама срр чтобы думающий режим включить нужно в системный промт добавить строчку <|think|>, без нее результаты у слабой модели вообще никакие, и сильная на 26б не доходит до конца. Еще теперь нужно писать - продолжай, надо разбираться что не так стало. Полный набор инструментов выкачивает (около 4к токенов), но видимо нужен еще системный промпт - или где-то в инструментах в самом начале, как известно на больших контекстах нужно в начале или конце важное оставлять, там нужно дать объяснение что такое клиент-сервер код, его контексты, модули форм и просто модули, потому что и слабая и сильная модели не используют поиск по взаимосвязям.
Самое первое где затык происходит find_symbol { наме, репо} - пустой ответ {"_meta":{"dependent_files":[]},"result":{"classes":[],"functions":[],"imports":[],"variables":[]}} и продолжаются поиски другими функциями, мне кажется если бы поиск выдал и модули и из модуля все остальное быстро происходило, а так из функций нужно вырабатывать скилл под конкретную модель ИИ.
А так оно добирается до кода лист_файлы и греп_код, рид_файл внутри регексы. Т.е. я задал подсказки что искать - Запись, регистр, у модели нет понимания, что запись у клиента всегда идет через модули сервера, а у них названия могут быть другими, без слов ЗаписатьРегистр и тем более что нужно заглянуть и проверить. Можно написать подробный промпт и он то будет работать, то не будет, можно подписаться на точную модель. Говорят сейчас модно 100 строк промпта, тогда всем проще будет ) Как я понял удел локальных моделей это лист и греп))
Лишить себя инструментов на начальном этапе довольно сложно, но скорее всего это правильно, нужно искать каких именно.
Exclude reasoning from context в ллама решает проблему больших простыней от tools
также отключил get_file_summary
было 80к стало 11к
качество ответа даже улучшилось
а нет, пропустило важную часть, где было 80к было точнее, надо смотреть еще
выложили интересные вещи 120 tok/s on 12GB VRAM with Gemma 4 12B QAT MTP
потестил тот же самый вопрос, скорость выросла в 2 раза, а сама модель Q4 + MTP Q8 опять дала новый код в той же функции, точный и форму даже хорошо предложила оформить. Пробовал модель которая q4 не qat она там выдумала, а эта даже без MTP вполне адекватна
у меня 9 Гб при 30к занимает 10 Гб при 100к, 13Гб при 240к - это вообще все вместе, а не кеш отдельно. кстати, ллама срр мастер MTP добавили для гем 4. Квантование Q4 QAT это гугл выкатил, других нет, гуфф унслот использую.
Спасибо, потестировал на старых вопросах - стало 17к, а код тот же самый , упорно пытается взять read_file, отключил его, а вот summary гораздо легче стал, после него получить_функцию два раза и все.
добавлял системный промпт
<|think|>
use tool=code-index repo = unf
без него начинаются вопросы в чат, ну и может запустить поиск_функции на миллион токенов {
"name": "ПриСозданииНаСервере",
"repo": "unf"
}
если сказать что функция в этом же модуле, то вот так спросит
Сначала мне нужно увидеть текущий код функции ПриСозданииНаСервере, чтобы понять, куда именно вставить создание таблицы (чтобы она не "развалила" существующую верстку).
Пожалуйста, дай мне код функции ПриСозданииНаСервере (строки 36-73).
1. Непосредственно в сам сервер добавлен кеш.
2. В кеш добавлена дедупликация, потому что модели при исследовании частенько грешат повторными запросами по сужению(например) уже имеющихся(!) у них в контексте диапазонов данных. Вот дедупликация от этого спасает. Ну и плюс - можно работать в много сессий - первичный повторяющийся запрос для новой сессии отдает полный набор данных их кеша, а вот вторичный - уже 0, ибо сервер фиксирует - что кому отдал.
Хорошая модель. У тебя она наверное видит все актуальные методы crates, потому что у меня, если использовать макросы, то превращается в игру бросить кубик - соберется или нет)) В итоге из первоначального "будем использовать бла бла с свежими версиями", превращается "пишем на чистом Rust с минимум макросов" ))
По качеству 3.8 Q4 на голову превышает предыдущие модели, мне интересно будет посмотреть, как оно впишется в конфигурацию 1С, чему-то обучали судя по ответу и прошлая модель тоже что-то адекватное выдала. Ускорения пока особого нет (хотя подключил все что можно, получилось 20т/с), очень много размышлений, но они вроде помогают. Эх, когда еще через консоль отладчик будет работать в 1С ) наверное как-то есть в EDT, но даже не хочется туда лезть.
это я все к чему "построитель индекса по 1С-ному году - штука прекрасная - особоливо если вы в Квадранте еще найдете такую штуку как граф" и вместо АСТ - будет через встроенную модель строить АСГ (Абстрактный синтаксический граф)
но потом такой сервис лучше готовить к встраиванию через АгентПлагин 1.0 - внутрь любого АИ Кодинг Провайдера
P.S.. специально писал вручную и без англиЦкого
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 2677918
Создание 27.04.26 16:30
Обновление 19.09.26 16:20
Просмотры 9848
Загрузки 0
Рейтинг
44
Комментарии 74
Код открыт Да
Рубрики Инструментарий разработчика
Кому
Системный администратор
,
Разработчик
Тип файла Нет файла
Платформа Не имеет значения
Конфигурация Универсальные
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)