К вопросу о надежности искусственного интеллекта в бизнесе
Ох уж эти галлюцинации! Кто только не попался на эту удочку. От рядовых пользователей до целых коллективов с академическим статусом, публикующихся на arxiv. Наиболее яркий пример тому: Alice in Wonderland: Simple Tasks Showing Complete Reasoning Breakdown in State-Of-the-Art Large Language Models Эта же статья не так давно обсуждалась на Хабре Ахиллесова пята ИИ: простая задача, обнажившая слабости всех языковых моделей
Если хотите разобраться с этим, забудьте на время это слово галлюцинации и обратите внимание на другое слово семплирование. Что это такое. Большая языковая модель выдает вам ответ на ваш вопрос по частям, которые называются токенами. Это не слово и не буква, а нечто среднее между ними. На каждом шаге модель выбирает из нескольких возможных вариантов продолжения. Варианты не равны между собой. Какие-то считаются более подходящими, какие-то менее. Например, у вас может быть вариант 1 с рейтингом 70%, вариант 2 с рейтингом 29% и вариант 3 с рейтингом 1%. Это будет означать, что в 70 случаях из 100 для продолжения будет выбран вариант 1, в 29 случаях вариант 2 и в 1 случае вариант 3. На практике это может означать, что вы получите пресловутую галлюцинацию в 30 случаях из 100. Более того, в 1 случае из 100 вы получите такую галлюцинацию, о которой будете долго рассказывать всем, кто только будет вас слушать.
Самое важное здесь в том, что семплирование не является органической частью модели. Семплирование это нечто "прикрученное" сбоку. Зачем так сделали, и почему не стали просто выбирать всегда наилучший вариант? Представьте себе, что семплирование отключено и на каждом шаге выбирается наилучший вариант. Вы просите модель рассказать сказку. Она расскажет вам сказку. Возможно даже неплохую. Но она расскажет ее и вам, и Васе, и Пете... И сегодня, и завтра, и послезавтра. Каждый раз одну и ту же сказку. Если речь идет о сказке, то это никуда не годится. С другой стороны, если вам надо решать задачу на логику или математику (а бизнес-задачи чаще всего именно такие), тогда одна "сказка" для всех и всегда, это именно то, что вам нужно.
Провайдеры больших языковых моделей предусмотрели возможность управлять семплированием. Есть две управляющие опции при вызове через API, а у некоторых провайдеров есть еще третья. Вот они:
-
temperature
-
top_p
-
top_k
Самая простая из них top_k. С ее помощью мы можем установить количество рассматриваемых на каждом шагу результатов. Понятно, что если задать top_k=1, то это и будет полным отключением семплирования. Но это слишком просто. В OpenAI, например, считают, что не по пацански просто, поэтому у них такой опции нет. Опция top_p работает сложнее. На каждом шаге из всех возможных кандидатов выбираются самые лучшие один за другим до тех пор пока их суммарный "рейтинг" (или суммарная вероятность, как это чаще называют) не станет больше либо равен установленного порога. Если установить top_p=0.1, то это тоже будет равносильно отключению семплирования, за исключением экзотических случаев, когда у вас будет много кандидатов с низким рейтингом (вероятностью). Например: 0.05, 0.04, 0.03, 0.03... Но это и будет означать, что выбор на этом конкретном шаге почти не играет значения.
Самая замудренная опция temperature. Тут используется логарифмическая функция для изменения изначальных рейтингов. При значении temperature=1 распределение рейтингов (вероятностей) остается неизменным. При значениях выше 1, разница между рейтингами сглаживается, при значениях ниже 1, разница обостряется. Допустим, изначально у вас было два кандидата с рейтингами 60% и 40% (0.6 и 0.4). Вы задаете низкую температуру и разница обостряется, превращается, условно говоря, в 98% и 2% (0.98 и 0.02). Чтобы отключить семплирование, надо установить как можно более низкую температуру. Некоторые провайдеры разрешают указывать temperature=0, другие занимаются буквоедством и не разрешают этого делать (ну да, на значении 0 эта функция не определена). Приходится указывать что-то типа temperature=0.01
Несмотря на свою сложность, опция temperature пользуется наибольшей популярностью. Видимо, в силу прозрачности ассоциации. Высокая температура - бред. Низкая - холодный расчет.
Как видите, в этом смысле управлять моделью не сложнее чем, краном на кухне. Холодное-горячее. Тем удивительнее то, что так много людей обожглось и продолжает обжигаться горячими. Видимо, здесь нет ничей вины. Большие языковые модели были явлены широкой публике в виде чата. Для поболтать-поразвлекаться. Температура в чате была установлена в значение 1. Регулировка температуры отсутствовала (она и сейчас чаще всего отсутствует), дабы не смущать публику логарифмами. Для решения задач на логику это никуда не годилось, но сказочки получались знатные. А если какой-нибудь Вася пробовал чат на логику, то получалось еще лучше! Вася с некоторой, довольно высокой вероятностью получал очень странный результат и него тут же возникало желание поведать об этом всему свету. На его крики приходили Петя и Коля. Проверяли у себя решение задачи на логику. Получали нормальный результат и разгорался жаркий спор, привлекающий все новых и новых участников, из которых кто-то потом становился подписчиком. Business as usual.
Можно сказать, что все мы, кто сейчас занимается внедрением искусственного интеллекта в бизнес, отчасти стали жертвой первоначального маркетингового успеха больших языковых моделей. Спутником этого успеха стал миф о галлюцинациях, с которым теперь приходится бороться.
В истории с галлюцинациями больших языковых моделей большая часть это миф. Но это все же часть. Отключив семплирование, мы получим ... Но прежде, чем перейти к тому, что мы получим, хочу обратить ваше внимание на Debate: Sparks versus embers. Здесь два математика обсуждают тему: "Текущие подходы масштабирования LLM достаточны для создания новых методов, необходимых для разрешения основных открытых математических гипотез..." В дебатах есть примечательный момент. Когда условный ИИ-скептик говорит, что в длинных цепочках рассуждений обязательно будут галлюцинации, оппонент ему возражает так: "Послушай, ну мы-то с тобой знаем, что если человеком написана статья в 50+ страниц, то там будут галлюцинации 100%. И что? И ничего, показываем ревьюверам, исправляем. Все это запросто воспроизводится и в искусственном интеллекте. Одна модель проверяет другую..."
Отключив семплирование мы конечно же не получим абсолютного отсутствия галлюцинаций. Оно в принципе недостижимо. Но мы получим уровень галлюцинаций не выше, а скорее всего значительно ниже, чем у человека.
Но и это еще не все. С этим можно еще поработать. В особо ответственных случаях, да, можно будет организовать ревью на нескольких других моделях. Но для основной массы бизнес-задач, я думаю, это будет излишним. Есть более простой и достаточно эффективный метод.
Допустим, мы знаем, что на наших задачах уровень галлюцинаций составляет 1 к 1000 на запрос. Это означает, что на 1 запрос из 1000 будет выдан неверный результат. Если мы делаем около 1000 запросов в год, тогда примерно раз в год модель нам будет подкидывать неприятности. Будем тогда дублировать каждый запрос, т.е. отправлять один и тот же запрос к большой языковой модели дважды. Всякий раз мы будем получать один и тот же ответ, но раз в год ответы будут разными. Тогда мы отправим запрос в третий раз и воспользуемся тем результатом, который встретился в двух случаях из трех. Таким нехитрым приемом, мы хоть и не достигнем абсолюта, но теперь неприятности нас будут ожидать не раз в год, а раз в тысячу лет.
Этот метод хорош тем, что его можно очень просто масштабировать. Если нас не устраивает тысяча лет, можно превратить ее в миллион или миллиард простым повторением запросов. Это, конечно, увеличивает затраты, но тут хочу напомнить, что бизнес-задачи стоят существенно дешевле, чем развлечения. У вас может быть миллион записей о продажах. Но практически любой запрос на получение статистики даст вам на выходе текст SQL запроса, который уложится в 100 токенов. Текущая цена 100 выходных токенов у модели gpt-4o-mini всего лишь 0.00006 долларов. Т.е. 1000 запросов вам обойдутся в 6 центов, ну а две тысячи в целых 12. Есть, конечно, еще входные токены, но они стоят в разы меньше. Gpt-4o-mini прекрасно справляется с бизнес-задачами. Но есть, например китайская Deepseek coder v3, которая по утверждениям некоторых работает еще лучше. Так она стоит еще дешевле.
Подведем итоги. Миф о невозможности использования искусственного интеллекта в бизнесе возник на базе маркетингового успеха развлекательного направления. Отключение семплирования дает уровень галлюцинаций не выше, а скорее ниже, чем у людей. И есть простые методы получения любого желаемого уровня надежности при использовании больших языковых моделей в бизнесе.

Вайб-кодинг — ИИ пишет за вас в 1С
Решение «Вайб-кодинг» внедряет искусственный интеллект прямо в 1С: пишет корректный код, анализирует метаданные и помогает автоматизировать проектные задачи. Поддерживает GPT-4, Llama, Claude и Gemini.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Нейросети Системный администратор Разработчик Аналитик Бухгалтер Пользователь Руководитель проекта 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Зарплата и Управление Персоналом 3.x Россия Платные (руб)
Подключите ИИ к 1С и решайте рабочие задачи обычными словами. От работы с данными до доработки конфигурации через расширения, всё в привычном чате с ИИ-помощником. Теперь с поддержкой DeepSeek Harness, Kimi Code и Kimi Work, доступных в России без VPN.
15990 руб.
30.07.2026 19411 43 4
SALE! %
Банковские операции Обмен с интернет-банком Мастера заполнения Нейросети Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1C:ERP 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:ERP. Управление холдингом 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 1С:Розница 3.0 Платные (руб)
Корректируйте банковские документы быстро и легко! Создайте правило обработки — и оно автоматически применится при загрузке выписки (отбор по любому реквизиту или регулярному выражению). Решение заполняет расшифровку платежа, комиссию эквайринга, подбирает ведомости на выплату зарплаты, помечает дубли из банка на удаление и многое другое. Доплачивать за алгоритмы не нужно — они включены в решение. Обработка работает при загрузке из файлов клиент-банка и через DirectBank. Новое — искусственный интеллект: модель приводит нестандартные назначения платежа к виду, понятному алгоритмам, а ИИ-ассистент прямо в 1С консультирует по решению и разбирает код правил и алгоритмов. Поддерживаются локальные и облачные OpenAI-совместимые модели — данные могут не покидать ваш контур.
17500 руб.
20.12.2024 21482 104 32
Инструментарий разработчика Нейросети Платные (руб)
Первые попытки разработки на 1С с использованием больших языковых моделей (LLM) могут разочаровать. LLMки сильно галлюцинируют, потому что не знают устройства конфигураций 1С, не знают нюансов синтаксиса. Но если дать им подсказки с помощью MCP, то результат получается кардинально лучше. Далее в публикации: MCP для поиска по метаданным 1С, справке синтакс-помощника и проверки синтаксиса.
15250 руб.
25.08.2025 76833 147 41
SALE! 30%
Нейросети 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Управление нашей фирмой 3.0 Россия Платные (руб)
Расширение добавляет в 1С чат с ИИ-агентом. Пользователь пишет вопрос обычными словами: «какие УПД не подписаны?», «какой НДС к уплате за квартал?», «что висит на согласовании дольше недели?», а агент сам строит запросы к базе с правами этого пользователя и отвечает цифрами, таблицей, диаграммой или файлом Excel. Плитки «Аналитик», «Бухгалтер» и «Руководитель» дают сводку по базе одной кнопкой. Агент разбирает ошибки по скриншоту, сверяет прайсы поставщиков и проверяет коды маркировки. С версии 1.0.21 спрашивать можно и с телефона: QR-код в окне агента, без установки приложения. Работает в УТ 11, КА 2, ERP 2, БП 3.0, УНФ 3.0, Документооборот 3.0 и Альфа-Авто 6, ставится одним расширением.
18300 руб.
05.10.2026 3498 10 9
Инструментарий разработчика Нейросети Системный администратор Разработчик Руководитель проекта 1С 8.3 Платные (руб)
Обработка заменяет ФИО, организации, ИНН, ИИН, БИН, ОГРН, КПП, БИК, счета и IBAN, паспорта, СНИЛС, адреса, телефоны, почту и суммы на правдоподобные выдуманные перед отправкой данных в ChatGPT, Claude или YandexGPT, а потом расшифровывает ответ модели обратно, подставляя настоящие имена и настоящие числа. Возвращаются и те итоги, которые модель посчитала сама: суммы масштабируются одним коэффициентом, поэтому пропорции и доли переживают обезличивание. Словарь замен хранится в самой базе и подхватывается автоматически, даже если обработку закрывали. Реквизиты России и Казахстана, любая конфигурация от 8.3.24, без единой зависимости.
14640 руб.
07.08.2026 2167 3 0
Распознавание документов и образов Нейросети 1С:Предприятие 8 1С 8.3 1С 8.5 1C:Бухгалтерия 1С:Зарплата и Управление Персоналом 3.x Беларусь Россия Казахстан Армения Платные (руб)
ИИ-сканер документов с REST API для интеграции с 1С и корпоративными системами. Извлекайте данные из счетов, паспортов, дипломов, патентов и трудовых книжек за секунды. Точность человека - скорость машины. Приложение поддерживает восемь типов документов, четырех провайдеров ИИ (имеется возможность использования локальных ИИ), локальный REST API и экспорт в JSON. Важно! модель должна поддерживать функцию Vision (распознавание файлов и картинок). Запускайте используя локальные ИИ, без подписок и ограничений
6100 руб.
24.08.2026 1416 1 0
Нейросети Разработчик Бесплатно (free)
Как автоматически создавать маркетинговые ролики для собственных IT-продуктов, используя ИИ? В предыдущей статье я рассказывал о Zapis — приложении для работы с речью и текстом. Теперь расширил его возможности: добавил конвейер создания видео, в котором ИИ-агент изучает материалы проекта, готовит сценарий, подбирает реальные скриншоты и пишет текст диктора. Zapis отвечает за озвучку, а Remotion — за анимацию и сборку. На примере обмена ПУТ на OneBase -> 1С:Бухгалтерия 3.0 покажу готовый 83-секундный ролик из восьми сцен. Разберём, как устроен процесс, зачем нужны настоящие скриншоты интерфейса, как синхронизируются речь и изображение и что сохраняется для повторной сборки после изменений в продукте. Исходный код и инструкции доступны в открытом репозитории Zapis.
06.11.2026 420 Ibrogim 2
Нейросети Разработчик 1С 8.3 Бесплатно (free)
Как подключить ИИ-агента к разработке 1С на примере обработки «Почему не закрывается месяц»: одна папка, копия демобазы и несколько скриптов. Семь шагов: агент, выгрузка в файлы, правила, проверка кода, сборка, тесты YAxUnit и сценарии форм. На каждый: зачем он нужен, команда и где легко споткнуться. В конце: что выросло поверх, три ошибки с разных типовых и сколько это стоило.
05.11.2026 6326 Iliaelagin 6
На подходе реструктуризация базы и создание произвольных алгоритмов. Т.е. пользователь говорит что-то типа: "А теперь мне надо вести учет по размерам", а в результате происходит перестройка базы
На подходе реструктуризация базы и создание произвольных алгоритмов. Т.е. пользователь говорит что-то типа: "А теперь мне надо вести учет по размерам", а в результате происходит перестройка базы
Разрешите поинтересоваться где это внедрено?
Похоже речь об этой работе
Если так, то вопросов нет
Я сам давно заметил, что пользователи en masse не работают с отборами, сколько им не объясняй. И тут нет смысла злиться на пользователей. Не надо говорить, что пользователи плохие. Надо сказать себе, что это отборы плохие. А для пользователей надо придумать что-то другое
вот здесь подробно описано
Один из примеров (тоже очень активно занимаемся темой виртуальных ассистентов). Допустим, одна из функций агента добавляет задачу для пользователя в информационную базу. Функция принимает на вход текст задачи, дату и время, продолжительность. Всё работает, если диалог строится примерно таким образом: Я: Создай задачу ИИ: Скажите текст задачи, дату и продолжительность. Я: Позвонить клиенту, завтра в два часа дня. ИИ: Я создал для вас задачу #123.
Затем, я например говорю: Я: Я должен завтра позвонить клиенту и обсудить детали договора. ИИ: Я создал для вас задачу #124. Время он не спросил и передал в мою функцию 9 утра, при этом и в описании параметров и в самой функции указано, что ИИ обязан спросить время у пользователя. Тоже и с продолжительностью, передано 30 минут, хотя ни значения по умолчанию ни каких-то других указаний в схеме описания функции нет.
Это один из примеров, есть и другие.
По поводу решения проблемы не детерминированности путем многократного выполнения запросов, не очень понятно с практической точки зрения. ИИ может параллельно запрашивать функции, результаты которых лежат в основе дальнейших рассуждений модели, ещё не видимых пользователю, а также вовлекает создание объектов в информационной базе, что существенно меняет ответ функции при повторном запуске всего цикла. Для голосовых помощников, это в принципе неприемлемо, мы на пупе крутимся за десятые доли секунды, чтобы максимально обеспечить естественность общения с помощником.
Почему бы не делать то, что вы делаете в два прогона? Сначала промт от пользователя и получение структурированной задачи. Если вы в тулзах укажете все параметры необязательными, тогда и никаких 9 утра и 30 минут не будет. На втором шаге сравниваете эту не полностью заполненную структуру с тем, что должно быть и получаете список того, что надо заполнить...
Вы "на пупе крутитесь" потому, что сами себя туда загнали. Я вот принимаю голосовое сообщение в Телеграм и через некоторое время выдаю пользователю ответ. И это тоже естественно. Все уже так привыкли: пишешь что-то в мессенджер, а тебе через какое-то время отвечают. Вы уперлись в то, что должен быть именно разговор. А это, кстати, не самое "естественное", если можно так выразиться. Есть определенная ассиметрия. Для человека комфортнее когда он выдает на выход голосом, а принимает текстом. Человеку так легче. Говорить легче, чем писать, но читать легче, чем слушать
Интересная интерпретация, возможно вам стоит попробовать углубиться в практическое применение ИИ чуть глубже, чтобы нащупать проблему, о которой я говорю. Не обижайтесь, но вот это "а попробуйте то, а попробуйте сё", уже порядком надоело и на форуме опенай от теоретиков, которые занимаются исследованиями, а не практическим применением.
> Вы "на пупе крутитесь" потому, что сами себя туда загнали.
Мне кажется вы изолировали себя от реальности и смотрите на задачи с позиции уже полученного опыта работы с ИИ, а не потребностей бизнеса. Мне почти неудобно вас спрашивать, а зачем тогда OpenAI разрабатывает модели gpt-4o-realtime* (эти модели позволяют создавать разговорные среды с низкой задержкой, и поддерживают ввод и вывод аудиоданных в реальном времени) и представляете ли вы себе что такое требования заказчика и существование категории работников, у которых руки, например, в перчатках, а из техники, смартфон в халате или автономный raspberry pi.
А чем вам рецепт с необязательными параметрами не понравился?
ИИ просит меня вызвать функцию, имя которой и параметры, ИИ для меня уже подготовил. И если я могу проверить, все ли параметры переданы по составу и заполненности, то я не могу проверить сами значения параметров на предмет их подлинности. Например, если ИИ просит меня вызвать функцию добавления напоминания и передает мне 9 утра, то вне зависимости, обязательный в схеме это был параметр или нет, у меня нет быстрого способа проверить, что пользователь таки действительно просил ему что-то напомнить в 9 утра, а не потому что так решила модель (про температуру, сэмплирование, об этом всём в курсе).
Затем, я например говорю: Я: Я должен завтра позвонить клиенту и обсудить детали договора. ИИ: Я создал для вас задачу #124. Время он не спросил и передал в мою функцию 9 утра, при этом и в описании параметров и в самой функции указано, что ИИ обязан спросить время у пользователя. Тоже и с продолжительностью, передано 30 минут, хотя ни значения по умолчанию ни каких-то других указаний в схеме описания функции нет.
Немножко абстрактно для понимания. Сможете привести текст промта целиком? Там где ИИ обязан спросить время у пользователя. Любопытно понять, почему не спросил. Модель claude-3.5-sonnet?
Я пишу живому человеку:
Меня интересуют источники информации, которыми "пичкают" ИИ при обучении. Это что, весь интернет? Или умные дядьки пишут 100 тыс пар вопросов-ответов? Или инфу можно как-то фильтровать? А то мало ли чего там ИИ начитается. Зайдет на сайт ИГИЛ и начнет выдавать какой-нибудь экстремизм.
И что же я слышу в ответ?
Охренеть. Я спрашиваю про запись концерта какого-нибудь музыканта, где он проходил, сколько стоили билеты, а в ответ слышу лекцию о том как звуковые волны преобразуются в электромагнитные.
Поэтому выход только один. Заставить ИИ каждый раз переспрашивать у пользователя "Я вас правильно понял?". Или какую-нибудь кнопочку добавить "Да/Нет". Но это, наверно, тоже неудобно пользователю. ИИ должен сам "догадаться". Нельзя ли собрать статистику таких "ляпов", чтобы потом на ее основе написать подробные инструкции для ИИ, что и как ему понимать в ответах пользователя? Наверно, именно это вы и делаете сейчас? Серьезная у вас задача, быть первопроходцем.
И еще. Переписка с пользователем между сеансами сохраняется? Потому что один раз ИИ переспросит какой год, 2024 или 2025, а потом уже будет учитывать предыдущие ответы, и переспрашивать не будет.
Я задал Клод Соннету 3.5 от 20 июня следующий промт:
Я: Создай задачу ИИ: Скажите текст задачи, дату и время, продолжительность. Я: Позвонить клиенту, завтра в два часа дня, встреча на полчаса. ИИ: Я создал для вас задачу #123. ИИ:{позвонить клиенту}{завтра в два часа дня}{полчаса}
Давай начнем.
Создай задачу
Четыре раза просил его создать задачу, он меня ни разу не подвел. Если я не задавал продолжительность, то ИИ писал {Не указано}. Когда я в четвертый раз еще и дату/время не указал, то ИИ не захотел создавать задачу. Видимо, у вас как-то по-другому это работает.
Что нужно, чтобы воспроизвести вашу ситуацию? Несколько сотен раз задать вопрос? Просто любопытно.
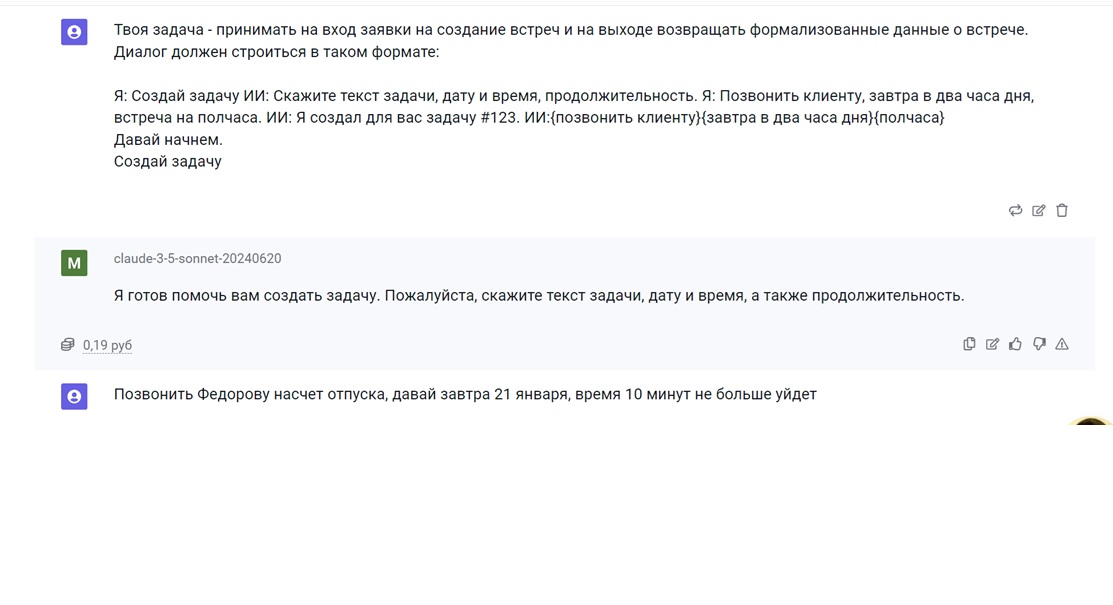
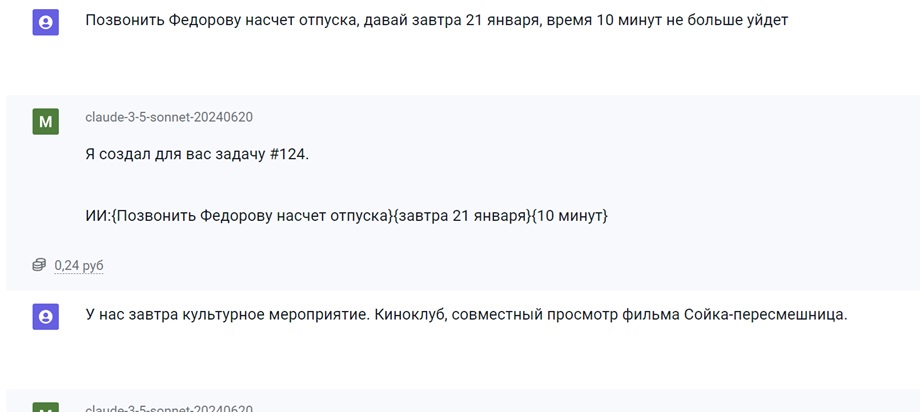

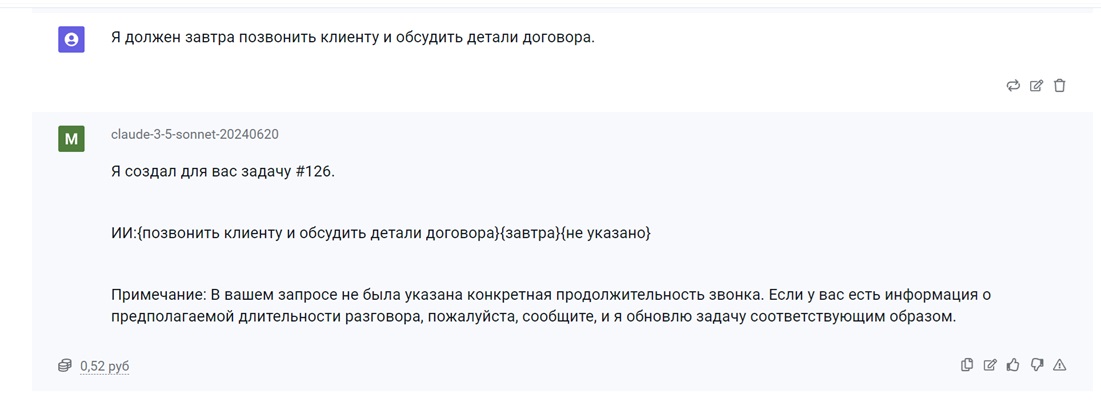
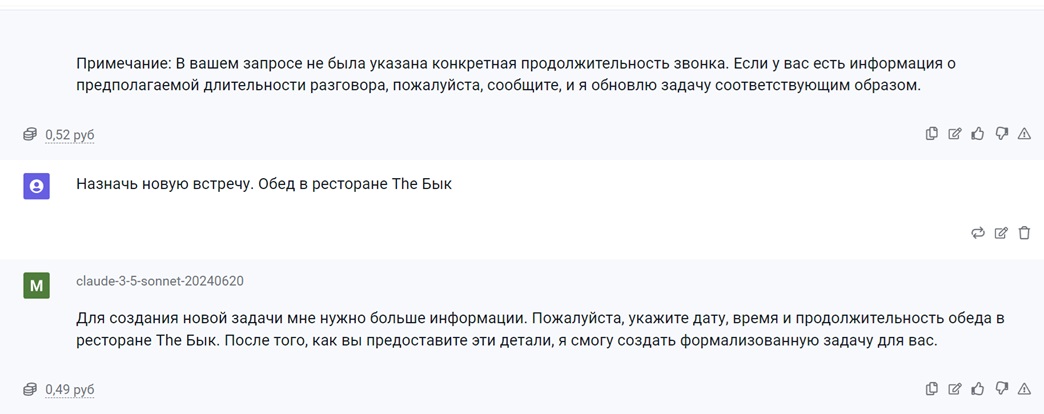
Обратите внимание, что задача решалась не так, как у вас, а через функции (tools)
Не хочу. Я убедился, что это слишком сложно для меня.
У автомобиля есть газ и тормоз, а что под капотом - пусть разбираются автомеханики. И то, я даже газ и тормоз не трогаю. Стараюсь все вопросы решать через промт. Тогда понятно, почему автор (11) мне не ответил. Слишком долго и сложно объяснять, да и бесполезно.
Я занимаюсь примерно тем, же. Но у меня таких проблем не было
Может ссылочкой форума поделитесь, где вопрос обсуждался? Любопытно будет почитать. У нас на форуме что-то спрашивать бесполезно. Тебе начнут рассказывать про космические корабли, которые бороздят просторы вселенной. Если интересно, то могу даже рассказать почему.
к сожалению или нет, но в архитектуру заложили высокую доступность, и независимость от провайдера. И как бы нам не нравился антропик (у которого нередко падает API, как бы там их графики доступности не врали), задачу связки с openai не отменили.
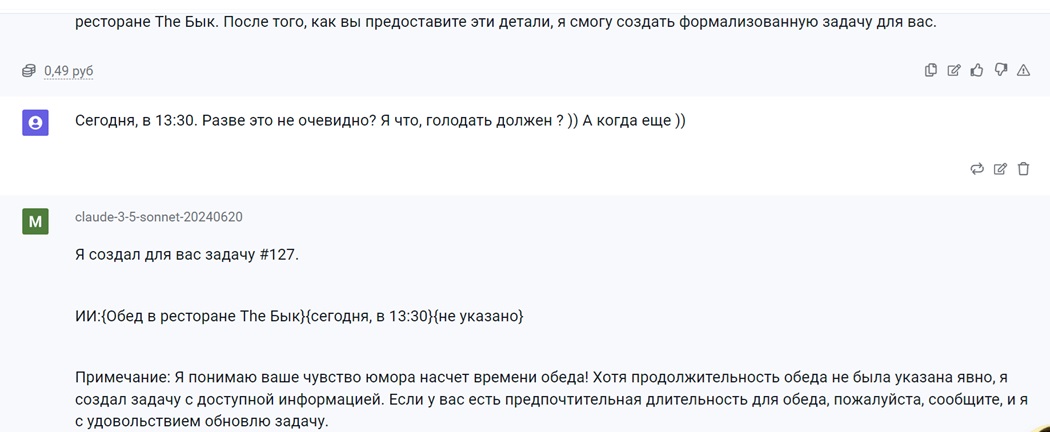
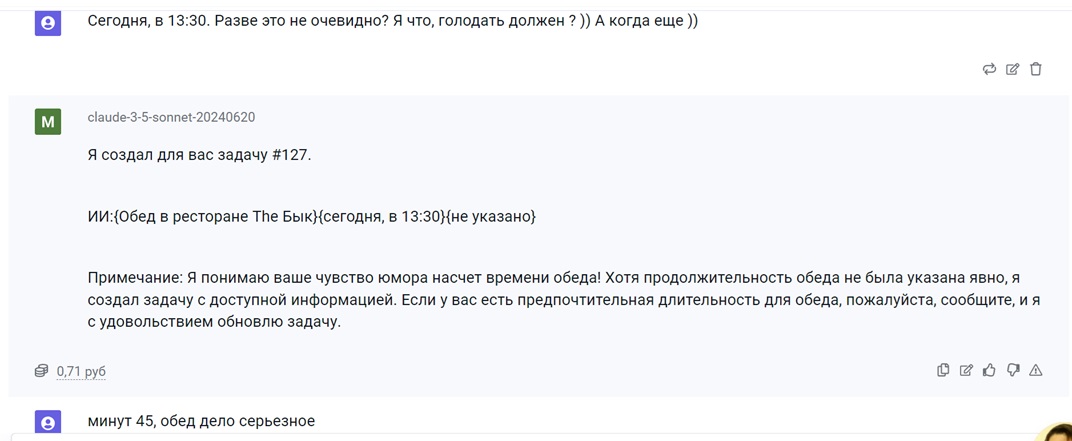
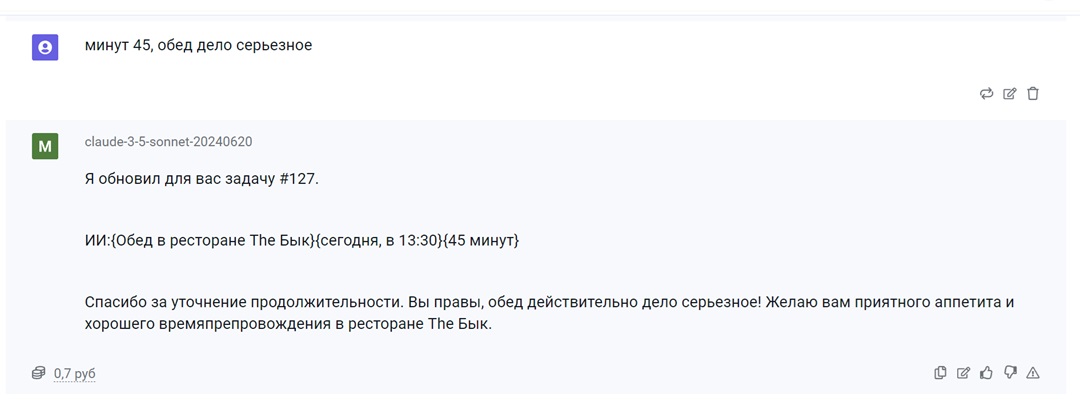
В одном комментарии сложно передать всё, что приходилось пробовать. Рецепт рабочий в одной ситуации, но вылазит в другой. Чтобы бы вы понимали, мы уже дошли до того, что записываем разговоры (теперь мы понимаем больших вендоров), чтобы потом у себя воспроизводить общение пользователя и смотреть, где лажает. Потому что у себя - всё работает, а потом пользователи жалуются, и правильно жалуются, видим по логам что передает или запрашивает или не запрашивает (а должен) ИИ. И главное, как это надёжно тестировать? Да, есть у нас своя консоль, есть свой прокси-сервер, который смотрит параметры запроса от сервера ИИ, сравнивает со схемой функций, вычисляет что обязательно, что не обязательно, что обязательно, но можно передать 0 или пустую строку и т.д., есть тесты-промпты и т.д., но потом у заказчика - всё равно как-то что-то скажет, и что-то ломается. В целом - работает, но наша практика показывает, что для того, чтобы оно очень хорошо работало, пользователю нужно всё-таки учиться определенной схеме общения с ИИ, чтобы ИИ не ошибался.
Но сейчас склонен считать, что это было заблуждением. Надо стремиться создавать такие сервисы, где от пользователя не потребуется никакой опыт. Он просто говорит, что ему надо и получает, что ему надо
дает 404
может это у меня косячит что-то.
ИС из РБ бывает не открывается почему-то...
А может туплю...
Пользователь (!) к ИИ обращается для решения задачи.
Он-то и задачу не может сформулировать толком, но это ладно. ИИ как-то вытащит уточняющими вопросами может быть. А сам пользователь может адекватно оценить "валидность" ответа ИИ?
Я думаю, что ты неправильно ставишь вопрос. Может ли пользователь оценить... Кто-то может, кто-то не может. Первый становится дядей, второй идет подметать улицу. ИИ не сделает из дурака умного.
"Реши задачу: буханка хлеба стоит 100 рублей. Буханка подешевела на 20%, а потом подорожала на 20%. Сколько стоит буханка после подорожания?"
- После подорожания буханка стоит 124 рубля.
Запустил там же второй раз
"Реши задачу: буханка хлеба стоит 100 рублей. Буханка подешевела на 20%, а потом подорожала на 20%. Сколько стоит буханка после подорожания? Покажи ход решения задачи."
- Буханка хлеба стоит 100 рублей.
Буханка подешевела на 20%, значит, новая цена: 100 - (20/100) 100 = 80 рублей.
Потом буханка подорожала на 20%, значит, новая цена: 80 + (20/100) 80 = 96 рублей.
Ответ: после подорожания буханка стоит 96 рублей.
Все будет как всегда: людям с деньгами будет доступна качественная еда, остальнеы будут есть бич-пакеты...
Если решать твою задачу за деньги, то это будет стоить не более 6 (Шести) копеек. О каких деньгах речь?
.
ИС тоже когда-то был бесплатным, когда был молодым...
.
Попробовал заставить MS-Copilot сварганить прямой запрос на 7.7.
Рожает разные варианты 8-оподобных шаблонов запросов...
Жуть...
Ни знаний, ни мозгов...
Откуда по-твоему он знает про такие экзотики как "прямой запрос для 7.7"? ) Тут людей, которые знают эту технологию, осталось не больше сотни на всей земле ))
"Сумлеваюсь я"...
Суть ИИ в том, чтобы взять из "супа" сухой остаток и на основании вашего запроса разбавить его определенным количеством воды, чтобы получить другой новый "суп".
Т.е. ИИ не сделает больше, чем есть инфы в Инетах.
С таким же успехом можно говорить, что ни один ученый в мире не делает больше того, что сделал Аристотель со своей логикой
Какая у вас практика? На основании чего вы делаете выводы?
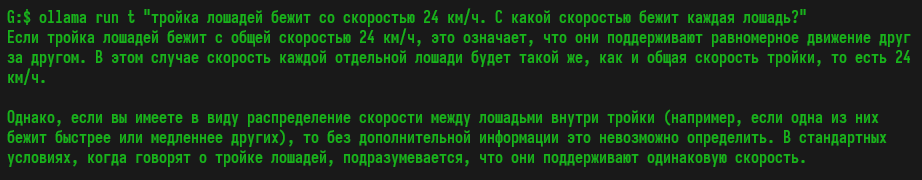
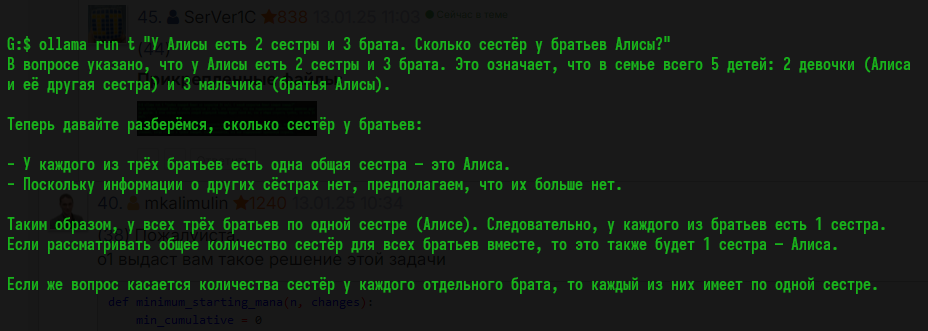
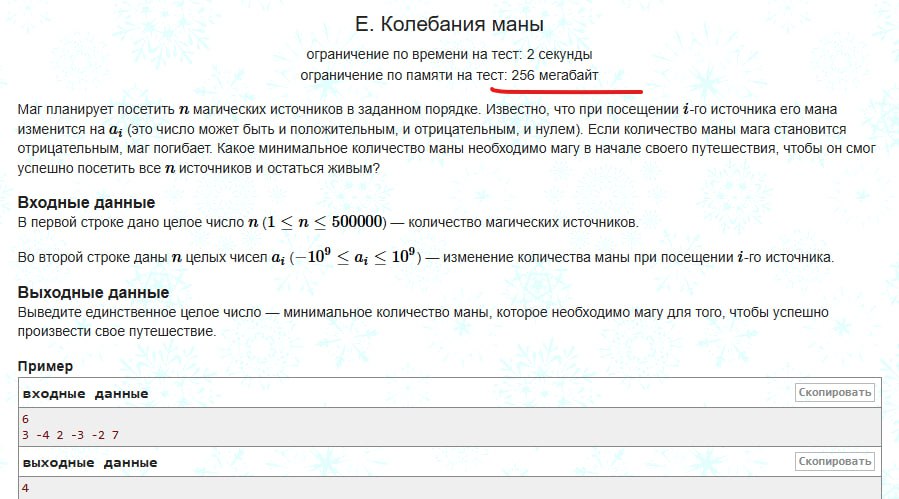
Ну вы серьезно? Вы статью читали? Там самая первая ссылка на ту самую "Алису". Откройте ее. Там ссылка на исходный код в гитхаб. Посмотрите код и убедитесь, что это ха-ха, а не исследование. Таким образом логические задачи не решаются в принципе. В статье подробно расписано почему.
o1 выдаст вам такое решение этой задачи
def minimum_starting_mana(n, changes):
    min_cumulative = 0
    cumulative = 0
    for change in changes:
        cumulative += change
        if cumulative < min_cumulative:
            min_cumulative = cumulative
    return max(0, -min_cumulative)

if __name__ == "__main__":
    import sys
    # Считываем количество источников
    input_data = sys.stdin.read().split()
    n = int(input_data[0])
    changes = list(map(int, input_data[1:n+1]))
    result = minimum_starting_mana(n, changes)
    print(result)
ПоказатьНо это не так интересно. Потому что это задача начального уровня и, кроме того, она может быть уже была в интернете и попала в обучающую выборку.
Гораздо интереснее другое. Представленная в конце прошлого года o3 имеет вычисленный рейтинг на Codeforces 2727. Это лучше, чем у 99.9% людей, участвующих в соревнованиях. 175 место в мире и соответствует уровню международного гроссмейстера. Вычисление рейтинга производится на только что прошедших соревнованиях, поэтому задачи модель точно не видела. Это при том, что еще совсем недавно передовые модели имели рейтинг ниже 1900 и относились ко второму дивизиону (любители)
а смысл спрашивать? кто будет что-то объяснять совершенно потороннему челу с улицы (уволенному уже)..?
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 2278473
Создание 10.01.25 12:00
Обновление 10.01.25 12:00
Просмотры 5770
Загрузки 0
Рейтинг
32
Комментарии 81
Код открыт Да
Рубрики Нейросети
Кому Для всех
Тип файла Нет файла
Платформа Не имеет значения
Конфигурация Универсальные
Операционная система Не имеет значения
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)

