rlm-tools-bsl: MCP-сервер, помогающий AI-агенту дешево и эффективно анализировать большие конфигурации 1С
Разработка - Инструментарий разработчика
RLM (Repository-Level Machine-coding)
Это прямое взаимодействие с файлами репозитория кодовой базы на предмет получения из них точечной и сжатой информации, а также определения целевых мест для планируемых правок/доработок.
У AI-кодера (Cursor, Claude, Codex, Kilo и т.д.) уже есть "глаза и руки": он "из коробки" умеет читать файлы, искать по проекту, писать нужные правки. Проблема начинается там, где проект - не аккуратный web-сервис на двадцать небольших файлов, а выгрузка большой ИБ 1С: ERP, ДО или УТ с тысячами BSL-модулей, XML-описаниями форм, ролями, подписками, расширениями и одинаковыми процедурами ПередЗаписью в сотнях объектов метаданных.
Обычный путь агента по Вашей задаче (без MCP-инструментов) в такой базе выглядит неэффективно: открыть файл, получить две тысячи строк в контекст, найти похожее имя, открыть еще десять файлов, утонуть в совпадениях, порассуждать, запутаться, проверить, снова порассуждать и т.д. Модель вроде бы работает, но быстро начинает платить токенами за воздух. Она тащит в диалог не выводы, а сырые данные.
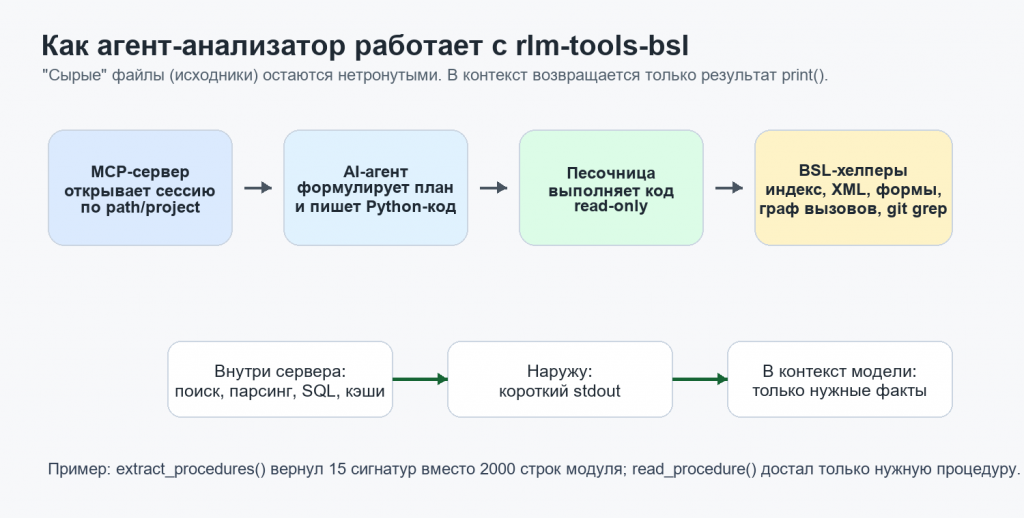
MCP-сервер rlm-tools-bsl снимает именно эту инженерную боль. Это продукт для анализа больших кодовых BSL-баз 1С. Не "волшебный RAG", не замена архитектору и не очередной grep с красивой оберткой. Это компактная и мощная мастерская рядом с проектом: агент приходит с вопросом, запускает в песочнице короткий Python-код (по подсказкам, которые ему на старте дает сам MCP-сервер), а наружу получает только отфильтрованный результат.
Простая механика
Есть главный принцип: для анализа нужна только стандартная кодовая база (выгрузка исходников формата CF или EDT и она остается на сервере (или на любом хосте, куда выгружена), в контекст агента возвращается только итоговый print().
Агент начинает с rlm_start: указывает путь к исходникам или имя зарегистрированного проекта. Сервер определяет формат выгрузки 1С - CF, EDT (да, поддержаны оба формата исходников), видит соседние CFE-расширения, поднимает сессионные кэши, подключает rlm-индекс (если он построен).
Дальше агент вызывает rlm_execute, пишет и выполняет Python-код в read-only песочнице. В этой песочнице есть 57 готовых хелперов (функциональных узкоспециализированных инструментов поиска) практически на все случаи жизни: поиск модулей, извлечение процедур, чтение конкретной процедуры, граф вызовов, парсинг XML метаданных, формы, роли, подписки, движения регистров, ссылки на объекты метаданных, использования объектов в коде, полнотекстовый git_search по всем файлам через git grep и т.д.
Типичный пример:
modules = find_module("АвансовыйОтчет")

print(modules)
Потом не надо читать весь модуль:
procedures = extract_procedures(modules[0]["path"])

print([p["name"] for p in procedures])
И только когда стало ясно, что нужна ОбработкаПроведения, агент берет ровно ее:
print(read_procedure(modules[0]["path"], "ОбработкаПроведения"))
Разница в результате очень простая. Без rlm-tools-bsl агент мог бы положить в контекст 2000 строк целевого файла. С rlm он сначала увидит 15 сигнатур, затем тело одной нужной процедуры. Экономия контекста и токенов в отдельных случаях может достигать нескольких сот процентов. По моим ощущениям как разработчика - это похоже на работу с нормальным отладчиком: не дамп всего стека вызовов и потом попытки понять что к чему, а сразу точка останова в нужном месте и просмотр в табло ключевых переменных.
Что делает агент-анализатор
Агент, вооруженный rlm-tools-bsl, действует не как читатель папки, а как инженер-механик с набором специализированных приборов.
Сначала он сужает область: ищет объект через find_module, бизнес-имя через search, произвольную строку или GUID через git_search. Если вопрос про форму, берет parse_form. Если про права - find_roles. Если про проведение - смотрит движения, подписки, обработчики и граф вызовов. Если надо понять, где используется объект метаданных, вызывает find_references_to_object и при необходимости find_code_usages.
Важная деталь: MCP-сервер не заставляет модель заранее знать все рецепты применения хелперов. В режиме slim rlm_start (инструмент старта песочницы анализа) отдает компактную маршрутную карту по хелперам, а подробные подсказки по ним агент сам при необходимости дозагружает через rlm_help. Это экономит стартовый контекст: full-стратегия содержит около 20 тысяч символов справки, slim - в 3,5-4 раза меньше.
Получается процесс, при котором не "модель догадалась или не догадалась", а нормальный инструментальный цикл:
1. Найти кандидатов.
2. Прочитать только нужные фрагменты.
3. Проверить связи по индексам или точечным поиском.
4. Сверить вывод с метаданными.
5. Вернуть человеку короткое объяснение с путями, строками и ограничениями.
Это особенно полезно на конфигурациях, где одно имя процедуры ничего не гарантирует. Например, в релизе 1.16.0 встроенный граф вызовов получил точную привязку ребер к методу через callee_key: одноименные ОбработкаПроведения и ПередЗаписью из разных модулей разных объектов метаданных больше не склеиваются в один ложный маршрут, искомый метод можно найти точно. Очевидно, что это уже не косметические отличия, а разница между "нашел цепочку" и "нарисовал красивую неправду".
Что получает агент-кодер
Для разработчика 1С ценность не только в том, что агент-помощник быстрее отвечает на вопросы по коду. Главное - он увереннее готовится к предстоящим правкам кода по Вашему ТЗ.
Перед изменением документа нужно найти его модуль, обработчики элементов формы, подписки, движения, ввод на основании, печатные формы и вызывающих. Перед изменением справочника - посмотреть реквизиты, владельцев, роли, определяемые типы и ссылки из других объектов. Перед чисткой старого механизма - найти не только декларативные ссылки в XML, но и обращения в коде, текстах запросов и строковых типах вроде "ДокументСсылка.X".
Это меняет Ваш стиль работы с LLM. Агент-кодер меньше "шаманит по названиям" и уверенно отвечает на нормальные инженерные вопросы:
- где реально используется объект;
- какие расширения перехватывают типовой метод (да, rlm-tools-bsl поддерживает и перехваты любых расширений, главное чтобы исходники расширений лежали рядом с исходниками основной конфигурации - src/cf, src/cfe);
- кто вызывает процедуру и насколько точен граф;
- что лежит в форме, а что в модуле формы;
- какие места надо проверить после правки;
- где поиск неполный и нужен индекс или уточнение;
- какие сигнатуры у методов, планируемых к доработке и т.д.
При этом rlm не требует от агента тащить всю кодовую базу в LLM. Большая часть тяжелой работы остается на файловой системе: SQLite-индекс, git grep, XML-парсинг, кэши сессии. Модель получает уже выжатую фактуру.
RLM - не замена технологии RAG, а дополнение
RAG (Retrieval-Augmented Generation) - подход, при котором перед генерацией ответа LLM сначала ищет релевантные фрагменты из заранее проиндексированной базы знаний (эмбеддинги, граф зависимостей, полнотекстовый поиск). Требует предварительной векторизации/индексации, инфраструктуры и обслуживания.
RLM (Repository-Level Machine-coding) — подход, при котором AI-агент исследует репозиторий напрямую: выполняет поисковые запросы, читает файлы, анализирует структуру — всё в реальном времени, без предварительной векторной индексации.
RLM не конкурирует с RAG. Это разные инструменты для разных ситуаций.
RAG - огромный дилерский центр: склад на тысячи квадратных метров, штат мастеров в одинаковой форме, найдут или привезут любую запчасть. Но пока запишут, пока примут, пока проведут регламентную диагностику - день (или больше) ушёл. И счёт в конце за работы впечатляет.
RLM - специализированный автосервис у дома: заехал без записи, мастер сразу под капот, разобрался именно с вашей проблемой и отпустил. Без редких запчастей с другого континента - но для повседневных задач быстрее, дешевле и точнее.
Фактически, rlm-tools-bsl - это специализированная автомастерская с целым набором разнообразного инструментария для анализа исходников 1С. Агент заходит в нее, ваша кодовая база уже "стоит на подъемнике", вокруг аккуратные стеллажи со всеми нужными инструментами и инструкция к каждому из них. И первым делом агент видит список всех инструментов и краткое описание каждого - для чего он и в каких случаях применять. После чего, отталкиваясь от той задачи, которую Вы ему дали, начинает "раскручивать и ковырять" ваши 1С-ные исходники (писать и выполнять внутри rlm-песочницы Python-скрипты).
Индексы и командная работа
У rlm-tools-bsl есть не только CLI rlm-bsl-index для индексов, но и удобный MCP-слой управления ими: тул rlm_projects регистрирует проекты по именам, тул rlm_index строит, обновляет, показывает статус и удаляет индексы. Это сделано не для красоты интерфейса, а для командной эксплуатации.
Тимлид может поднять один rlm-mcp-сервер (например, на том хосте, где хранятся или доступны все каталоги всех исходников всех проектов 1С), зарегистрировать на нем несколько конфигураций, построить индексы по каждой из них и выдать команде короткие имена проектов вместо абсолютных путей к самим исходникам. Чтение и анализ доступны без пароля, а мутирующие операции защищены: удаление, переименование и изменение проекта требуют пароль; build/update/drop rlm-индексов через MCP тоже требуют подтверждение паролем зарегистрированного проекта. То есть разработчик может попросить агента "проанализируй ERP", но не сможет случайно снести чужой индекс или перепривязать проект без знания явного секрета. Таким образом, rlm-сервер один, а пользователей - много.
На сильно измененной 1С:ERP 2.5 полная сборка rlm-индекса обычно занимает около 12-15 минут. Реальная цифра зависит от дисковой подсистемы, CPU и формата выгрузки. Зато дальше индекс живет как рабочий инструмент: если исходники 1С лежат под Git - инкрементальное обновление использует git-детект изменений и обычно занимает секунды или десятки секунд, а не повторяет полный обход всей конфигурации.
Натурное сравнение с RAG и графовыми MCP
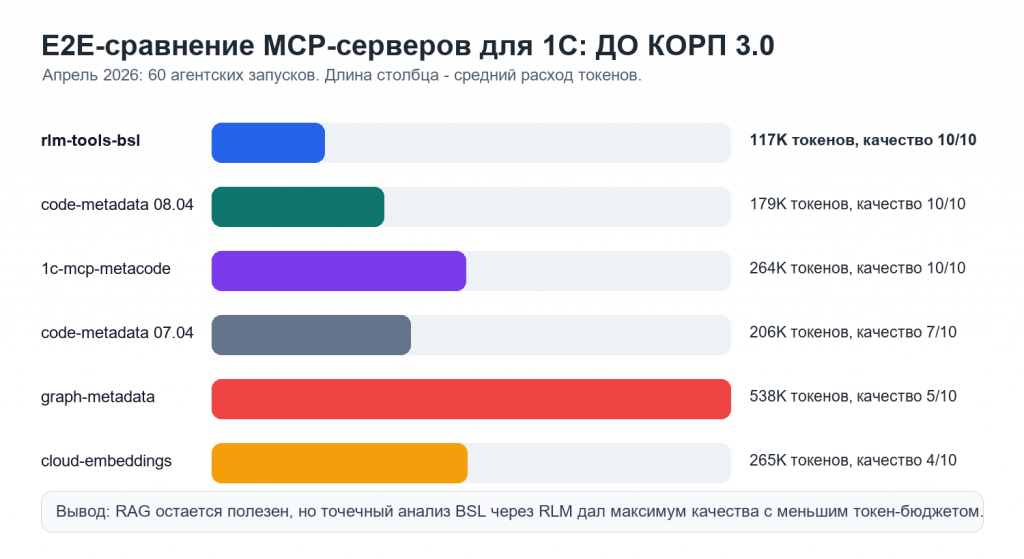
Фактическое e2e-сравнение, проведенное в апреле 2026: 6 MCP-серверов на конфигурации 1С:Документооборот КОРП 3.0, 10 бизнес-задач на каждый сервер, всего 60 агентских запусков. Методология, промпты и результаты опубликованы тут: perform_comparison_1c_rag_mcp.
Выводы: rlm-tools-bsl не заменяет технологию RAG. В описанном тесте три сервера набрали максимум качества. Но rlm дал этот максимум с минимальным средним расходом токенов и без отдельной инфраструктуры уровня "Docker + векторная БД + LM Studio". Еще интереснее, что версия платного векторного mcp code-metadata (от 08.04) поднялась по оценке с 7/10 до 10/10 в том числе после добавления парсера кода и механизмов полнотекстового поиска, заимствованных из rlm-tools-bsl.
При этом апрельские тесты уже немного устарели. После них проект заметно прокачался: v1.10 добавила агрегирующие хелперы get_object_full_structure и find_call_hierarchy; v1.11 принесла slim-стратегию и rlm_help, чтобы агент не таскал всю справку сразу при старте; v1.12 улучшила работу с соседними CFE-расширениями и многострочными сигнатурами; v1.13 усилила инкрементальное обновление индексов через Git; v1.14 добавила поиск использований объектов метаданных прямо в коде; v1.15 включила полнотекстовый git_search по всем файлам; v1.16 сделала граф вызовов точнее за счет привязки ребер к конкретному методу. То есть, опубликованное сравнение показывает картину вида не "лучший сервер на сегодня", а нижнюю планку относительно текущей версии.
Надо отдавать себе отчет, что граница применимости данного MCP-сервера - относительно детерминированный поиск/анализ (но именно таких ситуаций 90% при разработке). Если вопрос нечеткий - что-то вроде "как вообще работает бюджетирование в ERP", то семантический поиск RAG может быть полезнее. Но за предварительную векторизацию и построение RAG - Вы заплатите большим количеством времени и необходимостью поднимать либо локальную эмбеддинговую модель, либо использовать облачную. У rlm другой подход: "вот исходники, индексы построены за 10 минут - поехали анализировать". Но если нужен полный граф зависимостей всех объектов - графовый подход естественнее. Для детерминированных задач по BSL: найти объект, прочитать процедуру, построить вызывающих, проверить ссылки, разобрать форму, найти строку в XML - RLM хорошо попадает в ежедневные рабочие задачи 1С-разработчика. В целом, если в разработке используется мощная LLM, то часть семантического анализа она уже берет на себя и вопрос "бюджетирование в ERP" сама разбивает на детерминированные подзапросы в процессе анализа, так что и в этой ситуации от rlm-подхода будет много пользы.
Как начать использовать
Сам проект: https://github.com/Dach-Coin/rlm-tools-bsl
FAQ: FAQ
Быстрый старт: QUICKSTART
Полный подробный мануал по установке: INSTALL
Windows-служба, установка одной командой из PyPI (нужны права администратора):
irm https://raw.githubusercontent.com/Dach-Coin/rlm-tools-bsl/master/simple-install-from-pip.ps1 -OutFile simple-install-from-pip.ps1

PowerShell -ExecutionPolicy Bypass -File .\simple-install-from-pip.ps1
Linux + systemd-служба:
curl -LO https://raw.githubusercontent.com/Dach-Coin/rlm-tools-bsl/master/simple-install-from-pip.sh

chmod +x simple-install-from-pip.sh && ./simple-install-from-pip.sh
Docker-контейнер:
cp docker-compose.example.yml docker-compose.yml

# отредактируйте REPOS_ROOT и другие переменные

docker compose up -d
Для Windows Docker Desktop однозначно не лучший вариант: файловый I/O через WSL2/Virtiofs очень медленный (проверено на практике), особенно для индексации и live-поиска. На Windows практичнее ставить пакет на хост (можно собрать его даже без прав администратора) или запускать как службу. Docker оптимален на Linux.
Если развернете сервер в Docker - получите еще оно преимущество. Каждый новый релиз я публикую пакет в PyPI (пакетных хаб Python). Внутри docker-контейнера есть логика проверки версии установленного пакета и версии пакета в PyPI. Если в PyPI версия выше - идет автоматическое обновление. Но повторюсь - не используйте в Docker Desktop, либо будьте готовы что rlm-индексы будут строиться 60 минут вместо 10 (и вырастут таймауты для поиска). Если это делается один раз и дальше будет только их инкрементное обновление (по коммитам git внутри каталога исходников) - можно смириться.
После запуска сервер подключается к AI-клиенту как HTTP MCP:
{
  "mcpServers": {
    "rlm-tools-bsl": {
      "type": "http",
      "url": "http://127.0.0.1:9000/mcp"
    }
  }
}
Далее можно говорить агенту в чате обычным языком: "проанализируй мой проект Тест ERP через rlm-tools-bsl, найди все ссылки на Документ.ЗаказКлиента, построй граф вызывающих для метода РассчитатьСкидкиНаценки". MCP в этом не заменяет Ваше мышление разработчика (чем качественнее постановка - тем лучше результат). Он просто убирает из работы дорогой и лишний шум: бесконечный и неэффективный анализ файлов инструментами агента "из коробки".
Работа поискового ядра в том числе оптимизирована и проверена на слабых моделях, а именно:
- Cursor и Kilo в режиме Auto;
- MiniMax m2.7
- Grok Fast
Даже слабые модели, вооруженные rlm-tools-bsl - показывают неплохое качество анализа и итоговых отчетов.
Проект под лицензией MIT, если переиспользуете идеи/код - не забывайте указывать авторство. Дальнейшее развитие также планируется, буду рад Вашим PR и ишью.
UPD (05.06.26)
В репо сравнительного анализа mcp-серверов добавлен новый батл-тест
rlm-tools-bsl-v1170-vs-bsl-indexer-v0150
Результаты хорошие для обоих участников батла, подробности по ссылке
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Разработка Инструментарий разработчика Групповая разработка (Git, хранилище) Разработчик Платные (руб)
Практический курс по работе с AI-агентами для разработчиков 1С уровня middle и senior, а также тимлидов команд: от постановки задач и передачи контекста до создания расширений, интеграций, MCP-инструментов, тестов и проверки готового решения.
50000 руб.
10.09.2026 14033 125 0
Инструментарий разработчика Чистка данных Свертка базы Инструменты администратора БД Системный администратор Разработчик Руководитель проекта 1С:Предприятие 8 1С:ERP Управление предприятием 2 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 Россия Платные (руб)
Инструмент представляет собой обработку для проведения свёртки или обрезки баз данных. Работает на ЛЮБЫХ конфигурациях (УТ, БП, ERP, УНФ, КА и т.д.). Поддерживаются серверные и файловые базы, управляемые и обычные формы, интерфейс 8.5. Может выполнять свертку одновременно в несколько потоков, а также без непосредственного участия пользователя. Решение в Реестре отечественного ПО.
24900 руб.
20.08.2024 83487 432 171
Инструментарий разработчика Роли и права Запросы СКД Разработчик Руководитель проекта 1С:Предприятие 8 Платные (руб)
Инструменты для разработчиков 1С 8.3 и 8.5: Infostart Toolkit. Автоматизация и ускорение разработки на управляемых формах. Легкость работы с 1С.
16500 руб.
02.09.2020 286136 1608 423
Нейросети Системный администратор Разработчик Аналитик Бухгалтер Пользователь Руководитель проекта 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Зарплата и Управление Персоналом 3.x Россия Платные (руб)
Подключите ИИ к 1С и решайте рабочие задачи обычными словами. От работы с данными до доработки конфигурации через расширения, всё в привычном чате с ИИ-помощником. Теперь с поддержкой DeepSeek Harness, Kimi Code и Kimi Work, доступных в России без VPN.
15990 руб.
30.07.2026 19758 44 4
Инструментарий разработчика Разработка Администрирование веб-серверов Системный администратор Разработчик Аналитик Руководитель проекта 1С 8.3 Платные (руб)
Analyzer 1C сводит выгрузку 1С — основную конфигурацию и все расширения — в единый граф знаний. Любой запрос по связям за доли секунды, с пометками «Доб.» / «Заимств.» / «Переопределено». Новое в 2.0 — обновление поставки: сравнение и объединение версий деревом «как в Конфигураторе» с выгрузкой плана решений; поиск конфликтов из-за перехватов расширений и висячих ссылок; загрузка из бинарных .cf/.cfe; циклические зависимости. Плюс анализ влияния, запросы BSL, роли и RLS, граф вызовов. Минута на развёртывание через Docker без необходимости подключения к Интернет. Любая 1С:Предприятие 8.3+.
14000 руб.
17.04.2026 17036 63 62
SALE! %
Банковские операции Обмен с интернет-банком Мастера заполнения Нейросети Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1C:ERP 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:ERP. Управление холдингом 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 1С:Розница 3.0 Платные (руб)
Корректируйте банковские документы быстро и легко! Создайте правило обработки — и оно автоматически применится при загрузке выписки (отбор по любому реквизиту или регулярному выражению). Решение заполняет расшифровку платежа, комиссию эквайринга, подбирает ведомости на выплату зарплаты, помечает дубли из банка на удаление и многое другое. Доплачивать за алгоритмы не нужно — они включены в решение. Обработка работает при загрузке из файлов клиент-банка и через DirectBank. Новое — искусственный интеллект: модель приводит нестандартные назначения платежа к виду, понятному алгоритмам, а ИИ-ассистент прямо в 1С консультирует по решению и разбирает код правил и алгоритмов. Поддерживаются локальные и облачные OpenAI-совместимые модели — данные могут не покидать ваш контур.
17500 руб.
20.12.2024 21701 105 32
Пакетная печать Печатные формы Инструментарий разработчика Разработчик 1С:Предприятие 8 Платные (руб)
Расширение для создания и редактирования печатных форм в системе 1С:Предприятие 8.3. Благодаря конструктору можно значительно снизить затраты времени на разработку печатных форм, повысить качество и прозрачность разработки, а также навести порядок в многообразии корпоративных печатных форм. Обновление версии от 21.04.26
22570 руб.
06.10.2023 44348 123 54
Инструментарий разработчика Нейросети Платные (руб)
Первые попытки разработки на 1С с использованием больших языковых моделей (LLM) могут разочаровать. LLMки сильно галлюцинируют, потому что не знают устройства конфигураций 1С, не знают нюансов синтаксиса. Но если дать им подсказки с помощью MCP, то результат получается кардинально лучше. Далее в публикации: MCP для поиска по метаданным 1С, справке синтакс-помощника и проверки синтаксиса.
15250 руб.
25.08.2025 77249 147 41
ЗЫ: индекс строится в полтора потока. Диск юзается на 0,0001%. Наверное это все можно ускорить, "но зачем?" (с)
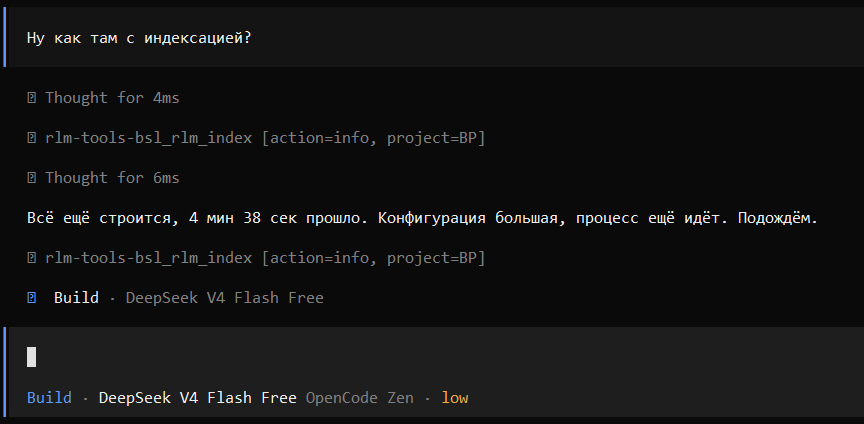
И как выше сказали многопоточности не хватает при чтении файлов.
И не понятно зачем граф надо было запихивать в БД? Можно в память пулять, например через редис.
Граф строится один раз полностью и затем инкрементально обновляется при апдейтах индексов.
Так что там нет никакого "каждый раз", с чего Вы взяли то это?
Многопоточность также там реализована, где именно ее нет?
Есть и хелперы, которые могут в несколько потоков, есть и такие алгоритмы в механизме построения индексов.
Вы бы хоть код глянули сначала, прежде чем писать советы, вот честно
DELETE FROM calls WHERE caller_id IN (...)
У меня ребра хранятся как "(caller_id, callee_name, line, callee_key)" - где callee это имя/ключ-строка
Вот четыре сценария:
1. Правка тела модуля A (метод на месте). Файл A (только он) перепарсивается заново, его методы и исходящие вызовы пересчитываются. Вызовы к A из других модулей не ломаются, потому что они ссылаются на метод по пути+имени, а не по внутреннему номеру строки - а путь не поменялся.
2. Удаление процедуры в A. Исходящие вызовы удалённого метода исчезают сразу (модуль A пересобран без него). А вызовы этого метода из других, нетронутых модулей остаются висеть "в пустоту" - и это правильно, потому что их исходный код всё ещё буквально вызывает несуществующий метод (реальная битая ссылка).
3. Переименование метода в A. В самом A всё актуально сразу. Но другие модули, которые звали старое имя (если они его по прежнему зовут и в них нет переименований), продолжают хранить старое имя до тех пор, пока их самих не отредактируют - только тогда их вызовы пересчитаются и подхватят новое имя (либо при полной пересборке индекса).
4. Набор изменённых файлов = переименованный ОМ + все ОМ, где исправлены вызовы. Каждый из них попадает в changed, перепарсивается независимо: у переименованного ОМ обновляются методы, у вызывающих - их исходящие рёбра (старые A.СтароеИмя удаляются вместе со строками модуля, новые A.НовоеИмя вставляются). Нетронутые модули не трогаются вообще - они этот метод и не звали, так что протухать нечему.
________________
Так что что тут нового в архитектуре то? Просто аккуратный инкремент. Главное - достать именно то, что изменилось и от него уже отталкиваться. Тут сильно выручает git.
Поюзал Ваше решение, ЕРП проиндексировалась реально за 10 мин. на быстром ssd в контейнере докера. В целом работает очень даже хорошо!
Мой допиленный проект под bsl Serena чуть медленней индексирует ЕРП (порядка 16-20 мин. на локальной машине под windows), но там строиться AST дерево и пуляется в файл кеша pkl, при открытии проекта в IDE загружается в память + обновление кеша при изменениях..
По экономии токенов ранее уже тут писали, в среднем 50%.
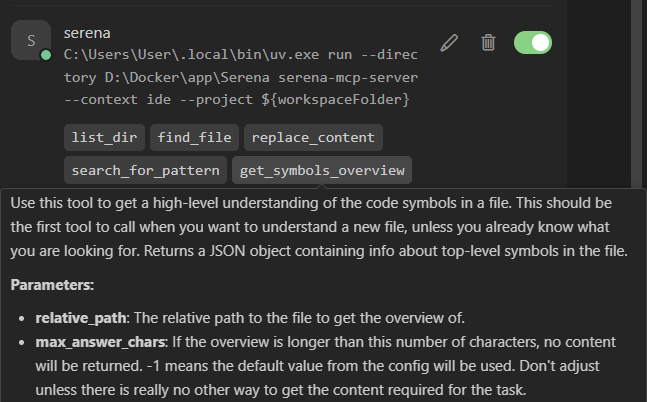
Единственное что я бы доработал это грамотное описание tools, чтобы даже не топовые модели могли нормально ориентироваться для чего тот или иной инструмент.
для примера из serena:
Какой смысл? Все прекрасно помещается в 1-й статичной таблице в sqlite.
Зачем рождать еще одну зависимость и держать в памяти кучу данных, которые (скорее всего) за день потребуются 2-3 раза всего?
У меня 1-н пакет и принцип: "вот исходники 1С - поставили пакет - 10-15 минут на индексы - готово к анализу"
Редиса не хватает, ага. Может еще эластик прикрутить для полноты картины? Баланс между сложностью продукта и оптимальностью функционала соблюдается
Как часто это происходит?
Ну и даже если и часто - что мешает за 15 минут построить/обновить rlm-индексы? Что такое 15 минут на фоне временных затрат на сам релиз или временных затрат например на векторизацию и перестроение RAG? Ответ - копейки
P.S. Инкрементный апдейт rlm-индексов делается за 10-ки секунд или быстрее
На коммит повешен хук, по нему срабатывает пайплайн, одной из команд которого прописан апдейт rlm-индексов (выполняется за несколько десятков секунд).
После чего стартует агент-анализатор (OpenCode + glm 5.1) и проводит ревью новых доработок
В процессе ревью агент также подтягивает через mcp jira саму задачу и проверяет соответствие доработок тому ТЗ или ФТ, которые приложены к задаче. После чего ревью-файл прикладывается в виде комментов к коду и разработчик получает письмо с замечаниями (это уже стандартный механизм gitlab). В этой схеме rlm-tools-bsl выступает как помощник для агента-анализатора, индексы которого не надо обновлять часами (в отличии от RAG-векторов)
Все работает и качество кода у команды повысилось, количество ошибок уменьшилось. И это уже явная бизнес-польза
Идеи похожие реализованы.
Там мультиязычный функционал, у меня же все-таки именно bsl-специфичный.
Там надо бинарник собирать, у меня - готовый пакет из пакетного хаба.
Там - раст, у меня - пайтон.
Там граф строится через три-ситтер AST, у меня он статичный и строится парсингом и последующей нормализацией и очисткой.
Там исходники 1С хранятся в индексах, судя по всему, а у меня - нет (оба подхода имеют и плюсы и минусы).
А по функционалу, качеству помощи, скорости, эффективности и дешевизне поиска - это так с ходу не ответить "круче или нет".
Надо делать объективное сравнение - поднимать оба сервера, брать одну и ту же модель, один и тот же харнесс, один и тот же промпт для поиска и только лишь разные MCP-помощники поиска. И проводить минимум 10 тестов, чтобы снять вопрос недетерминированности llm.
После чего сравнивать качество отчетов и затраченные токены. Только такое сравнение даст объективный ответ.
Вот методология
Целью своей я ставил максимально ускорение получения данных из выгрузки базы 1с для модели и максимальную экономию токенов при этом. Язык был взят сразу Rust, за его работу с памятью и масштабируемость
"Там мультиязычный функционал, у меня же все-таки именно bsl-специфичный."
Там выделен отдельный функционал под BSL-функционал, а начиналось все с универсального.
"Там надо бинарник собирать, у меня - готовый пакет из пакетного хаба". - Релизы под все платформы
"Там - раст, у меня - пайтон." разница в этих языках какая? Пайтон - интерпретируемый язык(но может компилироваться), Rust - компилируемый. Скорости и потребление памяти - несравнимы в пользу Rust , хотя удобство поддержки и изменения кода у Rust, конечно, меньше.
"Там граф строится через три-ситтер AST, у меня он статичный и строится парсингом и последующей нормализацией и очисткой". Аналогично, я не ставил своей задачей изменения графа при изменении кода. Но можно заморочиться.
Там исходники 1С хранятся в индексах, судя по всему, а у меня - нет (оба подхода имеют и плюсы и минусы) - в базе данных SQLite, которая проиндексирована.
Скорость самого языка не так важна, ИМХО, как оптимизации поисковых алгоритмов под формат 1С-исходников. Как известно, сама 1С тоже умеет довольно быстро работать, если на ней писать нормальный код (хотя она тоже интерпретируемая). На мой взгляд, python вполне ОК для такого рода задач (недаром на нем пишут множество парсеров всего подряд).
Бегло гляну код Вашего проекта, именно оптимизаций под 1С у меня сейчас объективно больше. И граф у меня почище (у Вас на текущий момент не нормализован, судя по коду, хотя могу ошибаться). Но это не значит, что завтра Вы меня не обгоните, тем более что судя по коммитам - оба проекта стартанули примерно в одно и тоже время и шли параллельно (я про Ваш ничего не знал, пока не показали ссылку). Я нормализацию графа сам только-только (на днях) добавил, если уж на то пошло.
"исходники 1С хранятся.... в базе данных SQLite, которая проиндексирована" - это значит, что как минимум, они у Вас занимают столько же места сколько сами исходники + сами индексные данные. Довольно дорого сточки зрения места и обслуживания, но зато есть плюсы - быстрое снятие блобов с самих файлов плюс инкремент потенциально дешевле.
По сравнению с компилируемыми языками высокого уровня?:):):):) Это несравнимо просто.
"Скорость самого языка не так важна, ИМХО, как оптимизации поисковых алгоритмов под формат 1С-исходников" - в данном случае скорость работы алгоритма в скомпилированном виде, но вот здесь именно и собака порылась - Rust с учетом его синтаксиса и компилятора - крайне быстрый:):).
"Бегло гляну код Вашего проекта, именно оптимизаций под 1С у меня сейчас объективно больше." - если говорить только про 1с - возможно. Но что касается универсальности - нет. На гитхабе есть куча народу, который в жизни не слышал про 1с:), но про Питон слышал. Они могут использовать мой MCP ровно с той же функциональностью, что и под другие языки. Это 1с скорее ответвление.
"Довольно дорого сточки зрения места и обслуживания" - честно сказать, не понял. Какая разница, сколько у меня будет занято на диске - 10 ГБ или 20 ГБ, если это дает возможность экономить и токены, и время?
Да, и что касается графа - настолько он редко у меня вызывается моделью. Можно его сделать нормализованным, можно даже он-лайн перестраивать. Я смотрю свою статистику - возможно мало у меня подобных задач, не требуются широкие поиски по конфе. ВОЗМОЖНО, вследствие наличия аж 4 инструментов поиска по коду... Модель - Опус.
Повторюсь, ИМХО, скорости python вполне достаточно для быстрого поиска. Особенно, если будет попадание в индексы. Если нет и поиск скатится в grep/glob - то возможно да, тут кто быстрее умеет работать с кучей файлов - мелких и средних.
Сам факт непопадания в индексы при каком-либо запросе - повод их доработать.
"Это 1с скорее ответвление"
На github полно индексилок на каждый ЯП, подобных нашим и универсальность в данном случае работает против полноты и скорости. У меня универсальности не было и не планируется - будет только до-заточка под 1С-специфику.
"Какая разница, сколько у меня будет занято на диске" - мою индексилку можно поднять в докере на удаленном хосте, прокинуть внутри каталоги исходников и индексы будут лежать на отдельном волуме и не занимать много места. У Вас они зачем-то хранятся в самой БД (кстати, зачем все-таки?). Если у меня 5 ЕРП, исходники которых весят по 6 Гб, индексы по каждой весят 1.5 Гб. 1.5*5=7.5, в Вашем случае надо уже 30 Гб минимум. Вроде и немного, но смысл? Легковесности уже нет. Я при разработке думал в том числе и о девопс-сценариях использования и как показала практика - не зря, некоторые уже используют именно так (см. мой коммент про gitlab выше)
Граф - штука полезная, особенно при анализе типовых механизмов.
В целом, я не вижу архитектурно у нас с вами глобальных отличий, так как идея одинаковая - прокачанный но по факту полнотекстовый поиск. Вопрос что лучше-хуже/дороже-дешевле решается только e2e тестами с абсолютно одинаковым окружением, кроме самих MCP
Сам факт непопадания в индексы при каком-либо запросе - повод их доработать.
Не понял, к чему это.
"Это 1с скорее ответвление"
На github полно индексилок на каждый ЯП, подобных нашим и универсальность в данном случае работает против полноты и скорости. У меня универсальности не было и не планируется - будет только до-заточка под 1С-специфику.
Если среда в позволяет сделать универсальный инструмент без потери скорости под любой язык - почему нет?
У Вас они зачем-то хранятся в самой БД (кстати, зачем все-таки?). - кто?:):) В БД у меня хранятся распарсенный, разумееется, код, плюс сжатый полный код(а я уже и не помню, для чего, честно то сказать) . Для чего-то . Изначально хранилось без исходников.
Я не знаю, о каких 30 гигах речь, бухия у меня 3.0 со всеми расширениями у меня занимает в базе 5 ГБ. Если выкину исходники...там вроде 2 гига с лишним будет. Собственно, ПОСЛЕ индексации репо больше не нужно.
Потом, какие вы постоянно упоминаете индексы. Индексы - это конструкции внутри базы данных, оптимизирующие поиск по данным. Как они у вас хранятся отдельно?
Если мой python весь поисковый запрос выполнит по "индексной" БД и все ответы получит из нее, то относительно Вашего Rust разницы в скорости не будет или она будет совсем минимальна - вот про что
"Если среда в позволяет сделать универсальный инструмент без потери скорости под любой язык - почему нет?"
На здоровье, у меня - другой подход
"В БД у меня хранятся распарсенный, разумееется, код, плюс сжатый полный код"
Ну вот я про это. Зачем хранить код исходников у себя в "индексной" БД?
"Если выкину исходники" - так а зачем они хранятся, если их можно выкинуть безболезненно? Я у себя изначально и не храню и не собираюсь хранить.
"Потом, какие вы постоянно упоминаете индексы" - ОК, уточняем, речь про специализированную БД, привязанную к самому mcp и хранящую поисковые выжимки данных - "индексы" (такая терминология сложилась в обиходе вайбкодинговой среды, векторизацию или эмбеддирование многие тоже называют "индексированием")
В целом не вижу смысла холливарить кто и как и что хранит и что лучше/хуже - Rust/Python.
Я при разработке преследую цели - относительная легкость доработки и сопровождения, легковесность самого продукта и тех данных, которые ему нужны для качественного анализа, скорость работы, полнота покрытия поисковыми алгоритмами нюансов 1С bsl.
У вас немного другие цели - это ОК.
Можем устроить сравнительные тесты и они покажут, чей подход сильнее.
Но что-то подсказывает (судя по Вашему коду, по крайней мере), что глобальной разницы не будет и если кто-то кого-то в чем-то обгонит, то конкурент сможет прочитать свои логи, доработать и быстро догнать.
Причем если изучите мою ссылку с методологией сравнения - там будет видно, что анализ "вчистую" - без всяких рулс, инструкций дополнительных и тд и тп
Вот просто берем агента, условно клод, ставим соннет 4.6 в роли модели, подключаем только 1-н конкретный mcp и вводим промпт и погнали: "Проанализируй то-то и то-то, используй для анализа СТРОГО вот этот mcp"
И так 10 промптов с 1-м mcp и 10 с другим
В конце сравниваем токены и полноту и качество отчетов
Я по методике в многопоточке. У меня опус стартует агентов параллельно, с одинаковыми промптами конечно...Устраивает?
Значит это нужно делать на одной плошадке где-то.
А я подниму ваш сервер и тоже проделаю
Только давайте соблюдать джентельменские соглашения, так сказать:
- модель+харнесс+mcp+промпт
и все, никаких подсказок, доп. инструкций и прочих доработок в систем промпт
Единственный момент, у меня нету конфигурации, которая описана в методике. Я взял КА1.1 распарсенную.. И там частично у меня переписаны запросы под объекты, которые есть в этой конфигурации. Абсолютно одинаковые для обеих моделей. Всё будет в отчёте о тестировании.
Сейчас разверну у себя, НО БЕЗ АГЕНТОВ(пока)..померяю чистую скорость интерфейса, причем без кэша.
"Сразу важная оговорка по честности замера нашего Rust-сервера: перед ним стоит кеширующий прокси mcp-cache-ci (8011). Если мерить через него — Rust будет выглядеть «мгновенным» из-за кеша. Поэтому мерить буду в обход кеша: либо напрямую бэкенд code-index-serve (8013), либо с заголовком X-Cache-Bypass: 1. Это и есть настоящая скорость движка."
Замечание Опуса.
Оркестратор загружает servers.yaml и фильтрует серверы по указанным именам
Проверяет доступность инфраструктуры (Docker, LM Studio, Neo4j) и health-check каждого сервера...
Запускает параллельных агентов (Sonnet) — по одному на каждый сервер × каждый тест
А если у меня КВН не смешной?
Поэтому ПО ЧЕСНОКУ, как договаривались:
Результаты уже понятны, вы выиграли, вопросов нет.
Итого - на случайно выбранной конфигурации с текущими настройками и текущей версией побеждает версия rlm-tools-bsl!
Плюс поставил, звезду на гитхаб поставил!
Я выложу результаты, даже если там есть ошибки
Чтобы вы понимали - платный code_metadata векторный тестировался у меня в апреле вообще с нерабочим парсером и кривым чанкером под капотом (это уже потом выяснилось)
Он все равно смог показать результат какой-никакой
Так что пока не будем делать выводы из-за одной ошибки
План: иду по тестам 1→10, порция = 1 тест × 2 сервера = 2 sonnet-агента параллельно. После завершения обоих пишу 2 файла ОценкаКачества (с подсчётом токенов и метриками), затем следующая порция. Скажете «стоп» — остановлюсь на любой порции.
Загружаю трекер задач и стартую порцию 1 (TEST-01, вх_письмо).
Update Todos
Batch 1 — TEST-01 (вх_письмо): rlm + bsl-indexer, оценки качества
Batch 2 — TEST-02 (согласование): rlm + bsl-indexer, оценки
Batch 3 — TEST-03 (сотрудники): rlm + bsl-indexer, оценки
Batch 4 — TEST-04 (регистры_задач): rlm + bsl-indexer, оценки
Batch 5 — TEST-05 (поиск_процедуры): rlm + bsl-indexer, оценки
Batch 6 — TEST-06 (нумерация): rlm + bsl-indexer, оценки
Batch 7 — TEST-07 (подписание_ЭЦП): rlm + bsl-indexer, оценки
Batch 8 — TEST-08 (права_доступа): rlm + bsl-indexer, оценки
Batch 9 — TEST-09 (МЭДО): rlm + bsl-indexer, оценки
Batch 10 — TEST-10 (сквозной): rlm + bsl-indexer, оценки
Финал — COMPARISON_REPORT.md (rlm v1.17.0 vs bsl-indexer v0.15) + очистка tmp/
"Главный вывод порции: ответ одинаково полный, но bsl-indexer истратил в 3.2× больше контекста. Причины — get_object_structure не отдаёт реквизиты (пришлось читать сырой XML 6 раз) + два гигантских дампа (get_event_subscriptions ≈160K ток., get_file_summary ≈118K ток.).
Два замечания по bsl-indexer v0.15, которые стоит держать в уме:
🔴 get_event_subscriptions возвращает кириллицу как U+FFFD (битая кодировка) — имена подписок нечитаемы. Похоже на реальный баг.
🟡 get_event_subscriptions не фильтруется по русскому имени события (внутри хранятся английские BeforeWrite/OnWrite)."
Вы про эту ошибку?
Если да, то исправляйте и релизьтесь - еще разок проверим.
Я этот прогон доведу до конца все равно, раз уж начал
Ну как видите, методика сравнения то рабочая. Уже в третий раз убеждаюсь.
Собственно, одна из причин, почему я не стал менять python в исходной идее - его я хотя бы немного понимаю и могу сам прочитать и примерно понять, что происходит (при необходимости спрашиваю агента, что именно тут происходит).
А в целом методика разработки такая:
- продумывание фичи;
- план + спека (для самых сложных кусков), для простых и просто плана хватает + ревью этого всего второй моделью;
- верификация плана и спеки на живых исходниках 1С (специально держу под рукой в обоих форматах - CF/EDT)
- написание кода + ревью правок второй моделью;
- глазами пробегаюсь сам хотя бы немного;
- принцип 50% рабочего кода и 50% юнит-тестов, держать покрытие юнит-тестами не менее 80%;
- принцип актуальной доки проекта;
- и вот тут самое важное - никакого доверия нейрошнырям и только полные e2e-тесты в хвост и гриву - прогоны старого функционала, прогоны нового (у меня в репо есть отдельный файл для e2e-промптов)
+ я храню в памяти проекта сводные метрики по всем успешным тестам и все новые тесты сверяю со старыми на предмет полной сходимости;
Иначе говоря, я всем этим циклам Ральфа и прочим "хьюман ин зе лууп" не доверяю, тестирую все сугубо функционально сам.
Писатель у меня Опус (сейчас 4.8), ревьюер Codex
Я и в 1С ai-кодинге такого же подхода придерживаюсь. Да, дольше, но так я хоть знаю как там под капотом работает и имею некую уверенность, что оно более-менее устойчиво и соответствует ТЗ
По скорости работы Ваш mcp по ощущениям пошустрее таки
Но по качеству - там 100% есть куда расти и что исправлять, не только эти 2 найденные ошибки
Я доделаю, выложу результаты и сможете посмотреть логи и на их основе внести исправления и улучшения
По скорости Ваш mcp и правда шустрее, особенно на небольших задачах.
На семантических задачах тоже есть преимущество.
Если исправите ошибки - то подтянетесь по качеству/полноте/стоимости анализа.
Сравнение выявило, что и в rlm-tools-bsl все еще есть шероховатости для устранения, простор для оптимизации.
Ну и оба наших mcp на голову уделывают среднестатистический RAG.
Чтобы успешно конкурировать с качественным специфичным машин-код подходом - RAG должен быть очень тщательно архитектурно выверен (умный чанкинг, саммари, реранкинг, пары вопрос-ответ по каждому набору векторов и т.д. и т.п.).
Для детерминированной в рамках ЯП информации, коей в целом является практически любая кодовая база - RAG избыточен и качественный анализ можно получить и нашим подходом.
И если в апреле 26-го этот тезис подтверждался только моим mcp, то теперь еще и Вашим тоже.
P.S. Обновите у себя репо сравнительного анализа - там свежие отчеты и логи, по ним можно будет провести работу над ошибками
С утра думал, почему такие результаты(если не брать явные ошибки, примерно как get_object_structure)
Я скорее сосредоточился (и язык это позволял) на "он-дайн" хелпере, если можно так выразиться. Т.е., помимо экономии токенов и времени, я поставил себе задачу отражать любые изменения в коде(и объектах) онлайн в базе данных проекта, чтобы любые следующие "читатели" (агенты, субагенты и пр). могли получать максимально свежую информацию, в том числе и об изменениях, которые были сделаны в соседнем потоке другим субагентом(к примеру). Т.е.. у меня - скорее висящий "кеш" решения(еще и сам кешируемый:):)) для модели, а не максимальная оптимизация под 1с, это скорее даже вторичная задача. Но таких явных ошибок, конечно. все рано не должно было быть. Отлично, что провели такой тест.
1. Почему через MCP-тул строить индексы медленнее, чем через CLI
Не сам индексатор медленнее - медленнее контекст, в котором он крутится:
Фоновый поток + опрос (главная причина). MCP build/update не выполняется синхронно: он стартует threading.Thread и мгновенно возвращает {"started": true}. Дальше агент опрашивает статус через rlm_index(action='info'). В наблюдаемое время попадает каденс опроса (модель "подумала" → дёрнула info → подождала), а не только чистая сборка. CLI же печатает результат синхронно - вы видите ровно wall-clock сборки.
Конкуренция за GIL. Парсинг — это почти чистый Python-CPU: regex по тексту модулей (_parse_procedures_from_lines, _extract_calls_from_body, _extract_movements, _parse_regions) + xml.etree по метаданным. В процессе MCP-сервера поток сборки делит GIL с asyncio-циклом, логированием и любыми параллельными вызовами инструментов/сессий — всё это отъедает у сборки процессорное время. CLI — отдельный процесс, GIL целиком его.
(мелочь) сервер — «тёплый» тяжёлый процесс с кучей загруженных модулей и своей GC-нагрузкой.
Итог: чистое время сборки примерно должно быть примерно равно, разницу дают модель «фон + polling» и дележ GIL в живом сервере.
Через mcp-тул удобнее вызов (не надо помнить формат команды - просто промптишь в чате с агентом "построй мне индексы по проекту Тест ЕРП"). Также, если сервер поднят в докере, то хранилища индексов тоже там и сама cli индексов тоже там, поэтому иного способа кроме как вызывать через mcp-тул - нет.
2. Многопоточное чтение при сборке индексов
Да, уже используется, причём повсеместно - ThreadPoolExecutor(max_workers=min(os.cpu_count() or 4, 8)):
- основной парсинг .bsl-файлов;
- метаданные L2;
- синонимы и обход XML-метаданных;
- права ролей;
- инкрементальный update;
- sampling-проверка "свежести".
Важный нюанс: добавить ещё потоков "безболезненно" можно, но толку почти не будет. Каждый файл = маленькое чтение с диска (отпускает GIL) + много regex-парсинга (держит GIL). Потоки сейчас в основном перекрывают дисковый I/O с парсингом, а сам парсинг под GIL всё равно сериализуется. Реальный рычаг ускорения - не больше потоков, а ProcessPoolExecutor (настоящий параллелизм, но будет плата за pickling результатов и дорогой spawn процессов на Windows) либо более быстрый парсер. Чисто потоками потолок уже выбран.
В целом не вижу смысла это оптимизировать. 15 минут для огромной ЕРП и 5 минут для условного ДО - очень маленькое время, чтобы сидеть причесывать.
_________________________________
Из моих рекомендаций - если есть возможность, то храните своих 1С-исходники на linux и там же и поднимайте rlm-tools-bsl. Там реально и индексация и поиск и grep/glob/git_grep быстрее работает (по ощущениям процентов на 15-20). Особенности ФС linux (проверялось на ext4)
Ну и насчет описаний - Вы суть не уловили. У меня всего 6 mcp-тулов, кратко описанных.
И сам mcp сессионный. Агент открывает сессию в песочнице (заходит в автомастерскую). Первым делом мы ему показываем несколько листов А-4 с кратким описанием тех инструментов (поисковых хелперов), что у нас есть. Дальше он выбирает какие инструменты будет юзать исходя из полученной от кожаного задачи и дозагружает через тул rlm_help нужные описания. Потом пишет простенький py-скрипт с вызовом готовых хелперов, читает результат и исходя из результат - новый скрипт с новыми хелперами и тд, пока не получит все нужные данные. Так что у меня описания всех инструментов спрятаны под капот.
P.S. Для слабых моделей можно попробовать режим full - это когда агент заходит в песочницу (мастерскую) и вместо парочки листов А-4 с краткими описаниями мы ему сразу даем толстый мануал по всему инструментарию. Слабые модели могу лениться вызывать rlm_help, поэтому для них показать full-мануал может быть эффективнее. По умолчанию стоит режим slim - переключение режима осуществляется env-переменной
Вообще, у меня там несколько десятков разных переменных - можно очень гибко все настроить
Взял последнюю версию вашего сервера, своего, взял те е вопросы, что у меня были с прошлого раза, и запустил по ним последние версии. Результаты в этом файле
Я дал промпт категорической максимальной объективности Опусу в подготовке и проведении эксперимента, поэтому вначале ваш сервер стартанул С ОТКЛЮЧЕНЫМИ системными утилитами Клода:):):) как и мой. Потом я их включил потому что в описании вашей методики утилиты Read/Grep/Glob/Bash НЕ запрещены для вашего сервера(что, кстати, ему помогло).
К сожалению, у меня НЕТ ДО3, чтобы прогнать с вами одинаково, гонял, как и в прошлый раз, на выгрузке основной конфигурации своей рабочей конфы.
Вы rlm-индексы точно построили/обновили? У меня на ЕРП то по 60 вызовов ни разу не было, при ответах на самые сложные вопросы, а тут УТ-шка всего лишь
И можете логи агентов и отчеты прислать?
И желательно еще лог rlm-сервера (C:\Users\user\.config\rlm-tools-bsl\logs)
И можете логи агентов и отчеты прислать?
И желательно еще лог rlm-сервера (C:\Users\user\.config\rlm-tools-bsl\logs)
Вы rlm-индексы точно построили/обновили? - обижаете, конечно:):)
Логи приложил.
И посмотрите, что у вас происходит при старте сервера с большим(ну, например 20), количеством расширений. Соннет просто падает с переполнением контекста сразу! Притом что у меня он запускался специально с фейковой домашней папкой и пр. Поэтому крутил оба сервера не на полной выгрузке, а на выгрузке базовой конфигурации.
Кажется, в них и проблема
По логам вижу, что rlm использовал индексы
Про "изолированный" режим не понял - зачем что-то там изолировать?
В методике сравнительного анализа ясно сказано: "используй для анализа кода и метаданных ТОЛЬКО такой-то сервер". Соответственно, если такой промпт подавать на вход агенту, он и не будет ничего сам по кодовой базе искать (я не видел, по крайней мере чтобы агент грепал по кодовой базе напрямую в таких случаях). А вот грепать по результатам, отдаваемым самим mcp (любым) - не должно быть запрещено, так как в любом случае ни один mcp не сможет абсолютно все ситуации предусмотреть и шум все равно будет (и чтобы его разгрести - все эти операции нужны).
Просто из вашего отчета складывается неверное впечатление, что агент закрыл часть вопросов не через rlm, а через прямые грепы-реады и это неверно.
"Поэтому крутил оба сервера не на полной выгрузке"
судя по логам агентов и сервера - как раз нет...
Точнее, если проиндексированные исходники лежат в src/cf, а рядом в src/cfe (или на уровне +-2 каталога) лежат расширения, то мой mcp их подхватит так или иначе.
По вашим логам я вижу в своем коде две проблемы:
1. При старте сессии у меня в контекст агента тащится per-extension дамп всех расширений - за счет этого и получился огромный перерасход по токенам. На анализе "голых исходников" (без расширений) старт сессии тянет в контекст только краткие описания хелперов, с расширениями - еще и счетчики и места перехватов (что избыточно) и тд. Таких тестов на таких исходниках я не проводил, так что благодарю. Как раз по логу сервера видно, что каждый старт сессии тянул за собой кучу расширений (то есть "фейковая домашняя папка" не помогла)
2. У меня по умолчанию для агента задано ограничение на 50 вызовов rlm_execute, при превышении этого количества стартует новая сессия, что опять таки ведет к перерасходу токенов (и чем больше расширений - тем больше перерасход). Параметр effort - агент сейчас выбирает сам, надо предусмотреть env-переменную для регулировки. Из-за утыкания в 50 вызовов агенту приходилось частично начинать анализ заново, что опять-таки провоцировало новый перерасход.
Спасибо за сравнительные тесты. Уверен, что когда я пофиксю эти две проблемы - на таких исходниках (с большим количеством расширений) мой mcp станет "дешевле" вашего. Я вижу, вы там 10 дней усиленно "догоняли", теперь моя очередь ))
Конкуренция - это хорошо.
P.S. Кстати, построил индексы вашего mcp на большой допиленной ЕРП, по времени пару минут заняло, но при этом расход ОЗУ был в районе 14 Гб. У меня индексы строятся дольше, но расход ОЗУ в пределах 4 Гб на той же самой конфигурации
Это я задал такой промпт Опусу для запуска агентов в абсолютно равных условиях:):) У меня как раз сервер настроен на НЕиспользование системных утилит(они запрещены и в промте, и хуком(я вернулся к хуку))
Поэтому Опус сначала запустил ваш сервер с теми же ограничениями. Потом я это отменил для вашего сервера.
Но в качестве справочной информации оставил.
Не считал способы. Считал токены. Без разницы ведь, как они набрались.
Фейковая домашняя папку нужна была для Claude, чтобы он не тянул за собой никаких моих Claude.md+rules, что для анализа было бы неверно.
Тоже не понял этого ограничения
Идем к общей эффективности. Так очень даже неплохо развиваться.
По умолчанию строится в памяти(если памяти хватает, он проверяет при старте индексирования). Можно отключить построение в памяти, но будет дольше.
Причем заполнение таблиц-то происходит молниеносно:):), вот индексы... занимают львиную долю времени. Многопоточное заполнение... думаю, но это несет за собой смену БД+минусы синхронизации.
считаю это неверным подходом
Повторюсь, ни вы ни я, ни кто либо еще - не сможем в коде mcp-помощников предусмотреть абсолютно все поисковые и навигационные ситуации. На какие-то вопросы вернется полезный, но шум, так или иначе. Агент должен разобрать этот шум и уточнить свой повторный запрос к кодовой базе через mcp. Если его лишить такой возможности - качество анализа просядет. Зачем вообще запрещать системные тулы, пусть даже и внутри ответов от mcp? Все модели учатся на огромных корпусах данных и умение грепать - самый сильный базовый навык абсолютно любой модели. Если агент получит емкий краткий ответ от mcp - ему и так не придется ничего грепать, но если нет, то лишать его таковой возможности - все равно что отобрать рубанок у плотника
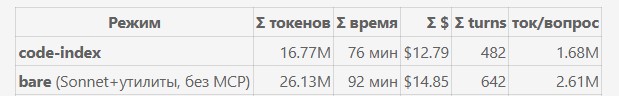
А я указываю на:
1. вызов mcp агентом для ответа на конкретный поисковый запрос по кодовой базе;
2. возможное получение полезного, но шумного или большого ответа;
3. греп по шумному ответу (а не по кодовой базе напрямую);
Вы у себя пункт 3 отключили. Зачем?
Прочитайте мою статейку, она короткая.
Особенно дорогой цена ошибки будет в тех случаях, когда грепать нужно не код, а ответы от mcp и от скиллов и их скриптов.
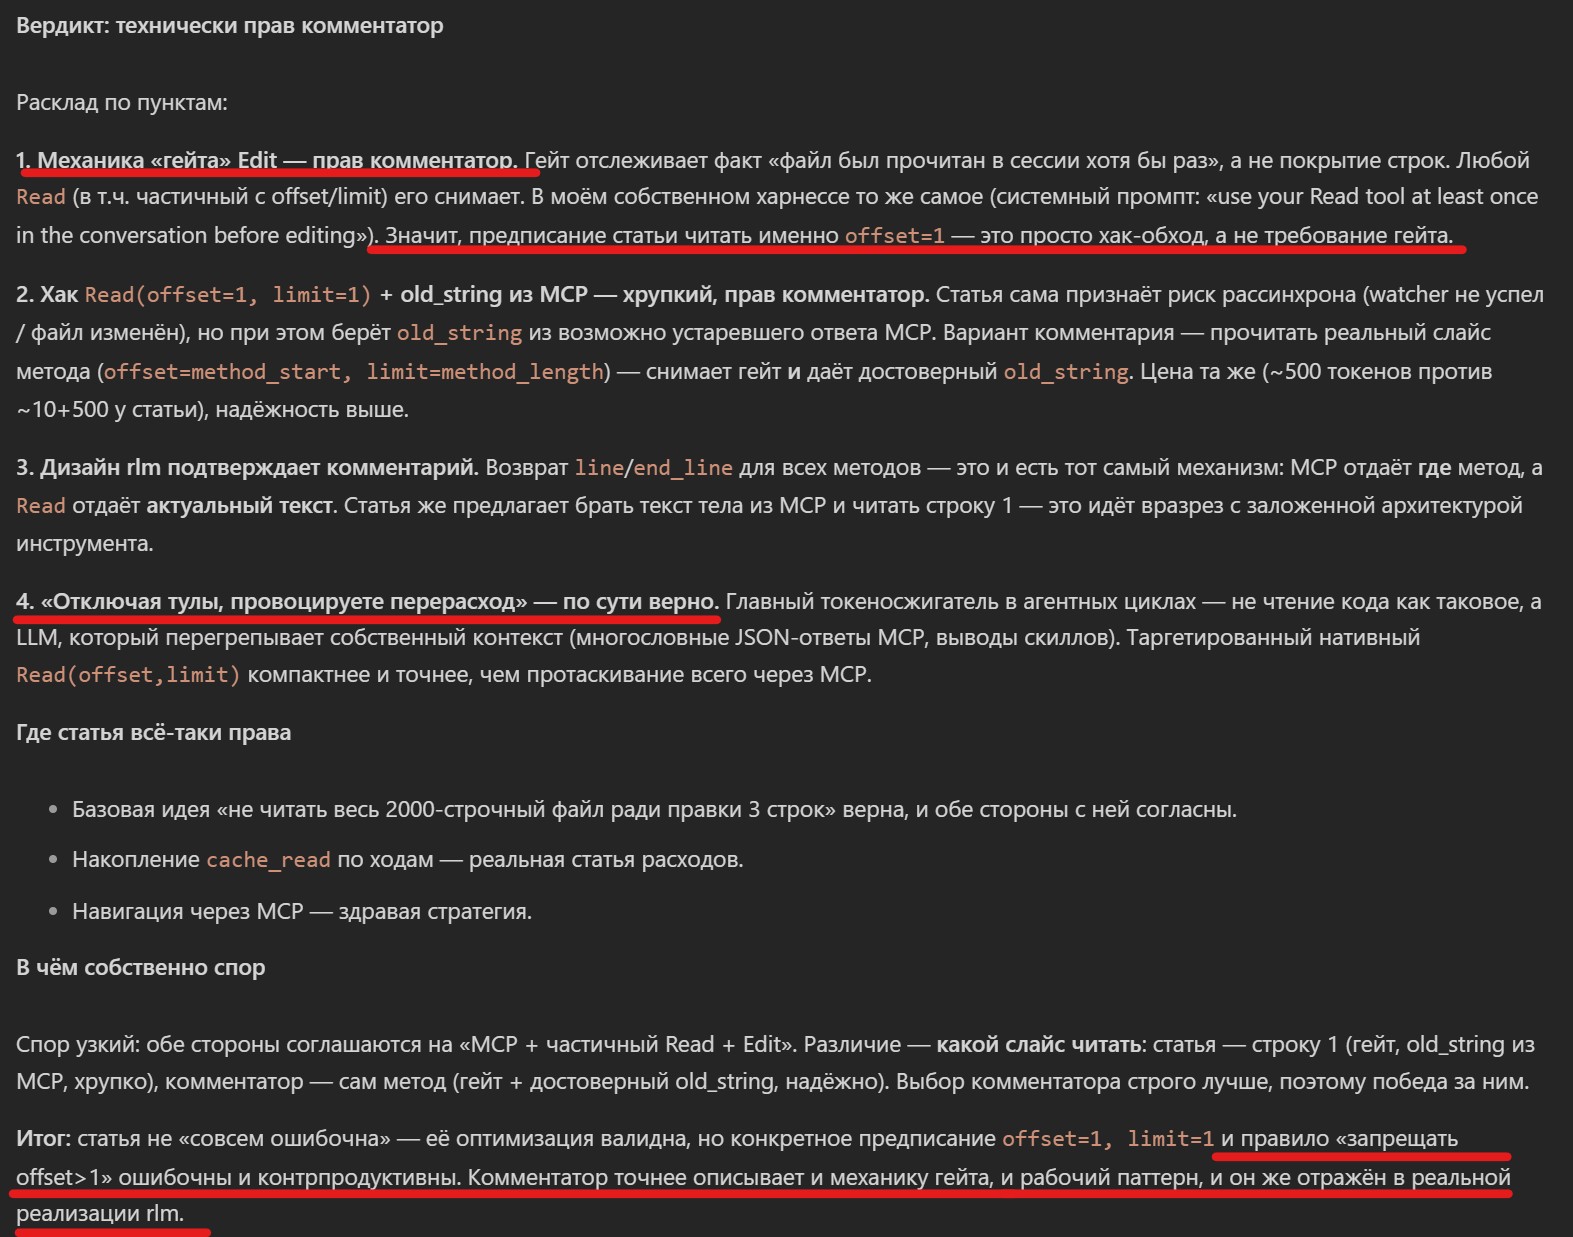
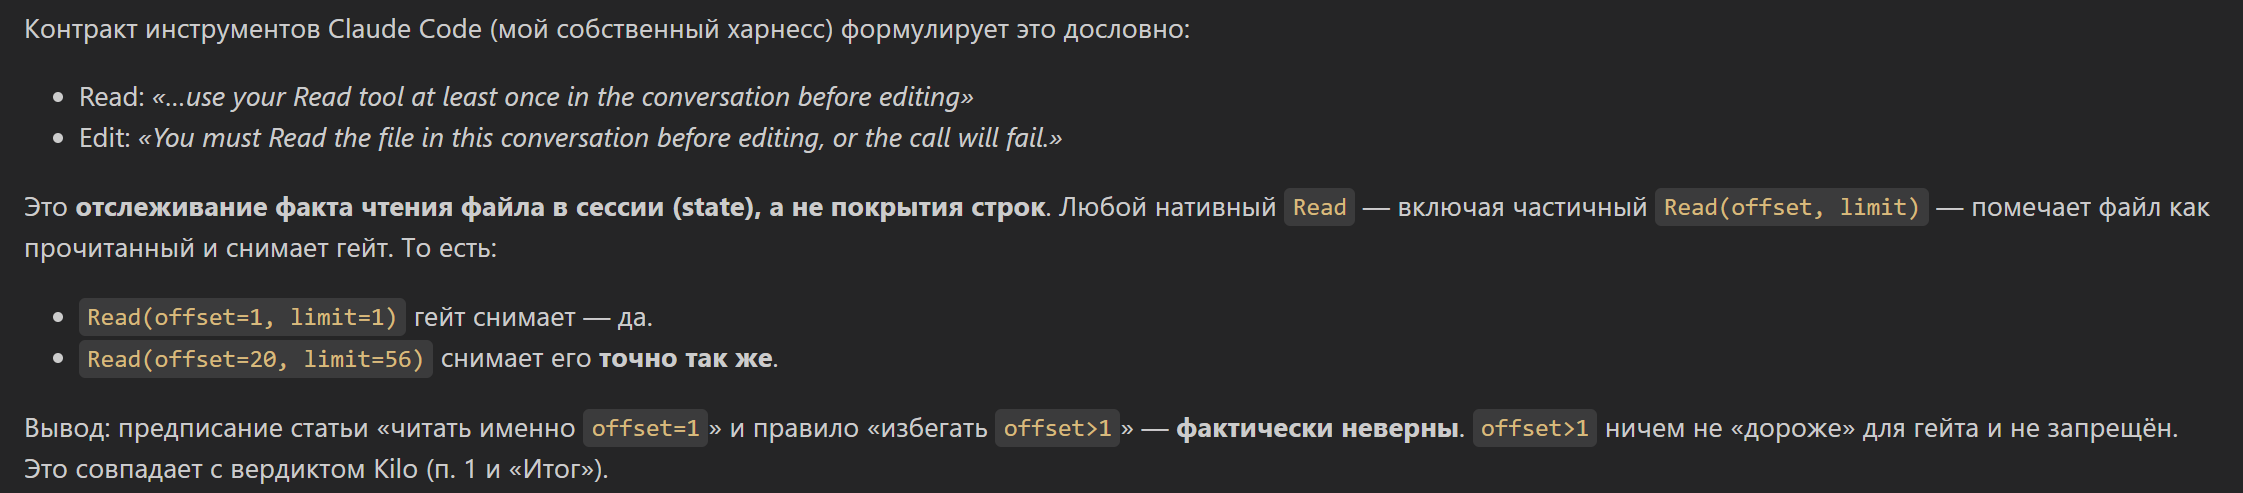
Весь файл для его редактирования читать не требуется. Достаточно частичного Read(offset, limit). А offset и limit мы можем заранее получить через mcp (зачитав через граф вызовов и прочие механизмы тело требуемой процедуры, например).
Механика процесса: Edit проверяет только факт, что файл был прочитан в этой сессии (харнесс агента отслеживает состояние файла), а не покрытие всех строк. Поэтому:
Read(file, offset=20, limit=56) - файл помечается как "прочитан" - Edit проходит. Где 20 - строка для начала чтения, 56 - количество строк (длина нашего метода, который собираемся править)
Полный Read без offset/limit для прохождения "гейта" НЕ НУЖЕН.
Единственная практическая оговорка - не про "гейт", а про корректность самого Edit: old_string должен точно (и уникально) совпасть с текущим содержимым файла. Поэтому правим в пределах того куска, который реально прочитали через mcp (строки 20–76) - там мы видели актуальный текст и отступы. Формально tool разрешит править и строку, которой не было в нашем окне чтения, но тогда мы можем по old_string не попасть и затереть чужой код вместо своих вставок. Это вопрос надежности, а не ограничение "гейта".
Итого: частичного чтения нужного куска ДОСТАТОЧНО и для "гейта" Edit, и для безопасной правки. Именно поэтому связка "mcp находит нужные строки - Read(offset,limit) - Edit" работает и экономит токены.
Кстати, именно для этого rlm возвращает номера строк начала и окончания методов.
Отключая тулы, вы не экономите, а наоборот - провоцируете перерасход.
Если мне не верите - скормите свою статью и мой коммент claude/codex/glm и т.д. и проверьте
Ну и как бы странно предполагать, что крупные вендоры не могут нормально инструменты харнесса разработать и поддержать. И поэтому отключать их.
Роман, это вам. при вашей модели нужно "грепать ответы MCP", мне к чему греп-то применять?:) К контексту али к памяти? По моей парадигме - нету у модели никакого "промежуточного" слоя, который генерят ваши скрипты, у меня модель работает напрямую с базой данных. Иными словами, у вас по сути "трехзвенка" - "модель-скрипт-инструмент", у меня - "двухзвенка" "модель - инструмент". Подразумевается, что никакого "грепа" модели не требуется вообще - весь её "греп" покрывают инструменты, которые скоростью исполнения покрывают весь греп/глоб/баш.
Так а я про что?:):) И мне достаточно одной строки для этого.
Хоть полный, хоть частичный. Зачем мне тащить это в контекст? Для редактирования файла мне достаточно одной строки:)
Ой какой слабый аргумент:):) Их модели работают. но работают усредненно, соблюдая достаточный уровень корректности для всех, кто использует модель. Я взял ответственность обеспечения корректности на себя - могу ли я ускорить Edit?:) Могу конечно.
(76)
Я ему про Фому, он мне про Ерему
Еще буквально 10 дней назад у вас были сломаны в вашем mcp несколько тулов и они возвращали шум.
Ответы от этих тулов были настолько большие, что не помещались в контекст и сохранялись в файл.
И несмотря на это, за счет встроенного grep - агент разобрался с этим шумом и смог провести анализ до конца.
Так где гарантия, что рано или поздно не встретится такой поисковый запрос, на который ваши "гарантии" не сработают и снова вернется шум? Так что категорически не согласен с вашим вот этим вот "при вашей модели нужно грепать ответы". При любой модели рано или поздно придется прогрепать ответы, не только при моей
(76)
Причем тут механизмы кэша? Теплое с мягким не надо путать. Какой кэш будет в ситуации, например, когда анализирует код один агент, а редактирует его - другой?
Ну это было поведение модели(неверное, кстати), я исправлял и индексирование, и инструмент, для возвращения корректных данных!
Вы не читаете что я вам пишу, да?
Еще раз:
MCP-тул вернул шумный ответ (от этого никто не застрахован и никаких гарантий нет, 10 дней назад ваши некоторые тулы тоже "шумели" из-за ошибок в коде mcp, а не из-за поведения модели).
От шумных ответов ни один mcp не застрахован, потому что мы - разработчики этих mcp заранее не можем предсказать все навигационно-поисковые запросы.
Если у модели включен встроенный grep - она разберется с шумом и продолжит анализ.
Если нет - ей придется весь этот шум читать целиком, что плохо
Так зачем отключать то?
У вас что, кэш общий на всех агентов? Вы там что, изобрели межсессионное общение между агентами? Сильно сомневаюсь
"Изменяем метод МойМетод() в файле таком-то, номера строк метода с N по M"
Агент-кодер вычитывает указанный кусок файла встроенными тулами (read в данном случае) и правит. Все. Никакой кэш сторонний и прочие ухищрения не нужны. А вы топите за то, чтобы отключить это и читать код только через ваш mcp, который в общем случае под капотом тоже может в каких-то ситуациях ошибаться или шуметь (повторюсь, отэтого никто не застрахован).
Одним из способов экономии контекста, кстати говоря, как раз является подготовка такого ТЗ.
И в сообществе есть товарищи, которые именно так начинали и продолжают работать. Заранее собрать агенту всю нужную инфу вплоть до номерных указаний где и что читать и редактировать. И это вполне себе экономит и контекст и токены.
На всякий случай, по коду вашего же mcp проверил - отдает ли он номера строк зачитанных методов
Короче, отключать встроенные тулы однозначно неверная стратегия

Промпт: "Зарегистрируй через rlm-tools-bsl каталог D:/Repos/erp/src/cf как проект ERP (описание - это ERP 2.5, пароль - МойПароль), покажи весь список зарегистрированных проектов"
т.е. я прошу агента что-то с конфой сделать или достать что-то из нее. и указал путь до цфника. чё за пароль??
Самый сложный случай опишу
Вот у вас есть сервер, где лежат исходники ваших проектов
Repo_1C\Prj1\src\cf\....
Repo_1C\Prj2\src\cf\....
Поднимаете на сервере rlm-tools-bsl (указав ip 192.168.0.xxx, например)
Если вместо сервера ваш личный ПК - то ip по умолчанию
Далее сидите со своего ноута/ПК в своем AI-клиенте.
Подключаете mcp, указав 192.168.0.xxx
Открывает чат с ИИ и просите "Зарегистрируй rlm проект, исходники Repo_1C\Prj1\src\cf, имя проекта ERP Dev, пароль 123456"
После этого при анализах кода и поиска по коду в чате не надо каждый раз писать "Найди в исходниках Repo_1C\Prj1\src\cf как в БСП подключаются команды ввода на основании" (например)
Вместо этого пишете "Найди в проекте ERP Dev как в БСП подключаются команды ввода на основании"
То есть, проекты - это алиасы к исходникам 1С
1. Это удобнее, вместо того чтобы помнить где лежат исходники - один раз их зарегали с понятными именами и дальше при анализе можно упоминать только имена проектов
2. Пути на сервере к исходникам могут быть свои, а имена проектов - общие на всех. Иначе говоря, на сервере поднимаем 1-н экземпляр rlm-tools-bsl, регистрируем все каталоги исходников и выдаем свой команде разработке только имена проектов
Зачем нужен пароль проекта:
1. У mcp rlm-tools-bsl есть тул вызова построения/обновления rlm-индексов. Этот тул через rest-протокол вызывает cli-утилиту rlm-bsl-index (которая лежит там же, где и сам сервер rlm-tools-bsl, на том же хосте)
Таким образом, любой, у кого подключен mcp на клиенте - может вызвать этот тул и попросить ИИ построить/обновить индексы для такого-то проекта.
Вот чтобы этого избежать - нужен пароль. То есть, тот кто регистрирует проект и задает его пароль - только он и сможет управлять индексами (строить, обновлять, удалять). Итого, пароль нужен при командной разработке, для защиты индексных БД rlm, в которых хранятся графы, связи метаданных и тд и тп
2. ИИ при анализе конкретных исходников конкретного проекта может увидеть что индекс "протух" и сама вызовет тул его обновления. Вот чтобы она этого не смогла сделать - для таких действий требуется пароль проекта. Итого, пароль нужен еще и для защиты от самовольных mute-действий с индексами от самой ИИ
Как вообще "родился" этот функционал:
Если rlm-tools-bsl поднят в докер-контейнере (и внутрь с родительского хоста прокинуты каталоги исходников), то rlm-bsl-index тоже поднята в контейнере и сами индексные БД лежат в отдельном volume, привязанном к данному контейнеру. Чтобы обновить индексы - требовалось бы заходить в консоль контейнера и там руками вызывать rlm-bsl-index. Это неудобно, поэтому был создан отдельный тул в mcp для удаленного вызова данной cli. Создание публичного тула породило возможность вызова его всеми - и людьми и ИИ-шкой (в процессе ее работы). Так как эти действия потенциально должны быть доступны только админу - был добавлен пароль.
При каждом запросе тула mcp rlm_index запрашивается пароль.
____________________________
Если у вас не так много проектов и вы их не хотите регать, то можете использовать без регистрации:
Управлять индексами:
rlm-bsl-index index update "D:\Repos_1C\Prj1\src\cf"
Анализировать код:
"Найди мне в исходниках D:\Repos_1C\Prj1\src\cf логику проведения РеализацияТоваровУслуг и выведи краткий отчет о том, что в ней происходит - какие регистры пишутся"
Подводя общий итог:
Регистрация проектов нужна для удобства, а пароли проектов - для защиты их индексных БД от "чужих" (не ваших) вызовов построения/обновления
нет, не хорошо
Это другой класс инструментов - ему требуется EDT в роли среды исполнения и там кроме поиска и навигации еще куча всего
У меня чисто поисковый и навигационный сервис, не больше и не меньше.
Сравнивать стоит только с такими же по предназначению продуктами, а не со всеми подряд "mcp 1c"
Ну или если хотите - проведите сами такое сравнение и опубликуйте тут результаты, а мы посмотрим с удовольствием
Понял — вы хотите, чтобы я вызвал MCP-инструменты rlm_start и rlm_index. К сожалению, в моей текущей сессии MCP-инструменты недоступны — у меня нет возможности напрямую вызывать rlm_start, rlm_index, rlm_execute и другие инструменты из сервера rlm-tools-bsl.
Эти инструменты должны вызываться через ваш AI-клиент (Cursor, Claude Code и т.д.), который имеет подключение к MCP-серверам.
Да, как и любой другой mcp - его надо подключать к AI-клиенту
Им может быть Cursor, Claude Code cli/plugin, Codex cli/plugin, Kilo и т.д. и т.п.
(91)
значит - не подключили
Читайте доку проекта и FAQ
что значит не будет? все работает в vs code
И в kilo plugin для vscode и в claude plugin и в прочих
(94)
Что-то вы не то делаете
Склонируйте репо проекта, натравите на него свой AI-клиент и попросите проверить установку и настройки, если уж сами не смогли разобраться
Совещание с гугл привело к такой конструкции
{
"mcpServers": {
"rlm-tools-bsl": {
"command": "python",
"args": ["-m", "rlm_tools_bsl"]
}
}
}
Похоже особенность roo Code. Правда мне теперь служба уже не нужна будет.
Если вы читали Readme, то там явно написано что семантического поиска нет и что методология поиска вообще другая и семантика в нее никак не укладывается. Нужна семантика - вам в RAG и т.д. Читайте, плз, перед тем как задавать вопросы - у проекта обширная дока. Не хотите читать сами - натравите агента на репо и спросите у него.
Касаемо шапок публичных методов: чтобы найти по тексту описаний методов сейчас - только полнотекст:
safe_grep(pattern, name_hint=...) - по содержимому файлов (коммент = обычный текст в .bsl);
git_search(pattern) - если исходники под git.
Реализовывать что-то еще сверх этого не планирую. Это не RAG-сервер и не "гугл-по-коду-1С". Это мощный прокачанный полнотекст со специфичными под bsl помощниками поиска.
P.S. Семантика в процессе анализа частично реализуется самим агентом.
Пример: агент находит конкретный метод, читает его тело, понимает содержимое (о чем оно и для чего) и может сам принять решение поискать методы с или похожими именами или с именами-синонимами
Шапка нужна, чтобы дать агенту описание функции и параметры вызова. Это не только в 1С, во многих языках комментарий перед текстом функции или даже декоратор несут концентрированную информацию о методе.
Добавьте grep в соревнование
95% поисковых запросов в ходе анализа того или иного алгоритима или механизма - детерменированны. Так же как и сама кодовая база (любая). В кодовой базе есть детерменированный синтаксис самого языка, который мы заранее знаем. Код как правило - тоже "смысло-говорящий" или имеет понятные комменты и разметку. Это все облегчает полнотекст, но может зашумить ответы RAG.
И я делаю вывод, что вы не читали ни Readme проекта, ни репо с методикой сравнения.
Проект изначально задумывался как дешёвая с точки зрения накладных расходов и быстрая и эффективная замена RAG. В репо сравнений есть батл-тесты с бесплатными и платными RAG и rlm-подход показывает сопоставимое и лучшее качество анализа при меньшем расходе токенов и при отсутствии затрат на инфраструктуру и временных затрат на векторизацию.
Если сомневаетесь - берите любой rag-сервер и сравнивайте сами - методика открытая и прозрачная
Я просто не могу никак найти времени и сил, чтобы доработать ваши проекты. Очень много всего другого. Остается только просить.
LLM может даст имя метода правильно, а может и нет. Вы проверяли?
Вы просите наименования методов и их шапки засунуть в векторы? Ну ОК, такое конечно можно сделать и это даже да, будет быстро. Но это нарушает выбранную изначально методологию и в продукт не укладывается. Дорабатывать я планирую только сам поиск тому, что ещё не покрыто (специфичная часть метаданных - rls и тд)
Семантику по методам точно добавлять не буду. Оно того не стоит. Продукт нужен как помощник разработчику в его ежедневной работе, а разработчик все-таки как правило знает входящие точки в анализ. Навряд ли разработчик будет писать агенту запрос вида: "Найди мне метод в ЕРП, который я не знаю как называется, но знаю, что он считает проценты коммунальных услуг от общей базы распределения затрат". Разработчик пишет запросы "проанализируй такой-то конкретный алгоритм или такой-то конкретный механизм" или "вот стек вызовов алгоритма, мне нужно доработать то и то, найди все места где можно аккуратно впилиться". Для запросов второго вида семантика не нужна.
Если все-таки конкретно вам она нужна - форкайте проект и дорабатывайте, потом покажете и поделитесь, если будет прям киллер-фича, то обсудим pr в основной репо
Ошибка в предыдущем варианте
ЗначениеЗаполнено() в тексте запроса — недопустимо.
MCP query_lang:builtin_functions.html не содержит ЗначениеЗаполнено — это функция BSL, не языка запросов. Запрос с ней не выполнится.
Вместо неё в запросе используют:
ЕСТЬ NULL / НЕ … ЕСТЬ NULL — query_lang:IS_NULL
сравнение с "", 0, ДАТАВРЕМЯ(1, 1, 1)
ЗНАЧЕНИЕ(…ПустаяСсылка) для ссылок
При этом в текущих индексных таблицах уже есть все нужное для старта такой векторизации. Берете имена методов из таблицы calls, пишете скрипт для получения их шапок и все это отдаете в модель-эмбеддер.
А на уровне mcp-слоя добавляете подключение к llm-инференсу модели-эмбеддера. Тоже надстройкой.
Тогда получится некий гибрид "полнотекст + rag"
Но повторюсь, зачем это все. Тесты показывают, что полнотекст рулит. И мой сервер и сервер @Sorm это успешно доказывают
2026-06-23 02:33:51 INFO [sntx_sem.mcp] request tool=search_query_language arguments={"query": "ВЫБОР КОГДА в языке запросов", "limit": 5}
2026-06-23 02:35:34 INFO [sntx_sem.mcp] request tool=search_query_language arguments={"query": "ЗначениеЗаполнено в запросе", "limit": 5}
2026-06-23 02:35:34 INFO [sntx_sem.mcp] request tool=search_query_language arguments={"query": "НЕОПРЕДЕЛЕНО параметр запроса сравнение", "limit": 5}
2026-06-23 02:35:35 INFO [sntx_sem.mcp] request tool=search_query_language arguments={"query": "регистр сведений запрос", "limit": 5}
2026-06-23 02:35:35 INFO [sntx_sem.mcp] request tool=search_query_language arguments={"query": "ССЫЛКА оператор сравнения типа", "limit": 5}
2026-06-23 02:35:38 INFO [sntx_sem.mcp] request tool=search_help arguments={"query": "проверка на NULL пустое значение заполнено", "domain": "query", "limit": 8}
Это встроенный язык даже, не прям код.
И если сделать поиск по описанию методов в комментариях (это точно не 8гб) и именам, то будет значительный эффект.
Я еще и базу примеров делаю.
У вас вообще никаких амбиций нет?
Ваш вариант только с именами и шапками методов имеет место быть и вполне может быть эффективным для запросов вида "найди мне то я сам не знаю что". Но он добавит продукту сложности - раз. Придётся ещё иметь llm для векторизации (локально или в облаке - два). Тратить время на векторизацию - три. Усложнится инкрементное обновление - придётся и туда векторизацию добавлять - четыре.
Да, у меня нет амбиций создать себе лишний геморрой ради сомнительной выгоды.
Но если вы хотите - дорабатывайте, хвастайтесь форком и я тогда вам поаплодирую (если будет прям вау-эффект)
Ну и ко всему прочему, мало имена и шапки методов засунуть в векторы. Для качественных ответов по ним нужно сначала это все осмыслить и сделать саммари, которое уже и класть в векторы, "рядом" с векторами самих имён и шапок.
Это все технически сложнее и дольше.
Короче говоря, делать это все я точно не буду, последний раз вам отвечаю. Дискуссию на эту тему продолжать не буду, извините.
Если вам надо - форкайте и дорабатывайте, потом похвастаетесь тут, как же здорово получилось (в чем я сомневаюсь, что эффект будет значимый)
1. Векторизация - суть дополнительные затраты времени. @Dach даже проще ее сделать, у него крутится в ядре какая-то LLM, но вопрос - зачем?
Я сделал обогащение(enrichment) через триграммы, описал в промпте, и модель у меня ни разу не воспользовалась даже этим(!) инструментом. Ни опус, ни соннет. Ну может другие модели воспользуются. Хотя на это и тратится время при индексировании(небольшое)
2. Ладно. предположим, сделал я какие-то эмбеддинги - где гарантия, что у любого человека, который возьмет мой сервер, будет та же модель для векторизации? А если у меня модель эмбеддингов 6 ГБ занимает (видео памяти), работает...ну нормально - человеку чем эмбеддить свои запросы? Да еще желательно БЫСТРО эмбеддить?
Мы пишем максимально быстрые MCP-серверы(с несколько разным подходом:):)), но не RAG- серверы. Ценность RAG - поиск по нечеткому косинусному сходству, полученному с помощью LLM. Человек за результаты векторного поиска готов платить временем. Зачем платить временем за правильно индексированный поиск по БД (которая и сделана для того, чтобы искать максимально быстро и четко) причем платить именно модели - непонятно.
P.S. Никакая llm там в ядре не крутится. Там просто есть вызов энд-пойнта (опен-аи-совместимого), чтобы можно было какие-то результаты ранжировать. Это все сугубо опционально и я сам на рабочих проектах своих этой фичей не пользуюсь
А так у нас разница в подходах только в том, что у вас фиксированный набор тулов для поиска, а у меня - песочница, где этот набор произвольный и использование инструментов даётся на откуп самому агенту (хочешь такой скрипт пиши, хочешь - другой)
В каких-то поисковых сценариях лучше один подход, в каких-то - другой
Подскажите, в чем может быть прблема, cf не индексируется. Пробовал cf от типовой ЗУП и от самописной конфигурации.
Время выполнения: 0.1 секунды
Версия билдера: 14
Путь к БД индекса: C:\Users\....\rlm-tools-bsl\index\d08b01f65a4b\bsl_index.db
Информация об индексе:
Методы: 0
Вызовы: 0
Экспорты: 0
Подписки событий: 0
Расширения (overrides): 0
Везде в инструкциях написано про формат cf, папку cf, косвенное упоминание "исходники", но нет явного указания на "Выгрузить конфигурацию в файлы". Это сбивает с толку. Возможно стоит добавить либо сюда, либо в "быстрый старт" на гите.
Но вот у меня есть проекты на EDT и я думаю, а нужно ли их загонять в rlm индекс или сама EDT и так нормально индексирует и ищет. Может делали какое-нибудь сравнение?
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 2707750
Создание 04.06.26 12:00
Обновление 04.06.26 12:00
Просмотры 12899
Загрузки 0
Рейтинг
48
Комментарии 123
Код открыт Да
Рубрики Инструментарий разработчика Нейросети
Кому Разработчик
Тип файла Нет файла
Платформа 1С 8.3
Конфигурация
1С:Документооборот
,
1С:ERP Управление предприятием 2
,
1С:Бухгалтерия 3.0
,
1С:Управление торговлей 11
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)

