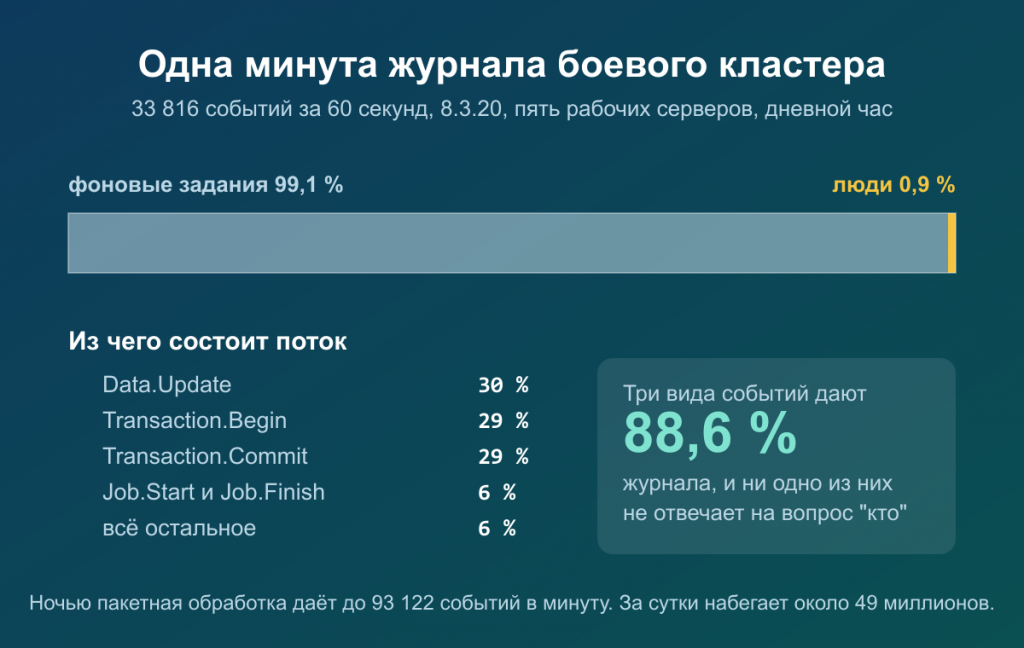
33 816 событий за одну минуту. Столько пишет журнал регистрации боевого кластера 1С из пяти рабочих серверов в обычный дневной час, и это без ночной пакетной обработки, которая поднимает поток до 93 тысяч в минуту. За сутки набегает около 49 миллионов строк. При этом вопрос, с которым администратор открывает журнал, почти всегда один из десятка: кто изменил, кто удалил, почему падает регламентное, что за ошибка повторяется, кто заходил ночью.
Я весь день гонял один и тот же инструмент по семи базам на трёх платформах и записывал, что журнал на самом деле знает о базе, чего не знает, и как из миллионов строк получить десять килобайт, которых нейросети хватает, чтобы разложить проблемы по приоритету. Числа ниже сняты штатным методом платформы, без SQLite, без ClickHouse и без прямого чтения файлов журнала.
Из чего состоит журнал боевой базы
Первое, что стоит знать про свой журнал: человека в нём почти нет. На кластере, с которого снята минута выше, 99,1 процента событий принадлежат фоновым заданиям. Людям остаётся около трёхсот строк из тридцати четырёх тысяч.
| Событие | Доля за 10 минут | Что это |
| _$Data$_.Update | 30 % | запись объекта или набора записей |
| _$Transaction$_.Begin | 29 % | начало транзакции |
| _$Transaction$_.Commit | 29 % | фиксация транзакции |
| _$Job$_.Start и _$Job$_.Finish | 6 % | старт и завершение фонового задания |
| всё остальное | 6 % | входы, откаты, ошибки, отказы, удаления |
Три вида событий дают 88,6 процента журнала, и ни одно из них не отвечает на вопрос "кто". Отвечают те шесть процентов, что в последней строке. Ровно на них и уходит внимание администратора, а платформа при этом пишет и хранит остальные девяносто четыре.
Розничная база на другой платформе показала тот же рисунок с другим составом: фоновых всего 29 процентов, зато 76 процентов журнала это начало и фиксация транзакций. Человек там виден лучше, но полезных событий в потоке всё равно меньше четверти. Практический вывод из этого раздела простой: прежде чем искать в журнале кого-то, стоит посмотреть, кто его пишет.
Почему полный поток не читается
Штатный способ получить журнал из кода один: метод ВыгрузитьЖурналРегистрации с отбором по датам, который наполняет таблицу значений. На нём стоит почти вся полка инструментов для журнала. Вот что он даёт на тестовой базе с платформой 8.3.27, где журнал сравнительно тихий.
| Окно | Событий | Время |
| 1 час | 651 | 150 мс |
| 6 часов | 3 516 | 783 мс |
| 24 часа | 96 499 | 23 056 мс |
| 30 дней | не дождался | таймаут через 30 секунд |
Скорость линейная, около четырёх тысяч событий в секунду. На боевом кластере с 49 миллионами событий в сутки это означало бы больше трёх часов на одни сутки при условии, что таблица значений на 49 миллионов строк вообще поместится в память рабочего процесса. Не поместится. Неделю таким способом не прочитать ни на какой машине, и это свойство подхода: оптимизация кода тут не поможет.
Дальше обычно предлагают выгрузить журнал наружу: в SQLite, в ClickHouse, в отдельную базу. Это работает, но это отдельная стройка с отдельным сервером, отдельным правом доступа к файлам журнала и отдельным человеком, который её поддерживает. Для вопроса "что у меня в базе не так" на утро понедельника это слишком много.
Отбор дешевле в 176 раз
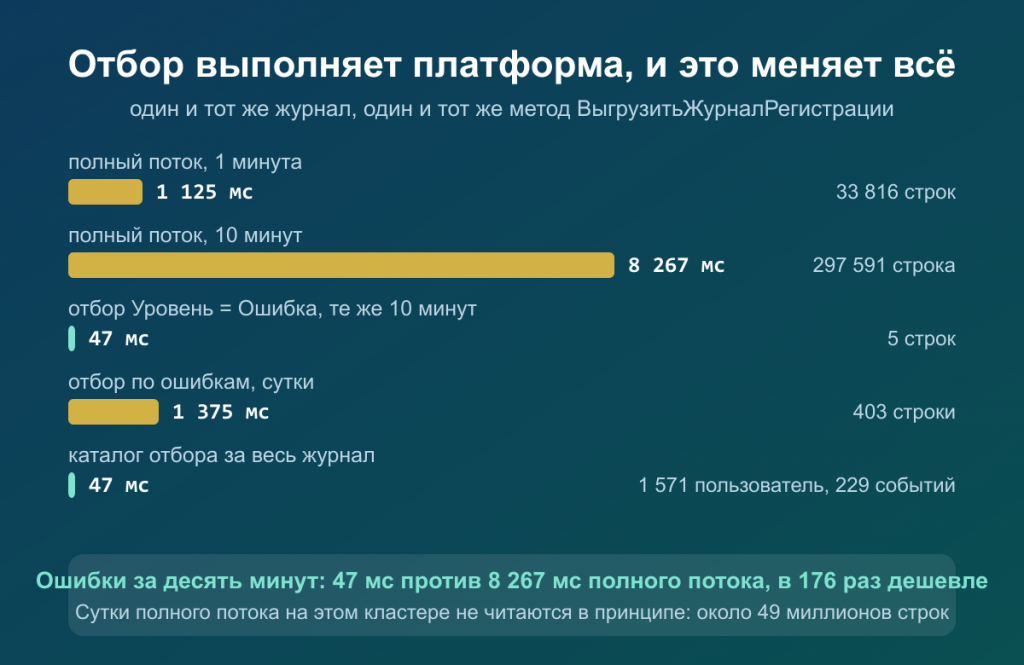
У того же метода есть параметр Отбор, и обычно его используют только для дат. Между тем отбор по уровню или по событию платформа выполняет у себя, на стороне хранилища журнала, и в таблицу значений приезжают только подошедшие строки. Один и тот же журнал, одна и та же боевая база:
| Запрос | Строк | Время |
| полный поток, 1 минута | 33 816 | 1 125 мс |
| полный поток, 10 минут | 297 591 | 8 267 мс |
| отбор Уровень = Ошибка, те же 10 минут | 5 | 47 мс |
| отбор по ошибкам, сутки | 403 | 1 375 мс |
| отбор по ошибкам, 7 дней | 3 114 | 47 473 мс |
| отбор по одному событию входа, 1 час | 828 | 1 438 мс |
Ошибки за десять минут: 47 миллисекунд против 8 267 у полного потока. Ошибки за неделю с боевого кластера читаются меньше чем за минуту, и это 3 114 строк вместо трёхсот с лишним миллионов.
Ещё дешевле оказывается то, о чём почти не пишут: метод ПолучитьЗначенияОтбораЖурналаРегистрации отдаёт каталог всех значений колонок за весь журнал, без чтения строк. На том же кластере это 1 571 пользователь, 339 компьютеров, 12 приложений, 229 видов событий и 5 рабочих серверов за 47 миллисекунд. Из него, кстати, строится карта псевдонимов ещё до того, как прочитано хоть одно событие.
Отсюда архитектура, которая читает журнал вопросами вместо строк. Ошибки, неудачные входы, отказы в доступе, изменения пользователей и конфигурации, падения заданий читаются отборами целиком за период, по суткам, свежие сутки первыми, чтобы усечение по времени отрезало самое старое. Объёмные потоки вроде входов, откатов и удалений сначала пробуются на последнем часе: если сутки стоили бы больше двадцати секунд, поток заменяется оценкой. А состав журнала и правки данных оцениваются по двенадцати коротким окнам, разнесённым по периоду. Полного скана нет ни в одном режиме. Всё это вынесено в отдельную обработку: Журнал регистрации для нейросети: тринадцать ответов с вердиктами, обезличенный снимок .md и книга .xlsx. Дальше в статье только то, что она показала.
Две грабли платформы 8.3.20, которые стоили полдня
Первая гипотеза была очевидной: раз полный поток опасен, поставим страховку через пятый параметр метода, МаксимальноеКоличество, и никакая порция не превысит лимит. На 8.3.27 это работает как задумано: лимит 100 отдаёт последние сто событий за 41 миллисекунду. На 8.3.20.2290 с отбором по датам тот же лимит в 5 000 вернул 25 301 строку, то есть не ограничил вовсе, и при этом сделал вызов в сорок раз медленнее: 30 секунд против 0,77 без лимита. Гипотеза снята, параметр в обработке не используется ни в одном вызове, и это первое, что стоит проверить, если ваш инструмент для журнала на старой платформе вдруг стал тормозить.
Вторая грабля тоньше. На 8.3.20 отобранная строка стоит от 0,3 до 2,6 миллисекунды, а строка полного потока 0,03. Значит "отбор дешёв" верно для редких событий и неверно для объёмных: входы за сутки на боевой базе это минута чтения, удаления две. Поэтому у объёмных потоков появилась часовая проба, а у редких событий свой бюджет времени. Вторая бухгалтерия того же дня подтвердила, что без пробы нельзя: одно сломанное расширение обмена давало 424 856 ошибок применения за сутки, и поток "редких" событий читал их семнадцать минут при обещанных трёх.
Что люди на самом деле спрашивают у журнала
Перед тем как выбирать вопросы, я разобрал 261 карточку раздела "Журнал регистрации" и 14 тем форумов по одному признаку: зачем человек вообще пришёл. Лидер с большим отрывом это "кто изменил документ и когда", около сорока пяти карточек, причём тридцать из них про версионирование, потому что журнал на этот вопрос отвечает только наполовину: кто и когда, но не что именно. Дальше "кто заходил и сколько работал", "какие ошибки и после какого обновления", "как сократить журнал, он занимает 90 гигабайт", "кто удалил", "почему упало регламентное", "неудачные входы и подбор пароля", "правки задним числом".
Из этого списка получилось тринадцать вопросов, и у каждого свой отбор, свой агрегат и своё правило вердикта: сколько повторов ошибки это "чинить", сколько неудачных входов с одного компьютера это перебор, какая доля откатов ещё норма. Вердикт и лечение печатает движок из реестра, модели достаётся диагноз. Это принципиально: то, что можно посчитать, считает код, а модель объясняет, что из этого следует.
Что нашлось в семи базах за один день
Один инструмент, один день, семь баз: тестовая торговля на 8.3.27, боевой кластер на 8.3.20, ERP и две розницы на 8.3.17, две бухгалтерии и ITIL на 8.3.27. Ни одна не оказалась скучной.
| База | Что показал журнал |
| ERP 2.4, 8.3.17, 300 пользователей | два расширения не применяются в каждом сеансе: 443 из 37 440 событий окон выборки, около ста тысяч записей за неделю. 12 305 ошибок отражения в регламентированном учёте за четыре ночи от одного задания, 91 процент всех ошибок. События входа отключены в настройке, при этом ошибок 13 585 и отказов в доступе 358: аудит выключен, ошибки пишутся |
| Розница 2.3, 8.3.17, 197 пользователей | 59 учёток входят с трёх и более компьютеров. 1 810 неудачных входов, из них 1 156 без имени пользователя 1С: это аутентификация операционной системы, у события в поле Данные лежит ПользовательОС. 26 571 удаление чеков ККМ фоновым заданием, штатное закрытие смены |
| Бухгалтерия 3.0, 8.3.27 | журнал выключен вовсе: ни одного уровня, каталог отбора пуст. Владелец ждал накопленной истории |
| вторая Бухгалтерия 3.0, 8.3.27 | 2 812 событий в минуту, 26 миллионов за неделю, из них 424 856 в сутки это ошибка применения одного расширения. Откатов в окнах 14 процентов от начатых транзакций |
| ITIL, 8.3.27 | журнал пишет только уровень "Ошибка". 1 550 из 1 583 ошибок это одно регламентное извлечение текста из файлов, каждые шесть минут круглые сутки |
| боевой кластер, 8.3.20, 1 571 пользователь | 403 ошибки за сутки это 35 разных текстов; лидеры "соединение с сервером баз данных разорвано администратором" 96 раз и "конфликт блокировок" 60. Семь дней журнала собраны за 106 секунд, 488 тысяч прочитанных строк |
Самая дорогая находка не про базы, а про журнал как источник. Входы, неудачные входы, отказы в доступе, откаты и удаления пишутся уровнем "Информация". Это замерено на 8.3.27 и 8.3.20 по колонке Уровень. Журнал, настроенный "только ошибки", по этой причине не содержит аудита вообще: ни кто заходил, ни кому отказано, ни кто удалил. Первая версия инструмента на такой базе честно отвечала "входов нет, отказов нет, удалений нет" с вердиктом "норма", и это была ложь по построению.
Шесть неправд, которых не видит самопроверка
У инструмента есть самопроверка из двенадцати сверок: итог ошибок против суммы по суткам, по пользователям и по текстам, входы против суммы по людям, прочитанное против суммы по потокам. На прогоне по ERP она сошлась двенадцать из двенадцати. В файле при этом стояло шесть неправд, и все шесть нашлись только глазами при сверке снимка с книгой xlsx.
"Неудачных входов за период нет" при отключённом событии: надо "не пишутся". "Изменений конфигурации 200": на самом деле ноль, а двести это потолок списка, забитый ошибками применения расширения из каждого сеанса. "Около 856 откатов в сутки" при одних прочитанных сутках: делили на период вместо прочитанного. "Пропущено суток: 8" за семь дней: проба часа считалась сутками. "Прочитано 3 из 6" при семи календарных днях: дни считались по секундам. И "verПОЛЬЗОВАТЕЛЬ_01məyib" в тексте ошибки: имя пользователя подставилось внутрь чужого слова, потому что замена шла подстрокой, а не целым словом.
Арифметическая сверка ловит потерю строк и не ловит неверный смысл. У каждой правды свой инструмент проверки, и для смысла этот инструмент пока один: положить рядом свод и полный состав и читать. На следующем прогоне той же ERP книга xlsx показала строку "Не отправлено письмо. Сотрудник: имя фамилия отчество", которую нормализация текста ошибки пропустила, потому что резала только по кавычкам и скобкам. Теперь режет и по двоеточию внутри строки.
Что нейросеть сделала с десятью килобайтами
Снимок это не журнал и не его выжимка построчно. Это сводка: что за база и что пишет журнал, таблица тринадцати ответов с вердиктами, лечение по вердиктам "чинить", топ ошибок, состав по окнам, изменения конфигурации и то, что осталось за кадром. Предел 10 240 байт, кириллица в UTF-8 это два байта на знак, то есть около пяти с половиной тысяч знаков. Если полный снимок не влезает, он собирается ступенями: сначала уходят таблицы состава и изменений, потом ошибки, но задание модели, шапка и таблица ответов остаются всегда.
Задание модели стоит в шапке файла, и оно короткое: отвечать как администратор 1С, по каждой строке таблицы дать диагноз и лечение, начать с "чинить", не придумывать чисел, которых нет в файле, а если данных не хватает, назвать, какое событие журнала и за какой срок нужно. Пустой раздел не значит, что проблемы нет: что журнал вообще пишет, сказано в первом разделе.
На снимке розничной базы за неделю модель начала с фразы "главное: чинить ошибки, а не пытаться оптимизировать журнал регистрации", потом перечислила шесть пунктов по убыванию: 320 одинаковых ошибок с одним пользователем, 106 ошибок "значение не является значением объектного типа", регламентное задание с четырьмя падениями, 1 781 откат транзакций как повод для отдельного расследования, 123 изменения пользователей, из которых 106 сделал один человек, и 162 неудачных входа, по которым "доказательств атаки недостаточно, но событие требует проверки". Про удаления двух чеков ККМ она написала "лечение не требуется", потому что в файле это помечено штатным закрытием смены.
И одно место, где модель оказалась осторожнее меня. Про долю фоновых заданий в правках она добавила: "файл содержит только 12 минутных окон, поэтому переносить эти пропорции непосредственно на каждую секунду работы базы нельзя". Это правда, и она стоила мне отдельного урока: на ERP два прогона в один день дали 91 и 4 процента фоновых в правках, потому что одно окно поймало массовую правку справочника размеров на 29 тысяч записей. Оценка по окнам подписана как оценка, и модель это прочитала.
Границы
Журнал знает, кто и когда записал объект, но не знает, что в нём поменялось: состав правок это версионирование, и никакой инструмент поверх журнала этого не изменит. Правки задним числом требуют даты документа, которой в журнале нет. Представления данных инструмент не читает нарочно: там лежат имена контрагентов и суммы, и в снимок для модели им нельзя. На платформе 8.3.17 с журналом в миллионы событий сутки ошибок стоят 10-20 секунд, и семидневный период честно режется до трёх-четырёх суток. Если это мешает, период стоит ставить три дня.
Открытым остаётся вопрос, на который у меня нет хорошего ответа. Если журнал на 94 процента состоит из событий, которые никто никогда не читает, какие из них вы бы отключили первыми у себя, и что вас останавливает?
Другие наши инструменты для работы с журналами и нейросетями:
- Матрица прав доступа для нейросети - следующий шаг после отказов в доступе из журнала: разбираться в самих правах, тем же способом, снимком для модели.
- Выгрузка метаданных для LLM - чтобы модель понимала, что за объекты стоят в ответах журнала: справочники, регистры и реквизиты одним файлом.
- Чек-ап СУБД под 1С - если лидер ошибок это конфликты блокировок и разорванные соединения с сервером баз данных, смотреть надо уже на СУБД.
- Анализ кода внешних обработок - когда в контексте ошибки всплыла внешняя обработка и непонятно, что она делает с базой.
Вступайте в нашу телеграмм-группу Инфостарт