Экономика внедрения ИИ в 1С-команде: где заканчивается хайп и начинается польза
ИИ умеет за несколько секунд подготовить запрос, объяснить модуль, составить документацию или предложить исправление. Такая демонстрация выглядит убедительно, но ещё ничего не говорит об экономическом результате. Между ответом модели и принятой задачей остаются получение контекста, проверка, исправления, тестирование и согласование.
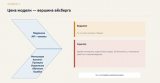
Поэтому главный вопрос для 1С-команды звучит не «насколько быстро ИИ пишет код», а «улучшает ли он полный процесс и какой ценой». Подписка и токены — только часть расходов. В расчёт входят интеграция, подготовка знаний, время экспертов, сопровождение и последствия ошибок.
Универсального процента экономии здесь нет. Экономика появляется у конкретного сценария: с известным объёмом задач, базовой линией, критерием принятого результата и измеримой стоимостью полного цикла.
Почему одного процента ускорения недостаточно
Исследования генеративного ИИ показывают очень разные результаты.
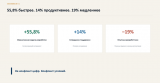
В контролируемом эксперименте GitHub и Microsoft разработчики с GitHub Copilot завершили ограниченную задачу на JavaScript на 55,8% быстрее контрольной группы. Это подтверждает значительный потенциал ИИ в задаче с ясным выходом и возможностью проверить результат. Однако эксперимент не измерял весь жизненный цикл промышленного изменения: требования, архитектурный контекст, ревью, интеграции, сопровождение и выпуск. Microsoft Research, 2023
В полевом исследовании NBER, охватившем 5 179 сотрудников клиентской поддержки, средний рост производительности составил 14%. У новичков и менее опытных работников он достигал 34%, а у наиболее опытных был минимальным. Средняя цифра скрывала большую разницу между сотрудниками. Brynjolfsson, Li, Raymond, NBER Working Paper 31161
В исследовании METR опытные open-source-разработчики решали реальные задачи в хорошо знакомых им репозиториях. При использовании ИИ-инструментов начала 2025 года они потратили в среднем на 19% больше времени. До эксперимента участники ожидали ускорения, а после работы всё ещё были склонны считать, что инструмент им помог.
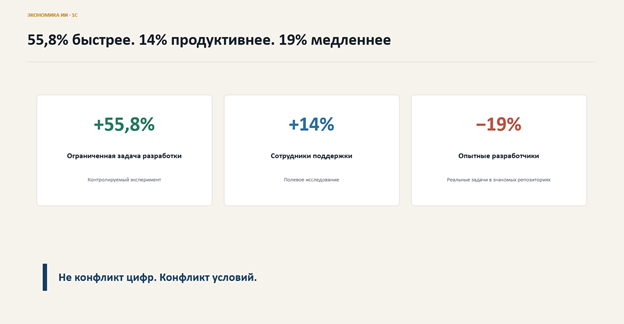
Эти выводы не обязательно противоречат друг другу. В исследованиях различаются задачи, участники, инструменты, контекст и границы измерения. Узкая лабораторная задача, работа новичка с типовыми обращениями и изменение сложного знакомого проекта — это разные условия.
Для 1С разброс может быть ещё сильнее. Один и тот же запрос в учебной конфигурации и в многолетней ERP с расширениями, интеграциями и неявными правилами имеет разную стоимость контекста и проверки. Поэтому внешний процент помогает сформировать гипотезу, но не подходит для бюджета без локального пилота.
Единица экономики — принятый результат
Ответ модели, выполненная операция и бизнес-результат находятся на разных уровнях.
- Ответ — текст, код или рекомендация, созданная моделью.
- Операция — действие, которое выполнил агент: создал файл, запустил тест или получил данные.
- Принятая задача — результат, прошедший необходимые проверки без существенной переделки.
- Бизнес-эффект — сокращение срока, очереди, повторной работы или фактических затрат.
Для расчёта полезнее всего принятая задача. Например, не количество сгенерированных тестов, а число тестов, которые прошли ревью и действительно используются. Не количество найденных аномалий, а доля рекомендаций, подтверждённых специалистом. Не скорость первого ответа на обращение, а время до корректной классификации и принятой гипотезы.
Сравнивать нужно два полных цикла: один без ИИ, другой с ИИ. У них должны быть сопоставимые задачи и одинаковый критерий качества. Если секундомер останавливается после генерации, а время проверки не учитывается, результат заранее смещён в пользу инструмента.
Полезно разделять активное время специалиста и календарное время цикла. ИИ может сократить ручную работу, но не повлиять на срок выпуска, если задача продолжает ждать ревью или приёмки. Возможна и обратная ситуация: прямые затраты почти не меняются, зато внутренний заказчик раньше получает результат.
Полная стоимость больше цены модели
Стоимость доступа к модели видна сразу: подписка, API-вызовы, токены или локальная инфраструктура. Остальные расходы часто проявляются позже.
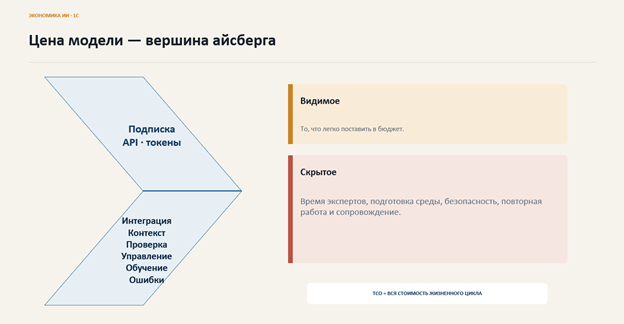
В полную стоимость владения ИИ-сценарием входят:
- Интеграция. Подключение API или MCP, выгрузка конфигурации, настройка ролей, журналов, тестовой базы и конвейера проверок.
- Контекст. Спецификации, стандарты, документация, Memory Bank и их регулярная актуализация.
- Проверка. Чтение ответа, ревью кода, тестирование, сверка метаданных и бизнес-логики.
- Управление. Политики, информационная безопасность, согласования и владельцы процесса.
- Освоение. Обучение команды и период, когда сотрудники экспериментируют с новым инструментом.
- Ошибки. Переделка, регрессии, инциденты, нарушение учёта и утечки данных.
- Альтернативная стоимость. Время архитекторов и ведущих разработчиков, которое можно было направить на другое улучшение.
Особенно легко недооценить человеческую проверку. Junior-разработчик может сэкономить час на подготовке кода, но если senior потратит почти столько же на поиск правдоподобной ошибки, эффект окажется намного скромнее. Поэтому время ревью на один принятый результат должно быть отдельной метрикой.
Также необходимо разделять фиксированные и переменные расходы. Настройка контура, подготовка источников и обучение возникают до первого результата. Вызовы модели и проверка каждой единицы растут вместе с объёмом. Частый сценарий лучше распределяет первоначальные затраты, однако при масштабировании может создать новую очередь у экспертов.
Ускорение одного этапа может замедлить систему
Представим, что до внедрения ИИ команда готовила пять изменений в неделю. Ревью успевало их обработать. После внедрения генерация выдаёт двенадцать черновиков, но мощность ревью не изменилась. Семь изменений ждут, переключают внимание и увеличивают объём незавершённой работы.
На уровне отдельного разработчика производительность выросла. На уровне полного потока срок выпуска почти не изменился или стал хуже. DORA в отчёте 2024 года отмечала похожий системный компромисс: применение ИИ связывалось с преимуществами для индивидуальной работы, но также с ухудшением некоторых показателей стабильности и пропускной способности поставки ПО. Это наблюдательная связь, а не универсальная причинная формула, однако она показывает необходимость измерять весь процесс. DORA, 2024
Перед автоматизацией стоит определить реальное ограничение потока. Если задачи неделями ждут уточнения требований, генерация кода не решит основную проблему. Если узким местом является тестирование, больше пользы может дать подготовка проверок. Если сопровождение перегружено сортировкой обращений, начинать стоит с первичного разбора.
Где у ИИ есть шанс окупиться
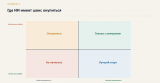
Для первого пилота подходят частые, узкие, проверяемые и обратимые сценарии.
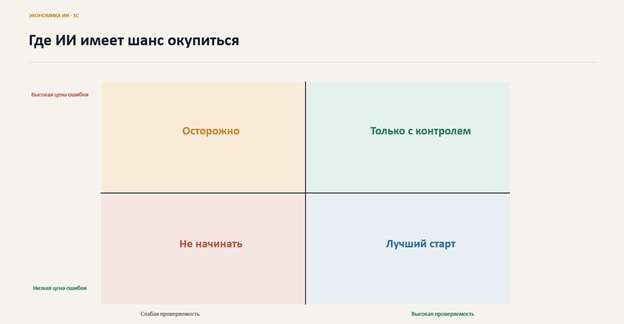
Сценарий можно проверить по шести критериям:
- задача регулярно повторяется;
- результат проверяется тестом, эталоном или понятным чек-листом;
- необходимый контекст можно получить без постоянного участия эксперта;
- ошибка обнаруживается до продуктивного воздействия и может быть отменена;
- операция имеет узкую границу и ясный критерий завершения;
- объём достаточен, чтобы окупить первоначальную настройку.
Для 1С-команды возможными кандидатами могут быть навигация по проекту, черновик документации по изменению, классификация обращений, заготовка типового теста или поиск кандидатов на аномалии без автоматического исправления.
Плохими первыми кандидатами будут массовое изменение продуктивных данных, проектирование при незафиксированных требованиях, редкая задача с высокой ценой ошибки и любой процесс без базовой линии.
При этом ИИ нужно сравнивать не только с ручной работой, но и с более простыми альтернативами. Иногда шаблон, статический анализ, обычный поиск или небольшая доработка 1С решают проблему дешевле и надёжнее. Использование нейросети оправдано там, где действительно требуется работа с неструктурированным контекстом, а не просто потому, что технология новая.
Как посчитать эффект на примере обращений
Рассмотрим условный сценарий сопровождения. Пользователь сообщает: «После обновления не закрывается заказ». ИИ должен классифицировать обращение, найти связанные материалы и подготовить первичную гипотезу. Человек проверяет результат и принимает обращение в работу. Автоматическое изменение базы не выполняется.
Для расчёта понадобятся следующие переменные:
- N — число обращений в месяц;
- T0 — медианное активное время первичного разбора без ИИ;
- T1 — время с ИИ, включая подготовку запроса, чтение и проверку;
- C — полная стоимость часа специалиста;
- Q0 и Q1 — доля обращений, принятых с первого раза;
- F — фиксированные расходы контура за период;
- V — переменные расходы на одно обращение;
- R — стоимость повторной работы и ошибок.
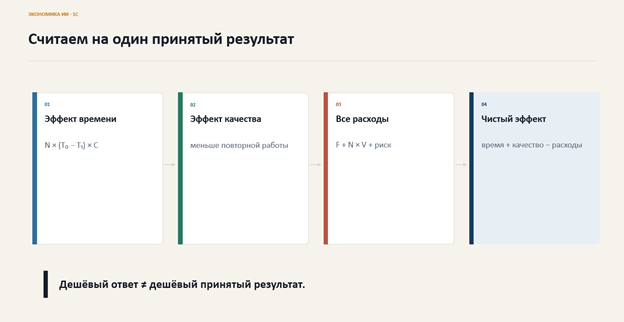
Базовая модель выглядит так:
Эффект по времени = N × (T0 − T1) × C
Чистый эффект = эффект по времени + изменение стоимости повторной работы − фиксированные расходы − N × переменные расходы
Если T1 больше T0, сценарий замедляет работу. Если время сократилось, но упала доля правильной классификации, необходимо учесть повторные передачи и уточнения. Более дорогая модель может оказаться экономичнее дешёвой, если её результаты значительно чаще принимаются без переделки.
Сэкономленное время не всегда является прямой денежной экономией. Если сотрудники остаются в команде, сначала возникает высвобождённая мощность. Чтобы превратить её в экономический эффект, нужно показать дополнительный объём принятых задач, сокращение срока или отказ от других затрат. Одни и те же часы нельзя одновременно записывать как сокращение бюджета и рост производительности.
Честный пилот вместо удачной демонстрации
Пилот должен быть устроен как измерение, а не как проект, который обязан доказать необходимость технологии.
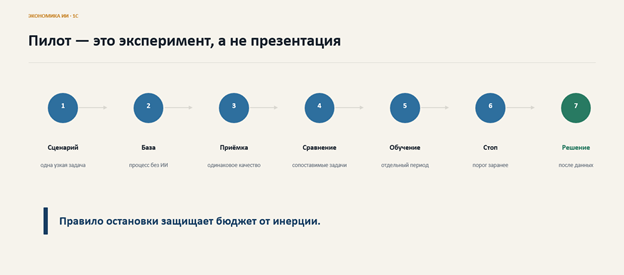
Рабочая последовательность выглядит так:
- Выбрать один сценарий и назначить владельца результата.
- Измерить процесс без ИИ: объём, время, качество и повторную работу.
- Определить единицу принятого результата и одинаковые правила проверки.
- Сравнивать сопоставимые задачи с ИИ и без него.
- Учитывать всё время: формулировку запроса, ожидание, чтение, исправление и приёмку.
- Отделить период обучения от устойчивого режима.
- Заранее назначить порог остановки по качеству, риску или стоимости.
- После пилота выбрать одно решение: остановить, сузить, перепроектировать, продолжить ограниченно или масштабировать.
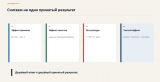
Минимальный набор метрик должен охватывать четыре стороны: время, качество, стоимость и риск. Например, полное время цикла, долю принятия без переделки, стоимость на один принятый результат и число эскалаций эксперту.
Удовлетворённость сотрудников тоже важна: неудобный инструмент трудно внедрить. Однако субъективное ощущение скорости необходимо сверять с фактическим временем. Исследование METR показало, что эти оценки могут расходиться.
Типичные ошибки расчёта
- Считать активность вместо результата. Количество ответов, промптов и строк кода ничего не говорит о принятой функциональности.
- Игнорировать проверку. Время квалифицированного специалиста способно поглотить экономию генерации.
- Переносить чужой процент. Результат другого исследования относится к его участникам, задачам, инструментам и метрикам.
- Ускорять не то узкое место. Дополнительные черновики не помогают, если выпуск ограничен требованиями, тестированием или приёмкой.
- Дважды учитывать время. Одни и те же высвобождённые часы нельзя одновременно записать как снижение затрат и дополнительный выпуск.
- Не определять условие остановки. Без него пилот продолжается потому, что в него уже вложили силы.
Выводы
У ИИ нет универсального ROI. Есть экономика конкретного сценария в конкретной 1С-команде.
Считать нужно полный путь до принятого результата. Цена модели является только частью стоимости: рядом находятся интеграция, контекст, проверка, сопровождение и ошибки. Публичные исследования помогают увидеть возможный диапазон эффектов, но не заменяют локальную базовую линию.
Первый пилот лучше строить вокруг частой, узкой, проверяемой и обратимой операции. До запуска нужно определить метрики и возможные решения после эксперимента. Масштабирование оправдано только тогда, когда эффект устойчив, качество не ухудшается, а полная стоимость и риск остаются управляемыми.
Практический следующий шаг — выбрать один повторяющийся сценарий, записать для него единицу принятого результата и измерить текущую базовую метрику. Только после этого имеет смысл обсуждать модель, интеграцию и ожидаемую окупаемость.
Вступайте в нашу телеграмм-группу Инфостарт