У вас уже есть Prometheus и Grafana. Кластера 1С там нет
Железо в Grafana, базы данных в Grafana, очереди в Grafana. А кластер 1С живёт отдельно: консоль администрирования, столбцы счётчиков, и смотреть в них нужно руками и именно в тот момент, когда всё уже встало. Истории нет, тревог нет, рядом с остальным стеком не положить.
Вариантов сегодня два. Поднимать под 1С отдельную систему мониторинга, то есть второй стек рядом с рабочим. Или писать свой экспортер поверх RAS, сервера администрирования кластера: разбирать вывод утилиты rac, придумывать имена метрик, потом рисовать двадцать панелей. Оба варианта стоят вечеров, и второй ещё и переписывается заново на следующем проекте.
Здесь одна команда и готовый дашборд.
Что это
Один файл PowerShell без зависимостей. Он спрашивает кластер штатной утилитой rac через сервер администрирования RAS и отдаёт числа в формате экспозиции Prometheus. Рядом лежат кусок конфигурации scrape, восемь правил тревоги и дашборд Grafana на 20 панелей.
powershell -ExecutionPolicy Bypass -File .\tezbase-1c-exporter.ps1 -SelfTest -StartRas
powershell -ExecutionPolicy Bypass -File .\tezbase-1c-exporter.ps1
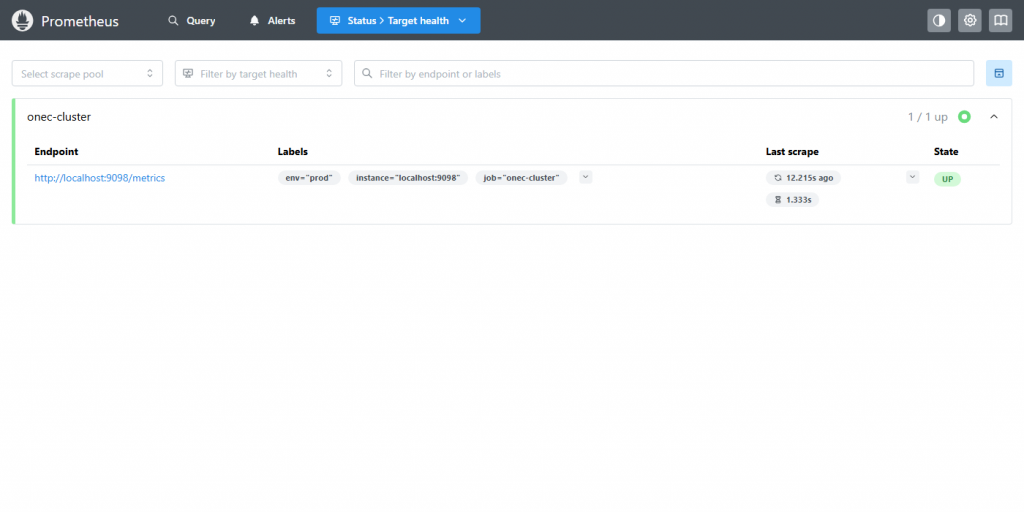
Метрики появляются на http://localhost:9098/metrics. Дальше кусок job в prometheus.yml, перезапуск, импорт json в Grafana. Настраивать панели руками не нужно.
Что видно на дашборде
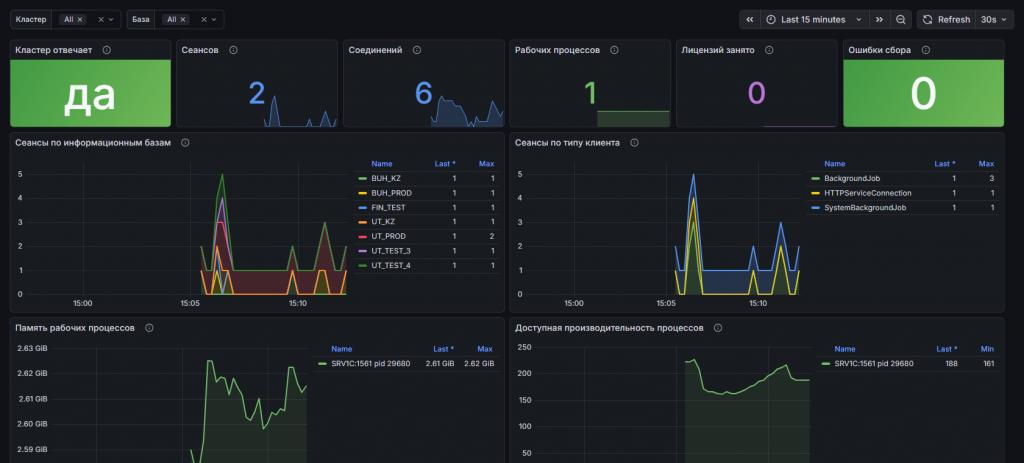
Двадцать панелей, скриншоты в галерее карточки. Шесть плиток состояния сверху: жив ли кластер, сеансы, соединения, процессы, лицензии, ошибки сбора. Переменные "Кластер" и "База" заполняются сами из метрик, отбор по ним работает.
- Сеансы разложены по базам и по типу клиента: тонкий, толстый, веб, фоновое задание. Видно и общее число, и кто именно его набрал.
- Память рабочих процессов и среднее время вызова, разложенное на время СУБД и время ожидания блокировок. Высокая доля СУБД при низком процессоре это тяжёлый запрос, а не жадный клиент, и на графике это разные линии.
- Самый долгий вызов, выполняющийся прямо сейчас, и возраст самого старого сеанса. Две панели, по которым видно, что кто-то держит систему, раньше, чем позвонят пользователи.
- Лицензии по типу, серии и по тому, кто их держит. Отдельная история, см. ниже про пустой стенд.
- Таблицы баз кластера и соединений по приложениям, блокировки кластера, заблокированные сеансы, трафик СУБД в живых сеансах.
Единицы на осях подставлены: память в гигабайтах, время в миллисекундах и минутах, трафик в мегабайтах.
Метрики
64 семейства и 95 рядов на кластере из одного сервера, четырёх баз и одного живого сеанса. Числа плавают в обе стороны: на большом кластере рядов больше, часть метрик размножается по базам, процессам и типам клиентов, а на кластере, куда никто не входил, выходит 61 семейство и 82 ряда - сеансовым метрикам не из чего взяться.
- Кластер и серверы. Жив ли RAS, сколько кластеров, серверов, менеджеров и информационных баз, лимиты соединений и баз на сервер.
- Рабочие процессы. Память, доступная производительность, ёмкость, среднее время вызова с разложением на СУБД, блокировки и серверную часть, среднее число потоков, время старта, длительность превышения по памяти.
- Сеансы. Разбивка по базе и типу клиента, спящие, заблокированные по СУБД и по сервису блокировок, самый долгий текущий вызов, возраст самого старого сеанса, процессорное время, трафик СУБД и чтение с записью.
- Соединения и блокировки. По базам и приложениям, блокировки кластера и объектные блокировки.
- Лицензии. Выдано, максимум мест, свободно. Разбивка по типу лицензии, серии, признаку выдачи сервером и по тому, кто держит: пользователь или рабочий процесс.
- Про сам экспортер. Длительность сбора, число ошибок, успех и время каждого из девяти сборщиков по отдельности. Это отвечает на вопрос, какая именно панель показывает устаревшее.
Главная метрика для тревоги называется onec_session_current_call_seconds_max. Пока она растёт линейно, кто-то держит систему прямо сейчас.
Режимы
- HTTP-слушатель. По умолчанию localhost:9098, прав администратора не требует. Чтобы Prometheus приходил с другой машины, нужен ключ -Bind и разовая регистрация урла; команду с подставленными значениями экспортер печатает сам.
- Запись в файл вместо порта. Когда на сервере уже стоит node_exporter, второй порт не нужен: экспортер кладёт метрики в файл, откуда их забирает node_exporter своим механизмом textfile. Файл пишется атомарно, через .tmp и переименование, и без метки порядка байтов BOM в начале файла: на ней node_exporter спотыкается.
- -Once для разового сбора, -Detailed для метрик по каждому сеансу отдельно, -SelfTest для диагностики человеком.
Права и данные
- К СУБД экспортер не обращается вообще. Только rac, только документированный протокол администрирования.
- Пароли информационных баз не нужны. Списки сеансов и соединений отдаются на уровне кластера. Пароль администратора кластера понадобится, только если он у вас заведён.
- Имена пользователей попадают в метки только в режиме -Detailed. Без этого ключа ни одного имени в выводе нет.
- Ни одной команды на изменение: экспортер не завершает сеансы и не управляет кластером.
- Пароль в командной строке виден в списке процессов. Если кластер защищён администратором, запускайте экспортер под своей учёткой и ограничивайте доступ к порту.
Что проверено на живом стенде
Всё ниже выполнено на живой системе, ни одна строка не взята из документации. Стенд: платформа 8.3.27, клиент-серверная база УТ 11.5 на MS SQL, один рабочий сервер. Рядом настоящий Prometheus 3.14 и Grafana OSS 12.3.
- Дашборд импортирован тем же вызовом, которым это делает интерфейс. На кластере, где работает хотя бы один сеанс, данные показали 20 панелей из 20. Каждый запрос каждой панели прогнан за пятнадцатиминутное окно и посчитан рядами.
- promtool check rules на восьми правилах тревоги: SUCCESS. Правила загружены живым Prometheus, у всех восьми health ok.
- promtool check metrics на выводе экспортера: ни одного замечания линтера.
- Полный сбор 1,3-2,4 секунды. Пять замеров: 1,285 в образце вывода, 1,333 на скриншоте цели, 1,473 в самодиагностике, 2,21 и 2,4 в двух прогонах подряд. За один сбор экспортер зовёт rac десять раз: список кластеров плюс девять сборщиков. Дороже всех в образце server, license и process, около 0,2 секунды каждый.
- Единица памяти сверена с операционной системой. rac отдал 1 700 868, у того же процесса rphost PrivateMemorySize64 в тот же момент 1 700 868 КБ. Второй замер, другой день, другой человек: 1 739 395 072 байта против 1 736 196 096, расхождение 0,18 процента, то есть секунды между двумя снятиями. Значит это килобайты private bytes, и метрика в байтах имеет право так называться. Там, где сверить было не с чем, единицы в имени метрики нет вовсе, а утверждение из документации ушло в описание.
- Деградация без RAS. Сервер администрирования остановлен: экспортер не падает, отдаёт onec_ras_up 0 и пять семейств вместо 64, счётчик ошибок 1, и в консоли лежит готовая команда запуска.
Две грабли, которые уже вытащены
Формат экспозиции принимает только перевод строки. Стандартный AppendLine в Windows ставит CRLF, и Prometheus отвечает invalid metric type "gauge\r", помечает цель down и не пишет ни одного ряда. Ловится это только настоящим Prometheus: HTTP при этом отдаёт 200, Content-Type верный, байты на месте, семейства считаются. Поймано первым же реальным scrape, исправлено, вывод проходит promtool.
rac может быть новее RAS, ras новее агента быть не может. Утилита 8.3.27.2325 спокойно работает с RAS 8.3.27.1606, а RAS 8.3.27.2325 против агента 8.3.27.1606 отвечает "Различаются версии клиента и сервера". Поэтому ключ -StartRas берёт версию из пути работающего ragent, а не самую свежую установленную. Порт при этом открывается в обоих случаях, то есть по живости порта отличить нельзя.
И следствие для пустого стенда. Лицензионные метрики, собранные с сеансов, на кластере без единого сеанса не печатаются вовсе, и панель "Лицензии" оказывалась пустой ровно в тот момент, когда покупатель смотрит на дашборд первый раз. Печатать вместо них нули было нельзя: метки типа лицензии и серии приходят из самой лицензии, ряда без них не существует, а ноль в свободных местах немедленно зажигает нашу же тревогу на каждом пустом стенде. Правдоподобное число опаснее отсутствующего. Числа нашлись у рабочего процесса: девятый сборщик отдаёт ключ, который держит сам процесс. Отсюда метка holder, и порог тревоги по свободным местам стоит только по клиентским лицензиям, иначе он горит круглосуточно на серверном ключе.
Совместимость
- Платформа 1С:Предприятие 8.3, клиент-серверный вариант. Прогоны шли на 8.3.27 (агент 8.3.27.1606, утилита rac 8.3.27.2325); разбор вывода rac завязан на формат этих сборок. Нужен запущенный сервер администрирования RAS, ключ -StartRas поднимает локальный сам.
- Windows PowerShell 5.1. На PowerShell 7 не запускалось ни разу: это непроверенная ветка, и обещать по ней нечего.
- Prometheus 3.14, Grafana OSS 12.3. Дашборд объявляет требование Grafana 10.0 и выше; на 13 не проверялся.
- Конфигурация любая: экспортер к прикладным объектам не обращается вовсе.
Чего он не делает
- Не читает журнал регистрации.
- Не ходит в СУБД и не показывает ожидания на уровне SQL.
- Не управляет кластером.
- Не работает без RAS: администрирование через COM-соединение с агентом сюда не заведено.
- Обёртки службы Windows в поставке нет. Запускается планировщиком при старте системы или сторонней обёрткой.
Границы: что стенд НЕ закрыл
Честный список, и стоит он тут до покупки. После неё он бесполезен.
- На первом запуске без сеансов данные покажут 14 панелей из 20. Шесть сеансовых напишут "No data", и это не поломка: пока никто не работает, рисовать там нечего. Двадцать из двадцати наполняются, как только в базу кто-то вошёл.
- Кластер с заведённым администратором не проверялся. Ключи -ClusterUser и -ClusterPwd пробрасываются в rac, но на стенде администратора кластера нет, и живого прогона по этой ветке не было ни одного.
- Кластер из нескольких рабочих серверов не проверялся: сервер на стенде один, размножение метрик по серверам подтверждено только чтением кода.
- Кластер с сотнями сеансов не замерялся. Время сбора снято на одном сеансе, как оно масштабируется, мы не знаем, и рекомендация по интервалу опроса стоит с запасом.
- Linux не запускался. Пути к rac для Linux в автопоиске есть, прогонов нет.
- Grafana 13 не проверялась, брали 12.3. Alertmanager не поднимался: проверено, что правила загружаются и считаются; как по ним уходит уведомление, мы не смотрели.
Что в архиве
- tezbase-1c-exporter.ps1 - экспортер, один файл, без зависимостей.
- tezbase-1c-cluster.json - дашборд Grafana, 20 панелей, две переменные.
- prometheus-job.yml - кусок scrape_configs.
- alerts.yml - восемь правил тревоги.
- metrics-sample.prom - живой обезличенный вывод со стенда, чтобы посмотреть на формат до запуска.
- README.md - ключи запуска, разбор метрик, замеры.
Скрипт написан латиницей целиком, включая комментарии. Причина практическая: файл .ps1 с кириллицей и без BOM Windows PowerShell читает в системной ANSI-кодировке и падает на разборе ещё до первой строки. Русский текст живёт в README и в подписях дашборда.
Откуда он взялся
Как экспортер прошёл шесть проверок и не отдал Prometheus ни одного ряда, почему ras.exe как служба Windows молча перестаёт стартовать после обновления платформы и что пришлось поменять в способе проверять - в статье Экспортер отдавал HTTP 200, а Prometheus не принял ни одной метрики кластера 1С.
Проверено на следующих конфигурациях и релизах:
- Управление торговлей, редакция 11, релизы 11.5.22.67
Вступайте в нашу телеграмм-группу Инфостарт