Обычно всё начинается с одной интеграции. Потом появляется вторая — её пишет другой человек, со своим логированием и своим способом искать контрагента. К десятой в конфигурации живут десять HTTP-сервисов, пять регламентных заданий, три регистра «журнала обмена» и один общий модуль с названием вроде ОбменОбщий_Новый2. Когда что-то ломается, первым делом выясняют не «что сломалось», а «кто это писал».
На проекте внедрения 1С:Управление холдингом в крупном агрохолдинге (более 5000 пользователей, свыше 30 внешних систем) я отвечал за архитектуру интеграций. Ниже — то, к чему мы пришли: не библиотека «из коробки», а набор решений, который можно повторить в своей конфигурации. Код в статье — упрощённые примеры, написанные для статьи, а не выдержки из проекта.
Что должен уметь механизм
Мы сформулировали требования так, чтобы на каждое можно было ответить «да» или «нет»:
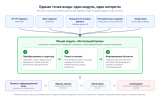
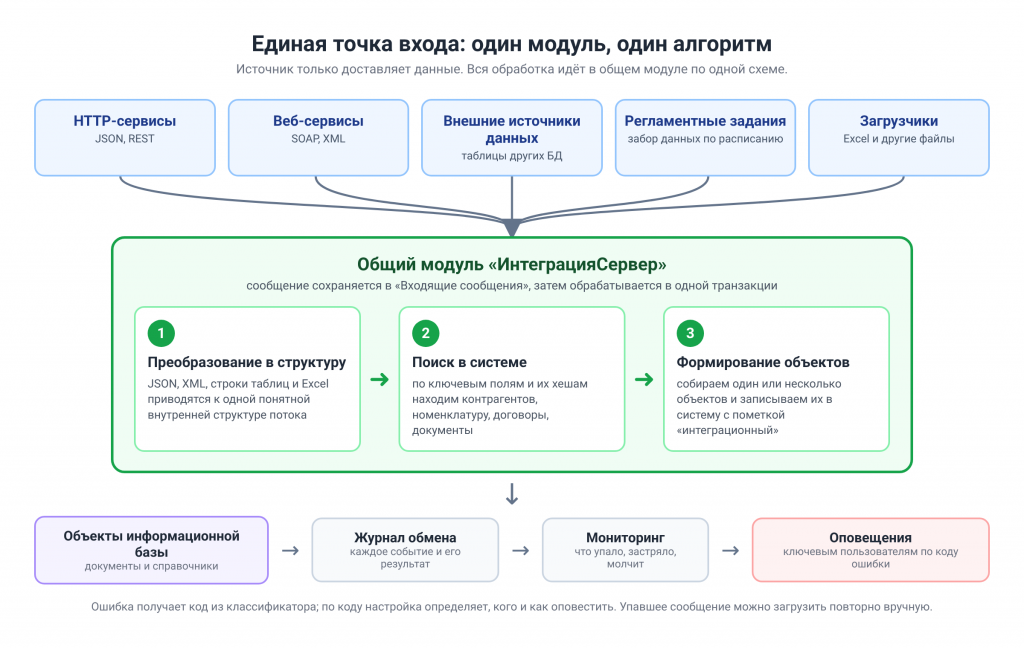
- Единая точка входа. HTTP- и веб-сервисы, внешние источники данных, регламентные задания и загрузчики передают данные в один общий модуль с одним алгоритмом обработки. Какой поток обрабатывать — определяется настройкой, а не отдельным кодом на каждую систему.
- Эндпоинты настраиваются в режиме предприятия. Добавить новый поток или поменять адрес внешней системы можно без обновления конфигурации.
- Настраиваемый запрос выгрузки для каждого исходящего потока. Какие поля отдать — решает настройка, а не хардкод.
- Исходящие потоки — через планы обмена, входящие — в транзакции.
- Регламентно и вручную; синхронно и асинхронно.
- Хеширование полей поиска для повторного сопоставления объектов.
- Блокировка объектов, полученных через интеграцию, от ручного редактирования.
- Ручная повторная загрузка сообщения.
- Мониторинг обмена и оповещения об ошибках.
Дальше — по порядку.
Архитектура обмена: приём и отправка данных
Механизм работает в обе стороны. Входящие потоки принимают данные из внешних систем и записывают их в базу, исходящие отправляют изменения из базы во внешние системы. У каждого направления свой общий алгоритм, но устроены они одинаково: источник или получатель — это только транспорт, а вся логика живёт в одном общем модуле.
Где живёт механизм
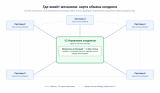
Важно понимать масштаб. В контуре холдинга не одна система, а несколько: помимо 1С:Управление холдингом работают другие крупные системы, и часть из них (пять) обмениваются данными не только с 1С, но и между собой. Всё, что описано ниже, — это внутреннее устройство обмена одной из них, 1С. Для остальных систем 1С — такой же участник контура: они отправляют ей данные и получают данные от неё, а как это устроено внутри, их не касается.
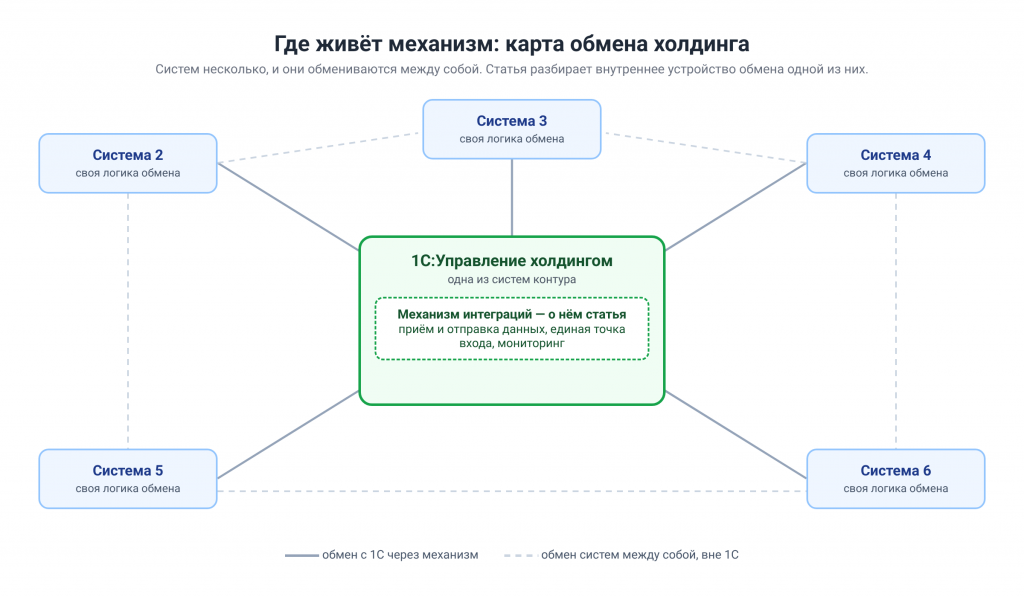
Такое разделение и даёт порядок. Обмены между другими системами живут своей жизнью, а все обмены, которые касаются 1С, проходят через один механизм с общими правилами, журналом и мониторингом.
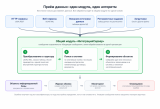
Схема приёма данных (входящие потоки)
Неважно, откуда пришли данные: любой источник передаёт их в один и тот же общий модуль, и там они проходят один и тот же алгоритм.
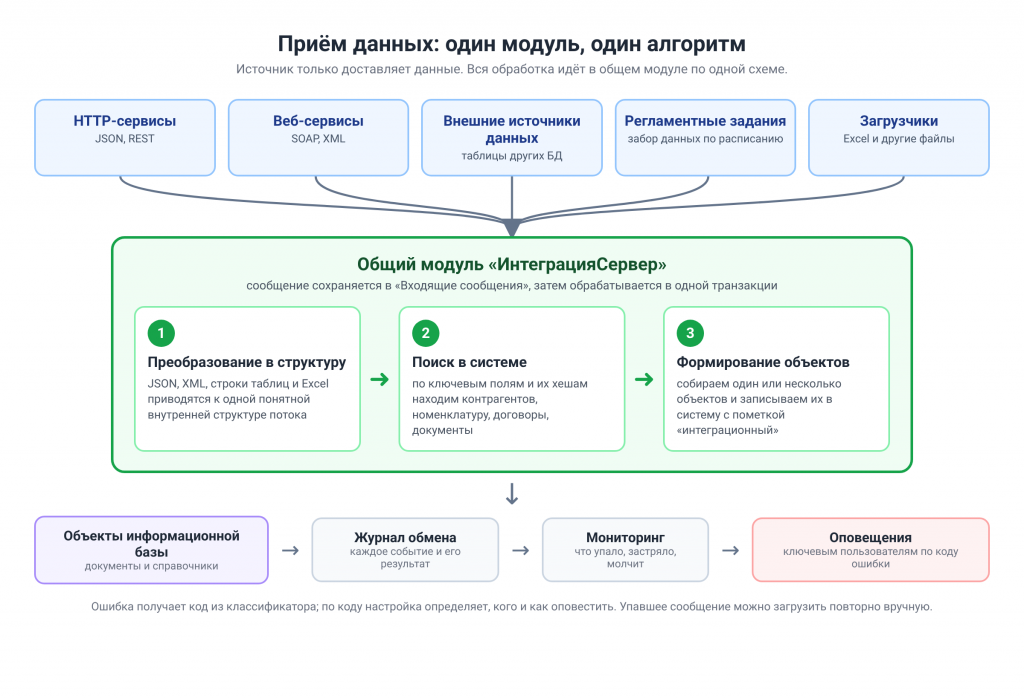
Что происходит на каждом шаге:
- Преобразование в понятную структуру. JSON из HTTP-сервиса, XML из веб-сервиса, строки внешнего источника данных, таблица из Excel приводятся к одной внутренней структуре потока. Дальше алгоритм уже не знает, откуда пришли данные.
- Поиск данных в общей системе. По ключевым полям (через хеши полей поиска) находим контрагента, номенклатуру, договор, документ, с которыми работает сообщение. Не нашли — создаём или останавливаемся с понятной ошибкой, как задано в настройке потока.
- Формирование объектов для записи. Из найденного и полученного собираем один объект или несколько (например, документ и новые элементы справочников) и записываем их в систему в одной транзакции с пометкой «интеграционные».
Источник только доставляет данные. Вся логика живёт в одном месте, поэтому новый поток — это новая настройка и правила преобразования, а не новый модуль со своим поиском и своим логированием. Входящее сообщение перед обработкой сохраняется в регистр «Входящие сообщения», поэтому его всегда можно загрузить повторно вручную.
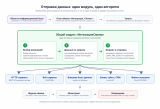
Схема отправки данных (исходящие потоки)
Отправка устроена зеркально. Получатели бывают те же: HTTP- и веб-сервисы внешних систем, внешние базы данных, банки, сайты и CRM по их API, файлы выгрузки в Excel, CSV или XML. Но путь данных у всех один.
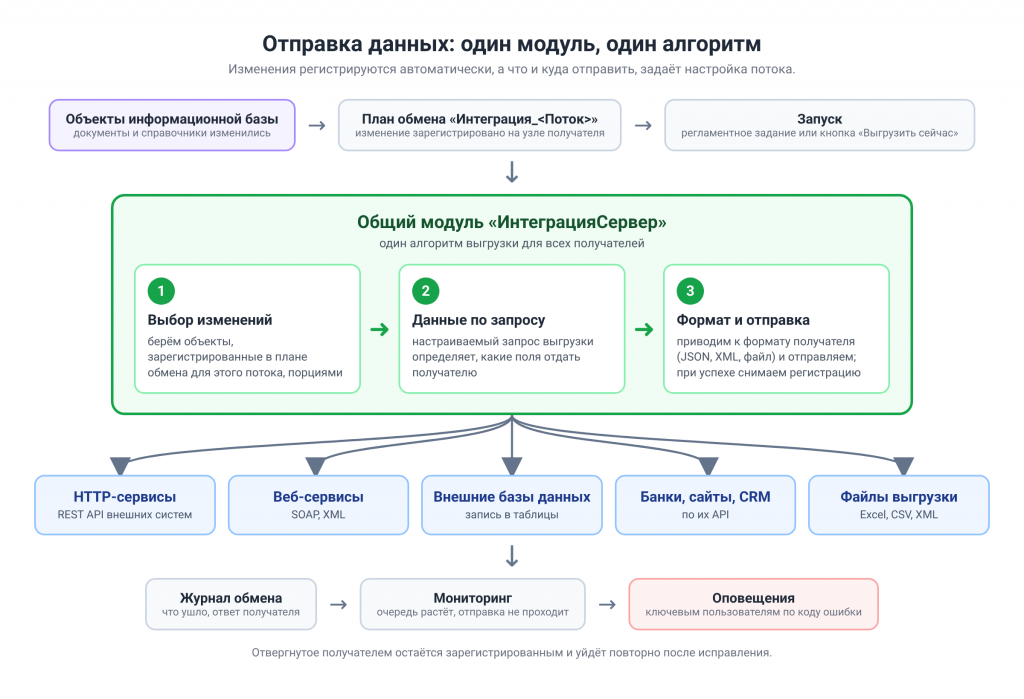
- Выбор изменений. Когда документ или элемент справочника меняется, платформа сама регистрирует его в плане обмена «Интеграция_<Поток>» на узле получателя. Регламентное задание или кнопка «Выгрузить сейчас» берёт зарегистрированные объекты порциями.
- Данные по настраиваемому запросу. Какие поля отдать, определяет текст запроса выгрузки в настройке потока. Получатель попросил ещё одно поле — его добавляют в запрос без обновления конфигурации.
- Формат и отправка. Результат приводится к формату получателя (JSON, XML, файл) и отправляется. Если получатель подтвердил приём, регистрация снимается; если отверг — объект остаётся в очереди и уйдёт повторно после исправления.
Журнал, мониторинг и оповещения общие для обоих направлений: ошибка отправки получает код из классификатора так же, как ошибка приёма.
Ключевые справочники и регистры:
| Объект | Назначение |
|---|---|
Справочник ИнтеграционныеСистемы |
Внешняя система: адрес, способ аутентификации, таймауты, ответственный |
Справочник ПотокиИнтеграции |
Поток: система, направление, тип объекта, имя обработчика, режим (синхр./асинхр.), текст запроса выгрузки, активность |
Регистр сведений ВходящиеСообщения |
Сырое тело сообщения, поток, статус, количество попыток, текст ошибки |
Регистр сведений ХешиПолейПоиска |
Поток + хеш ключевых полей → ссылка на объект |
Регистр сведений ЖурналИнтеграции |
Каждое событие: время, поток, объект, результат, длительность |
Единая точка входа
Все источники данных — HTTP-сервисы, веб-сервисы, внешние источники данных, регламентные задания, загрузчики из Excel и любые другие потоки — обращаются к одному и тому же общему модулю. У этого модуля одна понятная схема обработки из трёх шагов:
- Преобразует полученную информацию в понятную структуру.
- Ищет эти данные в общей системе: контрагентов, номенклатуру, договоры, документы.
- Формирует из них один объект или несколько объектов и записывает их в систему.
Источник отвечает только за доставку данных. Поэтому новый источник подключается без нового кода обработки, а поиск, запись и журнал работают для всех одинаково.
Покажу на примере HTTP-сервиса; веб-сервис, регламентное задание или загрузчик устроены так же и вызывают тот же общий модуль. Это HTTP-сервис с шаблоном URL вида `/flow/{code}`. Код потока — ключ к справочнику настроек. Сервис ничего не знает про номенклатуру или платёжки; его задача — принять, проверить, сохранить и, если поток синхронный, сразу обработать.
Функция FlowPOST(Запрос)

    КодПотока = Запрос.ПараметрыURL["code"];
    Поток = ИнтеграцияСервер.ПотокПоКоду(КодПотока);

    Если Не ЗначениеЗаполнено(Поток) Тогда
        Возврат ИнтеграцияСервер.ОтветОшибкой(404, "Поток не найден: " + КодПотока);
    КонецЕсли;

    Если Не ИнтеграцияСервер.АутентификацияПройдена(Поток, Запрос) Тогда
        Возврат ИнтеграцияСервер.ОтветОшибкой(401, "Нет доступа");
    КонецЕсли;

    Тело = Запрос.ПолучитьТелоКакСтроку(КодировкаТекста.UTF8);

    // Сначала сохраняем — потом обрабатываем. Сообщение не должно потеряться,
    // даже если обработчик упадёт.
    ИдСообщения = ИнтеграцияСервер.ЗарегистрироватьВходящее(Поток, Тело, Запрос.Заголовки);

    Если ИнтеграцияСервер.ПотокСинхронный(Поток) Тогда
        Результат = ИнтеграцияСервер.ОбработатьВходящее(ИдСообщения);
        Возврат ИнтеграцияСервер.ОтветПоРезультату(Результат);
    КонецЕсли;

    Возврат ИнтеграцияСервер.ОтветПринято(ИдСообщения); // 202 Accepted

КонецФункции
Правило «сначала сохрани, потом обрабатывай» — самое важное во всей схеме. Оно даёт сразу три вещи: ручную перезагрузку (сообщение уже лежит в базе), асинхронность (регламентное задание просто выбирает необработанные) и честный разбор инцидентов (видно, что именно прислали, а не что «должны были прислать»).
Подводный камень: идемпотентность
Внешние системы любят повторять запросы: таймаут на их стороне, ретрай — и одно сообщение приходит дважды. Если внешняя система передаёт идентификатор сообщения, храните его и отвечайте на повтор тем же результатом, не обрабатывая заново. Если не передаёт — считайте хеш тела и держите окно дедупликации.
Обработчики потоков
Три шага общего модуля выглядят в коде одинаково для любого источника. От потока к потоку меняются только правила: как читать исходные данные, по каким полям искать и какие объекты собирать. Они задаются настройкой потока и его обработчиком — например, общим модулем или процедурой в расширении. Вызов идёт через проверенный список разрешённых обработчиков, а не через `Выполнить()` с произвольной строкой из настройки: иначе любой, кто может редактировать справочник, получает возможность исполнять код на сервере.
Функция ОбработатьВходящее(ИдСообщения) Экспорт

    Сообщение = ПрочитатьВходящее(ИдСообщения);
    Обработчик = РазрешённыйОбработчик(Сообщение.Поток); // из фиксированного соответствия

    НачалоЗамера = ТекущаяУниверсальнаяДатаВМиллисекундах();
    НачатьТранзакцию();
    Попытка
        // 1. Преобразуем данные источника в понятную структуру
        Данные = Обработчик.ПреобразоватьВСтруктуру(Сообщение.Поток, Сообщение.Тело);
        // 2. Ищем в системе объекты, к которым относятся данные
        Найденные = НайтиОбъекты(Сообщение.Поток, Данные); // по хешам полей поиска
        // 3. Формируем и записываем один или несколько итоговых объектов
        Результат = Обработчик.СформироватьОбъекты(Сообщение.Поток, Данные, Найденные);
        УстановитьСтатусСообщения(ИдСообщения, "Обработано");
        ЗафиксироватьТранзакцию();
    Исключение
        ОтменитьТранзакцию();
        Информация = ИнформацияОбОшибке();
        // Код ошибки берём из классификатора — по нему настроены оповещения
        КодОшибки = ОпределитьКодОшибки(Сообщение.Поток, Информация);
        ТекстОшибки = ПодробноеПредставлениеОшибки(Информация);
        // Статус пишем уже вне отменённой транзакции
        УстановитьСтатусСообщения(ИдСообщения, "Ошибка", ТекстОшибки, КодОшибки);
        Результат = Новый Структура("Успех, КодОшибки, Ошибка", Ложь, КодОшибки, ТекстОшибки);
    КонецПопытки;

    ЗаписатьВЖурнал(Сообщение.Поток, ИдСообщения, Результат,
        ТекущаяУниверсальнаяДатаВМиллисекундах() - НачалоЗамера);

    Возврат Результат;

КонецФункции
Почему входящие — в транзакции
Входящий пакет часто содержит связанные данные: документ и новые элементы справочников для него. Если документ не записался, созданная «по дороге» номенклатура-сирота потом всплывёт в отчётах и дубликатах. Транзакция делает пакет атомарным: либо всё, либо ничего и понятная ошибка в журнале.
Но транзакция — это и блокировки. На базе с тысячами пользователей длинная транзакция по крупному пакету легко становится причиной ожиданий на управляемых блокировках. Поэтому:
- пакеты режем на разумные порции на стороне отправителя или при регистрации;
- внутри обработчика сначала всё читаем и сопоставляем, потом пишем — чтобы тяжёлые запросы не выполнялись под уже установленными блокировками;
- статус сообщения пишем вне отменённой транзакции, иначе ошибка «откатит» и саму запись об ошибке.
Хеши полей поиска
Классическая боль: внешняя система не хранит наш GUID, а мы — её идентификатор. Каждый раз объект ищется по набору полей: ИНН + КПП, артикул + производитель, номер + дата. Запрос по нескольким строковым полям, да ещё с приведением регистра и пробелов, — медленный и хрупкий.
Решение: при первом сопоставлении нормализуем ключевые поля, склеиваем, считаем хеш и сохраняем пару «поток + хеш → ссылка». Дальше поиск — одно обращение к регистру по индексу.
Функция ХешКлючевыхПолей(Поток, Данные) Экспорт

    ПоляПоиска = ПоляПоискаПотока(Поток); // массив имён из настройки, в фиксированном порядке
    Части = Новый Массив;
    Для Каждого ИмяПоля Из ПоляПоиска Цикл
        Значение = ?(Данные.Свойство(ИмяПоля), Данные[ИмяПоля], "");
        Части.Добавить(НормализоватьЗначение(Значение));
    КонецЦикла;

    Хеширование = Новый ХешированиеДанных(ХешФункция.SHA256);
    Хеширование.Добавить(СтрСоединить(Части, Символы.ПС));
    Возврат ПолучитьHexСтрокуИзДвоичныхДанных(Хеширование.ХешСумма);

КонецФункции

Функция НормализоватьЗначение(Значение)
    Строка = НРег(СокрЛП(Строка(Значение)));
    Строка = СтрЗаменить(Строка, Символы.НПП, " ");
    Пока СтрНайти(Строка, "  ") > 0 Цикл
        Строка = СтрЗаменить(Строка, "  ", " ");
    КонецЦикла;
    Возврат Строка;
КонецФункции
Грабли, которые стоит обойти заранее:
- Порядок полей фиксирован. Поменяли порядок в настройке — все хеши стали другими. Меняйте состав полей только с пересчётом регистра.
- Нормализация — одна на весь механизм. Если один обработчик обрезает пробелы, а другой нет, получите дубли.
- Хеш — не замена проверки. При совпадении хеша сравните исходные поля: коллизии SHA-256 на практике не встретишь, а вот «ключевые поля изменились в источнике» — встретишь постоянно.
- Разделитель между полями обязателен, иначе «12» + «3» и «1» + «23» дадут одно и то же.
Блокировка «интеграционных» объектов
Если справочник контрагентов ведётся в мастер-системе, а в 1С его правят руками, через неделю данные разъедутся, и следующая загрузка молча затрёт ручную правку. Поэтому объект, пришедший из интеграции, помечается (регистр сведений или реквизит в расширении), а в форме и в ПередЗаписью правка ключевых полей запрещается.
&После("ПередЗаписью")
Процедура Интеграция_ПередЗаписью(Отказ)

    Если ОбменДанными.Загрузка Или ИнтеграцияСервер.ИдётЗаписьИзИнтеграции() Тогда
        Возврат;
    КонецЕсли;

    Если ИнтеграцияСервер.ОбъектПолученИзИнтеграции(Ссылка)
        И ИнтеграцияСервер.ИзменёныЗащищённыеПоля(ЭтотОбъект) Тогда
        ОбщегоНазначения.СообщитьПользователю(
            "Объект ведётся во внешней системе. Изменения вносите в источнике.", , , , Отказ);
    КонецЕсли;

КонецПроцедуры
Важно блокировать поля, а не объект целиком: бухгалтеру часто нужно дописать свою аналитику, которой во внешней системе нет. И обязательно оставить роль-исключение для администратора — на случай аварии.
Исходящие потоки на планах обмена
Для исходящих потоков мы использовали планы обмена: по узлу на внешнюю систему (или на поток). Механизм регистрации изменений платформа даёт бесплатно, а номера сообщений и подтверждение приёма решают вопрос «что уже ушло, а что нет».
Что отправлять — определяет текст запроса в настройке потока. Обработчик выбирает зарегистрированные изменения, прогоняет их через запрос и сериализует результат.
Процедура ВыгрузитьПоток(Поток) Экспорт

    Узел = УзелПотока(Поток);
    Выборка = ПланыОбмена.ВыбратьИзменения(Узел, НомерСледующегоСообщения(Узел));
    Ссылки = Новый Массив;
    Пока Выборка.Следующий() Цикл
        Ссылки.Добавить(Выборка.Получить().Ссылка);
    КонецЦикла;
    Если Ссылки.Количество() = 0 Тогда
        Возврат;
    КонецЕсли;

    Запрос = Новый Запрос(ТекстЗапросаВыгрузки(Поток)); // хранится в настройке
    Запрос.УстановитьПараметр("Ссылки", Ссылки);
    Пакет = ТаблицуВМассивСтруктур(Запрос.Выполнить().Выгрузить());

    Ответ = ОтправитьВоВнешнююСистему(Поток, ЗаписатьJSONВСтроку(Пакет));
    Если Ответ.Успех Тогда
        ПланыОбмена.УдалитьРегистрациюИзменений(Узел, Ссылки);
    КонецЕсли;
    ЗаписатьВЖурнал(Поток, Неопределено, Ответ);

КонецПроцедуры
Упрощение для статьи: в реальной реализации стоит порционировать выборку, обрабатывать частичные ответы (часть объектов принята, часть нет) и не удалять регистрацию того, что внешняя система отвергла.
Настраиваемый запрос выгрузки: плюсы и риски
Плюс очевиден: внешняя система попросила ещё одно поле — аналитик добавляет его в запрос в режиме предприятия, без релиза. Риски тоже:
- запрос должен содержать параметр
&Ссылки— проверяйте это при записи настройки; - проверяйте запрос тестовым выполнением на пустом массиве при сохранении;
- права на редактирование текста запроса — только у узкой роли: через запрос можно выгрузить что угодно;
- версионируйте настройки: «кто и когда поменял запрос» — первый вопрос при инциденте.
Синхронно, асинхронно, регламентно, вручную
Это четыре разные оси, их полезно не смешивать:
- Синхронный входящий — внешней системе нужен ответ сразу (например, номер созданного документа). Обработка идёт в том же HTTP-вызове; держите такие потоки лёгкими.
- Асинхронный входящий — отвечаем
202, обрабатываем регламентным заданием. Подходит для пакетов и всего, что может ждать минуту. - Регламентный исходящий — задание по расписанию выгружает зарегистрированные изменения.
- Ручной запуск — кнопка «Выгрузить сейчас» и «Загрузить повторно» для конкретного сообщения. Это не роскошь, а главный инструмент поддержки: исправили справочник — перезагрузили упавшее сообщение, не прося внешнюю систему «прислать ещё раз».
Регламентные задания лучше делать по одному на группу потоков, а не одно на всё: иначе один зависший поток держит остальные.
Мониторинг и оповещения
Журнал, который никто не читает, бесполезен. Мониторинг у нас отвечал на три вопроса:
- Что упало? Сообщения со статусом «Ошибка» по потокам, с текстом ошибки и кнопкой перезагрузки.
- Что застряло? Сообщения, которые слишком долго висят в статусе «Новое», и узлы планов обмена с растущей очередью. Порог — в настройке потока.
- Что молчит? Поток, по которому обычно приходит N сообщений в час, а сейчас ноль. Это самый коварный случай: ошибок нет, потому что нет данных.
Оповещения строятся от конкретных ошибок, а не от факта «что-то упало». Для этого есть классификатор ошибок обмена: у каждой ошибки свой код, описание и важность. Общий механизм определения ошибок срабатывает при любом сбое обработки: он разбирает, что именно случилось (не найден объект, не прошла проверка данных, недоступна внешняя система и так далее), и присваивает сообщению код из классификатора.
Кого и как оповещать, задаётся настройкой: для кода ошибки или потока указываются ключевые пользователи и способ оповещения, письмом или в мессенджер. Поэтому ошибку в данных видит бухгалтер, который может её исправить, а недоступность внешней системы — тот, кто отвечает за интеграцию. Чтобы не утонуть в сообщениях, оповещения группируются: одно сообщение «по потоку X за последние 15 минут 40 ошибок с кодом такого-то, первая — такая-то», а не 40 писем.
Что получилось и что бы я сделал иначе
Итог в цифрах: на механизм переведено 68 интеграционных потоков. Раньше спроектировать новое подключение, сделать выгрузку данных под нестандартный запрос или получить информацию из системы — это был примерно месяц работы. Теперь, когда требования понятны и выдан доступ к конфигурации, первый демонстрационный результат получается за 1–2 дня, а итоговый, с тестированием, — в среднем за неделю. Качественно: новая интеграция перестала быть «новым проектом» — это настройка системы, потока, запроса выгрузки и, при необходимости, один новый обработчик.
Чему научились:
- Договаривайтесь о формате ошибок с внешними системами в первый день. Ответ «500, что-то пошло не так» без тела сводит на нет весь мониторинг.
- Храните сырые сообщения, но не вечно. Задайте срок хранения и регламентную очистку, иначе регистр входящих станет самой большой таблицей базы.
- Тестируйте на копии с реальным объёмом. Обработчик, который летает на ста документах, под нагрузкой тысяч пользователей ведёт себя иначе: блокировки, план запроса, время транзакции.
- Код-ревью обработчиков обязательно. Общий механизм задаёт рамку, но один обработчик с запросом в цикле способен испортить всё.
Весь механизм можно построить в расширении, не снимая основную конфигурацию с поддержки, — мы так и делали.
Вступайте в нашу телеграмм-группу Инфостарт