Предельные режимы. Часть 2. Профилирование и настройка PostgreSQL: анализ ожиданий, pg_stat_statements, pg_profile
- Архитектура наблюдаемости на уровне СУБД
- Включение pg_stat_statements без деградации продуктива
- Установка и запуск pg_profile
- Методика чтения отчета pg_profile
- Связка ClickHouse ↔ PostgreSQL: от SDBL-события до плана запроса
- Типовые паттерны неоптимальных планов для запросов 1С
- Тюнинг postgresql.conf под OLTP-нагрузку 1С
- Верификация и метрики
- Риски и ограничения
- Артефакты для читателя
- Заключение
Цикл: Инженерный контур 1С - проектирование, эксплуатация и масштабирование enterprise-систем
Обзор цикла: Развитие высоконагруженной системы 1С:Предприятие 8.3 на PostgreSQL и ОС Linux. Часть 1: конвейер Vector, ClickHouse, Grafana.
В первой части мы развернули конвейер Vector → ClickHouse → Grafana и научились видеть на дашборде всплески TLOCKS, TTIMEOUT и медленные SDBL-события. Теперь у нас есть ответ на вопрос «что тормозит» - конкретный запрос к СУБД, конкретный пользователь, конкретная строка контекста 1С.
Следующий вопрос инженера: «почему этот запрос выполнялся 14 секунд?» Журнал регистрации и технологический журнал 1С здесь бессильны - они не знают ничего о внутреннем устройстве PostgreSQL: планах выполнения, статистике таблиц, буферном кэше и конкуренции за блокировки строк. Для ответа нужны инструменты самой СУБД.
В этой части мы пройдем полный путь: от включения расширений статистики до конкретного измененного параметра в postgresql.conf, который убрал Seq Scan с регистра накопления на 600 миллионов строк.
Целевая аудитория и контекст
- Профиль читателя: DBA и ведущие 1С-разработчики, отвечающие за производительность баз данных; SRE-инженеры, эксплуатирующие высоконагруженные инсталляции на PostgreSQL.
- Исходное состояние: Сквозной кейс «Торговый контур»: PostgreSQL 16, Linux, база 1.8 ТБ, 350 активных пользователей в пике. Конвейер телеметрии из Части 1 развернут и работает.
- Ограничения: Никакие аналитические инструменты не должны выполнять тяжелые запросы на продуктивной СУБД. Все профилирование - пассивный сбор статистики, которую PostgreSQL накапливает сам в ходе штатной работы.
Постановка проблемы
После внедрения дашборда Grafana инженер видит на экране следующую картину в часы пиковых отгрузок:
SDBL-события сduration8-14 секунд, связанные с проведением документов реализации.- Контекст указывает на общий модуль
РегистрыНакопления.ТоварыНаСкладах- операция списания остатков. - В ClickHouse поле
sqlсодержит текст запроса к временным таблицам и регистру накопления.
Текст запроса есть. Но без плана выполнения (EXPLAIN) и статистики СУБД невозможно ответить:
- Использует ли планировщик индекс или идет Seq Scan?
- Сколько страниц буфера было прочитано с диска (Disk Hits vs Buffer Hits)?
- Нет ли конкуренции за
RowExclusiveLockна строках таблицы регистра со стороны параллельных транзакций маркировки?
Инструмент для ответа на эти вопросы - расширения pg_stat_statements и pg_profile.
🔍 Архитектура наблюдаемости на уровне СУБД
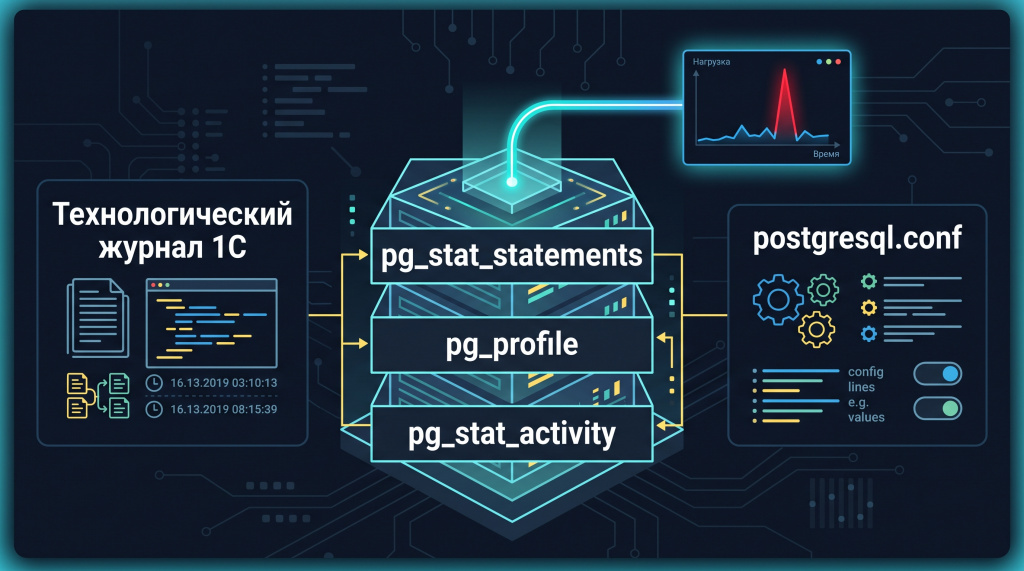
Наблюдаемость PostgreSQL строится на трех независимых уровнях:

Ключевой принцип: все три уровня - пассивные представления (views). PostgreSQL собирает их в разделяемой памяти в ходе обычной работы. Мы не добавляем нагрузки - мы читаем уже накопленные данные.
🔍 Включение pg_stat_statements без деградации продуктива
2.1. Оценка накладных расходов
pg_stat_statements добавляет к каждому запросу операцию нормализации текста и атомарное обновление счетчика в shared memory. На нагрузке «Торгового контура» (350 пользователей, смешанные OLTP-транзакции) измеренный оверхед составил менее 0.8% по CPU - значительно ниже порога чувствительности бизнес-процессов.
Расширение безопасно включать на продуктиве. Единственное ограничение: параметр pg_stat_statements.max должен быть достаточно большим, чтобы не вытеснять важные запросы из кэша статистики.
2.2. Установка расширения
2.3. Параметры в postgresql.conf
После изменения shared_preload_libraries требуется перезапуск PostgreSQL. Остальные параметры применяются командой SELECT pg_reload_conf(); без перезапуска. track_io_timing добавляет вызовы таймера на каждое чтение блока; на серверах с быстрыми часами это незаметно, проверить можно утилитой pg_test_timing.
2.4. Проверка корректности установки
🔍 Установка и запуск pg_profile
pg_stat_statements показывает накопленную статистику с момента последнего сброса. Он не отвечает на вопрос «что именно тормозило с 10:00 до 11:30 в час пиковых отгрузок». Для временных срезов нужен pg_profile.
3.1. Что такое pg_profile
pg_profile - расширение PostgreSQL, которое с заданной периодичностью делает снимки (snapshot) представлений статистики (pg_stat_statements, pg_stat_bgwriter, pg_stat_user_tables, pg_statio_user_tables и других), сохраняет их в служебных таблицах и умеет строить дифференциальные HTML/текстовые отчеты за любой выбранный интервал между двумя снимками.
3.2. Установка
Для pg_profile нужно расширение dblink из пакета postgresql-contrib. В официальном образе postgres:16 оно уже есть, на Debian и Ubuntu ставится отдельным пакетом.
Важно: Хранилище снимков (pgprofile_repo) рекомендуется создавать в отдельной базе данных. Это исключает любое влияние аналитических таблиц на рабочие табличные пространства 1С.
3.3. Регистрация сервера и настройка расписания снимков
Сначала в базе 1С нужна роль наблюдателя. Имя pg_monitor для входа не подходит: имена с префиксом pg_ зарезервированы, а pg_monitor - встроенная роль без права входа. Создаём свою роль и выдаём ей pg_monitor:
Последняя строка обязательна: без неё первый снимок завершается ошибкой permission denied for function pg_stat_statements_reset. Для роли нужна строка в pg_hba.conf.
Автоматизация снимков через pg_cron (рекомендуемый интервал - 30 минут для продуктивных контуров):
🔍 Методика чтения отчета pg_profile
4.1. Генерация отчета за инцидентный интервал
Допустим, дашборд Grafana зафиксировал всплеск TLOCKS с 10:15 до 11:45. Находим номера снимков, охватывающих этот период:
 sample |      sample_time
--------+------------------------
     42 | 2026-09-05 10:00:12+03
     43 | 2026-09-05 10:30:08+03
     44 | 2026-09-05 11:00:14+03
     45 | 2026-09-05 11:30:09+03
     46 | 2026-09-05 12:00:11+03
В таблице profile.samples имени сервера нет (там server_id), поэтому список снимков берём через show_samples. Номера в выводе - пример из кейса.
Генерируем отчёт за интервал снимков 42-46. Функция возвращает HTML одной строкой; чтобы файл открылся в браузере, сохраняем его в режиме «только данные, без выравнивания»:
Номера снимков искать не обязательно: отчёт за интервал времени - profile.get_report('торговый_контур', tstzrange(now() - interval '2 hours', now())).
4.2. Навигация по разделам отчета
Названия разделов даны так, как они выглядят в отчёте pg_profile 4.16 (интерфейс английский), в порядке разбора:
| Раздел отчёта | На что смотрим в первую очередь |
|---|---|
| Top SQL by execution time | Суммарное время выполнения. Кандидаты на оптимизацию - запросы с долей больше 10% от суммы всех. |
| Top SQL by shared blocks read | Запросы, читающие больше всего блоков не из shared_buffers. Признак нехватки кэша или отсутствия индекса. |
| Top SQL by executions | Очень частые, но «быстрые» запросы. Если их среднее время растёт - признак деградации плана или конкуренции за ресурсы. |
| Top SQL by shared blocks dirtied | Запросы, создающие много грязных страниц. Прямое влияние на checkpoint. |
| Top tables by blocks read | Какие таблицы читались с диска больше всего. Так находится физическая таблица PostgreSQL под регистром 1С. |
| Top tables by estimated sequentially scanned volume | Таблицы, которые читаются последовательным сканированием. Для регистров с индексами это тревожный признак. |
| Top tables by vacuum operations, Top tables by modified tuples ratio | Отстаёт ли autovacuum на высокооборотных таблицах. |
| Cluster settings | Значения параметров на момент отчёта: проверить, что применён именно ваш конфиг. |
Раздел с типами ожиданий (Lock, LWLock, IO) появляется в отчёте, только если на сервере установлено расширение pg_wait_sampling. На стенде статьи его нет, и раздела в отчёте нет. Без него ожидания смотрим запросами к pg_stat_activity из раздела 6.4.
4.3. Пример анализа реального инцидента
В отчете «Торгового контура» за инцидентный период раздел Top SQL by execution time показал:
Rank 1: total_time = 48 min 12 sec | calls = 41 230 | mean = 70 ms
Query ID: 3f7a2c...
SELECT ... FROM _AccumRg12345 t1 ...
WHERE t1._Period = $1 AND t1._Recorder = $2 ...
Запрос обращается к таблице _AccumRg12345 (регистр накопления «ТоварыНаСкладах»). 41 тысяча вызовов за 1.5 часа с средним временем 70 мс - при пиковой нагрузке среднее время отдельных вызовов достигало 8-14 секунд, что и фиксировал ТЖ.
Раздел Top tables by blocks read подтвердил: _AccumRg12345 - лидер по heap_blks_read (чтение с диска), при этом heap_blks_hit (из shared_buffers) было на порядок ниже. Прямой сигнал: таблица не помещается в буферный кэш или планировщик обходит нужный индекс.
🔍 Связка ClickHouse ↔ PostgreSQL: от SDBL-события до плана запроса
Ценность конвейера из Части 1 - в том, что текст SQL-запроса хранится в ClickHouse в поле sql событий SDBL. Это позволяет построить сквозной маршрут расследования:

5.1. Запрос к ClickHouse для извлечения SQL-текста
5.2. Поиск запроса в pg_stat_statements
Текст SQL из ТЖ 1С содержит конкретные значения параметров ($1 = '2026-09-05', $2 = ...). pg_stat_statements хранит нормализованные тексты - с плейсхолдерами $1, $2. Для поиска используем ключевые фрагменты структуры запроса:
5.3. EXPLAIN ANALYZE на тестовой реплике
Никогда не запускайте EXPLAIN ANALYZE на продуктивной базе с реальными данными в рабочее время - это выполнит запрос фактически и добавит нагрузку. Используйте потоковую реплику только для чтения:
Пример вывода, указывающего на проблему:
Seq Scan on "_AccumRg12345"  (cost=0.00..1842310.00 rows=1 width=...)
                             (actual time=8420.113..8420.115 rows=1 loops=1)
  Filter: (("_Period" = ...) AND ("_Recorder" = ...))
  Rows Removed by Filter: 598241037
  Buffers: shared hit=12450 read=229871
Planning Time: 0.8 ms
Execution Time: 8421.2 ms
Seq Scan при Rows Removed by Filter: 598 миллионов - планировщик выбрал полный перебор таблицы вместо индекса. Причина выясняется в следующем разделе.
🔍 Типовые паттерны неоптимальных планов для запросов 1С
6.1. Seq Scan на регистре накопления из-за устаревшей статистики
Симптом: Планировщик выбирает Seq Scan на таблице регистра накопления несмотря на наличие составного индекса по (_Period, _Recorder, _LineNo). Имена полей здесь и в примерах выше условные: в базе 1С вместо _Recorder стоят поля _RecorderTRef и _RecorderRRef, а номера в именах _AccumRg12345 и _Fld567 у каждой конфигурации свои.
Причина: Статистика таблицы (pg_statistic) устарела. После массовой перепроводки документов реализации (типовая ночная операция) или большого импорта данных через API распределение значений в столбце _Period радикально изменилось. AUTOVACUUM не успел обновить статистику до начала рабочего дня. Планировщик оценивает селективность фильтра по _Period как слишком низкую и считает Seq Scan дешевле Index Scan.
Решение:
6.2. Nested Loop на JOIN временных таблиц 1С
Симптом: Запрос с JOIN временной таблицы #tt... и большого регистра выбирает Nested Loop вместо Hash Join. При большом количестве строк во временной таблице время растет квадратично.
Причина: Статистика временных таблиц в PostgreSQL не собирается автоматически. Планировщик не знает реальный размер #tt... и недооценивает стоимость Nested Loop.
Решение в контексте 1С: Платформа создает временные таблицы и управляет их жизненным циклом, поэтому прямое влияние ограничено. Проверьте в EXPLAIN (ANALYZE, BUFFERS), что хеш-таблица не сбрасывается на диск (в узле Hash значение Batches больше 1): work_mem не заставляет планировщик выбирать Hash Join, он определяет лишь, поместится ли хеш-таблица в памяти.
6.3. Index Scan вместо Index Only Scan из-за мертвых строк (bloat)
Симптом: Запрос по индексу выполняется медленнее ожидаемого. EXPLAIN BUFFERS показывает высокий heap fetches при Index Scan.
Причина: Таблица накопила мертвые строки (tuple bloat) из-за задержки VACUUM. Для проверки видимости строки PostgreSQL вынужден обращаться к heap даже при Index Scan - теряется преимущество Index Only Scan.
Диагностика:
Решение:
6.4. Lock wait на уровне строк при параллельной маркировке
Симптом: В pg_stat_activity много сессий с wait_event_type = 'Lock', а wait_event равен transactionid или tuple. Время ожидания коррелирует с потоком API-вызовов маркировки.
Причина: Транзакции проведения документов реализации и фоновые процессы верификации кодов маркировки меняют одни и те же строки таблицы _AccumRg... (регистр остатков). Пока первая транзакция не завершилась, вторая ждёт снятия блокировки строки. RowExclusiveLock тут ни при чём: это блокировка таблицы, которую берёт любой INSERT и UPDATE, и с себе подобными она не конфликтует. Ожидание вызывают блокировки строк, поэтому искать надо transactionid и tuple.
Диагностика во время инцидента:
Решение (архитектурное, реализуется в Части 6А): Вынос потока API-верификации маркировки в асинхронный контур через RabbitMQ. Это ликвидирует прямую конкуренцию транзакций в СУБД.
🔍 Тюнинг postgresql.conf под OLTP-нагрузку 1С
Все изменения вносятся в postgresql.conf (или conf.d/1c_tuning.conf) и применяются командой SELECT pg_reload_conf();. Параметры, требующие перезапуска, помечены [restart].
7.1. Буферный кэш (shared_buffers)
Проверка эффективности буферного кэша:
Если buffer_hit_ratio ниже 0.90 на нагруженных таблицах регистров - увеличить shared_buffers.
7.2. Рабочая память для сортировок и хеш-таблиц (work_mem)
7.3. Сглаживание I/O при checkpoint
Агрессивные checkpoint-ы (сброс грязных страниц на диск) создают I/O-шипы, которые прямо конкурируют с пользовательскими транзакциями.
7.4. Стоимостная модель планировщика для SSD
По умолчанию PostgreSQL настроен на HDD (random_page_cost = 4.0). На SSD/NVMe случайный и последовательный доступ практически равноценны.
Снижение random_page_cost позволяет планировщику чаще выбирать Index Scan вместо Seq Scan - это напрямую решило проблему с регистром накопления из примера выше.
7.5. Логирование медленных запросов на уровне СУБД
7.6. Итоговый конфигурационный файл
🔍 Верификация и метрики
Применение изменений в конфигурации PostgreSQL верифицируется в контексте кейса «Торговый контур» по следующим метрикам.
| Метрика | До | После | Источник |
|---|---|---|---|
| Время проведения документа реализации (p95) | 14.2 с | 1.8 с | ClickHouse: агрегация SDBL по duration |
Buffer hit ratio (_AccumRg12345) |
82% | 98% | pg_statio_user_tables |
| I/O-spike в момент checkpoint | +340 IOPS | +65 IOPS | Node Exporter: node_disk_io_time_seconds_total |
| Количество Seq Scan на регистре за сутки | 1 247 | 3 | pg_stat_user_tables.seq_scan |
| MTTR при инцидентах СУБД | 45-90 мин | 8 мин | pg_profile: отчет готов за 2 минуты, диагноз очевиден |
8.1. Запрос для мониторинга эффективности индексов
Добавьте в дашборд Grafana через Prometheus / postgres_exporter или через прямой запрос к ClickHouse (если экспортируете метрики):
🔍 Риски и ограничения
Риск 1: Завышенный work_mem вызывает OOM-killer.
При одновременном выполнении сложных аналитических запросов (например, закрытие месяца или расчет себестоимости) несколько параллельных сортировок могут одновременно выделить N_сессий × work_mem. Если сумма превышает доступную RAM, ядро Linux убивает процессы.
Митигация: Устанавливать work_mem консервативно (32-64 МБ для OLTP). Отдельно повышать work_mem для конкретных аналитических сессий:
Риск 2: VACUUM ANALYZE на больших таблицах в рабочее время.
На таблице в 600 миллионов строк VACUUM может выполняться 20-40 минут. В это время процесс удерживает блокировку SHARE UPDATE EXCLUSIVE, которая мешает конкурентным DDL-операциям (ALTER TABLE, CREATE INDEX без CONCURRENTLY). На DML (INSERT/UPDATE/DELETE) это не влияет.
Митигация: Запускать принудительный VACUUM только вне пиковых часов либо использовать VACUUM (PARALLEL 4): параллельно обрабатываются только индексы таблицы.
Риск 3: pg_profile занимает место в служебной базе.
При снимках каждые 30 минут и хранении 30 дней объем репозитория для базы с 5 000 уникальных запросов - порядка 2-5 ГБ. Срок хранения задаётся один раз, старые снимки pg_profile удаляет сам при очередном снимке:
🔍 Артефакты для читателя
К статье прилагается архив release_part_02_postgresql.zip:
scripts/1c_tuning.conf- конфигурационный файл с комментариями под базы 1С.scripts/setup_extensions.sql- установкаpg_stat_statements,pg_profile,pg_cron, роль наблюдателя, регистрация сервера и расписание снимков.scripts/diagnostic_queries.sql- семь блоков диагностических запросов: буферный кэш, медленные запросы, индексы и Seq Scan, мёртвые строки, блокировки, checkpoint, суточная сводка.scripts/pgprofile_report.sql- просмотр снимков, отчёты, управление хранением.scripts/README.md- быстрый старт и контрольный чеклист.
Как проверено. Четыре SQL-файла и конфигурационный файл прогнаны на чистом PostgreSQL 16.15 (официальный образ postgres:16, Docker) с pg_profile 4.16 и pg_cron из пакета postgresql-16-cron: сервер стартует с 1c_tuning.conf, снимок создаётся (OK), отчёт сохраняется в HTML размером около 500 КБ, диагностические запросы выполняются без ошибок. Прогон повторяется скриптом evidence/run_scripts.sh из репозитория работы. Память на стенде уменьшена: 256 МБ shared_buffers вместо 32 ГБ. Числа кейса «Торговый контур» (таблица в разделе 8) этим прогоном не проверяются.
🔍 Заключение
Практические результаты
- Выстроена сквозная цепочка расследования инцидентов: от события
SDBLв ClickHouse до конкретного плана выполнения запроса в PostgreSQL. - Устранен Seq Scan на регистре накопления «ТоварыНаСкладах»: время проведения документов реализации (p95) снизилось с 14.2 с до 1.8 с.
- Налажен регулярный сбор снимков pg_profile: MTTR при инцидентах уровня СУБД сократился до 8 минут.
- Конфигурация PostgreSQL приведена в соответствие с реальным профилем нагрузки: SSD, OLTP, 350 пользователей.
Переход к следующей части
Теперь СУБД настроена, планы запросов оптимальны, а статистика собирается автоматически. Но в часы пиковых отгрузок инженер по-прежнему видит на Grafana периодические всплески потребления RAM процессами rphost, которые заканчиваются превентивными ночными рестартами.
В Части 3. Управление памятью rphost: jemalloc, cgroups v2 и safe-ротация без остановки бизнеса мы перейдем на уровень рантайма платформы 1С: настроим аллокатор памяти jemalloc, ограничим потребление ресурсов через cgroups v2 без риска OOM-kill в рабочее время и реализуем безопасный механизм плавной ротации рабочих процессов для обоих сценариев - КОРП и ПРОФ.
Кейс «Торговый контур» - на следующих конфигурациях и релизах:
- 1С:ERP Управление предприятием 2, релизы 2.6.1.53
- 1С:Комплексная автоматизация 2.х, релизы 2.7.4.25
- PostgreSQL 16.4, Ubuntu 22.04 LTS
Скрипты архива дополнительно проверены на PostgreSQL 16.15 с pg_profile 4.16 (Docker).
Вступайте в нашу телеграмм-группу Инфостарт
Вступайте в нашу телеграмм-группу Инфостарт