Input Voice: голосовой ввод в любое окно Windows и ИИ, который превращает поток мыслей в читаемый текст
Разработка - Инструментарий разработчика
Бесплатные
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Узнавайте о новых бесплатных решениях в нашей телеграм-группе Инфостарт БЕСПЛАТНО
Вы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
В предыдущей статье (Рабочая память ИИ-агента: как вести задачи, ТЗ и решения в файлах проекта без ручного учёта) я рассказывал, как храню задачи, архитектурные решения и техзадания в файлах проекта, чтобы автономные ИИ-агенты (в частности, Claude Code) не теряли контекст между рабочими сессиями.
Но на практике возникло узкое горлышко: всё это нужно набивать руками.
Когда глубоко погружаешься в постановку задачи, монотонный набор текста быстро утомляет. Начинаешь машинально сокращать формулировки, выбрасывать важные пограничные условия и детали. А затем удивляешься, почему агент или коллега понял ТЗ не так, как задумывалось.
Решение лежало на поверхности — перестать набивать черновики вручную и начать их диктовать.
Так родилась Input Voice — небольшая утилита для Windows, которая распознаёт русскую и английскую речь на лету и сразу печатает её в то окно, где стоит курсор: будь то строка ввода в VS Code/1C:EDT, комментарий к коммиту, Блокнот, карточка в таск-трекере или корпоративный мессенджер. Без переключения в сторонние вкладки и без копирования через буфер обмена.
У программы два режима:
-
Прямой ввод потокового распознавания (как есть).
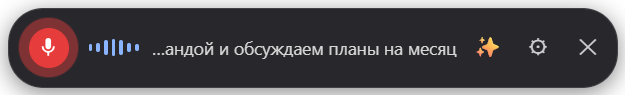
Активный процесс диктовки (виджет поверх окон отображает активный микрофон и фрагмент распознаваемой фразы).
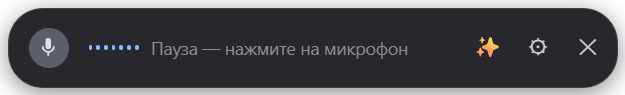
Режим паузы (вызывается кликом по значку микрофона или автоматически после 30 секунд тишины)
-
AI-рефакторинг текста по горячей клавише — отправка надиктованного в LLM для чистки от слов-паразитов, расстановки пунктуации и форматирования в готовое сообщение.
Сразу оговорюсь: к платформе 1С программа напрямую не привязана. Это мой рабочий инструмент архитектора и разработчика для повседневной работы с текстом и кодом.
Почему не подошли штатные решения
В Windows есть встроенный голосовой ввод по сочетанию Win+H. Казалось бы, зачем изобретать велосипед?
Я честно пытался жить на нём на постоянной основе, но упёрся в проблемы стабильности:
-
Панель диктовки регулярно не открывалась по шорткату.
-
Распознавание периодически засыпало прямо на полуслове, из-за чего приходилось постоянно отвлекаться и проверять, «слышит» ли меня система.
-
Качество распознавания русской речи по субъективным ощущениям заметно уступало алгоритмам Google.
Второй очевидный вариант — встроенный микрофон в десктопных клиентах Claude или ChatGPT. Распознают они прилично, но привязаны к конкретному интерфейсу. А диктовать нужно везде:
-
в терминал Claude Code или поле ввода ассистента в VS Code и EDT;
-
в комментарии к модулям;
-
в описание тикета в Jira/YouTrack;
-
в быстрый ответ коллеге в Telegram или почте.
Каждый раз переключаться на браузер, наговаривать текст, жать Ctrl+C и возвращаться назад — крайне не продуктивно.
Почему движком стал Chrome
Многие знают расширение Voice In для Chrome. Оно работает поверх нативного Web Speech API браузера. На мой взгляд, среди бесплатных решений оно точнее и быстрее всего переваривает русскую речь: текст начинает выводиться потоком прямо во время диктовки, а не через паузу после молчания.
Плюс к этому — не требуется регистрировать учетные записи и выпускать платные API-ключи для Яндекс SpeechKit, Azure или Google Cloud Speech. Нужен лишь установленный Chrome и стабильный интернет.
Оставалось вытащить этот механизм наружу и подружить с любым активным окном ОС.
| Инструмент | Где работает | Что не подошло |
| Win+H | Любые поля в Windows | Нестабильный запуск, обрывы записи на полуслове |
| Микрофон в Claude / ChatGPT | Только внутри их приложений | Локальная привязка, нужен постоянный копипаст |
| Voice In | Только на веб-страницах Chrome | Не может печатать напрямую в сторонний софт |
| Input Voice | Любое активное окно Windows | Требует наличия Chrome и доступа в интернет |
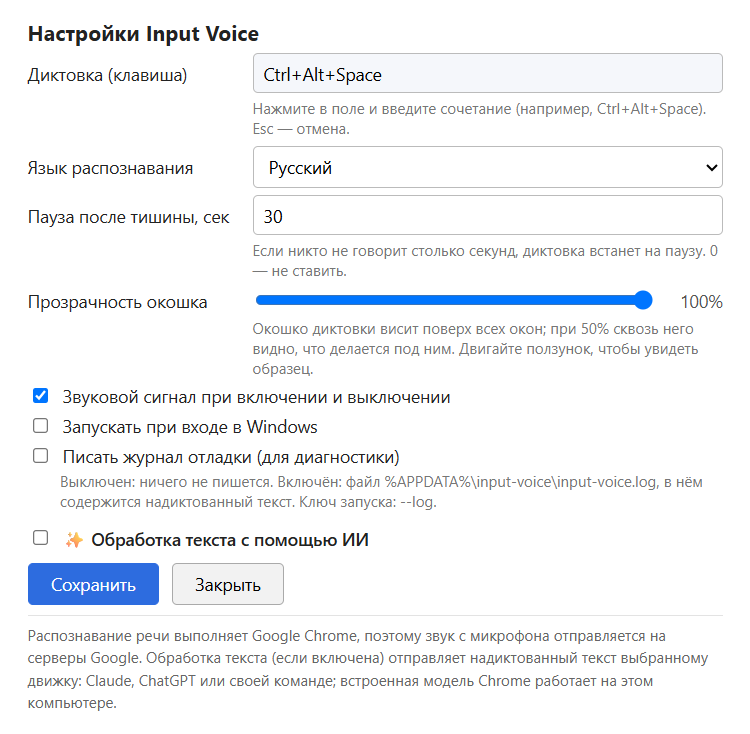
Окно базовых настроек Input Voice: горячая клавиша вызова, язык, таймаут тишины и прозрачность окна.
Как это работает для пользователя
Программа живёт в системном трее и не захламляет панель задач:
-
Распаковываем папку с программой.
-
Запускаем
InputVoice.exe. -
Ставим курсор в любое текстовое поле.
-
Жмём Ctrl + Alt + Space и начинаем говорить.
-
Если нужно сделать паузу, жмём кнопку паузы в компактном плавающем виджете (повторный клик возобновляет поток).
-
Для остановки жмём шорткат повторно или закрываем мини-окно.
Текст появляется в поле ввода прямо во время речи. Окошко утилиты закреплено поверх всех окон, сохраняет свою позицию на экране, но не перехватывает фокус ввода.
Если замолчать на 30 секунд — запись автоматически станет на паузу. Все тайм-ауты, шорткаты и язык (русский / английский) настраиваются.
Режим AI-редактора: приводим мысли в порядок
Мы пишем совсем не так, как говорим. В устной речи неизбежны слова-паразиты («ну», «короче», «в общем»), самоповторы, брошенные на середине мысли.
ИИ-агенту это не мешает. Claude Code прекрасно понимает сырой поток мыслей — со всеми «э-э-э», повторами и оборванными фразами — и сам вытаскивает из него суть. Чем больше деталей я наговорю, тем лучше он поймёт задачу. Поэтому агенту я диктую как есть, без всякой обработки.
А вот людям так писать нельзя. Коллеге в Telegram, в почту, в комментарий к задаче сырой поток не отправишь — его неудобно читать. Для этого я и добавил второй этап — обработку через LLM.
Она опциональна и вызывается отдельным сочетанием клавиш. Модель получает сырой распознанный текст и выполняет роль редактора:
-
убирает мусорные слова и дубли;
-
расставляет точки, запятые и абзацы;
-
исправляет специфические огрехи фонетического распознавания;
-
строго сохраняет исходные факты и технические термины.
Для этого используются лаконичные системные промпты.
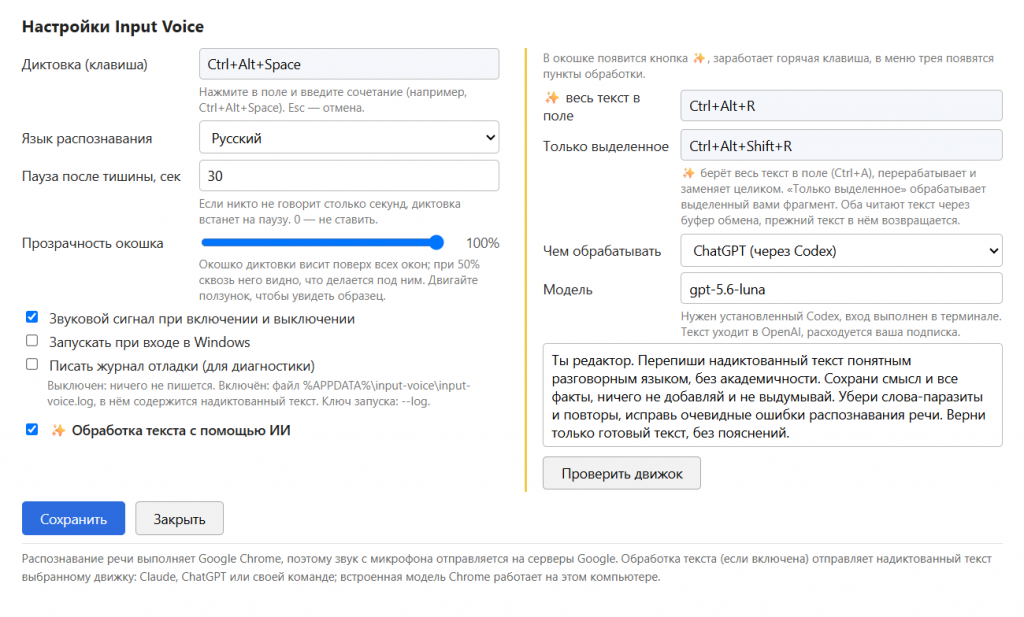
Вариант для обычных заметок и ТЗ:
«Ты редактор. Перепиши надиктованный текст понятным разговорным языком, без академичности. Сохрани смысл и все факты, ничего не добавляй и не выдумывай. Убери слова-паразиты и повторы, исправь очевидные ошибки распознавания речи. Верни только готовый текст, без пояснений».
Вариант для деловой переписки:
«Ты редактор. Перепиши надиктованный текст как короткое деловое сообщение коллеге: вежливо, по делу, без канцелярита. Сохрани смысл и все факты, ничего не добавляй. Убери слова-паразиты, междометия, повторы и оборванные фразы. Верни только готовый текст».
Режимы и защита от затирания
| Действие | Сочетание клавиш |
| Обработать весь текст в поле | Ctrl + Alt + R |
| Обработать только выделенный фрагмент | Ctrl + Alt + Shift + R |
Вставка результата происходит единой операцией (через буфер с возвратом старого содержимого), поэтому при неудачном ответе модели всегда можно нажать Ctrl + Z.
Предусмотрена защита от гонки состояний: если пока LLM генерировала ответ (это занимает от 7 до 25 секунд), вы переключили окно или руками изменили текст в целевом поле — утилита отменяет прямую вставку, кладёт результат в буфер обмена и выводит уведомление. Лимит одного запроса — 6000 символов.
Поддерживаемые бэкенды для редактирования
| Движок | Требования | Среднее время ответа в тестах |
| ChatGPT via Codex | Codex CLI + авторизация | 7–13 секунд |
| Claude via Claude Code | Claude Code CLI + авторизация | 6.6–30 секунд |
| Встроенная модель Chrome | Локальная загрузка весов (~4 ГБ) | ~21.8 с на 39 символов (русский официально не заявлен) |
| Собственная CLI-команда | Любой консольный пайплайн / curl / Ollama | Зависит от окружения |
Архитектурные нюансы реализации
Самые интересные грабли обнаружились не в общении с LLM, а в механике эмуляции клавиатуры и удержании сессии браузера.
1. Как удержать Web Speech API в фоне
Для работы Web Speech API необходим запущенный Chrome. Input Voice поднимает изолированный инстанс браузера со своей служебной HTML-страницей. Общение программы с этой страницей идёт по локальному HTTP-серверу (127.0.0.1) на случайном порту с валидацией через одноразовый токен.
Первой мыслью было запустить Chrome в режиме --headless. Однако в headless-режиме доступ к микрофону и Web Speech API заблокирован на уровне движка Chromium.
Пришлось запускать обычный оконный Chrome, но с координатами далеко за пределами видимой области экрана (off-screen). Если просто свернуть или скрыть окно через WinAPI, Chromium определяет вкладку как неактивную и через некоторое время глушит распознавание в целях экономии ресурсов. С заэкранным окном таких проблем нет: промежуточные результаты приходят каждые 100–300 мс.
2. Капризы SendInput и Блокнота Windows 11
Для печати текста в чужое окно используется Windows API функция SendInput с флагом KEYEVENTF_UNICODE через Node.js FFI-библиотеку koffi. Буфер обмена при потоковой диктовке не задействуется — идут честные виртуальные нажатия.
И вот тут начались сюрпризы: современный UWP/XAML-Блокнот в Windows 11 напрочь захлёбывался быстрым потоковым вводом.
| Способ отправки | Поведение в Блокноте Win 11 |
| Залпом весь массив символов за один вызов | Залипание букв: «привееееетттт» |
| По одному символу с интервалом 4 мс | Потеря ~1% символов |
| Пачками по 2–12 символов | Случайные пропуски букв и дубли |
Раздельные вызовы KeyDown и KeyUp с паузой 8 мс |
Стабильная печать без потерь |
Честная посимвольная печать (нажать → пауза → отпустить → пауза) ограничила максимальную скорость ввода примерно на уровне 30–32 знаков в секунду из-за накладных расходов планировщика Windows. Но для скорости живой диктовки этого запаса хватает с головой. Чтобы интерфейс утилиты не замирал во время печати, вывод вынесен в отдельный worker-поток Node.js.
3. Алгоритм диффа промежуточных результатов
Движок Web Speech возвращает поток промежуточных гипотез (interim results), которые постоянно мутируют в процессе того, как браузер дослушивает контекст фразы:
1. "раз"
2. "1 2"
3. "раз два"
4. "1 2 3"
Если просто «вбивать» всё, что возвращает API — получится каша.
Программа сопоставляет последний и текущий промежуточный результат, находит стабильный общий префикс, а последнее слово держит в уме до подтверждения. В окно печатается только инкрементальная разница. Когда от API приходит флаг isFinal, программа сверяет фактически напечатанное с финальным текстом и, если движок в последний момент изменил падеж или слово, подчищает хвост через серии виртуальных Backspace.
Стек и компромиссы
Программа собрана на Electron, JS и библиотеке koffi (быстрый FFI для системных вызовов user32/kernel32).
Выбор пал на Electron сугубо из-за скорости прототипирования: настроенное Node.js-окружение уже было под рукой. Расплачиваться за это пришлось весом дистрибутива: папка «как есть» весит порядка 335 МБ (сам исполняемый файл — 234 МБ). Переписав обёртку на чистый C#/.NET или Go/Rust, размер можно ужать до пары мегабайт, но зависимость от установленного в системе Chrome всё равно останется базовой.
Текущие ограничения и приватность
Инструмент создавался для решения конкретной личной боли и пока находится в статусе «as is»:
-
Маршрут данных: Звук с микрофона уходит на серверы Google (это особенность Web Speech API, офлайн-режима тут нет). При вызове AI-редактирования текст фрагмента уходит в OpenAI или Anthropic (в зависимости от выбранного CLI-клиента). Если вы работаете с NDA, паролями или персональными данными — диктовать их через облачный движок нельзя.
-
SmartScreen: Бинарник пока без платного сертификата подписи кода, поэтому защитник Windows при первом старте ожидаемо предупреждает о неизвестном источнике.
-
Права: Если вы пытаетесь печатать в окно программы, запущенной «От имени Администратора», Input Voice тоже должен быть запущен с повышенными привилегиями (стандартное ограничение UIPI в Windows).
-
Знаки препинания: Голосовые команды вроде «новая строка» или «точка» пока не закладывались — эту работу я полностью переложил на шорткат LLM-редактора.
Итоги
Input Voice закрыл для меня проблему ручного ввода и усталости пальцев при составлении объемных задач и обсуждений. Теперь можно на одном дыхании наговорить поток мыслей и сразу скормить его Claude Code, либо нажать горячую клавишу и получить структурированный связный текст.
Мои готовые решения для 1С (маркировка, токены, ТСД и т.д.):


Вступайте в нашу телеграмм-группу Инфостарт

