Git вместо хранилища в обычном Конфигураторе: ветки задач, синхронизация базы и загрузка по git diff
Разработка - DevOps и автоматизация разработки
Когда в команде больше трёх разработчиков, хранилище конфигурации начинает мешать: общий модуль захвачен коллегой, непроверенную задачу уже не вынуть из релиза, а релиз собирается вечером пятницы вручную. Обычный совет в таком случае — переходить на EDT (1С:Enterprise Development Tools) и git. Совет правильный, но дорогой: новая среда, мощные машины, переобучение всей команды и несколько месяцев, пока процесс снова заработает.
Я пошёл третьим путём. Разработчики остаются в обычном Конфигураторе, а git становится транспортом между их базами. Эта статья — практическое описание такого процесса: модель веток, правило, которое не даёт базе и файлам разойтись, загрузка в базу только изменённых файлов, работа с серверными базами через кластер и грабли платформы, на которые я наступил. Всё описанное собирается из штатных инструментов: git, ibcmd, пакетного режима Конфигуратора и rac. Повторить это можно на скриптах PowerShell, OneScript или в CI (системе непрерывной интеграции).
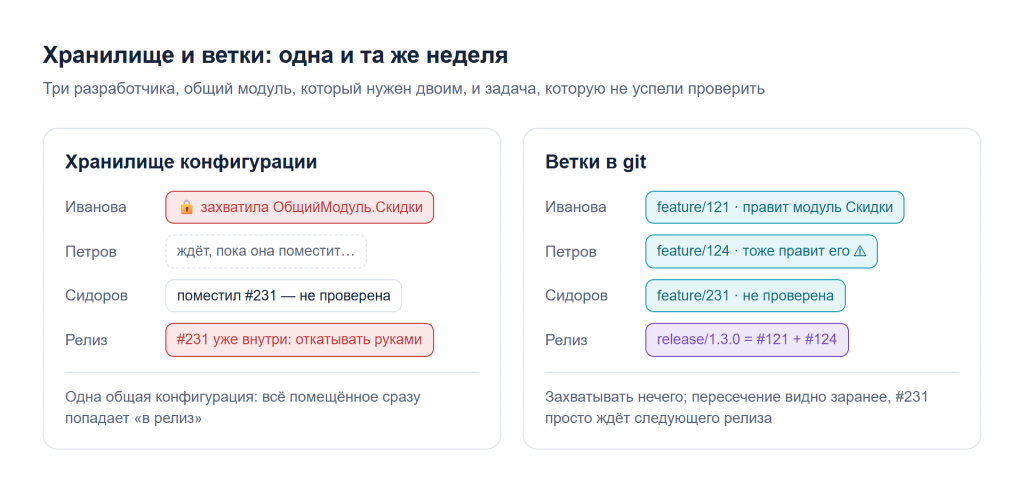
Хранилище и ветки: одна и та же неделя
Что не так с хранилищем
Хранилище — это одна общая конфигурация с пессимистичными блокировками. Пока команда маленькая, это удобно. С ростом команды вылезают три проблемы.
- Захваты. Общий модуль «держит» коллега. Остаётся ждать, пока он поместит изменения, или править в обход и потом переносить руками.
- Нет изоляции задач. Всё помещённое сразу попадает в общую конфигурацию. Не успели проверить одну задачу — откатываете её вручную или переносите весь релиз.
- Релиз — ручная работа. Собрать CF (файл конфигурации) и CFU (файл обновления), описать, что вошло, поставить метку. Каждый раз одно и то же.
Git решает все три: веток сколько угодно, захватывать нечего, а релиз — это слияние выбранных веток. Сложность в другом: git работает с файлами, а разработчик 1С — с базой. Значит, кто-то должен постоянно перекладывать конфигурацию из базы в файлы и обратно, причём быстро и без ошибок. EDT решает это, заменяя Конфигуратор целиком. Мне нужно было решить это, Конфигуратор не трогая.
Идея: база — это рабочая копия
Каждый разработчик работает в своей базе, файловой или серверной. Между базой и сервером git лежит каталог исходников — XML-выгрузка конфигурации средствами платформы: основная конфигурация в src/cf, каждое расширение в src/cfe/<Имя>. Все операции процесса сводятся к перекладыванию конфигурации между этими тремя местами.
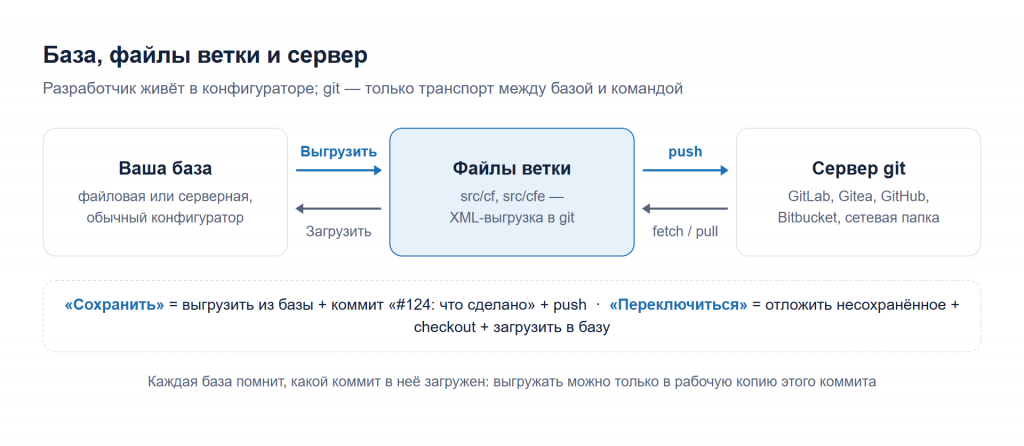
База, файлы ветки и сервер
Операций, с которыми сталкивается разработчик, всего несколько:
| Операция | Что происходит внутри |
|---|---|
| Новая задача | git fetch, ветка feature/<номер>-описание от свежего develop, загрузка конфигурации ветки в базу |
| Сохранить | выгрузка из базы в файлы, коммит с комментарием #124: что сделано, git push |
| Переключиться | несохранённое откладывается временным коммитом, git checkout, загрузка другой ветки в базу |
| Завершить | в ветку вливается свежий develop, конфигурация проверяется загрузкой в базу и синтаксическим контролем модулей |
| Тестовая сборка | ветка test пересобирается от develop с отмеченными задачами и грузится в тестовую базу |
| Релиз | ветка релиза, CF и CFU поставки, описание релиза |
Перед каждой загрузкой в базу полезно показывать предпросмотр: загрузка будет частичной или полной, какие объекты изменятся и удалятся, сколько коммитов develop придёт и ожидается ли конфликт. Тогда разработчику не нужно знать слова rebase и merge-base, а сюрпризов не бывает.
Модель веток: задачи встречаются только в релизе
Ветвление — вариация git-flow (известной схемы веток master, develop, feature, release), но с одним важным отличием. В классическом git-flow готовая задача вливается в develop, и дальше её оттуда не достать. Здесь задача не вливается в develop до выпуска. Она живёт в своей ветке до тех пор, пока релиз-менеджер не включит её в релиз.
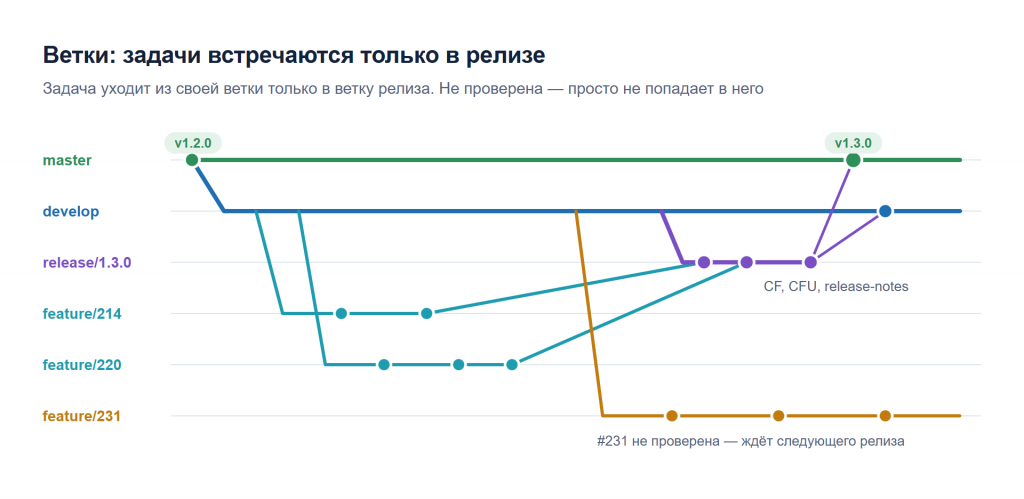
Ветки: задачи встречаются только в релизе
Это даёт две вещи:
- новая задача начинается с «чистой» конфигурации и не тащит за собой чужие непроверенные доработки;
- если задачу не успели проверить, её просто не включают в релиз — откатывать нечего.
Сборка релиза пересоздаёт ветку release/<версия> от develop и вливает в неё отмеченные задачи. Затем ветка грузится в сборочную базу, и в папку версии кладутся CF поставки, CFU от предыдущего релиза и release-notes.md. Пока релиз не выпущен, это черновик: develop и master не тронуты, тега нет. Сняли задачу — пересобрали.
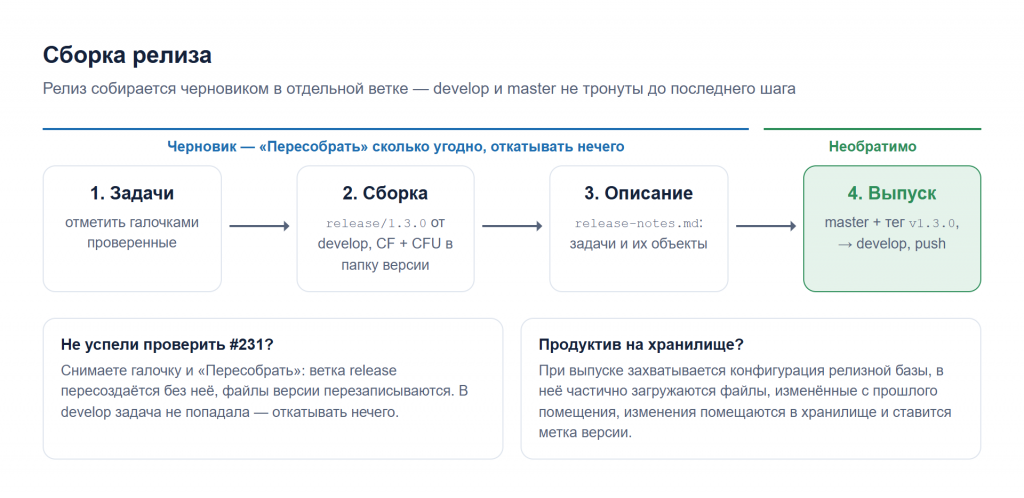
Сборка релиза
Выпуск — уже необратимый шаг: release → master с тегом v1.3.0, затем master → develop, ветки задач удаляются. Два правила, которые сэкономили много нервов:
- Версию конфигурации поднимают руками в свойствах конфигурации в одной из задач релиза, вместе с обработчиком обновления. Сборка её только проверяет: если версия не выше прошлого релиза, релиз не собирается.
- Описание релиза собирается само из номеров задач в комментариях коммитов и списка изменённых объектов. Руками дописываются только примечания для внедрения.
Если продуктив по-прежнему обновляется из хранилища, его можно оставить. Конфигурацию на поддержке целиком в хранилище залить не получится: платформа не даст заменить конфигурацию. Работает другой путь: захватить конфигурацию релизной базы, частично загрузить файлы, изменённые со времени прошлого помещения (исходники тега удобно брать во временном git worktree), поместить их с комментарием «Релиз 1.3.0: задачи» и поставить метку версии. Для разработки хранилище больше не нужно, а для эксплуатации остаётся.
Статусы задач — в самом git
Отдельный трекер для статусов не обязателен. Статус задачи можно хранить в git тегами на коммитах её ветки: ветка на сервере без тегов — «в работе», review/<ветка> — «на проверке», approved/<ветка> — «к релизу», done/<ветка> — «выпущена». Описание задачи удобно положить в сообщение тега task/<ветка>: описание ветки в git config видит только её автор, а тег после git push видят все. После git fetch вся команда видит одно и то же.

Путь задачи
Главное правило: база помнит загруженный коммит
Сделать «Сохранить» и «Переключиться» нетрудно. Трудно сделать так, чтобы они никогда не испортили работу разработчика. Главная опасность — выгрузить базу «не в ту» рабочую копию. Например, в базе лежит ветка #121, а в каталоге уже переключена #124. Выгрузка молча перезапишет файлы #124 содержимым #121, и следующий коммит унесёт это на сервер. Это самая частая причина вопроса «куда делись мои правки».
Поэтому вся синхронизация построена вокруг одного правила:
Для каждой базы хранится коммит, содержимое которого сейчас в ней (плюс правки разработчика, ещё не выгруженные). Выгружать можно только в рабочую копию этого коммита.
Если текущий коммит каталога (HEAD) не совпадает с загруженным, «Сохранить» не выгружает, а спрашивает: в базе версия другой ветки — выгрузить её полностью поверх файлов или сначала загрузить текущую ветку?
Вторая половина состояния — ConfigDumpInfo.xml. Платформа пишет в него версии объектов при выгрузке, и по нему можно понять, что изменилось в базе с прошлого раза. Беда в том, что файл один на каталог, а баз у разработчика несколько: разработки, тестовая, сборочная. Если хранить его в репозитории, каждая база будет затирать чужой. Поэтому ConfigDumpInfo.xml исключён из git (.gitignore), а своя копия хранится отдельно для каждой базы и каждого расширения в ней, в служебном каталоге рядом с репозиторием. Заодно это даёт полезную проверку: какие объекты разработчик уже поменял в Конфигураторе, но ещё не выгрузил.
Загрузка только изменённых файлов
Полная загрузка типовой конфигурации идёт долго, и переключение между задачами не может каждый раз занимать минуты. Раз база помнит загруженный коммит A, а грузить нужно коммит B, разница — это просто git diff --name-status A B -- src/cf. Остаётся решить, можно ли загрузить только её.
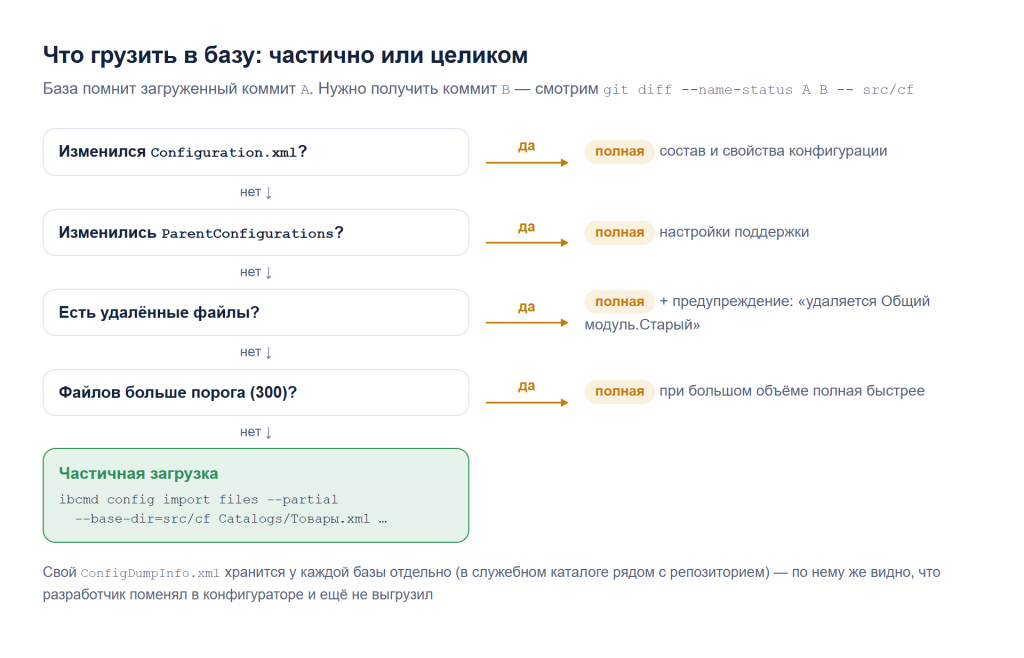
Что грузить в базу: частично или целиком
Правила выбора, по порядку проверки:
- В базу ещё не загружался известный коммит — только полная загрузка.
- Изменился
Configuration.xml(состав или свойства конфигурации, например номер версии) — полная. Частичная загрузка корня всё равно заставляет платформу перечитать всё дерево, по времени это как полная, но без её гарантий. - Изменились
ParentConfigurations(настройки поддержки) — полная. - Есть удалённые файлы — полная. Частичная загрузка объекты не удаляет. Удаляемые объекты стоит показать предупреждением: «удаляется Общий модуль.Старый».
- Файлов больше порога (у меня 300) — полная: при большом объёме она быстрее.
- Иначе — частичная загрузка списка изменённых файлов:
ibcmd config import files --partial --base-dir=src/cf Catalogs/Товары.xml …
У каждого расширения свой инкремент: сначала грузится основная конфигурация, потом каждое расширение со своим git diff и своим ConfigDumpInfo.xml.
Эти правила для файловой базы, а также проверку сеансов и запрет входа в серверную базу из раздела ниже я выложил скриптами PowerShell под лицензией MIT: configurator-git-scripts на GitHub.
Как это выглядит на самой большой типовой — ERP 2.6.2.59 на платформе 8.3.27, файловая база, ibcmd. Типовые модули на поддержке «с сохранением поддержки», наборы правок по 1, 50 и 250 модулей:
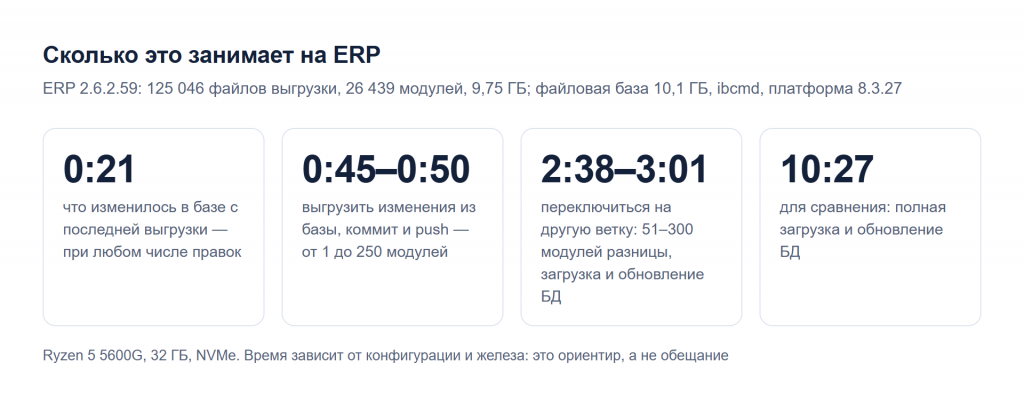
Сколько это занимает на ERP
Подробнее по операциям ERP:
| Операция | Время |
|---|---|
Узнать, что изменилось в базе с последней выгрузки (по ConfigDumpInfo.xml) |
0:20–0:21 |
| Выгрузить изменения, коммит и push: 1 / 50 / 250 модулей | 0:45 / 0:49 / 0:50 |
Новая задача, база уже есть: ветка от develop и частичная загрузка разницы |
1:57–2:47 |
| Переключиться: 51 / 251 / 300 модулей разницы, загрузка и обновление БД | 2:38 / 3:01 / 2:49 |
| Завершить задачу: проверка загрузки, теги статуса, push | 0:26 |
| Для сравнения: полная загрузка в существующую базу и обновление БД | 10:27 |
| Для сравнения: новая задача без базы (создание базы, полная загрузка) | 10:29 |
Основное время повседневных операций — открыть базу и спросить у платформы, что изменилось; число модулей почти ничего не добавляет. Обновление БД после частичной загрузки ERP занимает меньше минуты. На УТ 11.6 те же переключения идут 1:20–1:40. На вашей конфигурации и вашем железе цифры будут другими, но переключение задачи становится вопросом пары минут, а не получаса.
Кем выполнять операцию: ibcmd или Конфигуратор
ibcmd для файловых баз примерно вдвое быстрее пакетного Конфигуратора, но годится не везде. В итоге у меня сложилась такая таблица:
| Операция | Чем выполняю | Почему |
|---|---|---|
| Загрузка в файловую базу | ibcmd config import, частичная — config import files --partial |
примерно вдвое быстрее Конфигуратора |
| Загрузка в серверную базу | Конфигуратор /LoadConfigFromFiles с /UC <код> |
ibcmd ломает конфигурацию, см. ниже |
| Загрузка в базу, подключённую к хранилищу | Конфигуратор | ibcmd ничего не знает о захвате объектов |
| Выгрузка в файлы | ibcmd config export |
быстрее, читает напрямую из СУБД, в том числе серверной |
| Синтаксический контроль | Конфигуратор /CheckModules с явными режимами |
без режимов проверка ничего не проверяет |
| Резервная копия перед полной загрузкой | ibcmd infobase dump или /DumpIB |
внутри той же монопольной операции, что и загрузка |
| Сеансы и запрет входа | rac через RAS (сервер администрирования кластера) |
см. раздел о серверных базах |
Грабли платформы
Самая полезная часть этой работы — список того, что ведёт себя не так, как ожидаешь. Каждый пункт стоил мне от вечера до нескольких дней.
ibcmd config import в серверную базу «успешно» ломает её. Проверено на 8.3.27.2214 и MS SQL 2022: ibcmd config import (и config load) в серверную базу завершается без ошибок, но оставляет конфигурацию с ошибкой «Нарушена целостность структуры конфигурации». После этого не открываются ни Конфигуратор, ни config apply. Не помогают ни import → apply --dynamic=disable, ни предварительная инициализация базы, ни снятие с поддержки. Та же выгрузка через ibcmd в файловую базу и через Конфигуратор в серверную грузится чисто. Испорченную так базу возвращает ibcmd config reset: основная конфигурация снова становится равной конфигурации базы данных. Вывод: в серверные базы загружаю только Конфигуратором, а ibcmd оттуда только читает.
Синтаксический контроль без режимов ничего не проверяет. /CheckModules без указания режимов (тонкий клиент, сервер, внешнее соединение и так далее) честно отвечает «ошибок не обнаружено», не проверив ни строчки.
Платформа 8.5 и «Unknown exception». На 8.5.1.1529 частичная загрузка изредка падает в ibcmd с Unknown exception на исправном наборе файлов: в моих замерах по разу в каждом прогоне и в 4 сериях из 18 в отдельном опыте. Повтор того же набора файлов проходит. Если сразу переходить к полной загрузке, переключение задачи на ERP занимает 12 минут вместо 2–3, на УТ — 5 минут вместо полутора. Помогает один повтор частичной загрузки и только потом полная. На 8.3.27 таких сбоев не было ни разу.
Свободная память важнее процессора. ibcmd на ERP занимает до 5,5 ГБ. Когда свободным остаётся около 1 ГБ, полная загрузка и обновление БД идут в 5–9 раз дольше: загрузка — 35 минут вместо 7, обновление БД — 37 минут вместо 4. Смотрите на «Доступно» в диспетчере задач: после копирования больших выгрузок Windows держит в кэше файлов 13–18 ГБ. Для ERP в файловой базе держите свободными 8 ГБ и больше, а локальный сервер 1С и SQL Server на время загрузки лучше остановить, если они не нужны.
Открытый Конфигуратор держит файловую базу монопольно. Пакетные операции в это время невозможны. Тексты ошибок 1С и ibcmd о занятой базе стоит распознавать и предлагать понятное действие: сохранить конфигурацию (Ctrl+S), закрыть Конфигуратор и повторить.
Объекты типовой на замке поставщика не загружаются по одному, только вся конфигурация целиком. К этому нужно быть готовым при первом же обновлении типовой.
CFU собирается только от CF поставки предыдущего релиза, а не от обычной выгрузки CF. Поэтому CF поставки каждого релиза нужно хранить.
Большие двоичные файлы (CF поставщика на сотни мегабайт, двоичные макеты, ParentConfigurations.bin) сразу храните через Git LFS (Large File Storage, расширение git для больших файлов), иначе репозиторий быстро распухнет.
Репозиторий создавайте выгрузкой той же версией платформы, что у команды. Выгрузка другим релизом отличается в мелочах и даёт тысячи ложных изменений.
Серверные базы: пять шагов через кластер
Тестовая и сборочная базы в командах обычно серверные, и в них работают люди. Загружать конфигурацию, пока тестировщик проводит документы, нельзя. Сеансы проверяются и вход запрещается через утилиту rac и сервер администрирования кластера, и порядок шагов здесь важнее, чем кажется.
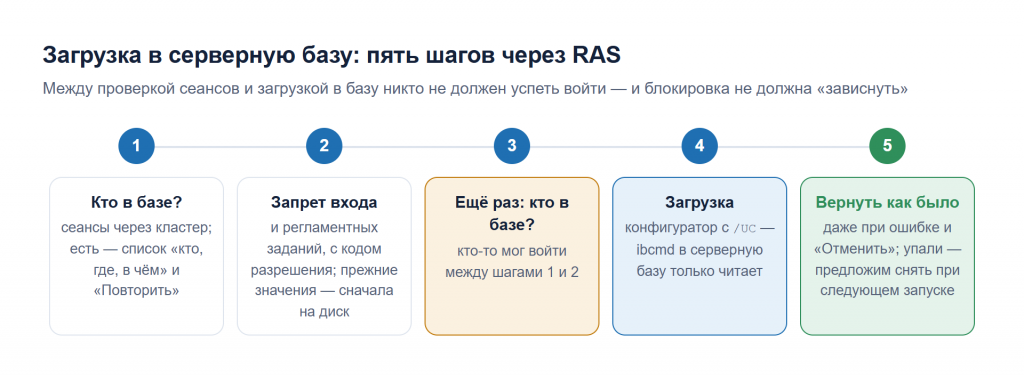
Загрузка в серверную базу: пять шагов
Сами команды штатные:
rac session list --cluster=<id> --infobase=<id>
rac infobase update --cluster=<id> --infobase=<id> --infobase-user=<пользователь> --infobase-pwd=<пароль>
    --sessions-deny=on --scheduled-jobs-deny=on --permission-code=<код> --denied-message="Обновление"
Загрузка Конфигуратором идёт с ключом /UC <код>, чтобы пройти через собственный запрет. Неочевидны два шага.
- Повторная проверка сеансов (шаг 3). Между «в базе никого» и «вход запрещён» кто-то может успеть войти. Без повторной проверки загрузка упадёт на середине или, хуже, пройдёт при активном сеансе.
- Прежние значения блокировки сначала пишутся на диск (шаг 2). Если скрипт упадёт или его закроют посреди загрузки, в базе останется запрет входа, и пользователи утром не смогут зайти. Сохранённые значения позволяют вернуть блокировку как было, даже после перезапуска. Возврат выполняется всегда: и при ошибке, и при отмене.
Если сервер администрирования недоступен, стоит хотя бы предупредить: «сеансы не проверены». О конфликте тогда сообщит сам Конфигуратор, он ходит через кластер.
Конфликты лучше видеть до слияния
В 1С конфликт слияния особенно неприятен: формы и модули объектов — это большие XML- и BSL-файлы, и разбирать их перед релизом не хочется никому. Гораздо дешевле договориться в начале работы: «я тоже трогаю ЧекККМ, давай я подожду твою задачу».
Для этого после каждого git fetch для всех активных задач команды строится список изменённых объектов метаданных. Пути файлов однозначно сворачиваются в объекты: Documents/ЧекККМ/Forms/ФормаДокумента/Ext/Form.xml → «Документ.ЧекККМ, форма ФормаДокумента». Пересечение объектов двух задач — повод предупредить. Для пар с общими объектами дополнительно запускается
git merge-tree --write-tree --name-only <ветка1> <ветка2>
Команда считает слияние без рабочей копии и по коду возврата честно говорит, будет ли конфликт. Результат можно кэшировать по паре вершин: история не меняется.
Тот же перевод путей в объекты даёт и историю объекта: кто, когда, в какой задаче и в каком релизе менял «Документ.ЗаказКлиента», а не сотню путей к файлам.
Когда конфликт всё-таки случился, нужно открыть файл во внешнем инструменте сравнения (VS Code, KDiff3, TortoiseGitMerge) или взять свою либо вливаемую версию целиком: для двоичных файлов вроде ParentConfigurations.bin другого способа нет.
Ещё по мелочи, но важно
- Откат выпущенной задачи. Задача сломала продуктив — создаётся ветка
hotfix/<номер>-revertотmasterи в нейgit revert -m 1слияния задачи. Само слияние удобно находить по тегуdone/<ветка>. Подвох в том, что повторное слияние старой ветки после отката ничего не вернёт: git считает эти коммиты уже влитыми. Поэтому новая задача с тем же номером должна начинаться с отката отката. - Резервные копии. Перед полной загрузкой можно делать файл выгрузки базы
.dtвнутри той же монопольной операции, что и загрузка, чтобы между копией и загрузкой никто не вошёл. Вместе с.dtстоит сохранять и состояние синхронизации — загруженный коммит иConfigDumpInfo.xml, — тогда после восстановления загрузки снова будут частичными. - Отмена посреди операции. Процесс 1С можно остановить, но посреди слияния или переключения ветки git прерывать нельзя: сценарий должен остановиться на ближайшем безопасном шаге. Прерванная загрузка помечает базу, и следующая загрузка будет полной.
- Тесты без платформы. Сценарии «сохранить, переключиться, завершить, релиз» со всеми ветвлениями удобно проверять на настоящем git, заменив 1С заглушкой, которая «выгружает» и «загружает» каталоги. Отдельный, более медленный набор тестов гоняется на настоящей платформе.
Ограничения подхода
- Частичная загрузка не удаляет объекты и работает только в базу, где уже есть совместимая конфигурация. Первый раз в пустую базу — только полная.
- Изменение состава или свойств конфигурации, настроек поддержки и любые удаления — полная загрузка.
- В серверные базы на 8.3.27 — только Конфигуратором, а это медленнее
ibcmd. - Подход проверен на Windows, платформе 8.3.27 и 8.5, Git for Windows с LFS.
- Это не замена EDT. Если команда уже работает в EDT, ей это не нужно. Если когда-нибудь решите перейти, репозиторий останется обычной XML-выгрузкой конфигурации, которую EDT умеет импортировать.
- Серверные базы для разработчиков всё равно нужно создавать в консоли кластера, а версию конфигурации — поднимать руками.
- Сервер git подойдёт любой: GitLab, Gitea, GitHub, Bitbucket, даже сетевая папка.
Итог
- Одна задача — одна ветка. В
developзадача попадает только вместе с релизом, поэтому непроверенную достаточно не включить в сборку. - Каждая база помнит загруженный коммит и хранит свой
ConfigDumpInfo.xml. Выгрузка не затрёт чужую ветку, а загрузка идёт поgit diff, а не всей конфигурацией. ibcmd— для файловых баз и для чтения. В серверные базы на 8.3.27 — только Конфигуратором, с запретом входа черезracи повторной проверкой сеансов.- На ERP переключение задачи занимает 2–3 минуты против 10 с лишним на полную загрузку, если свободной памяти хватает.
Отдельно интересен опыт с серверными базами: если вы загружали конфигурацию в серверную базу через ibcmd на 8.3.27 без ошибки целостности, напишите в комментариях, при каких условиях это получилось.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

