Код внешних обработок не читал никто, мой в том числе
Разработка - Рефакторинг и качество кода
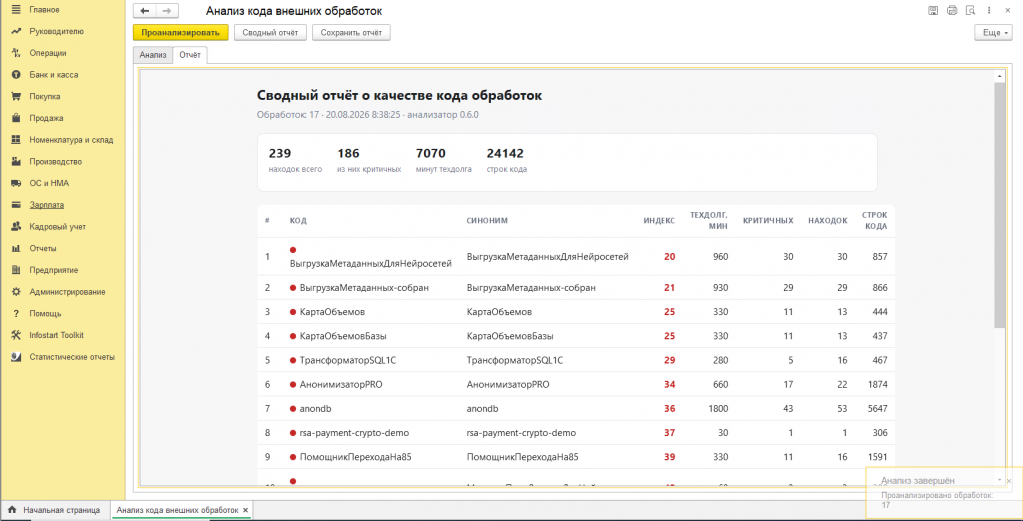
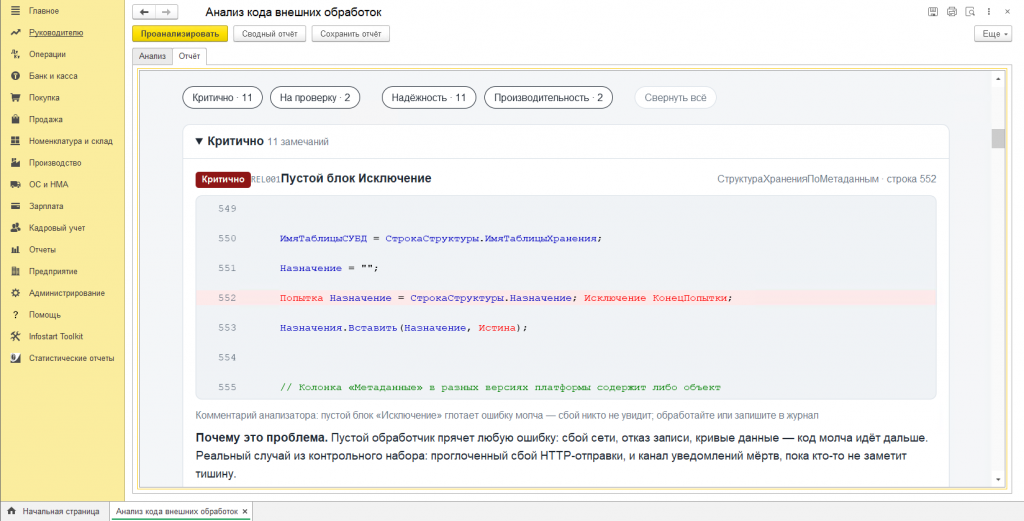
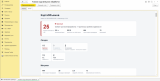
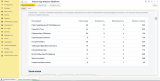
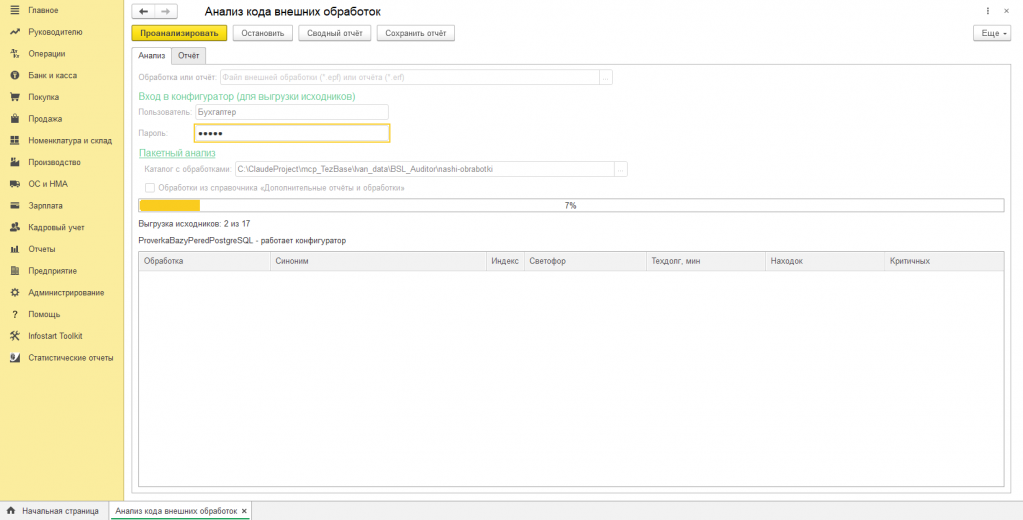
Я прогнал свой анализатор по семнадцати собственным обработкам. Тем самым, которые лежат на Инфостарте и которые у меня покупают.
Он нашёл 239 замечаний, из них 186 критичных. Семь тысяч минут технического долга, это почти пятнадцать рабочих дней по восемь часов, если сесть и всё починить. 24 142 строки кода в семнадцати файлах, и вот по ним такой расклад.
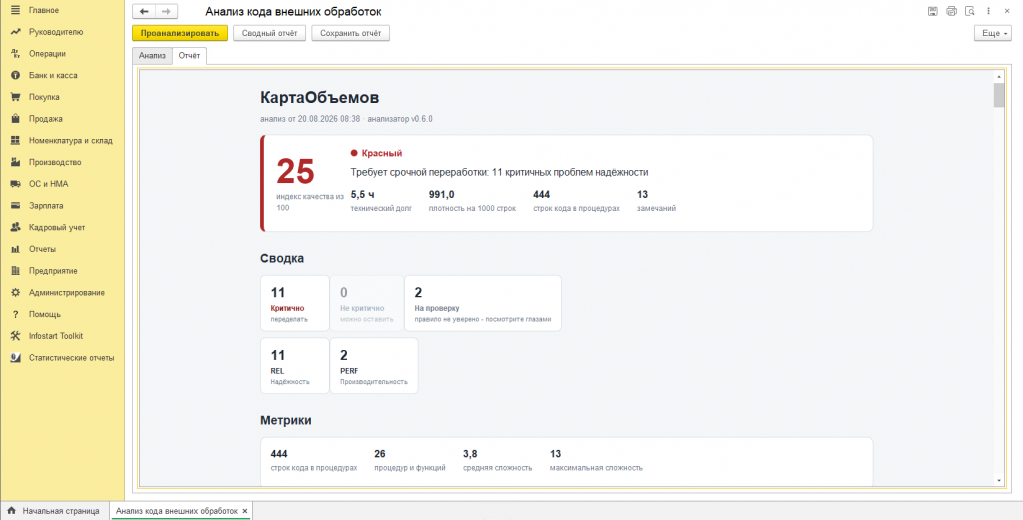
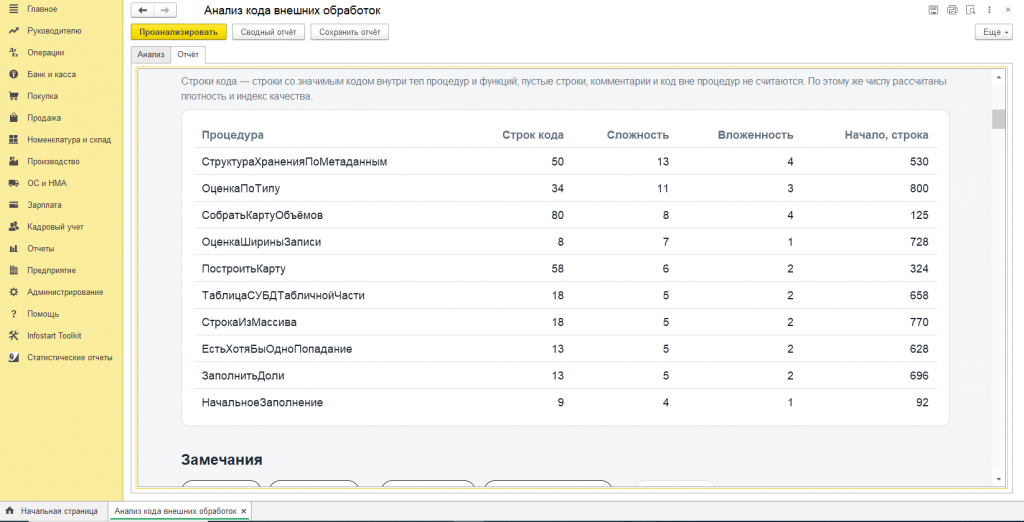
Хуже всех оказалась "Выгрузка структуры метаданных для нейросетей": индекс качества 20 из 100, тридцать критичных находок на 857 строк. У "Карты объёмов" индекс 25, одиннадцать критичных на 444 строки, красный светофор и приговор "требует срочной переработки". Взвешенная плотность находок 991 на тысячу строк, пять с половиной часов на исправление. Это не учебные примеры, это файлы, которые люди скачали и запустили у себя.
Чинить это буду я, и порядок мне задаёт тот же рейтинг: сверху вниз, начиная с двух красных. На момент публикации ни одна из семнадцати не переписана, и цифру я показываю до починки, а не после.
Потому что статью про инструмент проверки кода легко написать так, что автор в ней безупречен, а плохой код где-то у других. Такую статью читают до середины и закрывают. Свой красный светофор доказывает, что инструмент работает, лучше любого описания правил.
Дальше по порядку: откуда взялась задача, почему её пришлось решать движком с лексером и парсером, из чего этот движок состоит и по каким правилам он ищет.
Откуда вообще взялась задача
Откройте справочник дополнительных отчётов и обработок в любой базе, которая живёт больше трёх лет. Там будет два-три десятка позиций. Часть писали вы, часть предыдущий разработчик, часть прислал подрядчик, а про несколько штук никто уже не помнит, откуда они взялись. Все они запускаются с правами пользователя, ходят в базу, пишут документы, дёргают HTTP. И ни одну из них никто ни разу не открывал в редакторе.
Пока всё работает, это никого не беспокоит. Беспокоить начинает в момент, когда база тормозит по вечерам и надо понять, кто виноват. Или когда подрядчик прислал .epf и спрашивает, когда выкатим, а у вас на ревью чужих двух тысяч строк нет ни половины дня, ни желания.
Я эту задачу решал руками много раз, а потом написал под неё внешнюю обработку на чистом BSL (встроенный язык 1С:Предприятия, тот самый, на котором вы пишете каждый день). Она читает исходники других обработок и говорит, с какой из них стоит начинать.
Почему готовые ответы сюда не подходят
Статический анализ кода 1С придуман до меня, и решения есть хорошие. BSL Language Server, SonarQube, EDT, АПК. Я ими пользуюсь и никого не собираюсь заменять.
Только все они заточены под другую задачу. Они смотрят туда, где код уже под контролем: конфигурация, репозиторий, ветка, сборка. Чтобы туда попасть, код должен сначала стать проектом. Нужен git, нужна выгрузка в исходники, нужна Java, нужен сервер анализа, нужен человек, который всё это поднимет и будет чинить, когда оно сломается. Для командной разработки это правильные вложения. Для "мне прислали обработку, посмотри за десять минут" это неподъёмный входной билет.
Второе, что не сходится, ещё проще. Внешние обработки в репозитории не лежат. Они лежат в справочнике и в папке на сетевом диске, каждая внутри двоичного файла .epf, из которого исходники ещё надо достать конфигуратором. Сборка про них не знает и знать не может.
И третье. Часть кода, который надо посмотреть, вам не принадлежит: обработка подрядчика, купленный на площадке инструмент, наследство от прошлой команды. Отправлять это во внешний сервис вы не имеете права, а согласование со службой безопасности дороже, чем прочитать глазами.
Поэтому анализатор устроен так, как устроен: чистый BSL, всё внутри 1С, наружу не уходит ничего. Ни интернета, ни внешних компонент, ни Java, ни Python. Скачали файл, открыли в базе, нажали кнопку. Анализируемый код не покидает вашу машину, и это условие, при котором инструментом вообще можно пользоваться на чужом коде.
Что человек получает на выходе
Самая частая ошибка при разговоре про анализаторы это разговор про количество правил. Правил у меня двадцать одно по модулям и семь по схемам компоновки. У SonarQube их сотни. Если мерить так, я проиграл ещё до начала.
Мерить надо другим: сколько времени экономится на конкретной задаче.
Сводный рейтинг обработок. При прогоне по каталогу или по справочнику допобработок строится таблица всех разобранных обработок, отсортированная по индексу качества, худшие сверху. Это ответ на вопрос "с чего начинать", которого нет у анализаторов, работающих по одному файлу. Двадцать пять обработок в базе, три красные, начинать с них, про остальные двадцать две можно спокойно не думать.
Индекс качества, 0-100. Взвешенная плотность находок на тысячу строк кода, шкала логарифмическая. Плотность нужна, чтобы модуль на двадцать тысяч строк с пятью замечаниями не выглядел хуже, чем модуль на двести строк с тремя.
Поверх плотности стоят два жёстких потолка, и они важнее арифметики:
- есть хотя бы один Blocker, индекс не поднимется выше 49, светофор красный всегда;
- есть хотя бы один Critical, потолок 79, зелёным не станет.
Без этих потолков захардкоженный пароль в большом модуле утонул бы в плотности и дал зелёный светофор. Так делать нельзя, поэтому арифметика тут уступает.
Технический долг. Сумма нормативных трудозатрат на исправление находок. Это порядок величины, с которым можно идти к руководителю: "на приведение этой обработки в порядок нужно полтора дня, решайте". Мои семнадцать файлов в этой валюте стоят почти пятнадцать рабочих дней.
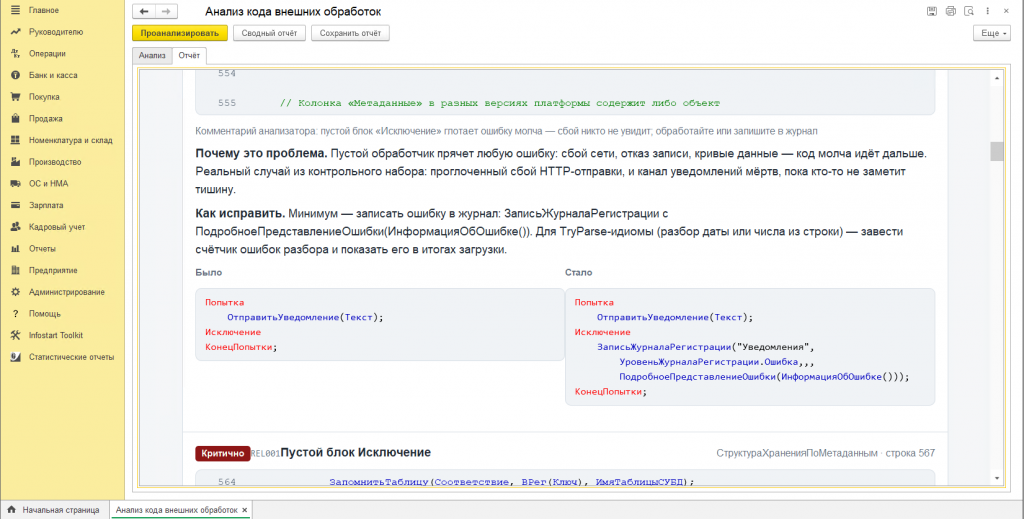
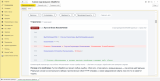
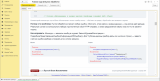
Находки с кодом. Номер строки, фрагмент с подсветкой, объяснение, чем это плохо и что писать вместо. HTML-отчёт открывается прямо в форме и сохраняется на диск, чтобы приложить к письму подрядчику.
Отдельная кнопка для схем компоновки. У внешнего отчёта главный запрос лежит в схеме компоновки данных, в модуле его нет вовсе, и анализ модулей проходит мимо. На одном и том же наборе кода правило про соединение с подзапросом срабатывает в схемах кратно чаще, чем в модулях. Половина проблем с запросами лежит там, куда анализаторы модулей не заглядывают.
Три сценария, ради которых это писалось
Приёмка чужой обработки. Подрядчик прислал .epf. Прогоняете, смотрите отчёт. Запись объекта в цикле по выборке и пустой блок Исключение вокруг HTTP-отправки делают разговор предметным, со ссылкой на номер строки: полдня чтения сжимаются до одной страницы.
Самопроверка перед отдачей. С этого начинается статья, и результат вы видели.
Теперь про то, почему это движок, а не поиск по тексту
Первую версию я сделал за вечер на регулярных выражениях. Она искала .Выполнить( внутри блока Цикл, ПолучитьОбъект() там же, пустое Исключение, конкатенацию в цикле. Работала быстро, выдавала много находок, выглядела убедительно.
Дальше я собрал контрольный набор: 32 срабатывания на реальном коде. Вердикт по каждому выносился по исходному коду объемлющей процедуры целиком, тремя независимыми проходами, и отчёт прототипа в расчёт не брался: задание было искать ошибку в его вердикте, а не подтверждать.
Расклад получился такой:
| Вердикт | Позиций |
|---|---|
| Ложное срабатывание | 20 |
| Настоящий дефект | 7 |
| Спорно, надо смотреть глазами | 5 |
Точность 22 процента. Из тридцати двух замечаний настоящих семь.
Это, между прочим, ровно то ощущение, которое у многих остаётся от анализаторов вообще: прогнал, получил простыню, полистал, закрыл. Причина тут не в плохих правилах. Правила нормальные. Регулярка просто не понимает, на что смотрит.
Разберу четыре класса промахов: каждый снимается своим слоем движка.
Находка внутри строки или комментария
Самый массовый и самый обидный класс.
Запрос.Текст =
    "ВЫБРАТЬ
    |   Товары.Ссылка
    |ИЗ
    |   Документ.РасходТовара.Товары КАК Товары";
Регулярка честно видит в этом тексте слова, которые ищет, и рапортует о находке. А это строковый литерал, текст запроса. Одна из позиций контрольного набора выглядела как запись объекта в цикле, и процедура на самом деле была образцово батчирована: находка сидела внутри текста запроса. То же самое с комментариями: закомментированный кусок кода это не код, но для поиска по тексту разницы нет.
Лечится лексером: посимвольный проход с тремя состояниями, код, литерал и комментарий. Кавычка открывает литерал, две кавычки подряд внутри это экранирование, // вне литерала открывает комментарий до конца строки.
Коварство тут в направлении вранья: молчал бы, было бы полбеды, а он врёт в сторону уверенных находок. Отчёт получается полный, красивый и неверный, и проверить его можно только чтением исходников.
Цикл из соседней процедуры
Счётчик вложенности циклов у прототипа не обнулялся на границе процедуры. Цикл открылся в одной процедуре, закрылся там же, а находка из следующей процедуры уже считалась "внутри цикла". Формулировка "запрос внутри цикла" при этом звучит убедительно, и на ревью такое проходит: никто не полезет проверять, тот ли это цикл.
Лечится парсером: дерево блоков, стек циклов, сброс стека на токенах Процедура, Функция, КонецПроцедуры, КонецФункции.
Одно имя метода у разных объектов
КомпоновщикМакета.Выполнить(СКД, Настройки, ДанныеРасшифровки);
Это компоновка макета в памяти. К СУБД обращения нет вовсе. Для регулярки это .Выполнить( в цикле, то есть запрос в цикле, то есть Blocker.
Так же с Записать: ДвоичныеДанные.Записать(Путь) пишет файл на диск, ДокументОбъект.Записать() пишет в базу. Одно слово, разная цена. И Счётчик = Счётчик + 1 для правила про конкатенацию в цикле неотличимо от Лог = Лог + Строка.
Лечится трассировкой конструктора. В пределах процедуры ведётся таблица "переменная, чем создана". Новый Запрос кладёт переменную в множество запросов, Новый КомпоновщикМакетаКомпоновкиДанных в множество "не СУБД". Правило про запрос в цикле смотрит только на первое множество. Полноценный вывод типов на BSL я не потяну, да и не нужен: хватает трассировки в пределах одной процедуры.
Цикл, тело которого выполняется один раз
Для Каждого Строка Из Выборка Цикл
    Объект = Строка.Ссылка.ПолучитьОбъект();
    Возврат Объект;
КонецЦикла;
Тело выполняется максимум один раз: безусловный Возврат или Прервать в той же ветке превращает цикл в однократное выполнение, и находка внутри него уже не про производительность. Лечится тем же деревом блоков. Есть между находкой и ближайшим КонецЦикла выход на том же уровне вложенности, находка понижается до информационной.
Из чего состоит движок
Слово "анализатор" у большинства связано со списком плохих паттернов: есть список, инструмент по нему проходит. У меня правила это четвёртый слой из шести, и три слоя до них существуют ровно затем, чтобы находка не врала так, как врал прототип.
1. АДАПТЕРЫ ИСТОЧНИКА  разные форматы входа -> единая модель
        v
2. ЛЕКСЕР              текст -> поток токенов
        v
3. ПАРСЕР              токены -> структура кода + разбор запросов
        v
4. ПРАВИЛА             каталог проверок по токенам и структуре
        v
5. СКОРИНГ             метрики, индекс качества, техдолг
        v
6. ОТЧЁТ               один самодостаточный HTML
Адаптеры источника. На входе два разных зверя: распакованный дамп .epf и выгрузка конфигурации в файлы. Раскладка каталогов у них своя, модуль объекта лежит в разных местах, у форм разные имена файлов. Адаптер приводит оба к одной модели: обработка, у неё метаданные и список модулей, у модуля путь, вид, тип формы и текст. Дальше по цепочке никто уже не знает, откуда пришёл код, поэтому третий источник добавляется одним файлом.
Лексер. Текст превращается в поток токенов. Он знает про комментарии, про многострочные литералы с вертикальной чертой в начале строки, про инструкции препроцессора и аннотации. Отдельно помечает литералы, похожие на текст запроса, чтобы дальше их можно было разобрать как запрос. Именно этого слоя не было у версии на регулярках, и отсюда шёл самый массовый класс вранья.
Парсер. Токены превращаются в структуру: где начинается и кончается процедура, дерево блоков внутри неё, циклы с глубиной вложенности, вызовы с привязкой к конкретному циклу. Здесь же живёт мини-парсер языка запросов 1С (SDBL): найденный текст запроса разбирается на секции, соединения, условия, поэтому правила по запросам работают уже с разобранным запросом.
Правила. Каталог проверок. Главное свойство сформулировано запретом: правило работает по токенам и структуре, доступа к сырому тексту у него нет. Стоит правилу начать искать подстроку, и оно тащит за собой все ошибки, ради которых писались слои выше. Правила разложены по профилям: ОБЩИЙ работает всегда, ОФ только на обычных формах, УФ только на управляемых. Профиль определяется автоматически по наличию директив компиляции в модуле, и правило чужого профиля не выполняется вовсе. Это и скорость, и минус целый класс ложняка. Честно про состояние: сейчас все включённые правила лежат в ОБЩИЙ, наборы ОФ и УФ пустые. Механизм есть, правил в нём пока нет.
Скоринг. Метрики, индекс качества, технический долг в минутах. Потолки по Blocker и Critical живут здесь.
Отчёт. Один HTML-файл без внешних зависимостей: подсветка, свёрнутые блоки, рейтинг обработок. Открывается там, где нет ничего, кроме браузера, и уходит письмом подрядчику как есть.
Плюс две вещи вокруг движка, без которых он разваливается на второй неделе.
Реестр правил. Таблица значений: идентификатор, категория, профиль, уровень, вес, признак включения, имя процедуры. Диспетчер вызывает Выполнить("Правило_" + Имя + "(...)"). Один вызов на правило на модуль, и никогда внутри цикла по токенам: Выполнить() дорогой вызов, и в цикле по токенам его быть не должно. Новое правило это строка в реестре и процедура, менять диспетчер не нужно.
Тесты на каждое правило. Пара мини-файлов на правило: "здесь обязано сработать" и "здесь обязано молчать". Второй важнее первого. Правило, которое ловит свой паттерн, пишется за полчаса; правило, которое молчит на всём похожем, требует ещё трёх заходов, и без негативного теста их никто не сделает.
По каким правилам он ищет
Правила разложены по шести категориям. У каждого уровень (Blocker, Critical, Major, Minor, Info) и вес. Уровень задаёт потолок индекса для всей обработки: один Blocker красит светофор в красный независимо от размера модуля, а сорок Minor утонут в плотности большого файла и правильно сделают.
Вес это минуты на исправление одной находки. Из него складываются и взвешенная плотность, и технический долг: те самые семь тысяч минут из первого абзаца это сумма весов всех 239 находок, в среднем по тридцать минут на штуку.
В таблицах ниже самые дорогие правила каждой категории, не весь каталог.
PERF, производительность. Тут живёт то, из-за чего обработка летает на тестовой базе и висит на рабочей.
| Что ищем | Уровень | Вес |
|---|---|---|
Запрос.Выполнить() внутри цикла |
Blocker | 60 |
ПолучитьОбъект() или Записать() в цикле |
Critical | 45 |
.Выбрать() без отбора |
Critical | 40 |
| Конкатенация строк в цикле | Major | 20 |
Запрос в цикле стоит шестьдесят и уровень Blocker, потому что цена ошибки растёт линейно с данными: на десяти записях никто ничего не заметит, на десяти тысячах обработка встанет. Выборка без отбора это тот же механизм с другой стороны: читаем всю таблицу и фильтруем в коде.
QRY, запросы в модулях.
| Что ищем | Уровень | Вес |
|---|---|---|
| Соединение с подзапросом | Critical | 45 |
ВЫБРАТЬ * |
Minor | 10 |
Соединение с подзапросом стоит дорого: у оптимизатора СУБД по такому соединению нет статистики, и план он выбирает вслепую. ВЫБРАТЬ * стоит десятку, гадость предсказуемая.
СКД, запросы в схемах компоновки. Отдельный проход и отдельная кнопка, и это половина находок по запросам.
| Что ищем | Уровень | Вес |
|---|---|---|
| Соединение с виртуальной таблицей | Major | 30 |
ИЛИ в условии соединения |
Major | 30 |
| Обращение через точку на три уровня и глубже | Major | 25 |
ПОДОБНО "%…" с ведущим процентом |
Major | 25 |
Обращение через точку на три уровня это неявные левые соединения, которых вы не писали и в тексте запроса не видите. ИЛИ в условии соединения обычно убивает индекс, ведущий процент в ПОДОБНО гарантирует сканирование целиком.
REL, надёжность.
| Что ищем | Уровень | Вес |
|---|---|---|
НачатьТранзакцию без отката |
Blocker | 45 |
Пустой блок Исключение |
Critical | 30 |
Транзакция без отката это заблокированные записи и повисший сеанс, который потом снимают руками. Пустой Исключение это молча проглоченная ошибка, и хуже всего он ведёт себя вокруг отправки: канал уведомлений умирает тихо, и никто не узнает, что алерты не ходят, пока не случится то, ради чего их заводили.
SEC, безопасность.
| Что ищем | Уровень | Вес |
|---|---|---|
| Хардкод пароля или токена | Blocker | 30 |
Выполнить() с кодом из переменной |
Critical | 40 |
| Инъекция во внешний запрос | Critical | 40 |
| Хардкод GUID | Major | 25 |
Хардкод GUID в списке потому, что при переносе базы он превращается в мину замедленного действия: ссылка есть, объекта нет. А Выполнить() с кодом из переменной это исполнение данных: если в переменную попадает что-то из файла или из реквизита, у вас в обработке дыра размером с платформу.
STD, метрики. Три порога: длина процедуры больше 125 строк, цикломатическая сложность больше 20, глубина вложенности больше 5.
Пороги выставлены не по учебнику. Длина и сложность взяты по девяносто пятому перцентилю большого набора реального кода, то есть флагуются те пять процентов процедур, которые действительно выделяются на фоне остальных. По сложности учебная рекомендация с перцентилем совпала, 20 против 21. По вложенности я оставил книжные пять уровней: перцентиль дал четыре, и по четырём флагуется слишком много обычного живого кода.
А вот порог длины процедуры я сначала поставил вдвое больше, 250 строк, и это была ошибка измерения, про неё в разделе про грабли. Настоящий перцентиль дал 125, и порог 250 пропустил бы половину слишком длинных процедур мимо.
Как правило попадает в релиз
Придумать правило легко: кандидатов у меня в списке под семь десятков, включено двадцать восемь. Фильтр из трёх условий:
| Фильтр | Порог |
|---|---|
| Частота | от десяти вхождений на живом коде, либо уровень Blocker, либо класс безопасности |
| Ущерб | внятный ответ на вопрос "что сломается или насколько замедлит" |
| Точность | ложных срабатываний меньше десяти процентов на выборке в тридцать срабатываний |
Смысл частотного порога простой: правило, которое не срабатывает никогда, раздувает каталог и создаёт ощущение мощности при нулевой пользе. Частоты меряны на большом наборе живого кода, состав которого я не публикую, поэтому дальше идут только сами числа срабатываний.
Две оговорки, из-за которых фильтр не превратился в украшение.
Транзакция без отката встретилась шесть раз. По частоте она вылетает. Хардкод пароля встретился пять раз и вылетает тоже. Оба остались, потому что это ровно те дефекты, ради которых аудит и заказывают: редкость не равна неважности.
Инъекция во внешний запрос прошла в релиз с единственным подтверждённым случаем, то есть формально фильтр её не пропускал вообще. Решение я записал в журнал явно: дыра в безопасности не становится менее важной оттого, что встретилась однажды. Записал именно потому, что фильтр, который обходят молча и когда удобно, через месяц перестаёт что-либо значить.
Третий пункт, точность, дороже всех остальных. Собрать тридцать срабатываний получается не везде: у редкого правила их шесть, и мерить долю ложных не на чем. Там вместо выборки работают парные тесты "должно сработать" и "должно молчать", а порог держится там, где выборка есть. История про 22 процента как раз про цену этого пункта.
Честные статусы: принято, чинить, отложено, сломано
У каждого правила в каталоге стоит статус, и он виден мне каждый день.
Принято. Детекция подтверждена на живом коде. Образец тут ПолучитьОбъект() или Записать() внутри цикла: сформулировано однозначно, ловится структурой, спорить не о чем.
Чинить. Правило стреляет, но даёт ложняк. Хардкод GUID сидит тут до сих пор: GUID предопределённого элемента обычно осознан, GUID документа почти всегда мина, и по тексту эти два случая пока не различаются. Там же пустой Исключение, который я долго считал эталонным правилом без единого промаха, пока не нашёлся контрпример, про него в разделе про грабли.
Отложено. Правило требует слоя, которого пока нет. Вложенные циклы со сложностью O(n²) и обращение к реквизитам ссылки через точку внутри цикла ждут нормального вывода типов. Написать их можно за час, и они будут врать.
Сломано. В текущем виде детектирует не то, поэтому выключено. Правило про временную таблицу без индекса сейчас работает счётчиком слова ПОМЕСТИТЬ. А помещение во временную таблицу само по себе дефектом не является: настоящее правило звучит как "таблица участвует в соединении и при этом не проиндексирована", и оно требует разбора запроса целиком. Пока не разберу, правило не включаю, потому что сотни находок ни о чём хуже, чем ноль находок.
Дорога из "сломано" в рабочее состояние выглядит так. Правило про Выполнить() строкой в первой редакции дало гору срабатываний, и почти все оказались вызовом Выполнить(); без аргументов вообще. Это вызов собственной экспортной процедуры с таким именем, стандартная схема для обработок, которые дёргает регламентное задание. Правило разделилось надвое: константная строка кода теперь Info с весом 10, а код из переменной остался Critical с весом 40, потому что это единственный из двух случаев, где данные и правда исполняются. Обе половины у меня пока в статусе "чинить": ложняк остался, но уже другого сорта.
Я специально держу этот список на виду и показываю его здесь. Инструмент, у которого нет ни одного изъяна, обычно означает, что автор их просто не искал.
Что вышло после движка
Собранный результат по механизмам (тесты разложены не по слоям схемы: типы и разбор схем компоновки сидят внутри парсера):
ЛЕКСЕР 45/0 | ПАРСЕР 38/0 | ТИПЫ 40/0 | ПРАВИЛА 67/0 | ОТЧЁТ 53/0 | СКД 29/0
= 272 проверки, 0 ошибок
На контрольном наборе: все двадцать ложных срабатываний замолчали, все семь настоящих дефектов найдены. Точность выросла с 22 процентов до 97. Оставшиеся спорные пять попали в уровень "требует ручной проверки", и это решение я считаю спорным сам.
Границы, названные прямо
Они же написаны в подвале каждого отчёта, потому что инструмент, который делает вид, что умеет больше, вреден.
Видит паттерны, не видит смысл. Скажет "запрос в цикле по выборке без ограничения, это тысячи обращений к СУБД". Не скажет "алгоритм расчёта себестоимости неверный".
Не знает кардинальности. Сколько строк вернёт запрос, из текста не следует. Цикл на десять записей и цикл на десять миллионов выглядят одинаково.
Не ходит между процедурами глубже одного уровня. Запрос в процедуре, которую вызывают в цикле через три уровня вложенности, он не увидит.
Не анализирует блокировки и не проверяет индексы СУБД под условия запросов. Для первого нужен рантайм и журнал.
Не читает обычные формы внутри .epf. Их модули лежат в бинарном Form.bin, и конфигуратор при выгрузке не отдаёт их отдельным файлом. Разбираются модуль объекта и управляемые формы. Для наследства, где половина обработок на обычных формах, это существенное ограничение, и я его не прячу.
Требования тоже без прикрас: платформа 8.3.27.1606 и выше, Windows, толстый или тонкий клиент. В веб-клиенте не работает, потому что там нельзя запустить конфигуратор для распаковки. Каждая распаковка занимает клиентскую лицензию, и на десятке обработок это десять последовательных запусков. Если исходники уже выгружены, можно скормить готовые .bsl и конфигуратор не трогать.
Если после этого списка инструмент всё ещё нужен, обработка лежит Анализ кода внешних обработок 1С: рейтинг по качеству, техдолг и находки с подсветкой.
Крупные модули идут одним куском. Лексер проходит модуль на двадцать тысяч строк примерно за десять секунд, а полного разбора с прогрессом и кнопкой "Остановить" пока нет: на очень большом модуле форма просто ждёт.
Грабли, которые стоили дороже всего
Не рекламная часть, но самая полезная для тех, кто будет делать похожее.
Молчаливый ноль на кодировке. ЧтениеТекста по умолчанию читает в системной ANSI, а выгрузка конфигуратора это UTF-8 без BOM. Первый прогон по реальным файлам дал ноль находок сразу по трём правилам, и выглядело это как "замечаний нет". Худший вид отказа: инструмент не падает и не ругается, он спокойно врёт в успокаивающую сторону. Кодировка теперь задаётся явно.
Удвоение строк при распаковке. Модули писались в текстовом режиме без явного указания переноса, Windows превратил \r\n в \r\r\n, и при чтении каждая строка стала двумя. Номера строк в отчётах уехали вдвое, статистика по длине процедур тоже. Это и есть тот самый порог 250 вместо 125 из раздела про метрики. Номер строки это основной способ доверять отчёту, и если он врёт, отчёт бесполезен целиком, каким бы верным ни был вердикт.
Пустой Исключение бывает законным. Правило про него я считал эталонным, без ложных срабатываний. Контрпример нашёлся:
Попытка
    Объект.ДатаИзготовления = Дата(СтрокаИзФайла);
Исключение
КонецПопытки;
В BSL нет неисключительного способа проверить строку на дату. Пустой блок здесь означает осознанное "не разобралось, оставить пустым". Правило осталось дефектом по умолчанию, но понижается до информационного, когда между Попытка и Исключение ровно одна инструкция и это присваивание с конструктором преобразования. Текст рекомендации при этом меняется на "заведите счётчик ошибок разбора".
Спорное место, про которое хочу услышать возражения
Уровень "требует ручной проверки". Тот самый, куда попали пять спорных позиций контрольного набора и куда идут находки, где число итераций цикла определить не удалось.
Мой довод: этот уровень означает не "мелочь", а "я не знаю". Запрос в цикле по выборке без ограничения на десяти записях норма, на десятках тысяч беда, и из текста программы разницы не видно. Показать такую находку с пометкой мне кажется честнее, чем промолчать.
Контрдовод сильный. Каждая неуверенная находка это работа человека, которую инструмент на него перекладывает, а анализатор, который прячет всё, в чём не уверен, выдаёт короткий чистый отчёт, и такому отчёту доверяют больше. Раздутая корзина "на проверку" была у меня реальной проблемой: пришлось учить движок оценивать порядок числа итераций по источнику цикла.
Красивого решения тут нет. Либо отчёт честный и местами шумный, либо чистый и местами лживый.
Как считаете правильным вы: анализатор должен показывать то, в чём не уверен, с пометкой, или молчать, пока не уверен?
И второй вопрос, который меня правда интересует. Сколько внешних обработок лежит в вашей рабочей базе, и когда последний раз кто-нибудь открывал код хотя бы одной из них?
Другие наши инструменты:
- Помощник перехода на 1С 8.5 - тот же разбор кода, только вопрос другой: что перестанет работать после смены платформы. Половина находок там сидит в модулях, куда при переходе смотрят в последнюю очередь.
- Трансформатор SQL в 1С - переводит запрос из профайлера обратно в имена справочников и регистров. Нужен ровно тогда, когда видно, что база тормозит, а чей это запрос непонятно.
- Оптимизатор временных таблиц - следующий шаг после находки: разбирает пакетный запрос и показывает, где не хватает индекса и где лишний проход по временной таблице.
- Чек-ап СУБД под 1С - вторая половина диагностики. Код бывает чистым, а тормозит всё равно, и тогда вопросы уже к настройкам сервера.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.