Контекст задачи: крупные компании и импортозамещение
Почему мы вообще столкнулись с этой проблемой? Мы, я имею ввиду ИБС – большие: у нас много офисов по России, общая численность – 3 000 сотрудников, около 500 – это только практика 1С, а команда по ЗУП – это 50 консультантов. И наши клиенты такие же большие – мы работаем с нефтью и газом, металлургией, ритейлом – с любым крупным игроком из этих отраслей мы так или иначе взаимодействуем.
После того как страна взяла курс на импортозамещение, к интеграторам начали приходить компании с вопросом: «Как нам дальше жить? Я только вчера узнал, что SAP уже нельзя купить – нет лицензий».
Мы начали рассматривать разные сценарии, смотреть на варианты реализации, в том числе 1С:Fresh, и в итоге собрали небольшой список – топ-5 проблем, с которыми сталкиваемся при попытке переезда.
Технические ограничения и анализ узких мест
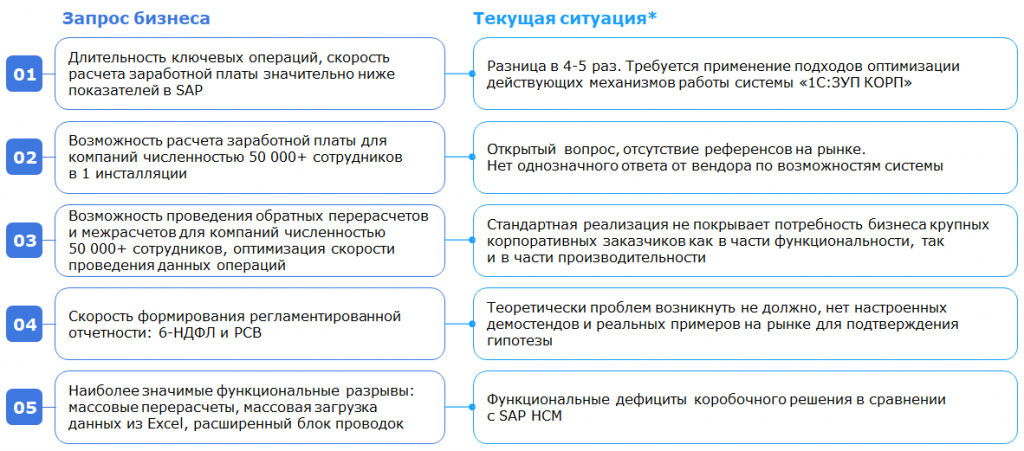
Первые два пункта нас отсекают сразу. 50 000 сотрудников – это достаточно крупная компания, расчет ЗП в одной базе для ЗУП у такого заказчика – серьезный вызов. Но для нас это достаточно типичный кейс.
Если вы занимаетесь расчетом зарплаты и пробовали считать большие организации, вы наверняка сталкивались с проблемой количества строк в документе начисления зарплаты. 10 000 сотрудников, по 10 начислений на каждого – и вы уже упираетесь в предел по количеству записей в 99 999. Насколько я знаю, проблема решена в 27-й платформе, но это только одна из сложностей, которая возникает при решении задачи.
В итоге мы уперлись в ключевую вещь: чтобы посчитать зарплату, нужно время. Когда это час-два – нормально, можно сходить попить чай, пообедать. Когда это сутки – это уже проблема.
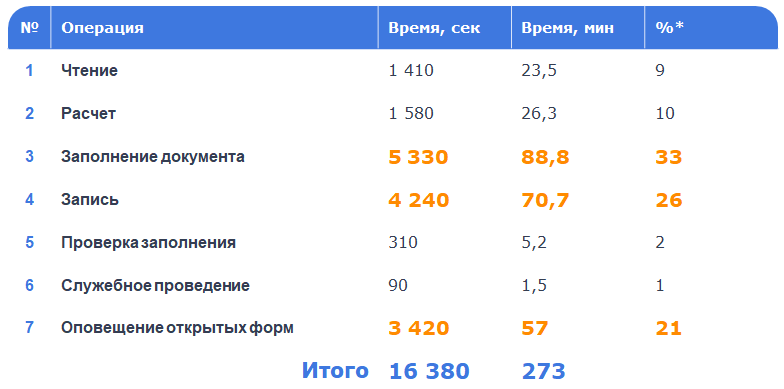
Чтобы решить проблему, нужно понять ее причину. Мы взяли документ начисления зарплаты и вообще все документы в этой цепочке. Самый характерный пример – именно он.
Время выполнения разложилось следующим образом. Три операции – заполнение, запись и, самое главное, открытые формы и их оповещения – на это уходит 80% времени. Теперь проблема стала понятна – осталось ее решить.
Поиск решений и архитектура системы
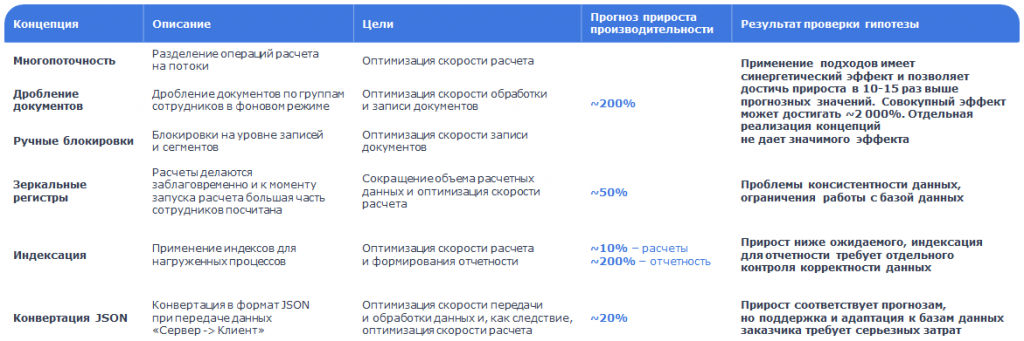
Наша команда начала искать гипотезы: выдвигать свои, смотреть, что публикуют коллеги, в том числе на «Инфостарте». В таблице приведен только короткий список – там были даже довольно безумные варианты: например, считать зарплату ежедневно, складывать результаты, потом их сравнивать. В общем, вариантов было много.
Нижние три идеи мы пока отмели – не используем, но окончательно не забыли. Есть ощущение, что индексация может дать хороший прирост при формировании отчетности. Например, при расчете 6-НДФЛ на большой объем данных. Потому что многопоточность для одного отчета, скорее всего, не получится применить.
В итоге в топ-3 у нас вышли три концепции: многопоточность (параллельный расчет), дробление документов и ручные блокировки.
Параллельный расчет требует блокировок, потому что процессы идут одновременно в нескольких направлениях. Дробление документов – это разделение данных по объектам. Каждая идея давала небольшой прирост, но вместе, по нашим оценкам, они должны были дать двукратное или трехкратное ускорение.
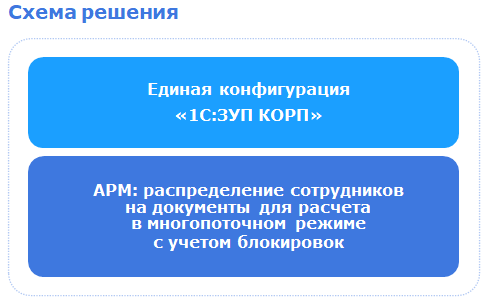
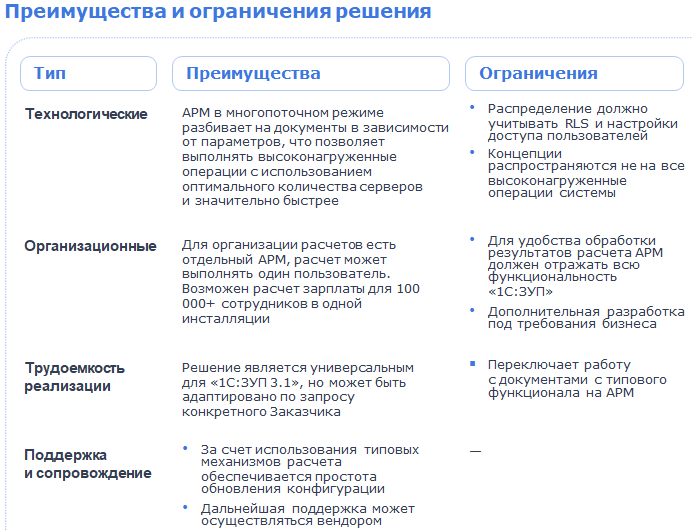
Но при дроблении возникает проблема: у нас десятки тысяч сотрудников, есть RLS по физлицам, несколько организаций, различные модели разграничения доступа. И повесить на расчетчика задачу вручную делить все это на части – это слишком жестоко. Мы на это идти не готовы.
Поэтому стало понятно, что нужна промежуточная прослойка. Так появилась идея автоматизированного рабочего места.
В нем мы делим данные по тем правилам и ограничениям, которые уже есть в системе. Если включена RLS по физлицам – делим по RLS. Есть отбор по подразделениям – значит, делим по подразделениям.
Таким образом мы запускаем параллельный расчет, минимизируем количество блокировок и получаем тот результат, на который рассчитывали.
Организационные изменения и логика работы АРМ
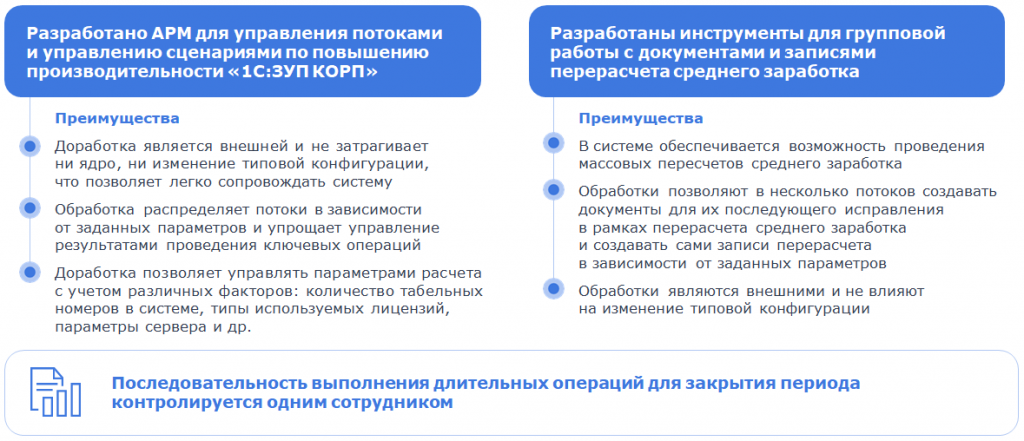
Что здесь важно? Важно понимать: если вы переходите на управление операциями расчета зарплаты с помощью АРМ, вы фактически организационно меняете процесс у заказчика.
Теперь пользователь заходит, задает сценарий, нажимает кнопку – и все. И это уже не просто технологическое изменение, а, скорее, организационное. Заказчик должен принять, что в одном месте он запускает процесс, а в другом – получает результат. То есть запуск отчетов и открытие документов – это уже не одно и то же.
Самое главное – на выходе он получает управляемую последовательность длительных операций, которую может задать исходя из текущей ситуации. И фактически один сотрудник контролирует закрытие периода.
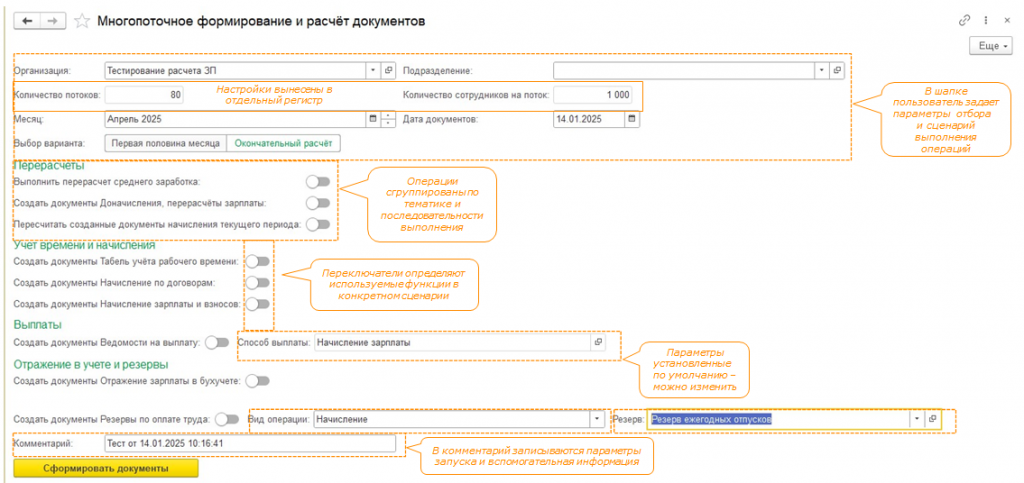
Вот так выглядит стандартный вариант поставки. Почему «стандартный»? Потому что у каждого заказчика обязательно появятся свои пожелания: дополнительные расчеты, запуск интеграций – что угодно. Здесь показан максимально лаконичный вариант.
Наверху – отбор. Здесь же пользователь получает информацию о том, какие настройки используются. Почему именно информационно? Потому что этим пользуется расчетчик, и объяснять ему, как настраивать количество потоков, не требуется. Настройки вынесены в отдельный регистр: администратор может задать их один раз или менять при необходимости. В итоге расчетчик просто контролирует результат.
Переключатель «первая половина» / «окончательный расчет» меняет набор функций. Сами функции расположены сверху вниз – в той логике, в которой пользователь выполняет действия. Мы же не будем сначала получать отражение в учете, а потом делать начисление зарплаты.
Задача пользователя – пройтись по переключателям и задать нужный сценарий. Например, можно запустить только перерасчет среднего – поставить один переключатель, нажать «сформировать» и на этом остановиться. А можно запустить все сразу. Это уже зависит от задачи пользователя.
В тех документах, где требуется выбор функции, мы оставили значения по умолчанию. Если в организации используется, например, отдельный расчет для ГПХ и для сотрудников по трудовым договорам – можно выбрать вручную или задать свое значение по умолчанию.
То же самое с резервами: если нужно сформировать резерв на премию – просто выбираем соответствующую опцию.
В комментариях к документам мы указываем, что именно было сформировано – в первую очередь для того, чтобы было понятно, что это программный документ, созданный через АРМ.
Теперь о том, что мы сознательно не стали делать. Частый запрос от расчетчиков: «Давайте добавим сюда отчеты». Мы это рассматривали несколько раз и каждый раз приходили к одному выводу.
У вас уже есть набор отчетов – типовых или нетиповых – которые формируются средствами платформы. Максимум, что можно сделать, – либо дублировать их внутри АРМ, что не нужно, либо просто вызывать их оттуда. Выигрыш – несколько секунд, а сложность настройки и поддержки возрастает. Поэтому мы решили, что это избыточно. Возможно, когда-нибудь пересмотрим это решение, но пока оставили так.
Что осталось? Остался лог. Мы берем данные из журнала регистрации: какие документы созданы, сколько времени это заняло, какие были ошибки.
После нажатия кнопки «сформировать документы» пользователь получает полную картину того, что произошло в системе: что создалось, что не создалось и где возникли проблемы.
Результаты синтетического тестирования
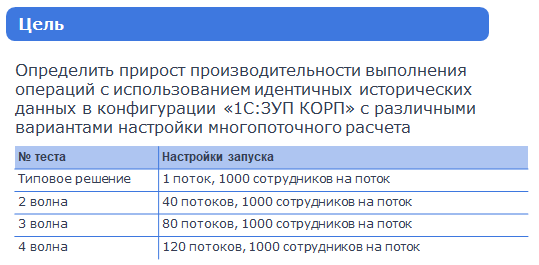
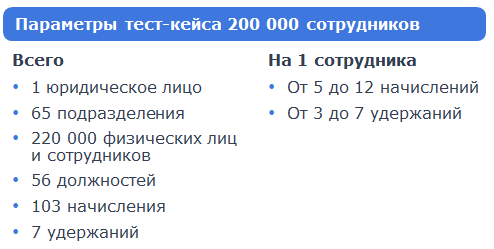
Это был наш первый большой подход – синтетический тест с достаточно однотипными сотрудниками. Главная задача была проверить, что схема в принципе работает.
Почему несколько вариантов запуска – 40, 80 и 120 потоков? Нам нужно было понять зависимость от использования процессорных мощностей: как влияет количество потоков, как это связано с количеством ядер и, самое главное, можно ли параллельно работать пользователям во время выполнения расчета.
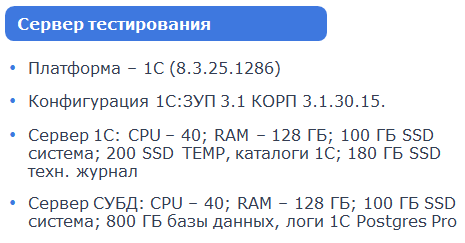
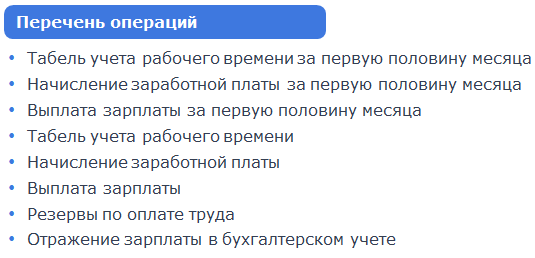
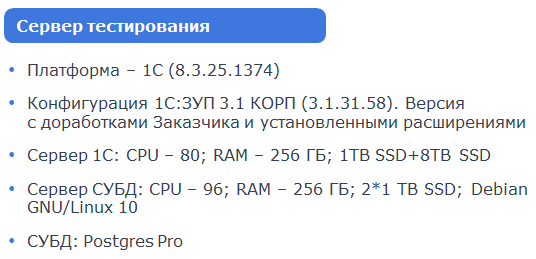
Кейс во всех случаях был одинаковый – одна и та же копия базы. Перечень операций стандартный, параметры сервера вы видите на изображении.
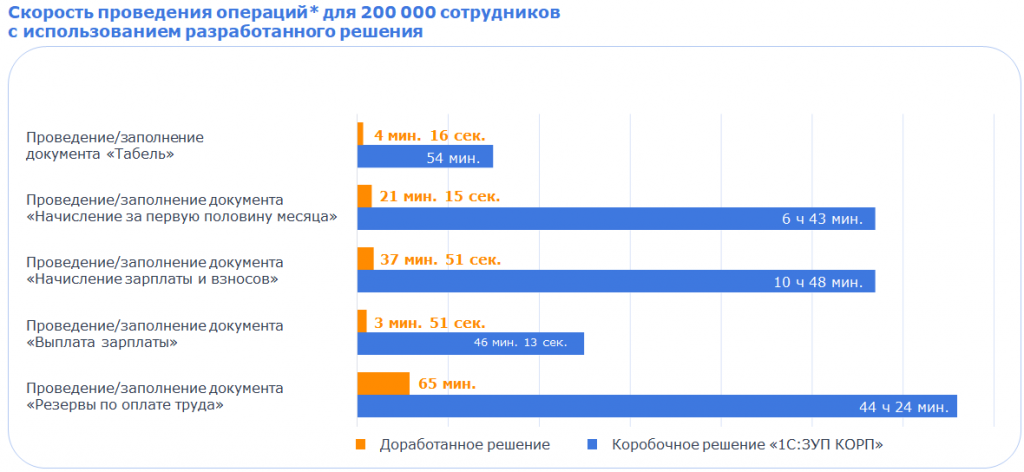
Что получили в итоге. Синяя линия – это один поток, классический расчет типовой конфигурации 1С, коробочное решение. Результат, который мы получили, честно говоря, мы не ожидали. Мы рассчитывали на прирост в два-три раза.
Самое сильное удивление вызвала последняя строка – резервы по оплате труда. 200 000 сотрудников, метод МСФО – в однопоточном режиме расчет занял 44 часа. Когда запустили в многопоточном режиме – 65 минут. Разница получилась примерно в 30 раз.
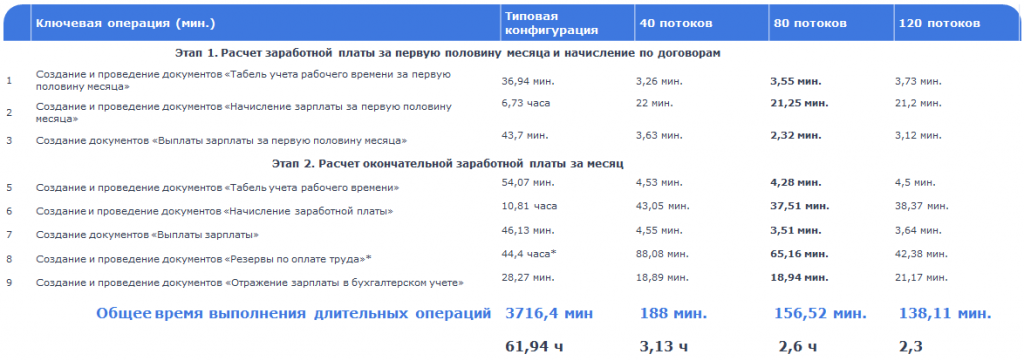
Вот сводная таблица по всем трем вариантам запуска. Здесь важно обратить внимание на следующее. Да, увеличение количества потоков снижает время выполнения операций. Но если внимательно посмотреть, разница, например, по начислению зарплаты за первую половину месяца между 40 и 120 потоками – это секунды. В одном случае экономия – полминуты, в другом – несколько секунд. Это уже погрешность.
При этом использование максимального количества потоков просто парализует работу пользователей. Поэтому важно найти баланс. Для нас золотой серединой оказалось двукратное превышение количества ядер. Хотя дальше покажу, что иногда мы используем и меньше.
Теперь по операциям. Как уже говорил, резервы – это колоссальная нагрузка: 44 часа против примерно 65 минут. Почему так? Потому что при расчете резервов методом МСФО для каждого сотрудника определяется остаток дней отпуска и рассчитывается средний заработок. Программа просто берет 200 000 человек и последовательно обрабатывает каждого. Аналогичная ситуация возникает, например, при перерасчете среднего после годовой премии. Это тяжелые, ресурсоемкие операции – и именно на них многопоточность дает максимальный эффект.
С начислением зарплаты за первую половину месяца и за весь месяц ситуация проще, но и там выигрыш значительный: 10 часов против 30 минут – это уже ощутимо.
А вот отражение зарплаты в бухгалтерском учете ускоряется не так сильно. Потому что документ ничего не рассчитывает – он просто заполняется и сохраняется. Да, ускорение есть, но оно минимальное.
По итогам синтетического теста мы сделали главный вывод: схема работает, и работает хорошо. Мы определили для себя оптимальное количество потоков – примерно в два раза больше числа ядер.
Внедрение на реальном проекте: кейс ритейлера
Дальше оставался следующий шаг – проверить все это на реальных данных.
Мы понимаем, что синтетические тесты – это однотипные данные: сотрудник №1, сотрудник №2, сотрудник №25. У них нет истории, нет «мусора», нет регистра перерасчетов. И всегда возникает вопрос: а вдруг нам просто повезло? Может быть, мы так построили тест, чтобы получить красивые цифры?
Ответ на этот вопрос может дать только реальный коммерческий проект. Название заказчика по его просьбе мы не раскрываем – поэтому просто «ритейл».
Это реальный проект, который завершился примерно месяц назад. Мы работали совместно с другими командами, а наша задача была провести нагрузочное тестирование, доработать АРМ под требования заказчика и показать результат.
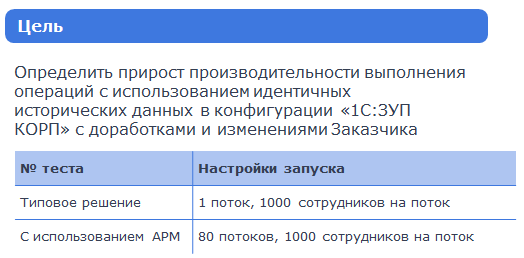
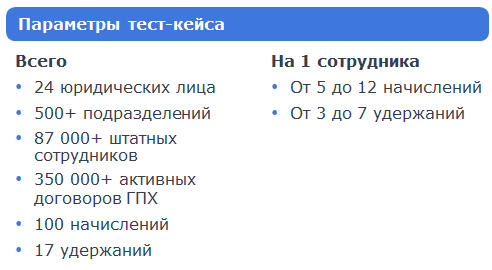
Что было на входе. Я, честно говоря, сначала не очень поверил: спрашиваю, сколько сотрудников – говорят, около 80 000. Думаю, нормально. И тут добавляют: еще 350 000 договорников.
Понятно, что с договорниками работать проще, но их 350 000 – и это не просто записи в справочнике, это 350 000 действующих начислений каждый месяц. Плюс были проблемы с интеграцией, получением данных из внешних систем, но это уже за рамками текущего рассказа.
По аппаратной части мы дали рекомендации, заказчик сказал: «Хорошо, возьмем в два раза больше». Взяли.
При тестировании заказчик отдельно попросил сохранить возможность нормальной параллельной работы пользователей. Поэтому количество потоков мы ограничили – не более двукратного превышения числа ядер. В итоге оставили 80 потоков, несмотря на рост ресурсов.
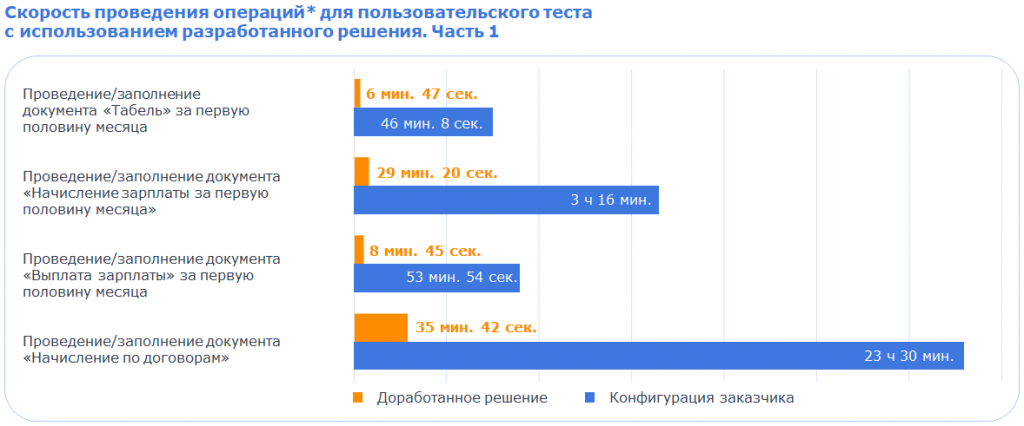
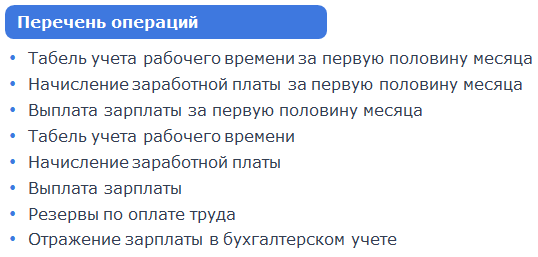
Теперь по операциям. Появилась новая – начисление по договорам. По просьбе заказчика мы разделили штатных сотрудников и договорников.
И здесь интересный момент: начисление по договорам в исходном варианте считалось почти сутки – 23,5 часа. Честно скажу, до конца не понимаю, почему так долго. Но факт остается: после оптимизации – 35 минут.
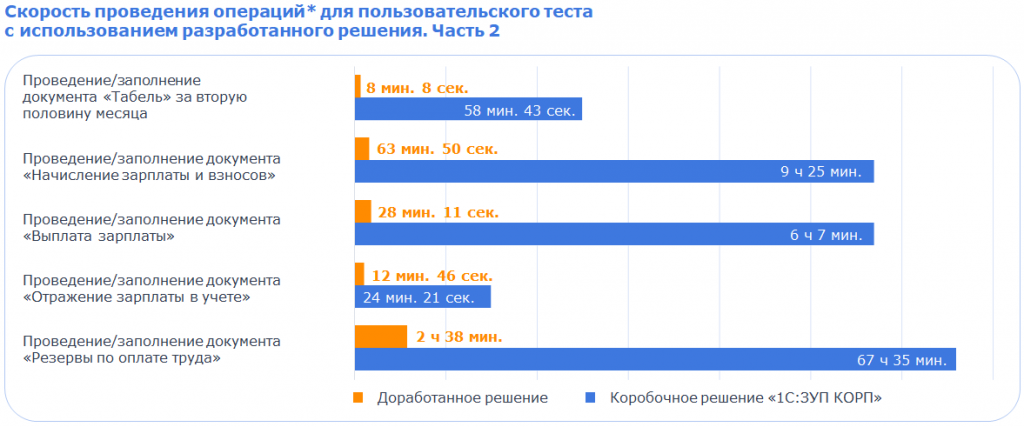
Резервы – это вообще отдельная история. В исходном варианте мы даже не смогли их посчитать полностью. Те самые 67 часов – это оценка: мы посчитали один участок, одно подразделение и экстраполировали результат. Сервер просто не выдерживал полной нагрузки. После оптимизации получили чуть больше двух часов.
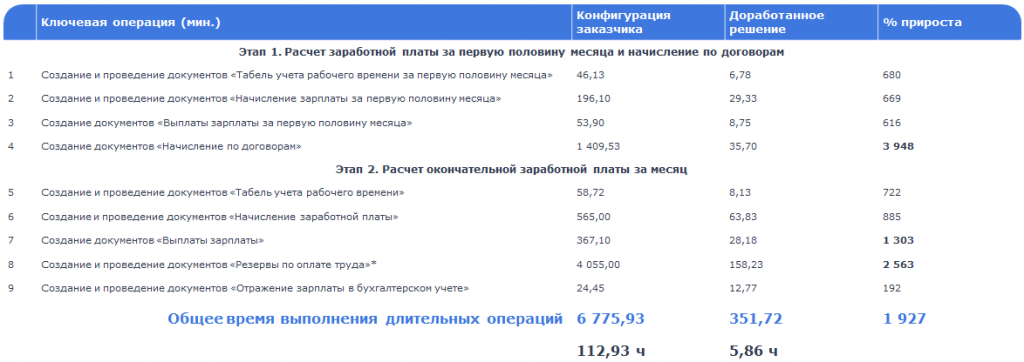
Если посмотреть сводную таблицу, последняя колонка – это процент прироста. Начисление по договорам ускорилось почти в 40 раз. Резервы – в 25 раз. Выплаты – примерно в 13 раз. Остальные операции – от 6 до 8 раз. Отражение зарплаты в бухгалтерском учете – чуть меньше, чем в 2 раза.
В итоге: было почти 13 часов расчета в обычном режиме – стало меньше 6 часов. И это уже можно запускать как регламентное задание в рамках решения.
Появился и дополнительный эффект, на который мы изначально не рассчитывали. 350 000 договорников и 87 000 штатных сотрудников оказались распределены по разным документам. Вы знаете, что если нужно изменить начисление у одного сотрудника и нажать «Провести», перепроводится весь документ. И перепровести документ на 1 000 человек и на 80 000 – это большая разница.
За счет дробления документов постобработка стала заметно удобнее и быстрее. Хотя, конечно, расчетчики поначалу смотрели на все это с осторожностью.
Итоги
Хочу зафиксировать несколько тезисов. Главный вопрос: можем ли мы это делать? Можем.
Самый крупный кейс, о котором я слышал, – это около полумиллиона сотрудников СБЕР. Наши тесты показывают, что такие объемы можно считать за адекватное время без разделения на отдельные базы.
При этом важно понимать: без доработок не обойтись. Придется дорабатывать и АРМ, и сами процессы расчета. Но, если есть возможность, старайтесь не лезть в менеджер расчета. Мы все знаем, как глубоко туда можно уйти – и не факт, что получится вернуться.
Отдельный момент – лицензии. Проф-лицензии в 1С ограничены по количеству ядер, если не ошибаюсь – до 12. Соответственно, по потокам вы упираетесь в 36 потоков - максимум, а для нормальной работы – скорее в 24. Поэтому на больших объемах вы неизбежно приходите к корпоративным лицензиям. Впрочем, в крупных организациях это и так стандартная практика.
Еще один важный момент – организационные изменения. Люди начинают работать по-другому. Это неизбежно, к этому нужно быть готовыми.
И последний тезис, самый важный. Да, зарплату нужно считать быстро – но это вторично. В первую очередь ее нужно считать правильно. Поэтому, когда вы ускоряете расчет, обязательно следите за тем, чтобы результат совпадал с ручным расчетом и оставался корректным.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции Анализ & Управление в ИТ-проектах.
Вступайте в нашу телеграмм-группу Инфостарт