Распознавание текста с использованием OCR Tesseract

16.09.24

Интеграция - Распознавание документов и образов

В 1С:Документооборот полнотекстовый поиск по содержимому отсканированных документов возможен, но не так хорош, как бы хотелось. Всё дело в качестве распознавания сканов. Поднимаем процесс распознавания на новую высоту с использованием Xpdf и OCR Tesseract.

Файлы

ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.

Наименование Скачано Купить файл
Распознавание текста с использованием OCR Tesseract (linux):
.cfe 40,77Kb ver:1.L.2.49
3 4 200 руб. Купить
Распознавание текста с использованием OCR Tesseract (windows):
.cfe 38,67Kb
45 4 200 руб. Купить

Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний

Оформите подписку на компанию для решения рабочих задач

Оформить подписку и скачать решение со скидкой

Вы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».

  • 0% комиссии — оплата напрямую исполнителю;
  • Исполнители любого масштаба — от отдельных специалистов до команд под проект;
  • Прямой обмен контактами между заказчиком и исполнителем;
  • Безопасная сделка — при необходимости;
  • Рейтинги, кейсы и прозрачная система откликов.

Полнотекстовый поиск по содержимому всех документов - отличная функция 1С:Документооборот, однако много документов хранится в сканах и их надо как-то распознать. Встроенный механизм базируется на откровенно устаревшей технологии (у CuneiForm последняя версия от 19.04.2011) и имеет очень низкое качество. Частично спасает ситуацию возможность удалённого распознавания на мощностях 1С, но далеко не все готовы отсылать свою переписку куда-то за пределы организации, да и не бесплатная это функция.

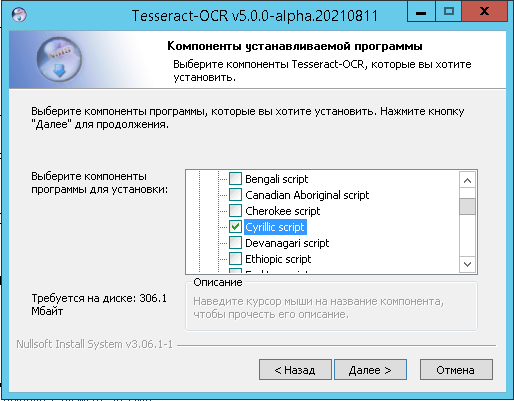
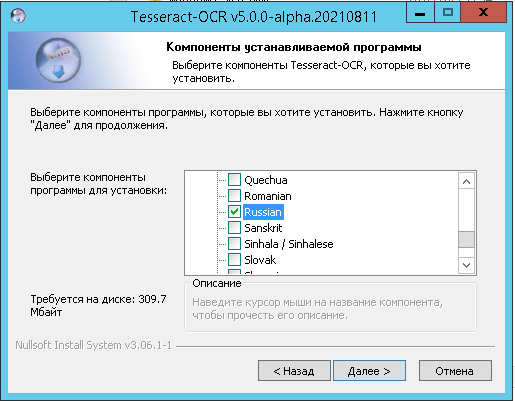
Однако есть выход, причем проект открытый и развивающийся, а потому можно надеяться, что качество распознавания будет расти. Я имею ввиду проект Tesseract OCR. На официальном сайте проекта есть сборка под все ОС, под Windows только alfa-версия, но работает она хорошо. Особенности установки с поддержкой кириллицы и русского языка я показал на скринах.

Неожиданно плохие результаты показало распознавание изображений, полученных из Adobe PDF с помощью утилиты Imagemagick. Часть изображений получается серые, я об этом эффекте уже писал. Нормально работает на изображениях, полученных с помощью утилиты pdftopng от производителя XpdfReader. 

Предлагаемое расширение подменяет функцию РаспознатьСПомощьюCuneiForm() общего модуля Распознавание, и корректно работает во всех сценариях, как в ручном, так и в автоматическом.

Программа первым делом производит поиск текстового слоя в файле pdf, для этого используем утилиту pdftotext из Xpdf command line tools. Тут есть один нюанс, в качестве параметра передаётся кодировка текста, который должен быть извлечён из файла, а она изначально неизвестна. Предположительно, чаще всего должна использоваться кодировка UTF-8, но как показывают тесты это не так и вообще часть текста может быть в одной кодировке, а часть в другой. А ещё лист документа может быть перевёрнут, причём в любую сторону. Тесты OCR Tesseract показали, что программа сама пытается выровнять текст. Если подать на вход изображение с текстом и это-же изображение, повёрнутое на 90 градусов, то качество распознавания не изменится. Но вот поворот на 180 и 270 градусов делает распознавание невозможным.

Что делать? Надо как-то понять, что распознанный текст содержит нормальный текст, а не мусор. Я решил, что можно считать долю кириллических символов в тексте, мы же распознаём русскоязычные документы, значит их там должно быть больше половины.

Получился следующий алгоритм:

  • пытаемся из файла Adobe PDF получить текст, если получается, то считаем долю кириллических символов, и если их больше 65% возвращаем текст;
  • разбиваем файл на изображения и начинаем каждое распознавать, после распознавания снова считаем долю символов, если меньше 65%, то переворачиваем на 180 градусов и пробуем снова.

Все "мысли" программы по поводу получения изображений и извлечения текста пишутся в журнал регистрации, там можно понять почему была выбрана определённая стратегия распознавания.

Настройки программ находятся в начале функции модуля РОТР_РаспознатьСПомощьюCuneiForm() общего модуля Распознавание из расширения, там указываются все пути к программам и разрешение изображений, настройки снабжены комментариями. Есть ограничения на минимальный и максимальный объём изображений, понятно, что они ничем особо не обоснованы, только наблюдения и тесты. Всё ради увеличения быстродействия, т.к. процесс распознавания получается мягко сказать "неторопливым".

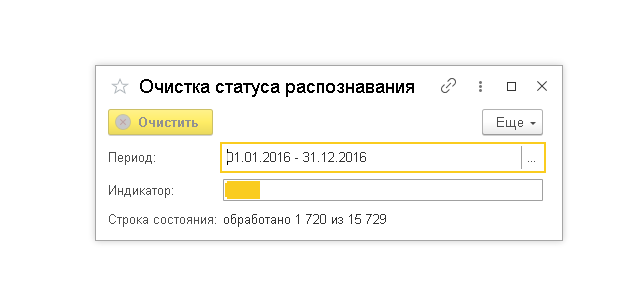
В общем модуле РОТР_ОбщегоНазначенияСервер собраны функции для работы в изображениями и распознавания текста, их можно использовать в собственных проектах, они также снабжены описанием параметров. Также хочется отметить, что процесс tesseract.exe может потреблять очень много оперативной памяти, у меня бывало доходило почти до 1 Гб (один раз), это надо иметь ввиду при внедрении данного механизма. Если раньше файлы распознавались с использованием старого алгоритма, то надо сбросить статус, для чего в расширении есть соответствующая обработка.

Расширение проверено на конфигурации 1С:ДГУ 2.1.29.16 и технологической платформе  8.3.17.1851.

Upd. 16.09.2024. Добавил адаптацию расширения под Linux, тестировал на 1С:ДГУ 2.1.34.1

Распознавание и загрузка сканов в 1С

Решение «Распознавание и загрузка сканов в 1С» — интеллектуальный инструмент, превращающий сканы накладных, счетов, УПД или Excel-файлов в готовые документы 1С. Без ручного ввода и ошибок — с распознаванием даже нечетких фото. Оптимизируйте документооборот и автоматизируйте рутину с помощью ИИ-распознавания.

Проверено на следующих конфигурациях и релизах:

  • Документооборот КОРП, релизы 2.1.34.1, 2.1.29.16

Вступайте в нашу телеграмм-группу Инфостарт

распознавание OCR Tesseract Xpdf

См. также

Учет документов Распознавание документов и образов Бухгалтер Пользователь 1С:Предприятие 8 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Россия Платные (руб)

Одна из наиболее удобных обработок автоматического прикрепления большого количества документов-оригиналов к документам 1С. Для файлов поточного сканирования автоматически определяются начало и конец каждого документа. Поддерживаются штрихкоды, QR-коды, отсканированные PDF документы без штрихкодов, сформированные в ЭДО текстовые PDF документы. Поддерживаются входящие и исходящие документы-оригиналы.

87108 руб.

23.12.2021    17394    35    25    

15

SALE! 35%

Распознавание документов и образов Периферийные устройства Программист Автомобили, автосервисы Россия Платные (руб)

Программа считывает кадры с ip-камер (http - запрос к камере), видео, фото (источники кадров (нет ограничения на их количество) настраивается в конфигурационном файле), находит и распознает номера автомашин и сохраняет в базу db, с сохранением фото номера и автомашины, а также времени детекции.

20740 руб.

31.05.2023    7626    5    5    

10

Учет документов Распознавание документов и образов Системный администратор Программист Руководитель проекта 1С:Документооборот Платные (руб)

Обработка многостраничных файлов PDF с разбиением на отдельные документы по штрих-коду и сохранение документов в отдельные файлы для. Не требуется интернет, внешние утилиты командной строки и т.д. Плюсы: скорость работы, независимость от внешних библиотек или утилит, достаточно большой перечень поддерживаемых типов ШК, возможность фильтрации по формату и данным ШК. Не требует установки (portable), может работать несколько экземпляров ПО на одном хосте с разными настройками.

12200 руб.

07.07.2026    611    2    0    

1

Печатные формы Инструментарий разработчика Распознавание документов и образов 1С 8.3 1C:Бухгалтерия 1C:ERP 1С:ЗУП 1С:КА 1С:УНФ 1С:УТ 1С:Розница 1С:Управление торговлей 11 Абонемент ($m)

Обработка для поиска иконок по фрагменту экрана. Ищет похожие изображения в каталоге файлов, общих картинках конфигурации и стандартной библиотеке платформы. Позволяет самостоятельно извлечь картинки из ресурсов установленной 1С.

1 стартмани

17.09.2026    150    0    SergMuravev    0    

4

Распознавание документов и образов Бухгалтер Пользователь Стажер 1С 8.5 1С:Бухгалтерия 3.0 Абонемент ($m)

Эта статья — подробный разбор обработки, которая автоматизирует создание платёжных поручений из счетов контрагентов.

1 стартмани

16.09.2026    322    2    user718500    0    

0

Распознавание документов и образов 1С 8.5 1С:Бухгалтерия 3.0 Абонемент ($m)

В современных условиях бухгалтеры и операторы регулярно сталкиваются с задачей ввода реквизитов новых контрагентов в информационную базу. Эта операция, на первый взгляд простая, на практике отнимает значительное время — необходимо вручную переносить данные из карточки организации, скана учредительного документа, счета-фактуры или договора. При этом ошибки при ручном вводе — явление распространенное, а каждая ошибка в ИНН, КПП или банковских реквизитах может привести к серьезным последствиям: от отказа в приеме платежа до проблем с налоговой отчетностью.

1 стартмани

11.09.2026    760    3    user718500    0    

1

Распознавание документов и образов 1С:Предприятие 8 Россия Бесплатно (free)

В типовых бизнес-процессах организаций значительная доля трудозатрат приходится на ручной ввод данных из входящих документов. Счета на оплату, паспорта, анкеты, трудовые книжки, дипломы и другие документы поступают в различных форматах (PDF, изображения, DOCX, RTF, HTML) и требуют переноса реквизитов в учетные системы.

26.08.2026    1020    user718500    0    

0
Комментарии
Подписаться на ответы Инфостарт бот Сортировка: Древо развёрнутое
Свернуть все
1. Semechka 22.10.21 13:46 Сейчас в теме
Добрый день, Сергей) Интересует следующее: в каком виде предоставляется результат обработки и входят ли компоненты в предоставляемое решение?
2. soulner 523 22.10.21 14:35 Сейчас в теме
(1) Добрый день. Там всё довольно хитро из-за необходимости интеграции со штатной функцией.
В штатную функцию передаются параметры РаспознанныйТекст, ПутьКФайлу, соответственно эти параметры и заполняются распознанным текстом и путём к файлу, содержащем текст.
А компоненты в решение не входят и должны быть скачены с сайта производителя самостоятельно.
Сайт XPDF Tools легко найти поиском (только там ищем именно command line tool), а с OCR Tesseract сложнее, я сборку нашёт тут https://github.com/UB-Mannheim/tesseract/wiki
denundersky; +1 Ответить
Для отправки сообщения требуется регистрация/авторизация