Использование языковой модели GPT3 для создания интерфейса 1С на естественном языке
Разработка - Работа с интерфейсом


Думаю, что уже почти все в курсе насчет GPT, но все же начну с небольшой справки.
GPT расшифровывается как Generative pretrained transformers. Это языковая нейросеть, обученная по технологии transformer. Описание технологии появилось в общем доступе в 2020 году. Кому интересно, ссылка здесь https://arxiv.org/abs/2005.14165. История развивалась более или менее обычными темпами для ИТ, но в конце прошлого года произошло нечто, выходящее за привычные рамки. Компания OpenAI выложила в общий доступ версию языковой модели, взаимодействие с которой организовано в виде чата. Всего лишь за одну неделю этот чат преодолел отметку в миллион пользователей. Такого раньше не было. О chatGPT стали очень много говорить и писать. В том числе, совершенно фантастические вещи. Наиболее впечатлительные начали говорить, что скоро нам всем конец, потому что искусственный интеллект вот-вот захватит мир.
Если не терять голову и смотреть на вещи трезво, то надо понимать, что языковая модель, это достаточно простая, почти механическая, штука. Вся магия в объемах данных, использованных для обучения. Ответ на ваш вопрос формируется как результат компиляции из того, что было ранее сказано в интернете. Языковая модель не обладает сознанием, она не в состоянии делать элементарные логические выводы. Общаясь с ней не стоит забывать, что вы общаетесь не с каким-то неведомым существом, а с людьми, которые когда-то обсуждали ваш вопрос в интернете.
При всем при этом, языковая модель обладает одним чудесным качеством, которое, я уверен, произведет самую настоящую революцию в области взаимодействия людей с компьютерами вообще и с базами данных и учетными системами в частности.
Она вас понимает.
Что это означает, я вам сейчас продемонстрирую на примере работы с типовой конфигурацией УТ редакции 11.5.
Я написал небольшое дополнение, которое необходимо добавлять к каждому вопросу пользователя. В этом дополнении дается описание таблиц базы УТ. В силу ограничений, установленных OpenAI для работы в режиме бесплатного тестирования, я включил в это описание не всю конфигурацию, как есть, а ограничился некоторым более или менее содержательным подмножеством таблиц. В него вошли остатки на складе, продажи и взаиморасчеты. Кроме того, так как большинство 1с-ников привыкли читать запросы на русском языке, я сделал перевод выдаваемого языковой моделью текста запроса.
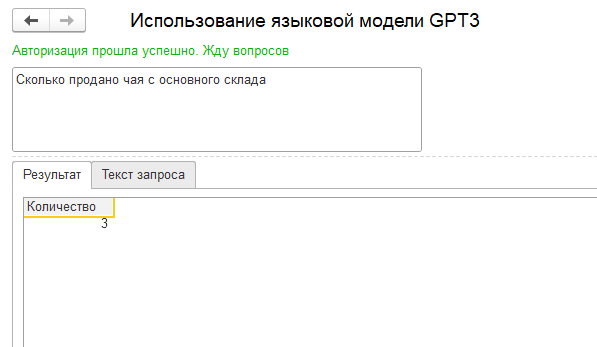
Также я написал простенькую обработку. Пользователь вводит свой вопрос на русском языке и получает ответ. При желании можно заглянуть в текст запроса.

Можно сказать, что мой первый вопрос составлен не совсем на русском языке. Скорее на русско-программистском. Но я хотел для начала дать языковой модели наиболее легкое задание. В этом тексте вопроса уже содержатся готовые инструкции: какие таблицы с какими следует соединять и по каким условиям.
Зададим более непринужденный вопрос.
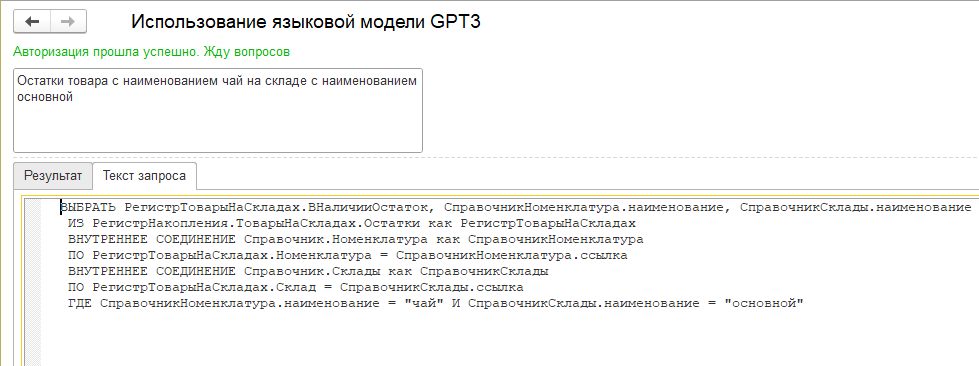
Текст запроса для этого вопроса почти такой же
ВЫБРАТЬ РегистрТоварыНаСкладах.ВНаличииОстаток
 ИЗ РегистрНакопления.ТоварыНаСкладах.Остатки как РегистрТоварыНаСкладах
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрТоварыНаСкладах.Номенклатура = СправочникНоменклатура.ссылка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Склады как СправочникСклады
 ПО РегистрТоварыНаСкладах.Склад = СправочникСклады.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай" И СправочникСклады.наименование = "основной"
Я зря старался в первом вопросе. Языковая модель и так понимает, что, с чем и как следует соединять.
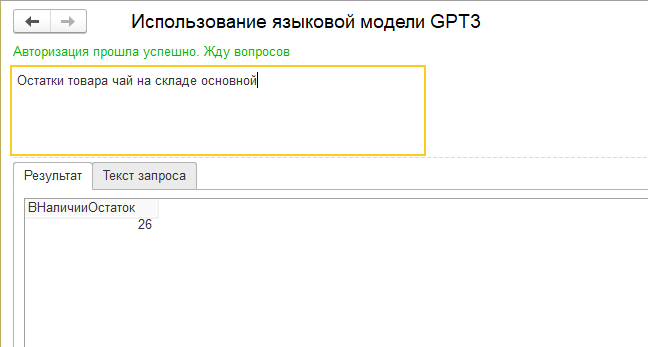
Раз так, зададим вопрос совсем по-человечески

Ответ такой же. Текст запроса не имеет смысла приводить, потому что он полностью совпадает с предыдущим. И это прекрасный результат. Особенно с учетом того, что у нас есть не только регистр остатков но и регистр продаж. А там тоже есть товар и склад. Но языковая модель совершенно правильно понимает, что нам нужны остатки.
Попросим теперь показать продажи.
Текст запроса здесь такой:
ВЫБРАТЬ СУММА(РегистрВыручка.Количество)
 ИЗ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура = СправочникНоменклатура.ссылка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Склады как СправочникСклады
 ПО РегистрВыручка.Склад = СправочникСклады.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай" И СправочникСклады.наименование = "основной"
Можно еще и так
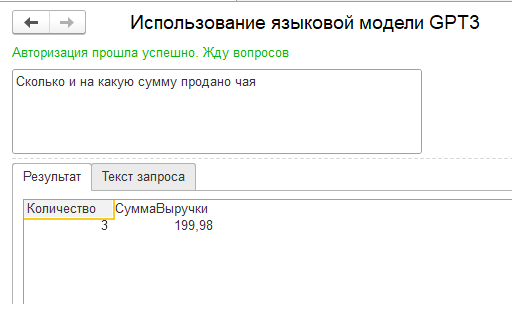
ВЫБРАТЬ СУММА(РегистрВыручка.Количество), СУММА(РегистрВыручка.СуммаВыручки)
 ИЗ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура = СправочникНоменклатура.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай"
Или так

ВЫБРАТЬ СправочникНоменклатура.наименование, СУММА(РегистрВыручка.Количество)
 ИЗ Справочник.Номенклатура как СправочникНоменклатура
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ПО СправочникНоменклатура.ссылка = РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура
 ГДЕ СправочникНоменклатура.наименование = "Чай" ИЛИ СправочникНоменклатура.наименование = "Сахар"
 СГРУППИРОВАТЬ ПО СправочникНоменклатура.наименование
Попробуем поставить языковую модель в тупик. Зададим неоднозначный, расплывчатый вопрос: "Сколько чая?" Из самого вопроса сложно понять, что хочет узнать вопрошающий. Остатки на складе или объем продаж?
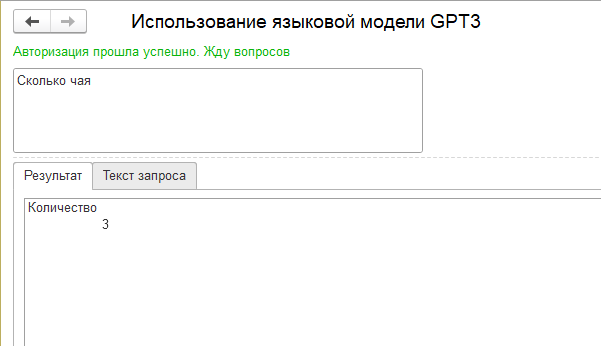
ВЫБРАТЬ СУММА(РегистрВыручка.Количество)
 ИЗ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура = СправочникНоменклатура.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай"
Языковая модель не зависает и не ломается. Она просто решает, что в данном случае будет уместным выдать информацию о продажах.
Если пользователь все-таки хотел получить информацию об остатках, он может задать вопрос чуть иначе. Например, вот так.
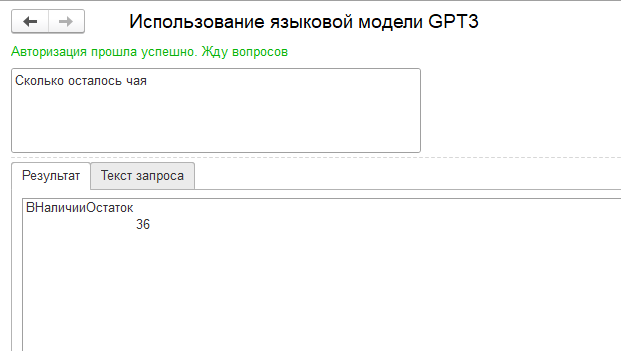
ВЫБРАТЬ РегистрТоварыНаСкладах.ВНаличииОстаток
 ИЗ РегистрНакопления.ТоварыНаСкладах.Остатки как РегистрТоварыНаСкладах
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрТоварыНаСкладах.Номенклатура = СправочникНоменклатура.ссылка ГДЕ СправочникНоменклатура.наименование = "чай"
Или так.
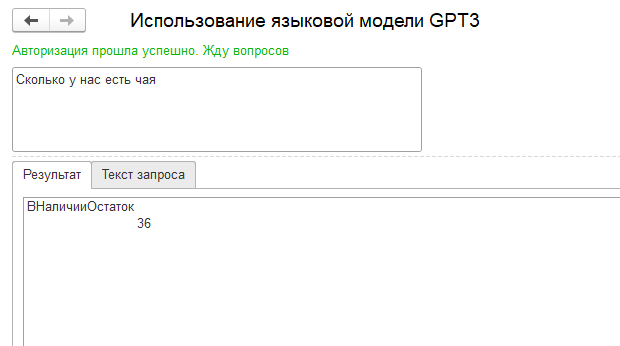
Текст запроса совпадает с предыдущим. Здесь важно то, что возникшее затруднение пользователь может решить так же, как он это привык делать при обычном общении.
Приведу еще несколько примеров.

ВЫБРАТЬ СУММА(РегистрВыручка.Количество)
 ИЗ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура = СправочникНоменклатура.ссылка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Контрагенты как СправочникКонтрагенты
 ПО РегистрВыручка.АналитикаУчетаПоПартнерам.Контрагент = СправочникКонтрагенты.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай" И СправочникКонтрагенты.наименование = "Иванов"

ВЫБРАТЬ СУММА(РегистрВыручка.Количество)
 ИЗ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура = СправочникНоменклатура.ссылка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Пользователи как СправочникПользователи
 ПО РегистрВыручка.Менеджер = СправочникПользователи.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай" И СправочникПользователи.наименование = "Иванов"
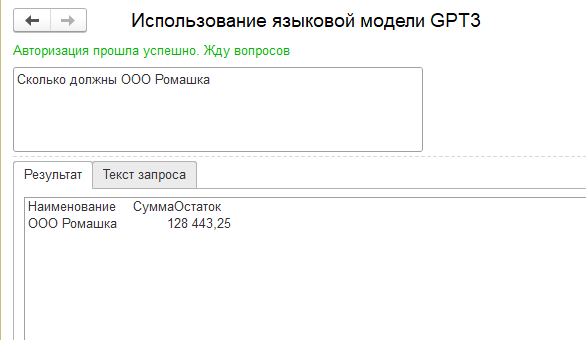
ВЫБРАТЬ СправочникКонтрагенты.наименование, РегистрВзаиморасчетов.СуммаОстаток
 ИЗ РегистрНакопления.РасчетыСКлиентами.Остатки как РегистрВзаиморасчетов
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Контрагенты как СправочникКонтрагенты
 ПО РегистрВзаиморасчетов.АналитикаУчетаПоПартнерам.Контрагент = СправочникКонтрагенты.ссылка
 ГДЕ СправочникКонтрагенты.наименование = "ООО Ромашка"
Как видите, языковая модель прекрасно справляется с вопросами на естественном языке. Во всем этом есть только один досадный момент. На вопрос "Сколько продано чая Иванову в январе" будет получен вот такой текст запроса
ВЫБРАТЬ СУММА(РегистрВыручка.Количество) ИЗ РегистрНакопления.ВыручкаИСебестоимостьПродаж как РегистрВыручка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
 ПО РегистрВыручка.АналитикаУчетаНоменклатуры.Номенклатура = СправочникНоменклатура.ссылка
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Контрагенты как СправочникКонтрагенты
 ПО РегистрВыручка.АналитикаУчетаПоПартнерам.Контрагент = СправочникКонтрагенты.ссылка
 ГДЕ СправочникНоменклатура.наименование = "чай"
 И СправочникКонтрагенты.наименование = "Иванов"
 И РегистрВыручка.период МЕЖДУ датавремя(2020,01,01) И датавремя(2020,01,31)
Когда мы говорим "в январе", мы имеем ввиду январь текущего года. Но в данном случае языковая модель нас не понимает. Более того, бесполезно пытаться уточнять "в январе 2023 года". Результат будет тот же. Здесь самое время вспомнить, что мы получаем ответы от людей, которые когда-то что-то писали в интернете. Обучение языковой модели происходило в 2021 году. И на тот момент в интернете не было (или почти не было, что одно и то же) текстов запросов, в которых упоминался бы 23 год. Время - это самое слабое место языковых моделей. Разработчик, OpenAI честно предупреждает об этом. Для учетных систем это реальная проблема. Но, к счастью, она решается путем относительно несложной доработки.
Подведем итоги. Использование языковой модели дает нам реальную возможность построения интерфейсов на естественном языке. Эффект усиливается еще и тем, что в недавно представленной платформе 8.3.23 уже присутствует сервис распознавания речи. Языковые модели и сервис распознавания речи приведут к революционным изменениям в способах взаимодействия пользователей с учетными системами и базами данных. Думаю, что каждому специалисту будет полезно узнать об этом и, по возможности, погрузиться в тему поглубже.
Если вас заинтересовал материал данной статьи и вы хотели бы поэкспериментировать с языковой моделью самостоятельно, тогда оставляйте заявку в произвольной форме на https://brainguard.ru
Если заявок наберется достаточное количество, я решу вопрос с корректной обработкой времени и открою доступ к тестовой площадке для зарегистрировавшихся.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Нейросети Системный администратор Разработчик Аналитик Бухгалтер Пользователь Руководитель проекта 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Зарплата и Управление Персоналом 3.x Россия Платные (руб)
Подключите ИИ к 1С и решайте рабочие задачи обычными словами. От работы с данными до доработки конфигурации через расширения, всё в привычном чате с ИИ-помощником. Теперь с поддержкой DeepSeek Harness, Kimi Code и Kimi Work, доступных в России без VPN.
15990 руб.
30.07.2026 21509 45 4
SALE! %
Банковские операции Обмен с интернет-банком Мастера заполнения Нейросети Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1C:ERP 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:ERP. Управление холдингом 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 1С:Розница 3.0 Платные (руб)
Корректируйте банковские документы быстро и легко! Создайте правило обработки — и оно автоматически применится при загрузке выписки (отбор по любому реквизиту или регулярному выражению). Решение заполняет расшифровку платежа, комиссию эквайринга, подбирает ведомости на выплату зарплаты, помечает дубли из банка на удаление и многое другое. Доплачивать за алгоритмы не нужно — они включены в решение. Обработка работает при загрузке из файлов клиент-банка и через DirectBank. Новое — искусственный интеллект: модель приводит нестандартные назначения платежа к виду, понятному алгоритмам, а ИИ-ассистент прямо в 1С консультирует по решению и разбирает код правил и алгоритмов. Поддерживаются локальные и облачные OpenAI-совместимые модели — данные могут не покидать ваш контур.
17500
14450 руб.
20.12.2024 22219 107 32
SALE! 30%
Нейросети 1С 8.3 1С:Бухгалтерия 2.0 1С:Бухгалтерия 1.6 1С:Бухгалтерия 3.0 1С:Управление холдингом 1С:Управление нашей фирмой 1.6 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 10 1С:Управление торговлей 11 1С:Документооборот Россия Платные (руб)
Расширение добавляет в 1С чат с ИИ-агентом. Пользователь спрашивает словами: «какие УПД не подписаны?», «какой НДС к уплате за квартал?», «что правили задним числом?», а агент сам строит запросы к базе с правами этого пользователя и отвечает цифрами, таблицей, диаграммой или файлом Excel. Нужный отчёт можно поставить на расписание: агент пришлёт его в Telegram или MAX каждое утро, по будням или раз в неделю. Плитки «Аналитик», «Бухгалтер» и «Руководитель» дают сводку по базе одной кнопкой. В расширении 67 готовых инструментов: ЭДО, маркировка, НДС и счета-фактуры, прогноз закупок, сверка прайса, Документооборот. Ключи API и VPN не нужны, модель уже в цене, персональные данные заменяются метками до отправки, в базу агент ничего не пишет. Работает в УТ 11, КА 2, ERP 2, БП 3.0, УНФ 3.0, Документооборот 3.0 и Альфа-Авто 6 при режиме совместимости от 8.3.9; для старых баз на обычных формах есть отдельный вариант.
18300 руб.
05.10.2026 5009 20 9
Инструментарий разработчика Нейросети Платные (руб)
Первые попытки разработки на 1С с использованием больших языковых моделей (LLM) могут разочаровать. LLMки сильно галлюцинируют, потому что не знают устройства конфигураций 1С, не знают нюансов синтаксиса. Но если дать им подсказки с помощью MCP, то результат получается кардинально лучше. Далее в публикации: MCP для поиска по метаданным 1С, справке синтакс-помощника и проверки синтаксиса.
15250 руб.
25.08.2025 79013 149 41
Работа с интерфейсом Анализ учета Мониторинг 1С:Предприятие 8 1С 8.3 1C:Бухгалтерия 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:Зарплата и Управление Персоналом 3.x 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 Платные (руб)
Создайте свой функциональный интерфейс в любой конфигурации 1С с помощью расширения Infostart Dashboard. Настраивайте панели виджетов с метриками, индикаторами и показателями на начальном экране. Узнайте возможность внедрения подсистемы у себя в конфигурации с помощью бесплатной обработки "Анализ внедрения подсистемы 1С Infostart Dashboard"!
31720 руб.
27.03.2025 92743 71 44
Распознавание документов и образов Нейросети 1С:Предприятие 8 1С 8.3 1С 8.5 1C:Бухгалтерия 1С:Зарплата и Управление Персоналом 3.x Беларусь Россия Казахстан Армения Платные (руб)
ИИ-сканер документов с REST API для интеграции с 1С и корпоративными системами. Извлекайте данные из счетов, паспортов, дипломов, патентов и трудовых книжек за секунды. Точность человека - скорость машины. Приложение поддерживает восемь типов документов, четырех провайдеров ИИ (имеется возможность использования локальных ИИ), локальный REST API и экспорт в JSON. Важно! модель должна поддерживать функцию Vision (распознавание файлов и картинок). Запускайте используя локальные ИИ, без подписок и ограничений
6100 руб.
24.08.2026 1720 3 0
Инструментарий разработчика Нейросети Системный администратор Разработчик Руководитель проекта 1С 8.3 Платные (руб)
Обработка заменяет ФИО, организации, ИНН, ИИН, БИН, ОГРН, КПП, БИК, счета и IBAN, паспорта, СНИЛС, адреса, телефоны, почту и суммы на правдоподобные выдуманные перед отправкой данных в ChatGPT, Claude или YandexGPT, а потом расшифровывает ответ модели обратно, подставляя настоящие имена и настоящие числа. Возвращаются и те итоги, которые модель посчитала сама: суммы масштабируются одним коэффициентом, поэтому пропорции и доли переживают обезличивание. Словарь замен хранится в самой базе и подхватывается автоматически, даже если обработку закрывали. Реквизиты России и Казахстана, любая конфигурация от 8.3.24, без единой зависимости.
14640 руб.
07.08.2026 2472 3 0
Нейросети 1С:Предприятие 8 1С:Управление торговлей 11 Платные (руб)
Устали вручную разбирать сотни писем в 1С? Доверьте рутину искусственному интеллекту! «По полочкам» — это готовое расширение для 1С, которое само читает входящие email, понимает их суть и мгновенно раскладывает по нужным категориям.
9028 руб.
15.10.2026 417 1 0
А еще больше на общение с джином:
- Я хочу попасть домой!
- Ну, давай руку - пойдем.
- Ты не понял, я хочу быстрей!
- Ну, тогда побежали!
"Сколько чая продал менеджер Иванов?"
Не, так не прокатит.
Даже не обращая внимания на "странный" поиск организации, номенклатуры и менеджера по наименованию.
В реальной жизни это звучит как-то так:
"Сколько продал менеджер Иванов (причем не тот, что Иванов кладовщик, а то Иванов, что менеджер по продажам в торговом зале) из подразделения "Владыкино" за период с 01.12.2021 по 20.11.2022 (на начало дня) с учетом возвратов по состоянию на текущую дату, но не учитывая возвраты по номенклатуре с типом "уценка".
Также нельзя учитывать продажи по заказу, сумма которого менее установленной в нормативах на дату продаж, или если количество звонков клиенту в периоде было менее норматива звонков, установленного в планах продаж.
Если номенклатура участвовала в акциях, то в сумму продаж включается не акционная цена, указанная в РТУ, а оптовая цена.
В сумму продаж должны включаться только полностью оплаченные реализации, или реализации по заказам с типом "без предварительной оплаты"."
И это очень скромный запрос.
Я даже не говорю о том, что GPT с этим не справится, но надо быть альтернативно мыслящим, чтобы считать такое общение удобным.
В результате все это попадет программисту, а ему намного проще и несоизмеримо надежней писать с учетом строгой логики языка программирования, и понимая, почему поиск по наименованию обычно плохая идея.
По-моему, GPT полезно только как поставщик шаблонов, например, "напиши мне на JScript
вызов метода ПослатьВсех, с частотой не менее 3 секунд, чтоб не забанили".
И тут уже GPT, в отличие от "обычного порошка, и промисы создаст, и всякие там then catch для них не забудет и код красиво отформатирует и даже учтет, что в самом браузере есть параметр, регулирующий как часто опрашивается очередь отложенных операций.
А если номенклатуры 100к+ и около сотни однотипной (отличаются только пара букв/цифр в названии) - наверное быстрее отчет.
Почему бы не пользоваться обычной консолью запроса? У нас бОльшая половина менеджеров предпочитают консоль.
"Сколько осталось артикула 123-А"
О chatGPT стали очень много говорить и писать. В том числе, совершенно фантастические вещи.
" это как технологии в матрице , технологии рассказа отдельно , и решения которые сделаны на не понятных технологиях, но все слито в одно как будто сделано на этой технологии?))) "
такие фантастические вещи вы имели ввиду?))))))))))
Я написал небольшое дополнение, которое необходимо добавлять к каждому вопросу пользователя. В этом дополнении дается описание таблиц базы УТ. В силу ограничений, установленных OpenAI для работы в режиме бесплатного тестирования, я включил в это описание не всю конфигурацию, как есть, а ограничился некоторым более или менее содержательным подмножеством таблиц. В него вошли остатки на складе, продажи и взаиморасчеты
Можно немного прояснить данный вопрос? а конкретно, что за "дополнение" а точнее как оно интегрируется в GPT ?
Хотелось бы понять как подключать свою языковую модель?
Я не могу понять данное предложение... Оно мягко говоря не закончено.
Следующее предложение
### Postgres SQL tables, with their properties:
#
# Employee(id, name, department_id)
# Department(id, name, address)
# Salary_Payments(id, employee_id, amount, date)
Первые две строки можно выкинуть
# Остатки(товар_id, склад_id, количество)
к примеру должен прилететь текст в GPT такого формата
сколько количество товаров на складе
в этом случае вам нужно понять как обработать сам запрос что бы он улетел в нужном вам формате ,
формат регулярки будет такой
[\W*(сколько)\W*|\W*(сколечко)\W*| сколько стоит
какоеколичество|
какмного|
докакихпор|
докоихпор|
какдолго|
какое количество|
|каквелико]
так то вопросы могут быть еще и с указанием )))
синтаксис может у каждого разный для регулярок, но в этом случае вы обрабатываете любые даже самые редкие слова вопросы как нужно
Вот прямо сейчас попробовал то, что вы предложили.
На вопрос: "сколько количество товаров чай на основном складе"
Я получаю текст запроса
ВЫБРАТЬ РегистрТоварыНаСкладах.ВНаличииОстаток
 ИЗ РегистрНакопления.ТоварыНаСкладах.Остатки как РегистрТоварыНаСкладах
 ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.Номенклатура как СправочникНоменклатура
ПО РегистрТоварыНаСкладах.Номенклатура = СправочникНоменклатура.ссылка ГДЕ СправочникНоменклатура.наименование = "чай"ЗЫ: для тех, кто не понял: если это вот все попробовать ввести с помощью системы распознавания голоса, то никаких "кой отаток" не будет, а будет "какой остаток". "Марковские процессы, панимаешь..." (с)
Ну и поиск номенклатуры по наименованию на равно, так это не работает )) Я еще понимаю на ПОДОБНО как реальная задача может существовать, а на равно пожалуй только по ссылке
1. "Регистр остатков может называться совсем не как в УТ..." Ужас! Что делать, никто не знает ))) Вам самому не смешно?
2. Положит или не положит сервер запрос без использования виртуальных таблиц, это надо конкретно смотреть. Серверы сейчас шустрые. Но здесь я с вами соглашусь. Эту проблему надо решить. Технически это не сложно. Просто переносим из ГДЕ в скобки.
3. Поиск на равно работает. Повторюсь, все запросы были реально проверены
А по поводу запросов, то не на столько тупая эта штука. Поумнее оптимизатора скульного будет точно.
Судя по статье, кожаные мешки пока умнее. Но им осталось недолго )))
В большинстве случаев программист изобретатель-исследователь, даже при наличии готового ТЗ
Подготовка запроса и постобработка ответа делаются на сервере и не на языке 1С.
Но это не мешает вам экспериментировать самостоятельно. Всю информацию я вам дал. Вам следует только понять, что с языковой моделью все не то чтобы просто, а прямо очень просто. Опишите ей таблицу остатков на русском языке как вам больше нравится и получайте тексты запросов в ответ на вопросы. Все
Подготовка запроса и постобработка ответа делаются на сервере и не на языке 1С
а можете вот эту часть раскрыть? она больше всего и интересна... а то что в ChatGPT можно запросы слать и получать осмысленные ответы (в данном случае запросы на языке 1с) ну это лично для меня не новость...
1. Отправил запрос языковой модели (структура данных + вопрос от пользователя как есть)
2. Получил в ответ текст запроса (чистый SQL)
3. Перевел текст запроса в 1С.
Все шаги очевидны, просто лежат на поверхности. Я не совсем понимаю, какие тут могут быть вопросы у специалиста?
Если вам до сих пор не понятно, как получается результат, тогда ждите доступ к тестовой площадке.
Единственный момент, о котором не говорится прямо в статье, но говорится здесь, в комментариях, это то, что обращаться лучше все-таки не к чату. У чата несколько другое предназначение
вот только это не понятно... как вы отправляете структуру данных (в каком формате)? как там указываются связи данных и тд..? Можете пример полного запроса что пуляете в ИИ для примера привести?.. вместо тысячи слов так сказать)
остальное все понятно..
### Postgres SQL tables, with their properties:
#
# Employee(id, name, department_id)
# Department(id, name, address)
# Salary_Payments(id, employee_id, amount, date)
#
### A query to list the names of the departments which employed more than 10 employees in the last 3 months
SELECT
Первые две строки можно не указывать. Результат от этого не изменится
Там же пример request
curl \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"model": "code-davinci-002",
"prompt": "### Postgres SQL tables, with their properties:\n#\n# Employee(id, name, department_id)\n# Department(id, name, address)\n# Salary_Payments(id, employee_id, amount, date)\n#\n### A query to list the names of the departments which employed more than 10 employees in the last 3 months\nSELECT",
"temperature": 0,
"max_tokens": 150,
"top_p": 1.0,
"frequency_penalty": 0.0,
"presence_penalty": 0.0,
"stop": ["#", ";"]
}'
Но эксперименты лучше проводить не через API, а на тестовой площадке на сайте
поэтому в 1с просто указание полей как в примере явно недостаточно, нужно еще предназначение как то передавать, тип данных. А еще есть фишка что у нас часть измерений в регистрах называются Договор, а где то Сделка... хотя они ссылаются на один и тот же справочник, просто в процессе развития конфы получилось вот так (уж не знаю почему, но переделать нереально). Как такие данные связать для ИИ...
ПС: как вызывать api это понятно ) я не про это спрашиваю... а именно про контекст 1с, не про справку или документацию, я ее умею читать ))
1. Да все понятно что делать, у вас там про контекст запроса в нейросеть написано в публикации буквально пару строк, а это очень важно.. собственно в этом самая большая изюминка описываемой модели, что она может выдавать результаты в контексте. Как вы готовите этот контекст - самое интересное. Если он готовится универсально для любых конфигураций - то окей, вопрос снимается.
2. Вот поэтому это пока демо-технология не более того, потому что для реального применения запрос нужно допиливать, и универсальным алгоритмом любые запросы не допилишь, увы... это задача для нейросети (обучение на данных от 1С).
3. Попробуйте написать запрос в нейросетку "остаток товара 120404 на складе" где искомый товар: Пластина для точения CNMG120404-MA VP15. Разумеется никто в реальной жизни полное наименование таких товаров не знает ) и это совсем простой пример... Я просто знаю допустим какая номенклатура используется в строительстве, там как бы в 150 символов ограничения наименования справочника номенклатуры легко можно упереться)
И не думаю, что такой сервис реально имеет шансы подвинуть программистов. Хотя, в ряде случае с очень большими штатами программистов или в небольших компаниях, практически работающих на готовых сторонних решениях - это может привести к некоторому сокращения штата. Но это всё будет капля в море - в среднем в ближайшие как минимум десятилетия (а то и столетия) ещё будет ожидаться средний рост спроса на программистов (может даже порой весьма бурный) практически во всех областях (даже если не учитывать в расчёте среднего стремительно растущий спрос на программистов для машинного обучения и нейросетей, который и далее будет стремительно ускораться).
Но говоря про автогенерацию запросов. Всё же, лично я больше склоняюсь к идее применения данных пдходов наряду с декларативным программированием - когда программист или аналитик будут задавать всё-таки исходную формализованную программу как декларацию строгих требований в специальном синтаксисе описания - а уже его будет обрабатывать ИИ и генерировать инструкции к выполнению (считаю что в идеале результат даже не надо показывать программисту, ведь не анализирует и не исправляет же сейчас программист опкоды после генерации из языка 1С - а зря - ибо 1С Предприятие там вообще почти ничего не оптимизирует). ИИ сам долен себя же и анализировать, в т.ч. статистически перепроверять код на тестовых, реальных данных - как сразу, так и со временем автоматически перепроверять. И генерировать сразу целые наборы вариантов исполнения - статистически подбирая наиболее оптимальный под конкретные условия эксплуатации.
А программист может его только направлять в нужное русло - для этого и нужна более формализованная постановка задачи в виде специального синтаксиса - декларативного языка - это упрсотит работу ИИ, сделав её более конкретизированной.
Ну и, заодно, такой подход должен повысить уровень абстракции такой декларативной постановки. Чтобы она была как можно более универсальной, и подхватывала, условно все настройки из библиотеки конфигурации - собирая готовое решения из целого набора абстракций и конкретных настроенных профилей, учитывала все, условно функциональны опции. А уже ИИ будет генерировать итоговый полностью собранный код алгоритма.
Ну а для периодического контроля можно будет лишь изредка обращаться к гуру - которые проанализируют логи, прогонят аналитические тесты, заглянут под капот сгенерированного кода, который тоже проанализируют при помощи специализированных инструментов разбора такого "машинного" кода - и составят отчёт - где есть узкие места, и какие правки нужно внести либо в настройки ИИ-генератора кода, либо в исходные декларативные инструкции, либо во всю архитектуру системы - логическую (на уровне метаданных) или физическую (на уровне СУБД). Но - это уже всё особый случай - требующийся только для экстремальной производительности (ну или просто для самоуспокоения - с редкой периодичностью).
В остальном - ИИ вполне себе будет генерировать качественный код - не в ближайшие лет 10 так через 100 лет - он этому научится на уровне не хуже среднестатистического профессионального программиста. Да и итоговый код в итоге у программ станет куда сложнее чем сейчас, и будет его на несколько порядков больше. Люди попросту уже не справятся с таким объёмом. А больше кода - выше функциональность - выше конкурентоспособность!
Я же не ратую против программирования - я лишь за его развитие - в виде ещё одной прослойки!
Можно стать крутым программистом или аналитиком или бизнесархитнектором - но не разбираться в тонкостях работы опкодов/машинных кодов и компиляции.
А можно не особо смыслить в бизнес-процессах (и логике запросов) - но хорошо разбираться в том, запросы SQL выполняются в той или иной СУБД и как её настраивать что-бы увеличить их скорость.
Безусловно базовые познания об обоих концах нужны всем - но углубляться практично будет только в одну область (ну или балансировать где-то посередине). Тут спрос будет определять потребность в тех или иных кадрах
Если вас интересуют вопросы непосредственного взаимодействия с языковой моделью, тогда вы можете начать тестирование самостоятельно, не дожидаясь обработки. На сайте OpenAI есть возможность генерировать SQL запросы в тестовом режиме
а только какую-то вероятность такого правильного ответа.
Поэтому в учетных системах, применение нейросетей будет скорее точечным и только в определенных областях,
потому что едва ли владелец организации захочет на вопрос "Какая прибыль организации за прошлый год ?",
услышать какой-то ответ, который может быть верным, а может и не быть...
А уж как будет налоговая рада суммам налогов в отчетности, которую сгенерировала нейросеть...
Да, и с GPT не надо общаться. Не забывайте, что это не существо, а всего лишь результат поиска того, что было сказано в интернете людьми
Про существо это вы смешно придумали. Вы пообщайтесь, посмотрите что оно вам ответит про базы данных и какую роль оно видит в них. Там все более чем логично.
Поэтому применение нейросетей так и останется ограниченным. В частности задача машинного перевода, которую вот уже лет пятьдесят решают, ими не будет решена. Не говоря уже о программировании.
Есть области. где воспроизводимость не важна. Скажем, дизайн. Отсюда популярность генеративных нейросетей для доработки изображений. Но там другая проблема, всякое творчество осуществляется в культурном контексте. Который нейрость может лишь вторично иммитировать, как Ван Гога например.
В целом то, что Вы видите столько смысла в работе нейросетей, это скорее не их заслуга (хотя это конечно сложные и во многом полезные алгоритмы), а Ваша. Мы так устроены, что можем находить смысл в том числе и там, где его нет и никогда не было. В гороскопах, в катренах Нострадамуса. То же самое с результатами нейросетей.
Проблема в том, что сегодня у Вас будет одно значение зависимых переменных, один результат, в Вашем случае - запрос, а завтра может быть другой результат. А независимые переменные при этом одни и те же.
Может быть результат будет почти такой же. А может быть будет существенно отличаться. Может быть он и останется прежним. Но Вы никогда не будете знать логику этих изменений. Хотя причина будет очевидна - нейросеть дообучили и/или поменяли какое-то количество из миллионов параметров.
Вы можете поступить, как люди поступают с 7.7. Один раз настроили, выдает нужный результат на контрольном наборе примеров. И все, не обновляем. Но это тоже некий тупик в стратегическом плане. Время идет, технология устаревает. И для этого алгоритм должен быть полностью на вашем железе.
Правильность ответов языковой модели зависит от того, сколько люди "наколотили" в контексте вашего вопроса. В области учета "наколотили" столько, что ответы нейросети почти идеальны. И потом, что значит неправильный ответ в нашем случае? Неправильный запрос? Неправильный запрос просто не отработает. И тогда пользователь просто переспросит другими словами. В обычном общении так и делают и никто не страдает: "а что будет, если меня неправильно поймут"
Вообще, генеративная модель работает не так. От того, что вы зададите ей супердлинный вопрос, она лучше не отработает
Даёшь ему таблицу на вход, а он делает по ней выводы типа "У нас на складе осталось 3 чая"...
Это можно было бы использовать в качестве заполнения тела писем в рассылках отчетов!
То есть при ежемесячной рассылке отчета менеджерам по продажам, можно было бы в тело письма сгенерировать строку типа "В этом месяце вы продали чая на 30% меньше чем обычно..."
Практического применения которого нет, разве что статьи клепать среднего качества и картинки генерировать, на то там и встроен рандом при выдаче результатов когда 2 и более ответа подходят, даже если отправить несколько раз один и тот же запрос результат может кардинально отличаться хоть общие черты будут сохранены(это к примеру генерации картинок) .
Это нейросеть больше именно для чатов, но никак не для учетных систем практической пользы которой не будет или вероятно будет даже вред, возможно широкое применение но ограниченное, например в чатах поддержки, это вам не ИИ !!! Не нужно питать к ней иллюзий о том что скоро люди будут не нужны, кто-то же должен делать физическую работу за еду которая настоящему ИИ не интересна ни в каких ее проявлениях).
Чат GPT это нейросеть для выдачи ответов на различные запросы описанных на естественном языке, и может следующее:
1. Генерировать ответы на вопросы.
2. Писать аля "статьи"
3. Генерировать картинки
4. И делать другие различные манипуляции с данными.
П.С. Причем чат GPT очень хорошо понимает контекст
Я не заметил... "Пример" запроса который Вы не удосужились выложить в голом виде даже? Картинки ответов, да, вижу. Как в анекдоте:
- А вы яблоки продаете?
- Нет, показываем
- Красивые!
Читал ветку, скинете в гит, молодец ,спасибо, вот вам морковка!
по апи скидывать запрос чату и получать ответ в виде запроса и выполнять его, а затем выводить результат выданного чатом запроса в таб док, это ваше практическое применение???
Приведите пару примеров реального практического полезного применения на реальных задачах в реальных базах данных)))
Для вашего приведенного примера и чата GPT не нужно для этого)
Что такое пример запроса в "голом" виде?
Вот запрос:
Сколько чая на основном складе?
Он в голом виде или в каком?
1. Я писал про запрос который вы отправляете чату, а не который вводит пользователь.
2. Вы между строк не читаете? Мне переформулировать свои мысли?
Для вашего приведенного примера и чата GPT не нужно для этого)
1. Запрос пользователя GPT и отправляю. Плюс описание таблиц.
2. Я тоже попытаюсь переформулировать. Есть человек, который хочет узнать сколько чая на основном складе. И он не знает и не хочет знать, что где-то в недрах программы, в каком-то особом месте есть пункт меню. А в этом пункте меню есть... ну вы поняли. Он хочет получить простой ответ на простой вопрос. Это и есть практическое применение. Интерфейс к базе данных на естественном языке
1. Почему тогда пример не выложили в статье, скриншот кода просто хотя бы, вам тут уже 100 вопросов задали по этому поводу и вы до сих пор не можете это понять в каком контексте вам пишут реальные люди!
2. Мысль вашу понял, полезность где?
Возьмите реальный отчёт продажи из УТ, пользователь будет печать/диктовать чату даже через войс прокладку описание всего и вся, ему не запросы надо формировать тогда уже а схему компоновки данных, хотя это нюанс. Которую надо будет хранить наверное чтобы каждый раз не объяснять заново, а потом таких схем накапливается с 10/100/1000 и выдуманная вами проблема которую вы хотели решить с помощью чата тут же проявляется в ещё более худшем варианте. Аргументы?
В чем сложность открыть отчёт если ты не кабачок!?
И я думаю заслуженно Станислав на мисте ветку утопил, не пятница сегодня.
Сколько чая на основном складе?
Вот и весь код. Вам не верится? Ну так проверьте!
Лично я встречал достаточное количество людей, которым сложно открыть отчет. И не потому, что они тупые, а скорее наоборот.
"Я бы и проверил то, что пишут, но это надо напрягаться, искать способы. Короче, все фигня!"
Он в принципе против обсуждения темы языковых моделей. Грозится всех в бан отправить. Скоро у него на сайте кроме геополитики ничего и не останется
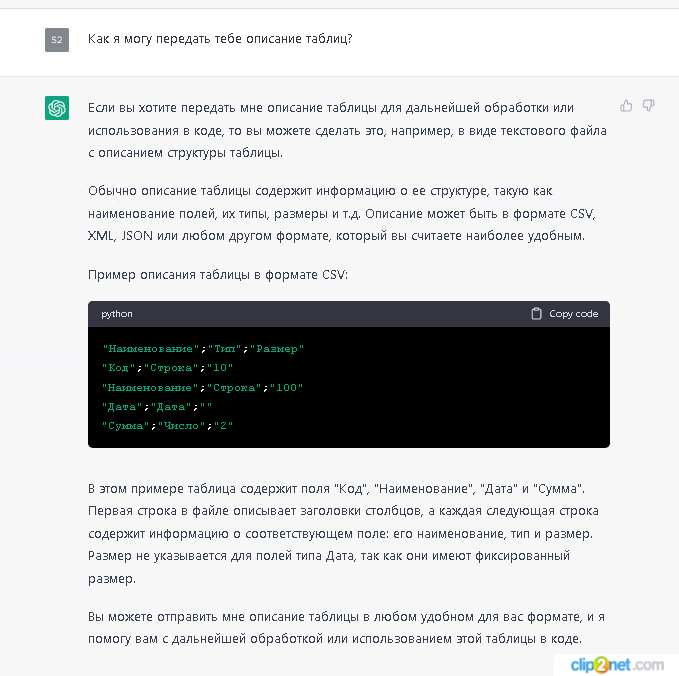
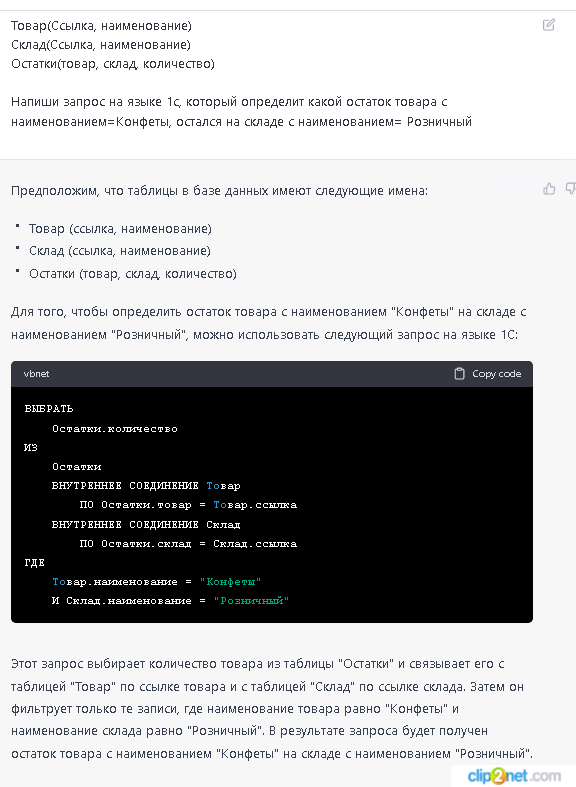
"вот сделай так и получишь результат"
Ну сделает он "так", получит ожидаемый результат. И что? Он ведь ничего не поймет в том, что происходит.
А вот когда он сделает "не так" и получит тот же результат, вот тогда возникнет понимание.
Поэтому я и говорю: "опишите схему таблиц"
Как? Словами. Своими. В этом вся соль.
Я же говорю, что модель вас "понимает" (что бы это ни значило).
Как бы вы ни описали таблицы, она все поймет. Можно использовать найденный вами способ. Можно тот, что у меня на сайте. Можно любой другой. Лишь бы в вашем описании был смысл
"Колея эта только моя..."
Подумалось, что можно интерфейс сбора данных улучшить.
Есть некоторые обязательные поля, важные для запроса и необязательные. Мы храним структуру и с теми и с другими.
Задача - заполнить обязательные поля и возможно частично - необязательные.
Но пользователь, делая запрос на естественном языке, может не указать всех обязательных данных.
Пусть, скажем, это будет что-то из предметной области "доставка продуктов". Есть обязательные поля: Имя клиента, Улица, номер дома, номер квартиры, контактный тел, Таблица товаров в которой заполнена хотя бы одна строка, возможно, с правилами: "Купить, если цена не дороже 200", "Купить любой черный хлеб" и т.п. - но это уже следующая ступень )))
Так вот, пользователь в запросе может не указать сразу все обязательные данные. То есть, он пишет: привези мне хлебушка в офис.
Соответственно, у нас такой запрос не всё заполнил, но движок GPT распознал продукт, который можно добавить в ТЗ.
И дальше он смотрит, что не хватает полей, и отвечает, спасибо, я вас понял, расскажите, пожалуйста, как Вас зовут, где вы живете и напишите ваш телефон
Пользователь отвечает: Вася я, телефон мой 12456, Живу я На улице Лизюкова
Получаем часть полей, но не все - нет дома и квартиры, и снова уточняем:
- Подскажите, пожалуйста, номер дома и квартиры:
- Дом 5 квартира 1.
теперь все обязательные поля заполнены. Можно резюмировать, как официнт в ресторане подтверждает заказ.
И добавить - это всё или еще что-то хотите?
Вот такое возможно ?
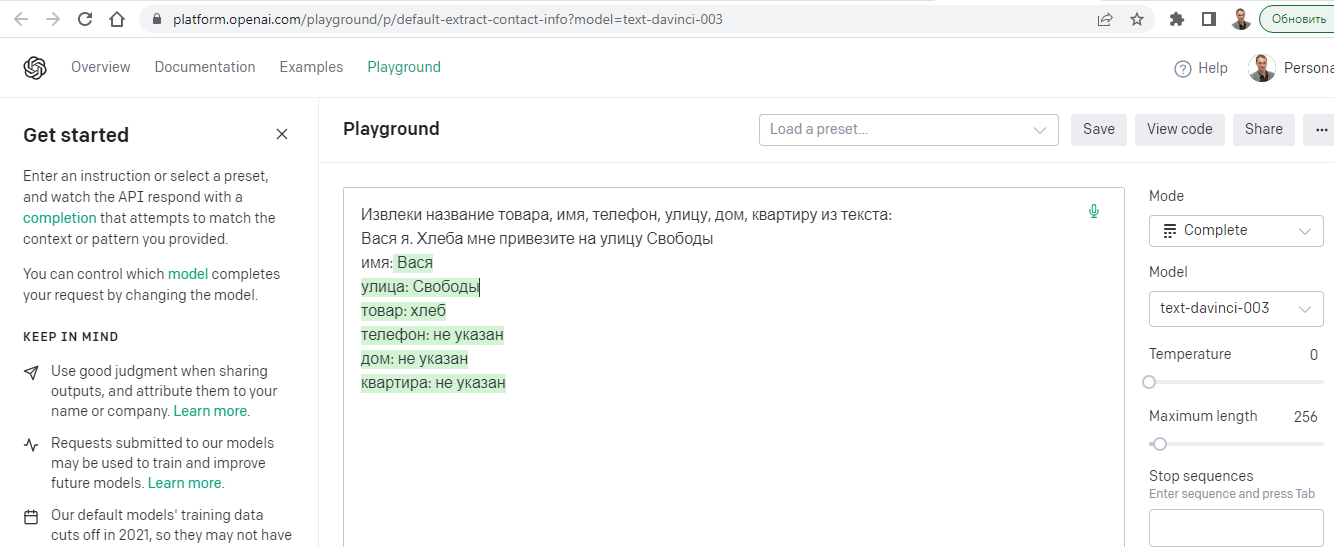
Или объясните как зарегистрироваться для получения ключика...Очень хочется попробывать игрушку!
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 1785995
Создание 15.01.23 22:30
Обновление 15.01.23 22:30
Просмотры 19334
Загрузки 0
Рейтинг
82
Комментарии 124
Код открыт Да
Рубрики Работа с интерфейсом Нейросети
Кому Разработчик
Тип файла Нет файла
Платформа 1С:Предприятие 8
Конфигурация 1С:Управление торговлей 11
Операционная система Не имеет значения
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)