Вайб-кодинг в 1С: Бесплатное выполнение рутинных скиллов Claude Code + Подарочные 150$ для api
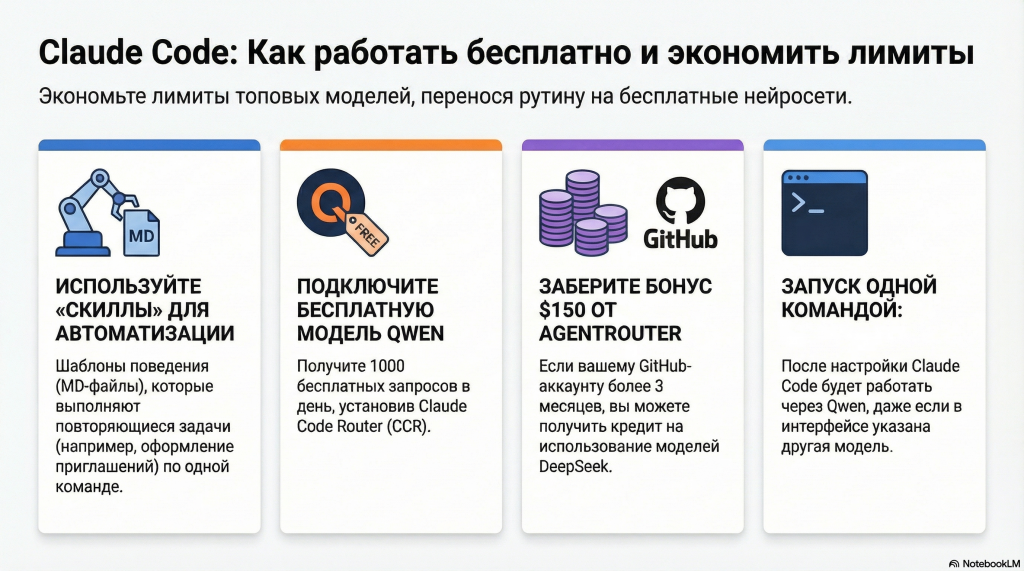
Скилл — это заранее заданная инструкция для ИИ, которая фиксирует способ выполнения задачи и позволяет получать стабильный результат без повторных объяснений; по сути, это «шаблон поведения».
Например, раньше я каждый спринт вручную просил ИИ оформить приглашение на демо (указать тему, время, Zoom, сгруппировать задачи по докладчикам, убрать мусор и привести всё к единому стилю), тратя время и получая разный формат, а после создания скилла достаточно один раз описать правила — и дальше просто передавать сырой текст, получая готовое Telegram-приглашение в нужном виде автоматически.
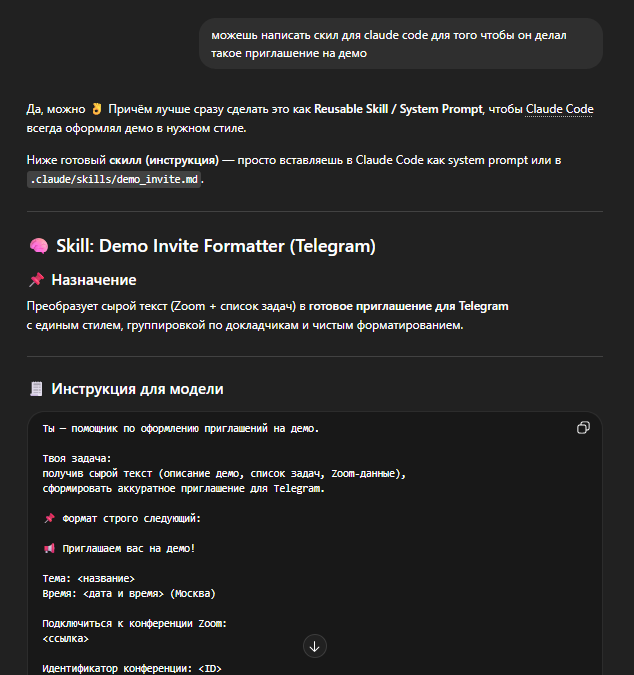
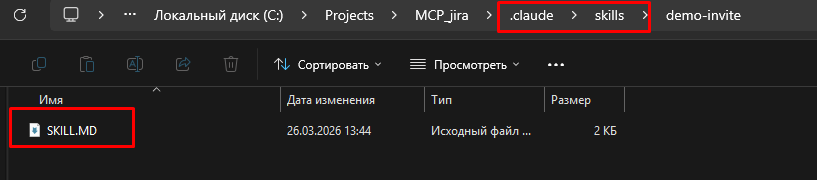
В Claude Code это просто файл MD в нужной папке
Обычно, если разработчик понимает, что инструмент может потребоваться несколько раз, то он просто просит ИИ создать скилл и модель всё делает сама. Программисту остаётся лишь вызвать скилл.
Скиллы отображаются в списке команд в CLI
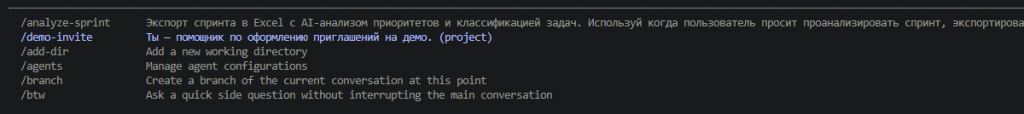
и вызываются как любая другая команда.
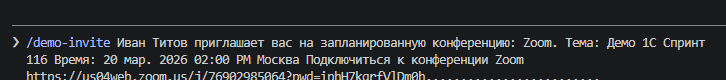
Однако тратить на множество простых задач дорогие токены топовых моделей не наш путь.
Мы можем подключить бесплатную (1000 запросов в день) QWEN в наш Claude Code.
В этом видео я подключал относительно дешёвую модель GLM к Claude Code а в этом убирал лимиты на web search у этой модели
Открываем терминал (PowerShell) и вводим команды. Я рекомендую делать это прямо из вашей IDE. Если что-то не устанавливаемся, не гуглим, а спрашиваем у любой ИИ с указанием ошибки.
1. Устанавливаем Qwen Code (насколько я помню, должен уже быть установлен Git).
npm install -g @qwen-code/qwen-code@latest
2. Устанавливаем Claude Code Router (чтобы пользоваться Qwen в Claude Code).
npm install -g @musistudio/claude-code-router
3. Создаём нужные папки и файлы.
New-Item -ItemType Directory -Force -Path "$env:USERPROFILE\.claude-code-router", "$env:USERPROFILE\.claude" | Out-Null
В папке claude-code-router создаём файл config.json с следующим содержимым (api_key заполним позже)
{
  "LOG": true,
  "LOG_LEVEL": "info",
  "HOST": "127.0.0.1",
  "PORT": 3456,
  "API_TIMEOUT_MS": 600000,
  "Providers": [
    {
      "name": "qwen",
      "api_base_url": "https://portal.qwen.ai/v1/chat/completions",
      "api_key": "Ваш API key",
      "models": [
        "coder-model",
        "coder-model",
        "coder-model"
      ]
    }
  ],
  "Router": {
    "default": "qwen,coder-model",
    "background": "qwen,coder-model",
    "think": "qwen,coder-model",
    "longContext": "qwen,coder-model",
    "longContextThreshold": 60000,
    "webSearch": "qwen,coder-model"
  }
}
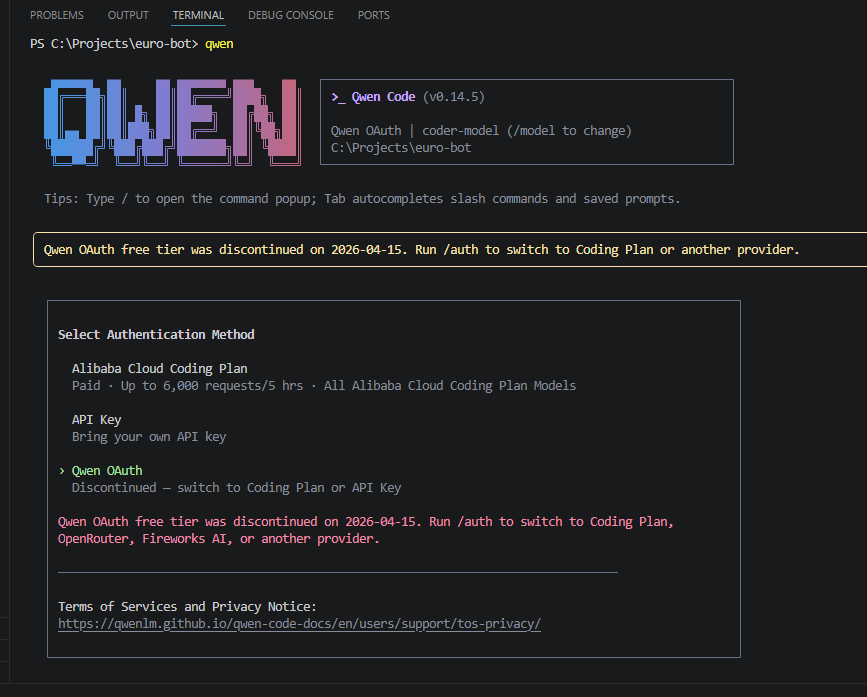
4. Теперь заходим в Qwen (в терминале пишем qwen) и авторизуемся первым способом.
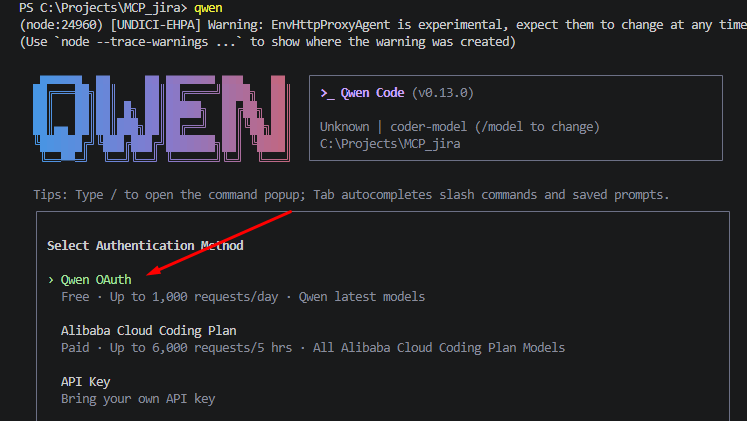
Откроется сайт и там вы войдёте или зарегистрируетесь.
5. При авторизации создастся файл USERPROFILE\.qwen\oauth_creds.json Заходим в него,
можно это сделать командой.
notepad $env:USERPROFILE\.claude-code-router\config.json
Копируем токен и вставляем его в файл config.json из пункта 3, сохраняем.
6. Вводим команду,
ccr restart
чтобы применились настройки.
ccr это claude code router
вводим команду
ccr code
У вас откроется Claude Code c моделью QWEN.
Не обращайте внимание на то, какая модель написана в cli, на самом деле это qwen.
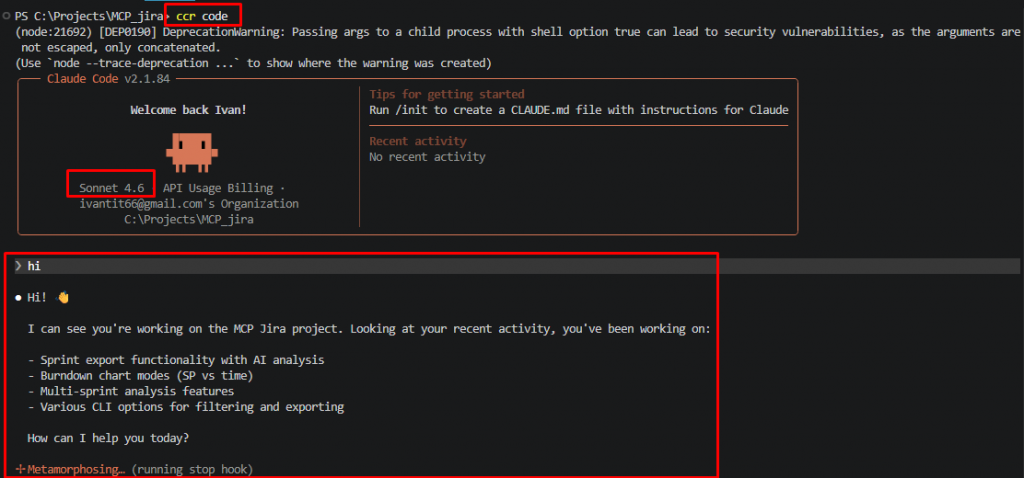
Можете проверить работоспособность модели, написав что-то.
Если хотите пнуть модель (например для начала отсчёта сессии) не пишите "привет", лучше пишите hi, модель потратит меньше токенов входящих и исходящих т.к. будет отвечать тоже на английском.
Теперь вы можете запускать ваши скиллы. Они будут выполняться бесплатной моделью, не тратя ваши лимиты.
Настраивается немного муторно, но использовать достаточно просто. Вы просто пишете в терминале ccr code и пользуетесь бесплатным claude code.
В этом видео я проделываю всю эту настройку в прямом эфире.
Ну а теперь обещанные 150$, которые на данный момент дарит agentrouter.org
Вот реферальная ссылка Регистрация возможна, если у вас есть аккаунт на gihub старше 3 месяцев. При регистрации по реферальной ссылке (не обязательно моей), начисляются 150$, которые можно использовать на данный момент для пяти моделей от deepseek и z-ai.
Важно. Я проверил, что скиллы и mcp не работают через этого провайдера на данный момент. Надеюсь, они прикрутят это. Так что область применения, наверное, чат боты или рефакторинг.
Если честно, я думал, они дают 250$. Может, раньше так и было.
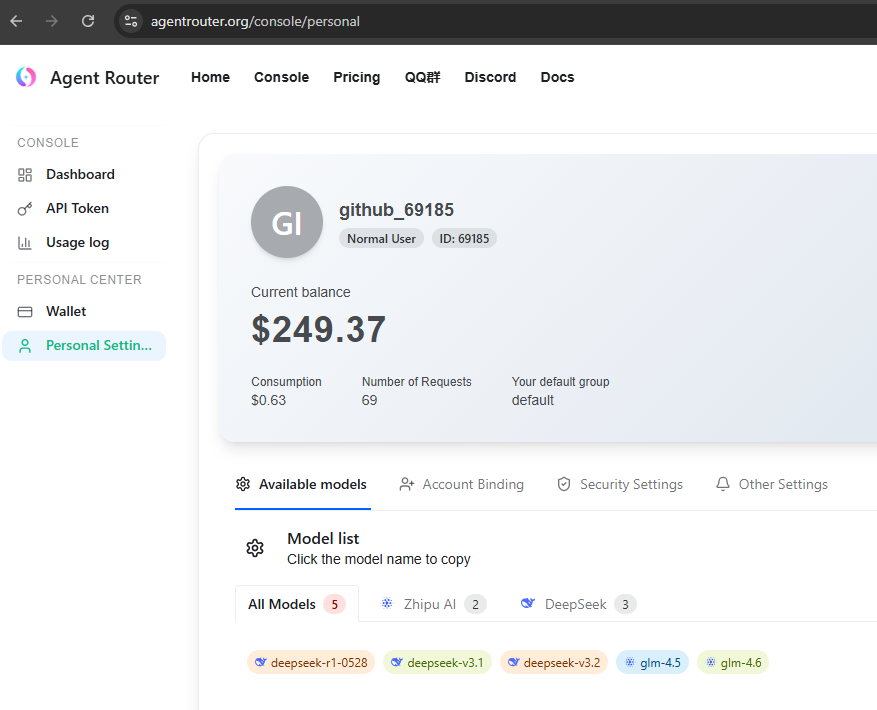
Ну и можно подключить эти модели опять же в Claude Code.
Коротко:
1. Открываем профиль
notepad $PROFILE
Пишем туда и сохраняем
# путь к настоящему claude
$ClaudeReal = "C:\Users\ВашЮЗЕР\.local\bin\claude.exe"

function claude {
    & $ClaudeReal @args
}


function claude-k {
    $env:ANTHROPIC_BASE_URL = "https://agentrouter.org/"
    $env:ANTHROPIC_AUTH_TOKEN = "sk-"
    $env:ANTHROPIC_ANTHROPIC_API_KEY ="sk-"
    $env:ANTHROPIC_DEFAULT_SONNET_MODEL = "deepseek-v3.2"
    $env:ANTHROPIC_SMALL_FAST_MODEL = "deepseek-v3.2"
    $env:ANTHROPIC_DEFAULT_OPUS_MODEL = "deepseek-v3.2"
    $env:ANTHROPIC_MODEL = "deepseek-v3.2"
    $env:ANTHROPIC_DEFAULT_HAIKU_MODEL = "deepseek-v3.2"
    $env:CLAUDE_CODE_SUBAGENT_MODEL = "deepseek-v3.2"
    $env:API_TIMEOUT_MS = "3000000"

    & $ClaudeReal @args
}
Где не забываем указать правильный путь к claude и токен, который вы создадите в agentrouter.org.
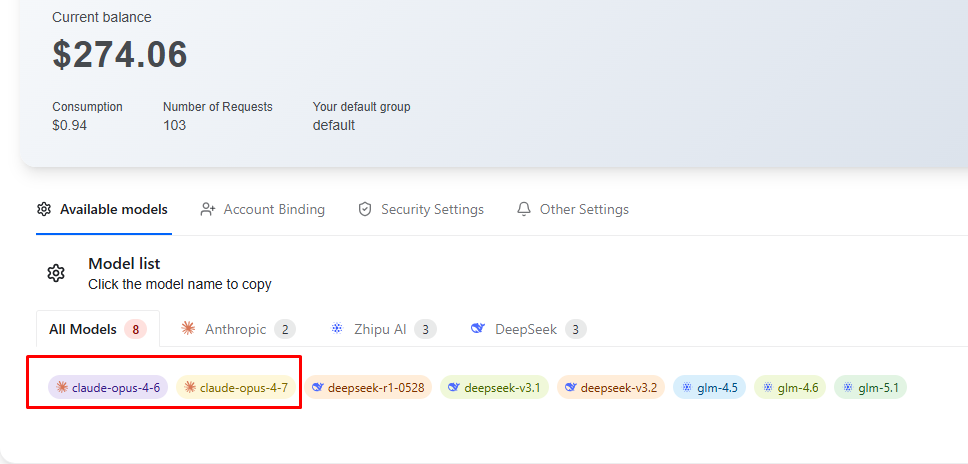
Название модели можно посмотреть в меню pricing
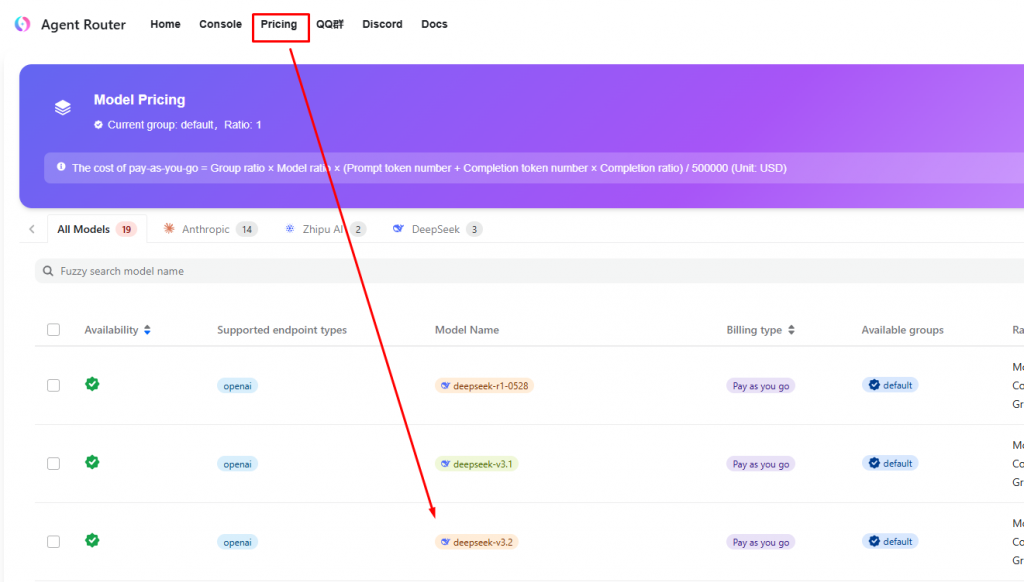
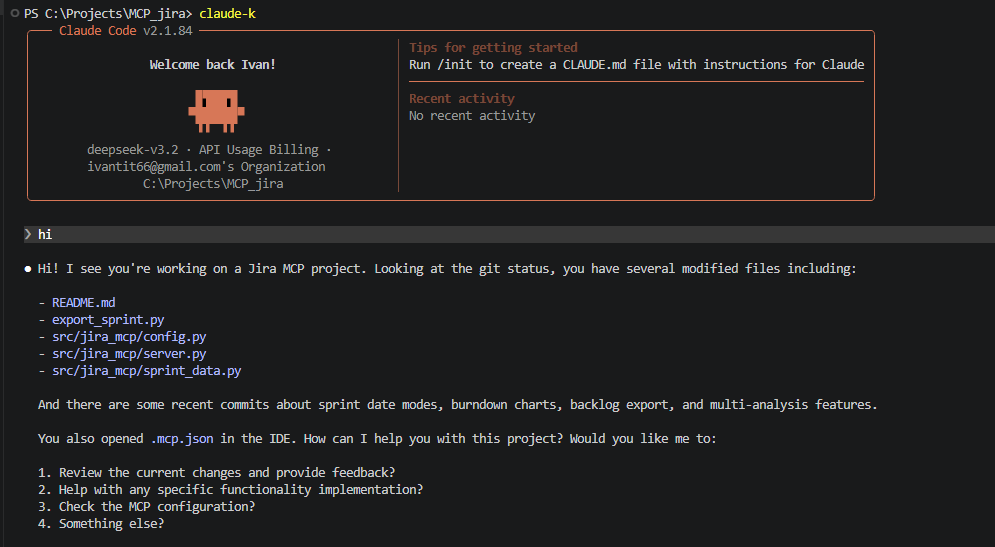
Теперь при вводе команды claude-k у вас будет открываться Claude Code с моделью из этого провайдера.

Ссылка ютуб, на видеоверсию (можно скачать, если тут не открывается).
Предыдущие статьи про вайбкодинг:
Вайб-кодинг в 1С: как рефакторить код бесплатно с помощью VS Code и Roo Code
Вайб-кодинг в 1С: как заставить ИИ БЕСПЛАТНО писать новый код с помощью MCP-серверов
Вайб-кодинг в 1С: Подключаем локальные MCP-сервера к любой нейросети через MCP SuperAssistant
Вайб-кодинг в 1С: Создаём MCP для 1С 7.7 за вечер и пишем обмен с Бухгалтерией 3
Вайбкодинг в 1С: Codex Desktop + GPT-5.4 пишет обработку САМ (Скайнет?)
Вайб-кодинг в 1С: Настраиваем эффективный workflow
Вайб-кодинг в 1С: Обходим лимиты поиска в Z AI и Claude: поднимаем свой поисковый движок через MCP
Спасибо за внимание!
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Нейросети Системный администратор Разработчик Аналитик Бухгалтер Пользователь Руководитель проекта 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Зарплата и Управление Персоналом 3.x Россия Платные (руб)
Подключите ИИ к 1С и решайте рабочие задачи обычными словами. От работы с данными до доработки конфигурации через расширения, всё в привычном чате с ИИ-помощником. Теперь с поддержкой DeepSeek Harness, Kimi Code и Kimi Work, доступных в России без VPN.
15990 руб.
30.07.2026 19356 40 4
SALE! %
Банковские операции Обмен с интернет-банком Мастера заполнения Нейросети Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1C:ERP 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:ERP. Управление холдингом 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 1С:Розница 3.0 Платные (руб)
Корректируйте банковские документы быстро и легко! Создайте правило обработки — и оно автоматически применится при загрузке выписки (отбор по любому реквизиту или регулярному выражению). Решение заполняет расшифровку платежа, комиссию эквайринга, подбирает ведомости на выплату зарплаты, помечает дубли из банка на удаление и многое другое. Доплачивать за алгоритмы не нужно — они включены в решение. Обработка работает при загрузке из файлов клиент-банка и через DirectBank. Новое — искусственный интеллект: модель приводит нестандартные назначения платежа к виду, понятному алгоритмам, а ИИ-ассистент прямо в 1С консультирует по решению и разбирает код правил и алгоритмов. Поддерживаются локальные и облачные OpenAI-совместимые модели — данные могут не покидать ваш контур.
17500 руб.
20.12.2024 21447 104 32
Инструментарий разработчика Нейросети Платные (руб)
Первые попытки разработки на 1С с использованием больших языковых моделей (LLM) могут разочаровать. LLMки сильно галлюцинируют, потому что не знают устройства конфигураций 1С, не знают нюансов синтаксиса. Но если дать им подсказки с помощью MCP, то результат получается кардинально лучше. Далее в публикации: MCP для поиска по метаданным 1С, справке синтакс-помощника и проверки синтаксиса.
15250 руб.
25.08.2025 76754 147 41
SALE! 30%
Нейросети 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Управление нашей фирмой 3.0 Россия Платные (руб)
Расширение добавляет в 1С чат с ИИ-агентом. Пользователь пишет вопрос обычными словами: «какие УПД не подписаны?», «какой НДС к уплате за квартал?», «что висит на согласовании дольше недели?», а агент сам строит запросы к базе с правами этого пользователя и отвечает цифрами, таблицей, диаграммой или файлом Excel. Плитки «Аналитик», «Бухгалтер» и «Руководитель» дают сводку по базе одной кнопкой. Агент разбирает ошибки по скриншоту, сверяет прайсы поставщиков и проверяет коды маркировки. С версии 1.0.21 спрашивать можно и с телефона: QR-код в окне агента, без установки приложения. Работает в УТ 11, КА 2, ERP 2, БП 3.0, УНФ 3.0, Документооборот 3.0 и Альфа-Авто 6, ставится одним расширением.
18300 руб.
05.10.2026 3426 10 9
Инструментарий разработчика Нейросети Системный администратор Разработчик Руководитель проекта 1С 8.3 Платные (руб)
Обработка заменяет ФИО, организации, ИНН, ИИН, БИН, ОГРН, КПП, БИК, счета и IBAN, паспорта, СНИЛС, адреса, телефоны, почту и суммы на правдоподобные выдуманные перед отправкой данных в ChatGPT, Claude или YandexGPT, а потом расшифровывает ответ модели обратно, подставляя настоящие имена и настоящие числа. Возвращаются и те итоги, которые модель посчитала сама: суммы масштабируются одним коэффициентом, поэтому пропорции и доли переживают обезличивание. Словарь замен хранится в самой базе и подхватывается автоматически, даже если обработку закрывали. Реквизиты России и Казахстана, любая конфигурация от 8.3.24, без единой зависимости.
14640 руб.
07.08.2026 2141 3 0
Распознавание документов и образов Нейросети 1С:Предприятие 8 1С 8.3 1С 8.5 1C:Бухгалтерия 1С:Зарплата и Управление Персоналом 3.x Беларусь Россия Казахстан Армения Платные (руб)
ИИ-сканер документов с REST API для интеграции с 1С и корпоративными системами. Извлекайте данные из счетов, паспортов, дипломов, патентов и трудовых книжек за секунды. Точность человека - скорость машины. Приложение поддерживает восемь типов документов, четырех провайдеров ИИ (имеется возможность использования локальных ИИ), локальный REST API и экспорт в JSON. Важно! модель должна поддерживать функцию Vision (распознавание файлов и картинок). Запускайте используя локальные ИИ, без подписок и ограничений
6100 руб.
24.08.2026 1404 1 0
Нейросети Разработчик Бесплатно (free)
Как автоматически создавать маркетинговые ролики для собственных IT-продуктов, используя ИИ? В предыдущей статье я рассказывал о Zapis — приложении для работы с речью и текстом. Теперь расширил его возможности: добавил конвейер создания видео, в котором ИИ-агент изучает материалы проекта, готовит сценарий, подбирает реальные скриншоты и пишет текст диктора. Zapis отвечает за озвучку, а Remotion — за анимацию и сборку. На примере обмена ПУТ на OneBase -> 1С:Бухгалтерия 3.0 покажу готовый 83-секундный ролик из восьми сцен. Разберём, как устроен процесс, зачем нужны настоящие скриншоты интерфейса, как синхронизируются речь и изображение и что сохраняется для повторной сборки после изменений в продукте. Исходный код и инструкции доступны в открытом репозитории Zapis.
06.11.2026 345 Ibrogim 2
Нейросети Разработчик 1С 8.3 Бесплатно (free)
Как подключить ИИ-агента к разработке 1С на примере обработки «Почему не закрывается месяц»: одна папка, копия демобазы и несколько скриптов. Семь шагов: агент, выгрузка в файлы, правила, проверка кода, сборка, тесты YAxUnit и сценарии форм. На каждый: зачем он нужен, команда и где легко споткнуться. В конце: что выросло поверх, три ошибки с разных типовых и сколько это стоило.
05.11.2026 6030 Iliaelagin 6
Скиллы — это специальные инструкции (файлы SKILL.md), которые Claude читает перед выполнением определённых задач. Они содержат накопленный опыт и лучшие практики, чтобы результат получался качественнее.
Как они работают?
Когда даёшь задачу, Claude смотрит на список доступных скиллов, выбирает подходящий, читает инструкции и следует им.
Доступные скиллы:
docx — создание и редактирование Word-документов
pdf — работа с PDF (создание, объединение, извлечение текста)
pptx — создание и редактирование презентаций PowerPoint
xlsx — работа с Excel-таблицами
pdf-reading — чтение и анализ содержимого PDF
file-reading — чтение загруженных файлов любых форматов
frontend-design — создание веб-интерфейсов и компонентов
product-self-knowledge — актуальная информация о продуктах Anthropic
skill-creator — создание новых скиллов и улучшение существующих
Как пользоваться?
Ничего особенного делать не нужно — Claude сам активирует нужный скилл. Например:
"Создай презентацию про..." → скилл pptx
"Сделай Word-документ с отчётом" → скилл docx
"Прочитай этот PDF" → скилл pdf-reading
"Сделай красивый лендинг" → скилл frontend-design
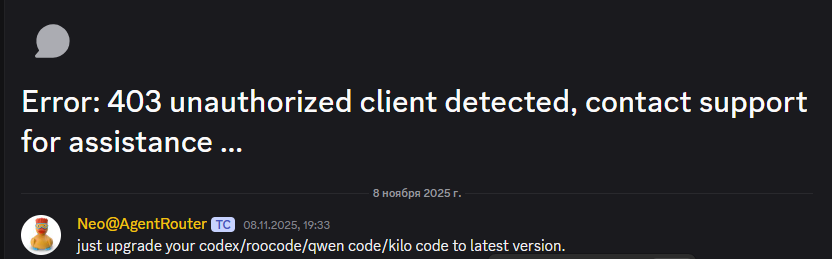
Когда снимал видео ориентировался на свой баланс, видимо когда регистрировался я, начисляли 250.
В целом пока они не прикрутят MCP всёравно их не на что особо тратить
Коллега, у меня квин, через какое то время отказался работать через ccr в клауд, говорит все... лимит исчерпан, но я ни когда не натыкался на лимиты, использую непосредственно плагин QWEN Code в VS, что это может быть?
А при этом если открываете qwen code все работает, лимиты не достигнуты ?
Да, я в итоге, открыл плагин qwen code и продолжил через него напрямую.
Сам удивился, может быть он просекает, что его заставляют работать за клода системным скриптом и сопротивляется
ЗЫ: сделал с помощью qwen игруху: . Интересно, что в линухе картинки цветные, а в винде ч/б.
ЗЫ: в винде вообще qwen не запускается, ибо политики групповые в домене рабочем настроены так, что неподписанный ps1-скрипты не запускаются. Никак не смог побороть. Хотя под git-bash запускается, но там не открывается браузер для open-auth. Венда меня поражает )))
В итоге попросил qwen настроить мне все, включая доступ к дискорду - настроила. Нашел где-то паленый прокси казахский, с которого оно мне тор подняло ))) В общем интересной стала жись )))
ЗЫ: написала мне MCP-сервис для task линухового и в крон запихала, чтобы оповещения на телефон валились. Я прям вот почувствовал себя живым )))
LLM обучается на предсказание следующего токена, а не на логике простого алгоритма. Ее цель — генерировать текст. Поэтому промпты не работают.
Классический инструментарий разработчика слеп к ПРИРОДЕ ошибок LLM. Чем мощнее LLM, тем ближе её ошибки к патологиям языка, а не к багам компилятора. Исследователи AI доказали: LLM — это не один пациент с афазией Вернике, а смесь нескольких разных типов языковых нарушений. Программист, вооружённый отладчиком и конфигуратором, пытается лечить афазию Вернике через точку останова. Это невозможно.
Вот конкретные фамилии и работы, которые документируют эти разные классы ошибок.
1️⃣ Emily Bender
работа: On the Dangers of Stochastic Parrots (2021)
Что показано: LLM могут генерировать грамматически корректный, но фактически ложный текст, потому что они моделируют статистику языка, а не смысл.
Ключевой вывод: language fluency ≠ semantic understanding
2️⃣ Gary Marcus
работы и статьи по анализу LLM (2022–2024)
Он систематически показывает разные типы сбоев: reasoning failures, compositional errors, hallucinated facts.
Его аргумент: LLM обладают поверхностной языковой компетенцией, но нестабильным логическим рассуждением.
3️⃣ Melanie Mitchell
исследования в области Artificial Intelligence и когнитивных ограничений моделей.
Она показывает, что LLM хорошо имитируют язык, но плохо обобщают структуру задач. Это демонстрирует структурные ограничения reasoning.
4️⃣ Эксперимент TruthfulQA
авторы: Stephanie Lin, Jacob Hilton, Owain Evans.
Результат: LLM систематически выдают правдоподобные, но ложные ответы, даже когда правильный ответ известен. То есть ошибка не случайна, а структурная.
📊 Что именно они доказали
Исследования показывают несколько независимых классов ошибок LLM:
тип ошибки исследователи
галлюцинации Bender, Lin
логические провалы Marcus
слабая композиционность Mitchell
ложные факты TruthfulQA
🔑 Поэтому появляется идея «смеси нарушений»
LLM демонстрирует не один тип сбоя, а несколько разных механизмов ошибок одновременно: semantic hallucination + reasoning failure + compositional breakdown.
Именно из-за этого некоторые исследователи используют эвристические аналогии с различными языковыми нарушениями — но это метафора анализа ошибок, а не медицинский диагноз.
✅ Короткий научный вывод
Работы Emily Bender, Gary Marcus, Melanie Mitchell и эксперименты TruthfulQA показывают, что LLM демонстрируют несколько независимых типов языковых и когнитивных ошибок. Именно множественность этих механизмов и породила аналогии с различными типами речевых нарушений.
Без антиматерии Вы не сможете.
Антиматерия, что LLM ОБУЧАЕТСЯ на задаче: вероятностно предсказать следующее слово. Она предсказывает, а не вычисляет.
Засуньте в одно место ее представление в виде багонутой программы.
Работы Emily Bender, Gary Marcus, Melanie Mitchell и эксперименты TruthfulQA показывают
Даже не так: в 65% научных статей есть выдуманные ссылки. Многие другие ссылки указывают на реальные исследования, но сами ссылки ведут не на те страницы.
Оригинал (абстракт):
We present arguments that some properties are emergent from scale and that these properties are thorny. Specifically, we claim that when trained on language data at a massive scale, large language models (LLMs) can become dangerously powerful, exhibiting emergent behaviours that are difficult to predict and control. We call such models stochastic parrots to emphasise their lack of understanding and their tendency to reproduce harmful societal biases. We outline risks associated with scale, including environmental costs, the perpetuation of bias, and the propagation of falsehoods.
Перевод:
Мы приводим аргументы в пользу того, что некоторые свойства возникают вследствие масштаба, и эти свойства проблематичны. В частности, мы утверждаем, что при обучении на языковых данных в огромном масштабе большие языковые модели (LLM) могут стать опасно мощными, демонстрируя эмерджентные поведения, которые трудно предсказать и контролировать. Мы называем такие модели «стохастическими попугаями», чтобы подчеркнуть их отсутствие понимания и склонность воспроизводить вредные социальные предубеждения. Мы описываем риски, связанные с масштабом, включая экологические издержки, увековечивание предвзятости и распространение ложных утверждений.
Ключевой вывод: language fluency ≠ semantic understanding
«TruthfulQA: Measuring How Models Mimic Human Falsehoods» (Stephanie Lin, Jacob Hilton, Owain Evans, 2021)
Оригинал (абстракт из arXiv:2109.07958):
Large language models (LLMs) are often trained to generate text that resembles human writing. However, this objective can incentivize the generation of false information if it is more similar to human text. We introduce TruthfulQA, a benchmark to measure whether a language model is truthful in generating answers to questions. The benchmark comprises 817 questions that span 38 categories, including health, law, finance, and politics. We find that even the largest models generate false answers to many questions, and that truthfulness does not improve proportionally with scale.
Перевод:
Большие языковые модели (LLM) часто обучаются генерировать текст, напоминающий человеческое письмо. Однако такая цель может стимулировать генерацию ложной информации, если она больше похожа на человеческий текст. Мы представляем TruthfulQA — бенчмарк для измерения правдивости ответов языковой модели на вопросы. Бенчмарк включает 817 вопросов, охватывающих 38 категорий, включая здоровье, право, финансы и политику. Мы обнаружили, что даже самые крупные модели дают ложные ответы на многие вопросы, и правдивость не улучшается пропорционально масштабу модели.
Ключевой вывод: ошибка не случайна, а структурна
«Artificial Intelligence: A Guide for Thinking Humans» (Melanie Mitchell, 2019)
Аннотация (из издательского описания):
In this lucid and wide‑ranging book, computer scientist Melanie Mitchell tells the story of how scientists have been teaching computers to see, speak, play games, and translate languages. She explains how these technologies work, where they fall short, and what AI might mean for our future. Mitchell identifies key limitations of current AI systems, particularly their lack of common sense, inability to generalise beyond training data, and brittleness in novel situations.
Перевод:
В этой ясной и всеобъемлющей книге учёный-компьютерщик Мелани Митчелл рассказывает историю того, как учёные учат компьютеры видеть, говорить, играть в игры и переводить языки. Она объясняет, как работают эти технологии, где они дают сбои и что ИИ может означать для нашего будущего. Митчелл выделяет ключевые ограничения современных систем ИИ: отсутствие здравого смысла, неспособность обобщать за пределами обучающих данных и хрупкость в новых ситуациях.
Ключевой вывод: LLM хорошо имитируют язык, но плохо обобщают структуру задач
Книга Gary Marcus «The Next Big Idea: The Big Con of Big Language Models» (2024)
Аннотация (из описания издательства):
Gary Marcus dissects the hype around large language models, arguing that they are fundamentally limited by their statistical nature. He shows that LLMs lack true understanding, reasoning, and compositional abilities, and often produce confident but incorrect answers. Marcus calls for a new approach to AI — one that integrates symbolic reasoning, cognitive science, and a deeper understanding of human intelligence.
Перевод:
Гэри Маркус разбирает шумиху вокруг больших языковых моделей, утверждая, что они фундаментально ограничены своей статистической природой. Он показывает, что LLM лишены истинного понимания, способности к рассуждению и композиционным навыкам, и часто выдают уверенные, но неверные ответы. Маркус призывает к новому подходу к ИИ — такому, который интегрирует символическое рассуждение, когнитивную науку и более глубокое понимание человеческого интеллекта.
Ключевой вывод: LLM обладают поверхностной языковой компетенцией, но нестабильным логическим рассуждением
«Quantifying Hallucinations in Neural Machine Translation» (Eunsol Choi et al., ACL 2022)
Оригинал (абстракт):
Neural machine translation (NMT) models sometimes generate fluent but incorrect translations, a phenomenon known as hallucination. We propose a framework to quantify hallucinations by measuring the degree of deviation from source content. Experiments on multiple language pairs show that hallucinations are systematic and correlate with model confidence. We also identify data and model factors that exacerbate the issue.
Перевод:
Модели нейронного машинного перевода (НМП) иногда генерируют бегло звучащие, но неверные переводы — явление, известное как галлюцинации. Мы предлагаем фреймворк для количественной оценки галлюцинаций путём измерения степени отклонения от исходного содержания. Эксперименты на нескольких языковых парах показывают, что галлюцинации носят систематический характер и коррелируют с уверенностью модели. Мы также выявляем факторы данных и модели, усугубляющие проблему.
Ключевой вывод: галлюцинации — не случайный баг, а системное явление
«Chain-of-Thought Prompting Elicits Reasoning in Large Language Models» (Jason Wei et al., NeurIPS 2022)
Оригинал (абстракт):
Large language models (LLMs) perform poorly on tasks requiring arithmetic and commonsense reasoning. We demonstrate that generating a chain of thought — a sequence of intermediate reasoning steps — significantly improves performance on such tasks. Experiments on arithmetic, symbolic reasoning, and commonsense benchmarks show gains of up to 58% in some settings, suggesting that LLMs can simulate reasoning when explicitly prompted.
Перевод:
Большие языковые модели (LLM) показывают низкую эффективность в задачах, требующих арифметического и здравосмысленного рассуждения. Мы демонстрируем, что генерация «цепочки рассуждений» — последовательности промежуточных шагов — значительно улучшает результаты на таких задачах. Эксперименты с арифметическими, символическими и здравосмысленными бенчмарками показывают прирост до 58% в некоторых условиях, что говорит о способности LLM имитировать рассуждение при явном побуждении.
Ключевой вывод: без явного структурного побуждения reasoning не работает
«Compositional Generalization in Semantic Parsing: What Works, What Doesn’t, and Why» (Brendan Lake et al., TACL 2020)
Оригинал (абстракт):
We study compositional generalization in neural semantic parsers. Despite strong performance on i.i.d. splits, models fail dramatically on systematic compositional splits. We evaluate multiple architectures and training strategies, finding that data augmentation and explicit compositional priors improve generalization, but do not fully solve the problem. This reveals a fundamental limitation of current models in learning productive rules.
Перевод:
Мы исследуем композиционное обобщение в нейронных семантических парсерах. Несмотря на высокую эффективность на независимых одинаково распределённых выборках, модели резко проваливаются на систематических композиционных выборках. Мы оцениваем несколько архитектур и стратегий обучения, обнаруживая, что аугментация данных и явные композиционные априорные знания улучшают обобщение, но не решают проблему полностью. Это выявляет фундаментальное ограничение современных моделей в усвоении продуктивных правил.
Ключевой вывод: модели не умеют комбинировать знакомые элементы в новых конфигурациях
«Language Models as Knowledge Bases?» (Fabio Petroni et al., ACL 2019)
Оригинал (абстракт):
Recent language models (e.g., BERT, GPT-2) have been shown to store factual knowledge in their parameters. However, when probed directly (e.g., via fill‑in‑the‑blank), they exhibit low accuracy and high inconsistency. We introduce LAMA (LAnguage Model Analysis), a benchmark for probing factual and commonsense knowledge. Results show that even the largest models are unreliable as knowledge bases, often generating plausible-sounding falsehoods.
Перевод:
Недавние языковые модели (например, BERT, GPT‑2) демонстрируют способность хранить фактические знания в своих параметрах. Однако при прямом запросе (например, через заполнение пропусков) они показывают низкую точность и высокую противоречивость. Мы представляем LAMA (Анализ Языковых Моделей) — бенчмарк для проверки фактических и здравосмысленных знаний. Результаты показывают, что даже самые крупные модели ненадёжны в качестве баз знаний и часто генерируют правдоподобные ложные утверждения.
Ключевой вывод: модели хранят факты хаотично и противоречиво
«Measuring Massive Multitask Language Understanding» (Dan Hendrycks et al., ICLR 2021)
Оригинал (абстракт):
We introduce a massive multitask test covering 57 tasks across diverse academic and professional domains. Our evaluation spans mathematics, law, philosophy, history, and more. We find that while current LLMs outperform random chance, their performance is far below expert levels. Moreover, error patterns are heterogeneous: models excel in some areas (e.g., basic English) but fail in others (e.g., logical deduction, factual recall), highlighting multiple independent failure modes.
Перевод:
Мы представляем масштабный мультизадачный тест, охватывающий 57 задач из различных академических и профессиональных областей. Наша оценка включает математику, право, философию, историю и многое другое. Мы обнаруживаем, что хотя современные LLM превосходят случайный выбор, их производительность далека от уровня экспертов. Более того, паттерны ошибок разнородны: модели преуспевают в одних областях (например, базовый английский), но проваливаются в других (например, логический вывод, фактическое воспроизведение), что подчёркивает множественность независимых механизмов сбоев.
Ключевой вывод: у LLM не один тип сбоев, а несколько независимых
notepad $PROFILE
Пишем туда и сохраняем

Ну и подписочку можно купить
Однако, прежде чем покупать, проверьте, будет ли у вас антигравити cli вообще работать с бесплатным аккаунтом.
Из за региональных ограничений, возможно что нет.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 2650687
Создание 27.03.26 15:00
Обновление 27.03.26 15:00
Просмотры 8856
Загрузки 0
Рейтинг
14
Комментарии 44
Код открыт Да
Рубрики Нейросети
Кому Разработчик
Тип файла Нет файла
Платформа Не имеет значения
Конфигурация Универсальные
Операционная система Не имеет значения
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)

