В прошлой части мы завели измеритель и выкинули два улучшения из трёх. А закончил я вопросом, который долго не давал мне покоя. Вот он, дословно, как записан в нашем проверочном наборе:
Какой общий механизм отвечает за запись движений документа по регистрам при проведении?
Общий механизм — это, конечно, не одна процедура, а целый набор: только в общем модуле ПроведениеДокументов их девяносто с лишним. Но у этого набора есть точка, через которую учётные механизмы пишут свои движения, — процедура ОтразитьДвижения. Её мы и разметили обязательным ответом, руками, ещё до первого прогона. А нейронка никак не хотела её давать, потому что поиск не приносил её на полку. Ни на первом месте, ни на десятом. Когда мы посмотрели глубже, оказалось, что её нет даже в первой сотне.
Вопрос короткий, ответ известный, конфигурация проиндексирована целиком. Эта часть — про то, почему так вышло, что мы пробовали и что из этого получилось. Сразу скажу честно: это история не про победу над одним вопросом. Приёмы, которые из него выросли, подняли качество на всём наборе. А сам вопрос до конца так и не сдался.
Что стояло на полке вместо ответа
Напомню, как мы меряем качество. Нейронке уходят первые десять строк выдачи, и всё, что в них не попало, для неё не существует. Эти десять строк я называю полкой.
Так вот, полка по нашему вопросу не пустовала. Она была забита процедурами, очень похожими на правильный ответ. Запись движений по регистру из расчёта себестоимости. Запись движений независимых регистров. Запись движений с контролем изменений. Процедуры в модулях документов, которые описывают учётные механизмы «для регистрации в механизме проведения». Все про движения, все про проведение, а ОтразитьДвижения среди них нет.
А теперь посмотрите на описание самой ОтразитьДвижения. В нём сказано, что она загружает данные в набор записей движений документа по указанному регистру. Ни слова про общий механизм. Ни слова про проведение. Описание честное и точное: оно рассказывает, что процедура делает внутри себя. А вопрос задан про механизм целиком и про его роль во всей конфигурации.
Это разные слова про одно и то же место конфигурации. Для человека, который знает конфигурацию, между ними нет никакой пропасти. Для поиска по смыслу — есть: отпечаток вопроса получается про роль, отпечаток описания — про устройство, и рядом они не ложатся.
Сначала посмотрели дальше десятки
Правильный ответ не попадал в десятку не только здесь. На тот момент поиск давал 0,791 — то есть промахивался на двадцати трёх вопросах из ста десяти. И первое, что мы сделали, — перестали смотреть только на полку. Для каждого промаха проверили, где правильный ответ стоит в первой сотне строк выдачи.
Картина получилась такая:
- у десяти промахов правильный ответ стоял на местах с 11-го по 50-е;
- у пяти — с 51-го по 100-е;
- у восьми его не было даже в сотне.
Наш вопрос оказался в последней группе.
Это деление важнее, чем кажется. Первая группа — ответы, которые поиск нашёл, но поставил низко. Их можно поднять, переставив строки. Последняя группа — ответы, которые поиск не нашёл вообще. Переставлять там нечего, их надо откуда-то принести. Разбор этих двадцати трёх промахов и привёл нас сразу к двум вещам: к тому, что переставляет, и к тому, что приносит. Первое дало самый большой шаг из всех, что мы делали на этом наборе.
Вторая модель, которая переоценивает первые пятьдесят
Поиск по отпечаткам устроен так: отпечаток считается для вопроса и для каждого кусочка конфигурации по отдельности, а при поиске сравниваются числа. Поэтому он быстрый. И поэтому грубый: вопрос и кандидат ни разу не встречаются лицом к лицу.
Модель-оценщик работает иначе. Она читает вопрос и кандидата вместе, парой, и решает, насколько именно этот кандидат отвечает именно на этот вопрос. Это сильно точнее и сильно медленнее, поэтому прогнать её по всей конфигурации нельзя — только по короткому списку. Отпечатки отбирают первые строки, оценщик их пересортировывает, первые десять уходят нейронке. Мы взяли открытую модель-оценщик (bge-reranker-v2-m3), она считается на той же видеокарте.
Сколько строк давать оценщику, выбирали так же, как когда-то десятку, — замером. Время — добавка на один вопрос, видеокарта NVIDIA GeForce RTX 3080 Ti:
| Сколько строк переоценивает | Качество | Время на вопрос |
|---|---|---|
| 20 | 0,791 → 0,800 | +0,14 с |
| 50 | 0,791 → 0,836 | +0,32 с |
| 100 | 0,791 → 0,855 | +0,76 с |
Взяли пятьдесят. Сотня даёт больше, но три четверти секунды на каждом запросе — это уже больше, чем мы готовы платить. На пятидесяти оценщик привёл в десятку шесть правильных ответов, которых там раньше не было, и потерял один.
А что наш вопрос? После оценщика полка поменялась и стала даже показательнее. Шесть мест из десяти заняли процедуры «параметры для проведения документа» из менеджеров регистров и общих модулей. В описании каждой прямо написано, что она работает «через общий механизм проведения». Оценщик сделал ровно то, о чём его просили: выбрал кандидатов, чей текст ближе всего к вопросу. Они рассказывают про общий механизм. А ОтразитьДвижения в первых пятидесяти не было — выбирать оценщику было не из чего.
Первая мысль: у нас же есть граф вызовов
Для ответов, которых в выдаче нет вообще, нужно что-то, что принесёт кандидатов со стороны. И первая идея лежала на поверхности. Мы как раз докручивали граф вызовов процедур: он знал, кто кого вызывает и откуда. Раз правильной процедуры в выдаче нет — может, там есть те, кто её вызывает? Нашли вызывающего, прошли по стрелке, пришли к ответу.
Для ОтразитьДвижения это выглядело особенно многообещающе. Её вызывают тридцать три процедуры из ста трёх мест. Причём тридцать две из тридцати трёх сами называются так же — ОтразитьДвижения — и отражают движения своего учётного механизма: запасов, денежных средств, взаиморасчётов, продаж, закупок, партионного учёта, НДС, ценообразования и дальше по списку.
Прежде чем писать под это код, ребята проверили идею пробой. Взяли три вопроса, где ответ — процедура, и посмотрели: попадает ли в первые пятьдесят строк выдачи хоть кто-нибудь, кто вызывает правильную процедуру или кого вызывает она сама.
Ноль. Во всех трёх случаях. У ОтразитьДвижения тридцать три вызывающих, и ни одного в первых пятидесяти.
Если подумать, это логично. Процедура, которая вызывает общий механизм, занята своим делом: запасы — запасами, взаиморасчёты — взаиморасчётами. Она пользуется механизмом, но она не про него. И чем механизм более общий, тем разнороднее те, кто его вызывает, и тем меньше любой из них похож на вопрос о самом механизме. Сосед по вызовам, «кто меня дёргает», может быть где угодно. Идти по связям вызовов просто не от кого: чтобы пройти по стрелке, нужна точка в выдаче, из которой стрелка выходит, а её нет.
Связи вызовов из этой работы ушли целиком.
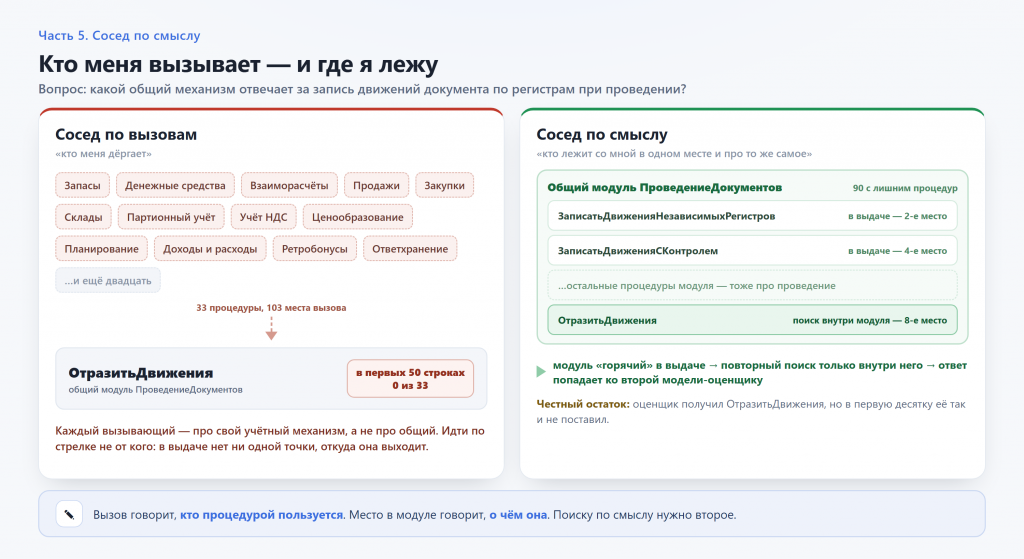 Слева — тридцать три процедуры, которые вызывают ОтразитьДвижения: каждая про свой учётный механизм, и ни одна не попала в первые пятьдесят строк выдачи. Справа — модуль, где процедура лежит: две её соседки по модулю в выдаче были, на втором и четвёртом местах. Поиск внутри модуля поставил ОтразитьДвижения восьмой из девяноста с лишним процедур.
Что в выдаче всё-таки было
А вот что бросилось в глаза, когда смотрели на ту же самую выдачу. Вызывающих в ней не было. Зато были другие процедуры того же модуля ПроведениеДокументов. Запись движений независимых регистров стояла второй. Запись движений с контролем — четвёртой. Это части того самого механизма, и на полке они стояли с самого начала. Не хватало только ОтразитьДвижения.
Сработал сосед по смыслу — «кто лежит со мной в одном месте и про то же самое».
В 1С это не совпадение, а то, как устроены конфигурации: процедуры одного механизма складывают в один модуль. Модуль ПроведениеДокументов — про проведение. Значит, если выдача раз за разом показывает на этот модуль, правильный ответ с большой вероятностью лежит в нём, даже если сам в выдачу не попал.
Так появился приём, который мы между собой называем «зум». Берём первые пятьдесят строк выдачи и считаем, какие модули встречаются в них чаще всего. Каждое появление модуля даёт ему голос, чуть больший, если строка стоит выше. Но несколько появлений всегда весят больше, чем одно, пусть даже на первом месте. Три самых «горячих» модуля берём и повторяем тот же самый поиск только внутри каждого из них — по пятнадцать кандидатов с модуля.
Внутри ПроведениеДокументов, среди девяноста с лишним процедур, ОтразитьДвижения встала восьмой. Во всей конфигурации она не попадала даже в первую сотню. Внутри модуля про проведение говорят все девяносто, и там её скромного описания хватило, чтобы войти в первые пятнадцать.
Для объектов связи уже записаны в метаданных
С процедурами сосед — это модуль. С объектами конфигурации интереснее: связи между справочниками, документами и регистрами в 1С не нужно угадывать по тексту программы. Они записаны в описании самих объектов. Мы взяли три вида таких связей:
- типы реквизитов — кто на кого ссылается через реквизит;
- владелец — какой справочник кому подчинён;
- регистр и регистратор — какой документ пишет движения в какой регистр.
Пример из нашего набора: «В каком справочнике ведётся список складов и их настройки?» Справочника складов не было даже в первой сотне. Зато среди первых пятидесяти строк шестнадцать объектов ссылались на него своими реквизитами. Шестнадцать голосов за один и тот же объект пропустить трудно — после добычи справочник встал на седьмое место.
Для реквизитов тот же зум, только внутрь двух самых горячих объектов-владельцев. «Где в соглашении с клиентом задаётся вид цен для расчёта?» — нужный реквизит соглашения встал шестым.
Добытых кандидатов мы не ставим вместо обычной выдачи. Их не больше двадцати пяти, и они добавляются сразу после тех пятидесяти строк, которые переоценивает оценщик, — дальше он сортирует всех вместе. Отсюда важная деталь: соседи работают только в паре с живым оценщиком. Без него некому решить, лучше ли добытый кандидат того, что уже стоит на полке. А если оценщик по какой-то причине не отработал, добытые просто остаются в хвосте и никого не вытесняют.
Результат на наборе: 0,836 → 0,855, плюс 0,20 секунды на вопрос. Спасены три вопроса: справочник складов, справочник характеристик номенклатуры и вид цен в соглашении. Потерян один: приходный ордер на товары стоял девятым, оценщик предпочёл добытых кандидатов и вытолкнул его за край.
Если вы читали прошлую часть — да, это тот самый закон: новый уверенный кандидат выталкивает того, кто стоял у края. Закон никуда не делся, он действует всегда. Разница с переписыванием вопроса, которое спасло семь вопросов и сломало шестнадцать, не в законе, а в том, сколько новых кандидатов приносишь и откуда. Переписывание приносило втрое больше кандидатов на каждый вопрос. Соседи приносят не больше двадцати пяти и только оттуда, куда выдача уже показывает сама.
А наш вопрос?
Тут надо быть честным до конца. ОтразитьДвижения после зума попала к оценщику. Она была среди кандидатов, которых он сортировал. И он всё равно не поставил её в десятку. Полка осталась ровно такой же, как до соседей: шесть «параметров для проведения документа», две процедуры из модуля проведения, две из расчёта себестоимости.
Почему — у меня есть объяснение, но отдельного замера по этому вопросу нет. Оценщик — тоже модель, и слова он читает так же. Рядом с кандидатом, в описании которого написано «через общий механизм проведения», кандидат со словами «загружает данные в набор записей по регистру» выглядит для него ответом на какой-то другой вопрос. Сосед довёл ответ до двери, а оценщик его не узнал.
И объяснение это не с потолка. Следующий же шаг показал, что у оценщика тот же разрыв между разговорными и официальными словами, что и у отпечатков.
Словарь, который сначала не дал ровно ничего
Словарь «разговорное → официальное» — 178 пар: сокращения, деловой жаргон, русские и английские имена модулей Библиотеки стандартных подсистем (БСП — набор готовых механизмов, который есть почти в каждой типовой конфигурации). Если в вопросе есть слово из словаря, поиск запускается ещё раз — с формулировкой, где это слово заменено официальным термином, но не больше двух формулировок на вопрос. Новые кандидаты идут к оценщику вслед за добытыми соседями.
Главное условие: словарь составляли вслепую. Его собирала отдельная нейронка по терминологии 1С:ЕРП, и наш набор вопросов ей не показывали вовсе. Иначе очень легко собрать словарь, который идеально закрывает ровно ваши сто десять вопросов и больше ничего. Такой словарь улучшает замер, а не поиск.
Первая версия дала ноль. Не «немного», а ровно ноль до третьего знака. Словарь задевал двадцать три вопроса из ста десяти, новые формулировки приносили новых кандидатов — и ни один из них не дошёл до десятки.
Стали разбираться и нашли вещь, которая объясняет и наш главный вопрос. Кандидатов, найденных по новой формулировке, оценщик сравнивал с исходным вопросом. Формулировка нашла правильный ответ в официальных словах, а оценщик прикладывал его к разговорному вопросу — и родства не видел. Тот же разрыв, только этажом выше. На одном из вопросов проба показала это прямо: по новой формулировке оценщик ставил правильному ответу высокую оценку, 0,903, а по исходному вопросу не пускал его в десятку.
Вторая версия сделала хуже. Дополнительные очки давали только новым кандидатам, которых принесла формулировка. Шум формулировок перепрыгнул через правильные ответы, которые уже сидели в списке на местах с 11-го по 50-е, и одна из мер качества просела.
Третья версия сработала. Каждого кандидата — и нового, и того, кто уже был в списке, — оценщик оценивает дважды: по исходному вопросу и по формулировке из словаря. Берётся лучшая из двух оценок. Результат: 0,855 → 0,864. Полностью спасён один вопрос: «Каким документом отражается оплата поставщику с расчётного счёта?» — формулировка назвала документ дословно, списание безналичных денежных средств. Ещё один правильный ответ поднялся с пятого места на первое. Потерь ноль, время прогона не выросло.
И тут же словарь упёрся в свой потолок. Из двенадцати оставшихся промахов слово из словаря нашлось только в трёх. Чтобы идти дальше, пришлось бы дописывать слова, подглядывая в вопросы, то есть готовиться к экзамену. Этого мы делать не стали.
Здесь я должен поправить сам себя
В прошлой части я написал, что мысль переводить разговорный вопрос в официальные слова вернулась к нам в скромном виде уже после того, как мы выкинули переписывание. Я перепутал порядок. Было наоборот: сначала словарь, и уже его потолок подтолкнул нас к большой модели. У девяти из двенадцати оставшихся промахов в вопросе не было ни одного слова из словаря. Раз так, рассудили мы, пусть официальный термин угадывает модель, которой словарь не нужен. Это и было переписывание вопроса — оно стартовало с тех самых 0,864 и уронило их до 0,782.
Лесенка целиком
Если собрать всё в одну картинку, получится исходная точка и три ступеньки над ней, и у каждой ступеньки своя цена.
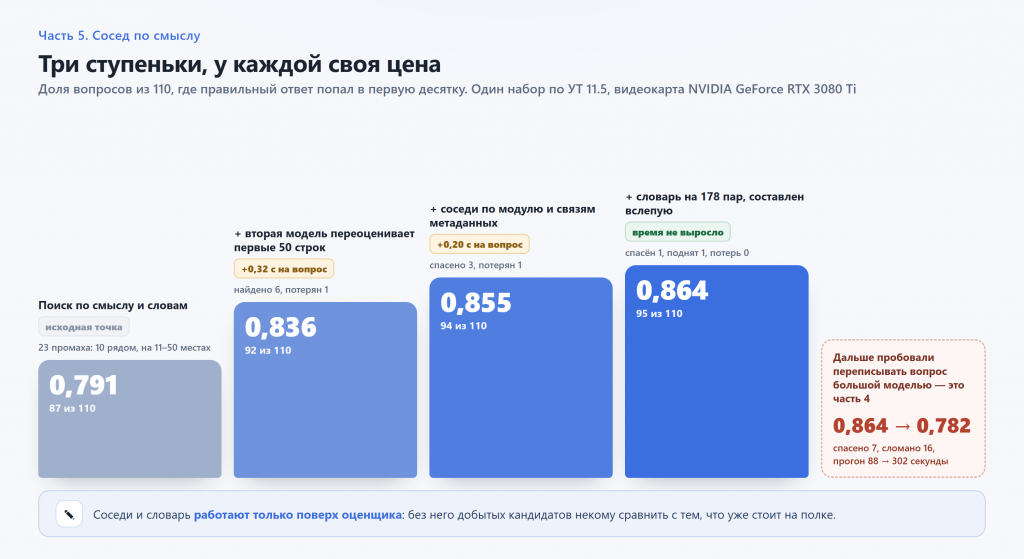 Доля вопросов из ста десяти, где правильный ответ попал в первую десятку. Поиск по смыслу и словам — 0,791 (87 вопросов). Переоценка первых пятидесяти строк второй моделью — 0,836 (92), плюс 0,32 секунды на вопрос. Соседи по модулю и по связям метаданных — 0,855 (94), плюс 0,20 секунды. Словарь на 178 пар — 0,864 (95), время не выросло. Всё — на одном наборе по УТ 11.5, видеокарта NVIDIA GeForce RTX 3080 Ti.
Оценщик в этой лесенке оказался стержнем: соседи и словарь без него не работают вовсе. Позже, когда мы переносили тот же подход на остальные своды, это подтвердилось ещё раз, и с неожиданной стороны.
Общеотраслевой истиной считается, что поиск по смыслу плюс поиск по словам строго лучше, чем поиск по смыслу в одиночку. На коде конфигурации эта смесь нам действительно помогла. А на двух сводах из четырёх без оценщика она оказалась хуже:
| Свод | Только по смыслу | Смысл и слова | Смысл и слова, плюс оценщик |
|---|---|---|---|
| Справка разработчика по платформе | 0,800 | 0,775 | 0,900 |
| Стандарты разработки | 0,975 | 0,950 | 0,975 |
| БСП по документации | 0,957 | 0,978 | 1,000 |
| БСП по исходникам | 0,857 | 0,976 | 1,000 |
С оценщиком смесь не хуже нигде. Без него — хуже на справке и на стандартах. Вывод я для себя сделал такой: прежде чем объявлять улучшение, его надо проверить на всех своих данных, а не на каких-то одних.
Что общего у всех этих шагов
Ответ почти всегда лежит рядом. Поиск по смыслу чаще находит место, чем точку: нужный модуль, соседние пятьдесят строк, другой конец реквизита. Вся эта часть — про то, как научиться дотягиваться от места до точки.
Связь должна быть про смысл, а не про использование. Вызов говорит, кто процедурой пользуется, и ничего не говорит о том, что она такое. Модуль, владелец, тип реквизита, регистр и его регистратор — говорят. В 1С с этим повезло: такие связи разработчик записывает сам, когда описывает объекты, и выводить их из текста программы не нужно.
Каждый приём лечит свой класс промахов. Оценщик — тех, кто стоит рядом. Соседи — тех, кого в выдаче нет, но чей модуль или связанные объекты в ней уже есть. Словарь — тех, в чьём вопросе есть знакомое слово. Ни один не лечит всё, и каждый мы мерили отдельно, поверх предыдущего шага. Включи мы всё разом и получи 0,864 — никогда бы не узнали, что первая версия словаря давала ноль, а вторая делала хуже.
Чем дотягиваются до ответа, который не похож на вопрос
Способов много, и победителя среди них нет. Что вообще бывает.
Спросить человека. Опытный разработчик УТ, скорее всего, ответит на наш вопрос сразу, не открывая конфигуратор. Быстрее и точнее ничего нет — пока такой человек под рукой и пока речь о типовой части. На доработке, которую другая команда сделала несколько лет назад, это уже не работает.
Поиск по именам и словам. Хорош, когда знаешь имя или его кусок. Для «общего механизма записи движений» бесполезен: в имени процедуры этих слов нет.
Поиск по смыслу. Находит место, а не точку — вся эта часть про это.
Смесь смысла и слов. На коде помогла: с ней мы и стояли на 0,791 до всех шагов этой части. На двух сводах из четырёх без оценщика навредила.
Вторая модель-оценщик. Самый большой шаг, но переставляет только то, что ей дали, и стоит долей секунды на каждом вопросе.
Соседи по связям. Нужны связи, которые про смысл. Вызовы у нас не сработали, модули и связи метаданных — сработали.
Словарь. Дешёвый и точный, быстро упирается в потолок. Честен, только когда составлен вслепую.
Переписывание вопроса моделью. На нашем наборе сломало больше, чем спасло, — подробно в четвёртой части.
Сколько это стоит
На каждом вопросе. Оценщик — плюс 0,32 секунды, соседи — плюс 0,20, словарь — ничего заметного. Всё на NVIDIA GeForce RTX 3080 Ti. Прогон всего набора из ста десяти вопросов со всеми тремя шагами — около полутора минут.
Проба графа вызовов. Три вопроса и одна проверка выдачи закрыли идею раньше, чем под неё написали код. Отказ мы записали отдельно, вместе с причиной: идея выглядит бесплатной и напрашивается сама, и без такой записи её рано или поздно предложили бы снова.
Словарь. Сто семьдесят восемь пар собрала отдельная нейронка. Всё остальное — три версии подсчёта оценок, каждая со своим прогоном набора, и две из трёх не сработали.
Чего я не измерял
Почему оценщик не берёт ОтразитьДвижения. Выше — объяснение, а не замер. Вполне может быть, что дело не только в словах описания, но и в том, как много рядом конкурентов с почти одинаковым текстом.
Хватило бы нейронке частей механизма. Две процедуры из ПроведениеДокументов стояли на полке на каждом шаге этой части. Смогла бы нейронка сложить из них внятный ответ про механизм, я не проверял: замер засчитывает вопрос, только когда на полке ОтразитьДвижения.
Вызовы на других вопросах. Проб было три, и все — про поиск процедуры по описанию её роли. Для вопросов вида «что сломается, если поменять эту процедуру» вызовы, наоборот, главное. Но это уже другая задача, не поиск по смыслу.
Другие конфигурации. Всё посчитано на УТ 11.5. В 1С:ЕРП процедур и модулей заметно больше, и как там поведёт себя зум, я не проверял.
Словарь для других конфигураций. Он собран по терминологии 1С:ЕРП, а мерили мы его на УТ. Как он сработает на бухгалтерии или зарплате, не знаю.
Почему смесь смысла и слов вредит на справке и стандартах. Замер это показал, а глубоко причину мы не разбирали: с оценщиком просадка закрылась, и копать дальше не стали.
Что было дальше
Эти приёмы довели нас до 0,864, и дальше мы долго жили на цифрах такого порядка.
А потом, после очередного пакета доработок, выкаченного в тестовую среду, замер по торговому набору выдал 0,073. Обвал больше чем в десять раз. Две недели работы оказались под угрозой, и было совершенно непонятно, где мы просчитались.
Но об этом — в следующий раз.
Если вы попали сюда с середины: первая часть — про то, почему нейронка выдумывает несуществующие процедуры, вторая — про день, когда всё получилось с первого захода, третья — про то, почему тот же приём не завёлся у команды, а четвёртая — про три очевидных улучшения, два из которых сделали хуже.
Вопрос к вам: когда вы ищете в чужой конфигурации процедуру, имени которой не знаете, — с чего начинаете: с модуля, с регистра или с того, кто её вызывает?
Вступайте в нашу телеграмм-группу Инфостарт