После обновления конфигурации база 1С перестала открываться. Как мы вытащили её через ibcmd без копии
База данных - Архивирование (backup)


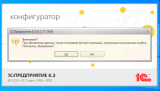
20 октября в 07:13 я запустил обновление конфигурации в рабочей базе ITEL. Через 15 секунд обновление упало, конфигуратор при входе стал спрашивать "При обновлении данных, после последней реструктуризации, произошла критическая ошибка. Повторить обновление?", а пользователи в базу больше не попадали.
В 08:10 люди снова работали. Данные не потеряли. Базу вытащили так: выгрузили в .dt через ibcmd прямо из базы, которая не открывалась, загрузили в новую базу на SQL Server и переключили на неё имя в кластере 1С. Сами выгрузка и загрузка заняли шесть с небольшим минут. Большая часть остального часа ушла на тупики.
Копии "до обновления" не было. Это главная ошибка, и она общая: моя и ИИ-агента Claude, который работал со мной на сервере.

Что за база
Платформа 8.3.17.1549, клиент-серверный вариант, кластер и MS SQL Server 2019 на одном сервере. Конфигурация "Розница для Казахстана" 2.2 с доработками, данных около 3,5 ГБ. Около десяти пользователей работают через удалённый рабочий стол (RDP) прямо на этом сервере, тонким клиентом. Регламентное задание гоняет обмен с маркетплейсом.
На том же сервере под администратором стоял Claude Code. У него был доступ к SQL Server, к rac, 1cv8 и ibcmd.
Накануне Claude нашёл, что бэкапов нет
19 октября я разбирался, почему тормозит 1С. Причину Claude нашёл в тот же день: форма списка заказов с таймером на 30 секунд. Но в том же вечернем отчёте он записал и другое: последняя резервная копия ручная, от 25 сентября; база в полной модели восстановления без копий журнала, поэтому журнал транзакций дорос до 48 ГБ; заданий обслуживания нет вообще.
Скрипты резервного копирования и обслуживания он подготовил. Запускать их не стали, отложили до решения. Решение было за мной.
На утро 20 октября стояло обновление конфигурации. Обновляли, кстати, ради MCP-сервера в базе, то есть HTTP-сервиса, через который нейросеть ходит в 1С. Для того же Claude.
Как упало
Обновление запускал я сам, в конфигураторе. Claude его не выполнял. По журналу регистрации картина такая:
07:13:03  DBConfigUpdateStart       начало обновления конфигурации БД
07:13:09  PredefinedDataUpdate      "Выполняется обновление предопределенных данных"
07:13:18  DBConfigUpdateError       текста ошибки нет
В такой ситуации это первое, что надо выяснить: реструктуризация прошла. Упал следующий этап, обновление предопределённых данных. Текста ошибки платформа не записала.
В 07:19 по моей просьбе Claude сделал полную копию базы на SQL Server, уже сломанной. Заняло 23 секунды. Отката до обновления она не давала. Она давала другое: любой следующий шаг можно было отменить.
Что не помогло и почему
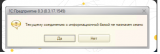
Перезапуск агента сервера 1С. Это была подсказка Claude: очистить серверный кэш. Я перезапустил службу агента сервера при открытом конфигураторе, и конфигуратор потерял сеанс:

Минут пятнадцать после этого мы разбирались с ошибкой, которую создали сами. Старый процесс ragent ещё и упал при остановке.
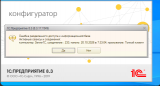
Повтор обновления. Первый ответ "Да" оборвал наш же перезапуск агента сервера. При следующей попытке мешал тонкий клиент пользователя, который сам переподключился к базе:

Пакетный конфигуратор. 1cv8 DESIGNER /UpdateDBCfg отработал за 4 секунды и написал в лог одну строку: Infobase structure error.
Запрет регламентных заданий в консоли кластера. Не ставится: "Обнаружена незавершенная операция сохранения конфигурации". Этот флаг хранится в самой базе, а база не открывается. Блокировка сеансов ставится, она хранится в кластере.
Перезагрузка сервера в 07:40. Ошибка та же. Состояние сбоя записано в самой базе, перезагрузка его не трогает.
Три совета со стороны. Я приносил Claude советы из другой ИИ-сессии и из интернета. Снять лимиты памяти кластера: лимиты и так нулевые, рабочие процессы не падали. Перезапустить SQL Server: зависших сеансов 1С в нём не было. Третий совет пришёл из статьи про похожий сбой, и к нашему случаю он не подошёл. Каждый совет Claude сначала проверял по факту и только потом предлагал выполнять. Ни один не понадобился.
Apply через ibcmd. В 07:48 Claude нашёл в поставке платформы ibcmd: он работает с базой сам, без кластера и без сеансов. ibcmd infobase config apply ответил [FATAL] Обнаружена незавершенная операция сохранения конфигурации. Признак незавершённой операции хранится в самой базе, и штатного способа снять его на сломанной базе у платформы нет. Лезть в служебные таблицы мы не стали бы советовать никому.
Дальше вслепую ничего не трогали. Claude предложил бросить попытки починить старую базу изнутри и идти вперёд через выгрузку. По-моему, это лучшее решение того утра.
Что сработало: .dt из базы, которая не открывается
ibcmd выгружает базу, даже когда конфигуратор и клиент в неё не пускают: ему не нужен ни кластер, ни сеанс. Выгрузка заняла 105 секунд, файл 438 МБ. Имена сервера и баз ниже условные:
:: 1. Выгрузка в .dt из неоткрывающейся базы
ibcmd infobase dump --dbms=MSSQLServer --db-server=Server1C --db-name=DB01 ^
      --db-user=<sql_user> --db-pwd=<sql_pwd> D:\Backup\DB01_20261020.dt

:: 2. Новая база на SQL Server из этой выгрузки
::    date-offset=2000, как у исходной базы
ibcmd infobase create --dbms=MSSQLServer --db-server=Server1C --db-name=DB01_new ^
      --db-user=<sql_user> --db-pwd=<sql_pwd> --locale=ru_RU --date-offset=2000 ^
      --create-database --restore=D:\Backup\DB01_20261020.dt
Вторая команда работала 274 секунды. В нашей 8.3.17 у ibcmd нет параметра пользователя 1С, он работает на уровне СУБД, поэтому в командах только логин SQL.
Почему новая база открылась, а старая нет, я до конца не знаю. Что именно осталось сломанным в старой, мы так и не выяснили. В .dt уходят конфигурация и данные, а новая база собирается из них с нуля, и этого хватило.
Новую базу сначала зарегистрировали в кластере под тестовым именем и сразу запретили в ней регламентные задания, чтобы обмен с маркетплейсом не пошёл из двух баз одновременно:
:: 3. Тестовая регистрация, база СУБД уже есть, поэтому без --create-database
rac infobase create --cluster=<id> --name=Base01_new --dbms=MSSQLServer --db-server=Server1C ^
    --db-name=DB01_new --locale=ru --db-user=<sql_user> --db-pwd=<sql_pwd> ^
    --license-distribution=allow localhost:1545
rac infobase update --cluster=<id> --infobase=<id_new> ... --scheduled-jobs-deny=on localhost:1545
Проверка: пакетный конфигуратор с /UpdateDBCfg вернул код 0, а я зашёл в Base01_new в режиме Предприятия и посмотрел данные своими глазами. С базой всё было в порядке.
Переключение сделали так, чтобы у пользователей ничего не менялось: их строка подключения по-прежнему смотрит на Base01, а под этим именем в кластере теперь новая база СУБД.
:: 4. Убрать тестовую регистрацию, сама база СУБД остаётся
rac infobase drop --cluster=<id> --infobase=<id_new> ...
:: 5. Старому имени дать новую базу СУБД
rac infobase update --cluster=<id> --infobase=<id_Base01> ... --db-name=DB01_new localhost:1545
:: остановить RAS (сервер администрирования кластера) и агент сервера, удалить srvinfo\reg_1541\snccntx*, запустить агент, затем RAS
:: 6. Снять блокировки
rac infobase update ... --scheduled-jobs-deny=off --sessions-deny=off --permission-code=""
В 08:10 пользователи работали. Простой от сбоя до этой минуты 57 минут. Данные не потеряли, потому что после 07:13 в базе никто ничего не вводил. Старую базу DB01 оставили на SQL Server страховкой.
Ошибки Claude, по порядку цены
Первая и главная: накануне он сам нашёл, что копий нет, и подготовил скрипты. Отложить их решил я. Но утром перед обновлением Claude знал про эту дыру и не настоял на копии. Копию не сделал никто.
Вторая: совет перезапустить агент сервера 1С. При открытом конфигураторе это добавило ошибку "не назначен сеанс" и пятнадцать минут путаницы.
Уже после аварии Claude включал технологический журнал и поставил порог длительности в микросекундах. А duration в logcfg.xml задаётся в десятитысячных долях секунды (проверяли на 8.3.17), и за десять минут журнал не записал ничего. Заметил это Claude сам и исправил.
Делили мы работу так. Каждое изменение на рабочей базе шло только после моего "да", кнопки в конфигураторе и консоли кластера нажимал я, в Предприятии базу проверял тоже я. Claude читал то, что мне быстро не прочитать: журнал регистрации, журналы Windows, вывод rac. Он проверял чужие советы до того, как их выполнять, и выполнял длинные команды. Решения на продуктиве оставались за мной.
Что поменяли после
В тот же день Claude завёл задания SQL Server Agent: полная копия каждый день в 23:00, копия журнала каждый час, статистика, индексы, проверка целостности. Хранение 14 дней на отдельном диске. Теперь базу можно поднять на любой момент за две недели, в том числе на минуту до обновления.
22 октября было ещё два изменения в той же базе, обновление формы и пересчёт итогов. Перед каждым Claude сначала делал копию.
Если это случилось у вас
- Не перезапускать агент сервера 1С при открытом конфигураторе и не перезагружать сервер в надежде, что пройдёт. Сбой записан в базе, а перезапуск только добавит "не назначен сеанс".
- Сразу сделать полную копию текущего состояния базы, даже сломанного.
- Один раз чисто повторить обновление: заблокировать начало сеансов в консоли кластера с кодом разрешения и зайти в конфигуратор с
/UCи этим кодом. - Не помогло - открыть журнал регистрации и найти, на каком этапе упало. Если структура уже применена, не тратить время на починку старой базы изнутри:
ibcmd infobase dump, затемibcmd infobase create --restoreв новую базу, проверка под тестовым именем, переключение имени в кластере. - Старую базу СУБД не удалять, пока новая не проработает неделю.
И раньше всех этих пунктов: копия перед обновлением. Без неё откат невозможен, остаётся только путь вперёд.
Как проверить у себя до обновления
Отчёт Claude 19 октября про копии был, и копию всё равно не сделали. Отчёт сам ничего не решает, решает правило: без свежей копии обновление не запускаем. Проверить это правило за минуту на любой базе, без ИИ на сервере, можно обработкой Чек-ап СУБД под 1С. Она показывает, сколько часов назад сделана последняя полная копия базы, и отдельной строкой ловит полную модель восстановления без копий журнала, с вердиктом "чинить". Ровно эти две дыры были у нас. На том сервере мы её не запускали, Claude дошёл до них сам.
Мне интересно, как это устроено у вас. Перед обновлением конфигурации копию делает человек или регламент? И встречал ли кто-нибудь эту "критическую ошибку после реструктуризации" на платформах новее 8.3.17?
Обработка из этой статьи: Чек-ап СУБД под 1С.
Другие наши инструменты для администратора 1С:
- Журнал транзакций переполнен - если журнал транзакций дорос до десятков гигабайт, как наши 48 ГБ: показывает, что его держит и что с этим делать.
- Журнал регистрации для нейросети - именно по журналу регистрации мы поняли, на каком этапе упало обновление. Обработка задаёт журналу готовые вопросы и не читает его целиком.
- Повреждение базы 1С на MS SQL - другой класс аварии: проверка целостности нашла ошибки. Показывает, какие объекты 1С задеты и что поднимать из копии.
- Чек-ап сервера 1С - нам советовали снять лимиты памяти кластера, а они и так были нулевые. Чек-ап сервера показывает такие настройки кластера и рабочих процессов одним списком, с последствием по каждой.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.


