Разбор XML документа - почти все возможные способы
Интеграция - Файловый обмен (TXT, XML, DBF), FTP

Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
При обмене данными, как бы он не производился ( через файлы, через HTTP запросы или еще каким либо другим путем ) все равно основным форматом обмена является XML. В 1С существует несколько способов обработки XML документов – какой из них выбрать по критерию логической простоты и быстродействия? Для практической проверки различных методов был создан XML документ вида

Задачей всех проверяемых методов было получение из XML файла массива, состоящего из структур со свойствами Номер, Дата, Поставщик, Состав, причем свойство Состав само является массивом структур со свойствами Номенклатура и Количество.
Первый метод – простое последовательное чтение XML.


Текущее положение в XML документе отслеживается в переменной ТекущийПуть и при поступлении текстового узла на основании этой переменной заполняются (или игнорируются) соответствующие данные 1С. Конечно, не совсем корректно оценивать логическую сложность программы в строках исходного текста, но тем не менее это самый большой объем из всех методов - 64 строки. Что касается быстродействия (оно проверялось на компьютере памятью в 8 Гб и процессором Intel i7 2.2 Ггц, было создано два файла один на 10 тысяч записей объемом 10 мегабайт, другой на 100 тысяч и 100 мегабайт соответственно) , то на файле 10 000 записей полная обработка заняла 30 секунд и на файле в 100 мегабайт линейно увеличилась в 10 раз.
Второй метод – получение из XML файла документа DOM и последовательный перебор всех узлов полученного документа


Логически этот метод весьма незначительно проще прямого ЧтенияXML (57 строк кода против 62), а вот с быстродействие картина интересная: для файла в 10 тысяч записей быстродействие составило 12 секунд (быстрее более чем в два раза) , но для файла со 100 тысячами записей резко поднялась до 1000 секунд (медленнее более чем в три раза).
Третий метод подобен второму, но вместо последовательного перебора узлов применен отбор требуемых узлов в DOM документе с помощью выражений XPath .


Этот метод немного проще чем простой перебор узлов в DOM документе, но быстродействие … При 10 000 записей 69 секунд , а для 100 000 обработка длилась более часа, так и не завершилась, после чего была снята принудительно.
Очевидно метод с использованием DOM, в особенности при поиске узлов документа XPath выражениями, надо использовать только для небольших изменений DOM документа со сложной структурой узлов.
Все последующие методы используют для разбора XML документа фабрику XDTO.
Четвертый метод использует метод ПрочитатьXML глобальной ФабрикиXDTO. При этом тип получаемого объекта не указывается, его определяет сам метод фабрики. Тут есть маленькая тонкость – в случае, если тип получаемого объектаXDTO не указан, фабрика не всегда может самостоятельно определить что она получила одиночный объект или список из нескольких одинаковых объектов ( в нашем примере если ПриходныйОрдер в XML документе будет один фабрика посчитает что ПриходыXDTO.ПриходныйОрдер это одиночный объект а не список).


Данный метод не только заметно проще, чем все предыдущие, но и показывает отличное быстродействие на 10 000 записях 4,6 секунды, а при 100 000 обработка длится 46 секунд. Что показывает линейную зависимость от объема обрабатываемого файла.
Пятый метод схож с предыдущим, но глобальной фабрике XDTO подается на вход не только сам XML документ, но и его тип. Этот тип берется из ветки конфигурации XDTO-пакеты. (Если те кто передает вам XML данные хорошие люди, то они должны передать вам и XML схему данных – файл с расширением .xsd из которого вы и создаете в своей конфигурации XDTO-пакет – команда импорт XML схемы …, если нет требуемый пакет обычно не сложно создать вручную, анализируя переданные XML данные).

Один нюанс – частенько XML данные передают без указания URI пространства имен ( атрибут xmlns). Если это так, то необходимо самому добавить недостающий атрибут в XML данные, что и делают первые три оператора процедуры.
Метод замечательный, как по простоте создания, так и по быстродействию – 3,1 секунды на 10 000 записях.
И последний метод. Это скорее некоторая модификация пятого метода, но для условия, что не используется объект конфигурации XDTO-пакет, и фабрика XDTO создается на ходу из текстового описания XML схемы. (Примечание 1-Конечно можно загнать схему в текстовый макет, и оттуда уже использовать, но для учебной программы так нагляднее. 2-Текстовый вариант XML схемы можно например получить создав XDTO-пакет в любой конфигурации XDTO-пакет и выполнив команду Экспорт XML схемы..)


В прилагаемой конфигурации все методы разбора XML представлены в общей команде РазобратьXML, там же в другой общей команде СоздатьXML представлены средства для создания тестовых данных.
Вступайте в нашу телеграмм-группу Инфостарт
См. также
Перенос данных 1C Файловый обмен (TXT, XML, DBF), FTP Системный администратор Разработчик 1С:Предприятие 8 1С:Комплексная автоматизация 1.х 1С:Управление производственным предприятием 1С:Бухгалтерия 3.0 Россия Бухгалтерский учет Платные (руб)
Перенос данных из 1С:Управление производственным предприятием 1.3 в 1С:Бухгалтерия предприятия 3.0 с помощью правил обмена | Можно выполнить переход с УПП на БП 3 или запускать выгрузку данных за выбранный период времени | Переносятся документы, начальные остатки и вся справочная информация | Есть фильтр по организации и множество других параметров выгрузки | Поддерживается несколько сценариев работы: как первичный полный перенос, так и перенос только новых документов | Перенос данных возможен в "1С: Бухгалтерия 3.0" версии ПРОФ, КОРП или базовую | Переход с "1С: УПП1.3" / "1С:КА 1.1" на "1С:БП3.0" с помощью правил конвертации будет максимально комфортным! | Можно бесплатно проверить перенос на вашем сервере!
55050 руб.
25.02.2015 192699 385 296
SALE! 10%
Перенос данных 1C Файловый обмен (TXT, XML, DBF), FTP Системный администратор Разработчик 1С:Предприятие 8 1С:Розница 2 1С:Управление нашей фирмой 1.6 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Розница 3.0 Россия Платные (руб)
Правила в универсальном формате обмена для ERP 2.5, ERP 2.6, КА 2.5, КА 2.6, УТ 11.5, УТ 11.6, БП 3.0, Розница, УНФ, для последних версий конфигураций. Ссылки на другие конфигурации в описании публикации. Правила совместимы со всеми другими версиями конфигураций новыми и старыми, поддерживающими обмен и синхронизацию в формате EnterpriseData. Не требуется синхронного обновления правил после обновления другой конфигурации, участвующей в обмене. Типовой обмен через планы обмена кнопкой Синхронизация вручную или автоматически по расписанию, или вручную обработкой.
27633 руб.
12.06.2017 165260 1009 329
Перенос данных 1C Взаиморасчеты Оптовая торговля Логистика, склад и ТМЦ Файловый обмен (TXT, XML, DBF), FTP Системный администратор Разработчик 1С:Предприятие 8 1С:Управление торговлей 10 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Россия Управленческий учет Платные (руб)
Можно проверить до покупки, оставьте заявку! Воспользовались более 268 компаний! Перенос данных из УТ 10.3 в УТ 11 | из УТ 10.3 в КА 2 | из УТ 10.3 в ERP. Решение для перехода с УТ 10.3. Можно перенести начальные остатки, нормативно-справочную информацию и все возможные документы. При выгрузке можно установить отбор по периоду, организациям и складам.
55200 руб.
24.04.2015 211565 186 254
Загрузка и выгрузка в Excel Маркетплейсы Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1С:Розница 2 1С:Управление нашей фирмой 1.6 1С:ERP Управление предприятием 2 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Россия Бухгалтерский учет Управленческий учет Платные (руб)
Реальный помощник, с помощью которого Вы преобразуете необходимые документы для Wildberries, OZON, ЯндексМаркет, ЛаМода, Мегамаркет, Aliexpress, Детский мир, Магнит Маркет (быв.МагнитЭкспресс), Лемана про, ЭНФАНТА (Акушерство), Летуаль, Твой дом, Золотое Яблоко, Каспи, Авито, Аптеки+, М.Видео,Тинькоф в документы "Отчет комиссионера (агента) о продажах" и другие. Работает в 1С:БП 3.0, 1С:БП 3.0 КОРП, 1С:УТ 11, 1С:УНФ, 1С:ERP.
5490 руб.
12.08.2021 48524 654 71
SALE! 10%
Перенос данных 1C Файловый обмен (TXT, XML, DBF), FTP Системный администратор Разработчик 1С:Предприятие 8 1С:Управление производственным предприятием 1С:Бухгалтерия 3.0 Россия Бухгалтерский учет Управленческий учет Платные (руб)
Переносите справочную информацию, остатки и документы из УПП 1.3 в Бухгалтерию 3.0 с помощью готовых правил. Переносится более 50 видов документов. Простой интерфейс и понятные настройки.
42000
37800 руб.
15.12.2021 37244 270 68
Загрузка и выгрузка в Excel Маркетплейсы Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1С:Управление торговлей 10 1С:ERP Управление предприятием 2 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Розница 3.0 Бухгалтерский учет Платные (руб)
Обработки загрузки данных о продажах WildBerries предназначены для следующих конфигураций: Бухгалтерия предприятия, редакция 3.0; Управление нашей фирмой, редакция 3.0; Розница, редакция 3.0; Управление торговлей, редакция 11; Управление торговлей, редакция 10.3
6000 руб.
11.12.2019 68100 1163 3
SALE! 10%
Перенос данных 1C Файловый обмен (TXT, XML, DBF), FTP Разработчик 1С:Предприятие 8 1С:Управление производственным предприятием 1С:ERP Управление предприятием 2 Бухгалтерский учет Управленческий учет Платные (руб)
Переносите справочную информацию, остатки и документы из УПП 1.3 в ERP 2.6 и КА 2.6 с помощью готовых правил. Переносится более 60 видов документов. Простой интерфейс и понятные настройки.
42000
37800 руб.
24.06.2020 73325 108 35
Перенос данных 1C Файловый обмен (TXT, XML, DBF), FTP Разработчик 1С:Предприятие 8 1С:Комплексная автоматизация 1.х 1С:Управление производственным предприятием 1С:Зарплата и Управление Персоналом 3.x Россия Бухгалтерский учет Платные (руб)
Правила переноса кадровых и расчетных данных и справочной информации из "1С:УПП1.3" или "1С:КА 1.1" в "1С:ЗУП 3.1 | Разработан в формате КД 2 (правила конвертации данных) | При выгрузке есть фильтр по организациям | Обновляется при выходе новых релизов 1С | Развитие алгоритмов | Расчетные документы переносятся в документ "Перенос данных" | Создаются документы "Начальная штатная расстановка" и "Начальная задолженность по зарплате", переносятся кадровые документы
63000 руб.
29.10.2018 64548 87 137
1. Из файла выделяются блоки (у меня называются "offer"), которых может быть до нескольких сотен тысяч. Делается это через чтение текста с разделителем.
// Чтение файла по блокам <offer>...</offer>
Файл = Новый ЧтениеТекста(ИмяФайла, , "</offer>");
ТекСтрока = Файл.ПрочитатьСтроку();
Пока ТекСтрока <> Неопределено Цикл
     // Обработка блока
    ТекСтрока = Файл.ПрочитатьСтроку();
2. Каждый блок разбирается с помощью регуляного выражения <ИмяСвойства>(.*?)</ИмяСвойства>
Последний файл размером 460 Мб, обработал за 2 минуты. Но тут надо учитывать, что обработка включала в себя еще чтение/запись в БД.
Памяти такой метод практически не потребляет, правда плохо подходит для файлов со сложной структурой (большим уровнем вложенности)
Преимущество XML документа, в том что это широко используемый международный стандарт
На данный момент написал такое:
	Файл = Новый ЧтениеТекста(ФайлХМЛ,КодировкаТекста.UTF8, "</offer>");
	ТекСтрока = Файл.ПрочитатьСтроку();
	Пока ТекСтрока <> Неопределено Цикл

		ТекСтрока = СокрЛП(Файл.ПрочитатьСтроку());
		ТекСтрока = ТекСтрока + "</offer>";
		Сч = Сч+1;
		ЧтениеХМЛ = Новый ЧтениеXML;
		ПараметрыЧтенияХМЛ = Новый ПараметрыЧтенияXML(,,,,,,,,Истина,Истина);
		ЧтениеХМЛ.УстановитьСтроку(ТекСтрока,ПараметрыЧтенияХМЛ);

		ПостроительDOM = Новый ПостроительDOM();
		ДокументDOM = ПостроительDOM.Прочитать(ЧтениеХМЛ);
		ЧтениеХМЛ.Закрыть();

		Списокoffer=ДокументDOM.ПолучитьЭлементыПоИмени("offer");
		Для Каждого НоменклатураУзел ИЗ Списокoffer Цикл
                 //Тута делаем все что нужно
              КонецЦикла;
         КонецЦикла;
Показать РезультатРазборки = Новый Массив;
ТипПриходныйОрдерXDTO = ФабрикаXDTO.Тип("http://localhost/testXML","ПриходныйОрдер");
Пока ЧтениеXML.Прочитать() Цикл
Пока ЧтениеXML.ТипУзла = ТипУзлаXML.НачалоЭлемента И ЧтениеXML.Имя = "ПриходныйОрдер" Цикл
ПриходныйОрдерXDTO = ФабрикаXDTO.ПрочитатьXML(ЧтениеXML,ТипПриходныйОрдерXDTO);
ДокументПриходныйОрдер = Новый Структура("Номер,Дата,Поставщик,Состав");
ДокументПриходныйОрдер.Номер = ПриходныйОрдерXDTO.Номер;
ДокументПриходныйОрдер.Дата = ПриходныйОрдерXDTO.Дата;
ДокументПриходныйОрдер.Поставщик = ПриходныйОрдерXDTO.Поставщик;
ДокументПриходныйОрдер.Состав = Новый Массив;
Для Каждого СтрокаСоставаXDTO Из ПриходныйОрдерXDTO.Состав.СтрокаСостава Цикл
СтрокаСоставаСтруктура = Новый Структура("Номенклатура,Количество");
СтрокаСоставаСтруктура.Номенклатура = СтрокаСоставаXDTO.Номенклатура;
СтрокаСоставаСтруктура.Количество = СтрокаСоставаXDTO.Количество;
ДокументПриходныйОрдер.Состав.Добавить(СтрокаСоставаСтруктура);
КонецЦикла;
РезультатРазборки.Добавить(ДокументПриходныйОрдер);
КонецЦикла;
КонецЦикла;
ПоказатьВ принципе то же самое, только позволяет несколько сэкономить память при последовательном чтении XML
Работа с DOM самая тяжелая операция из всех методов разбора XML, явное увеличение быстродействия может дать работа с фабрикой XDTO
В пакете XDTO создайте тип category и добавте к нему три свойства - id,parentId и text (впрочем третье имя может быть любым), для первых двух свойств установите Форма - атрибут, а для третьего Форма - текст. Тогда фабрика XDTO поймет строку вида <category id="85115" parentId="85354">Платья и сарафаны</category>
Не совсем, точнее совсем, непонятно пример чего?
Как программно!! (без изменения конфигурации) создать или модифицировать пакет xdto, чтобы можно было прочитать и атрибуты и само содержимое тега?
(43), (44), использовал, но может некорректную схему написал - все равно не видит. Вот мой код,
, а в аттаче пример файла.
В схеме использовал разные варианты, но ни один не видел текст, который между тегами, но прекрасно видит атрибуты.
В последнем примере статьи фабрика XDTO создается программно из строки. тут и надо указывать требуемые элементы пакета
Получается следующее при нижеприведенном коде и слегка расширенном тестовом XML:
Начали чтение ХМЛ
Контрагент № 1, Наименование учредители
Контрагент № 2, Наименование Фирма1
Договор № 3, Наименование Основной договор
Контрагент № 5, Наименование Последний без подчиненных договоров!
Прочитали ХМЛ
Код обработки (кол. атрибутов "N" теперь 5 и в последнем тоже нет подчиненных узлов с договорами). Тут сразу тоже вопрос: есть ли методы "по-человечески" проверить наличие подчиненного узла (или просто узла по имени? При такой конструкции мы сваливаемся по ошибке при делении на ноль без каких-либо сообщений.
Процедура ТестXDTO() Экспорт
	Попытка
		ЧтениеТекста = Новый ЧтениеТекста(ПутьЗагрузки, КодировкаТекста.UTF8);
		СтрокаXML = ЧтениеТекста.Прочитать(); // Для проверки технологии XDTO читаем до конца, а не порциями
		СтрокаXML = СтрЗаменить(СтрокаXML, "<ROOT", "<ROOT xmlns=""http://localhost/testXML"" ");

		ЧтениеXML = Новый ЧтениеXML;
		// Ниже в УстановитьСтроку(<СтрокаXML>, <Параметры>, <НаборСхемXML>) - ТРИ ПАРАМЕТРА!
		//Набор схем XML, используемых при проверки читаемого документа XML.
		//Если набор схем указан, но не проверен и включена проверка документа XML,
		//то будет выполнена проверка набора схем.
		ЧтениеXML.УстановитьСтроку(СтрокаXML); //<НаборСхемXML> - Вопрос заодно про третий параметр и его смысл, т.к. в статье описан другой прием

		РезультатРазборки = Новый Массив;
		ЧтениеXMLСхемы = Новый ЧтениеXML;
		Макет = ПолучитьМакет("схемаXSD");
		СтрокаXSD = Макет.ПолучитьТекст(); // Макет текстовый!
		ЧтениеXMLСхемы.УстановитьСтроку(СтрокаXSD);
		ПостроительDOM = Новый ПостроительDOM;
		ДокументDOM = ПостроительDOM.Прочитать(ЧтениеXMLСхемы);
		ПостроительСхемXML = Новый ПостроительСхемXML;
		СхемаXML = ПостроительСхемXML.СоздатьСхемуXML(ДокументDOM);
		НаборСхемXML = Новый НаборСхемXML;
		НаборСхемXML.Добавить(СхемаXML);

		СвояФабрикаXDTO = Новый ФабрикаXDTO(НаборСхемXML);
		ТипКореньXDTO = СвояФабрикаXDTO.Тип("http://localhost/testXML",    "ROOT");

		КореньXDTO = СвояФабрикаXDTO.ПрочитатьXML(ЧтениеXML, ТипКореньXDTO);
		//
		Сообщить("Начали чтение ХМЛ");
		Узлы = КореньXDTO.KON;
		Для каждого Узел из Узлы Цикл
			Сообщить("Контрагент № "+Узел.N+", Наименование "+Узел.Наименование); // Обработка контрагента как структуры
			Попытка
				Узлы = Узел.DOG;
				Для Каждого Узел из Узлы Цикл
					Сообщить(""+Символы.Таб+"Договор № "+Узел.N+", Наименование "+Узел.Наименование); // Обработка всех договоров (если есть) контрагента как подчиненных узлов
					F = 1/0; // Модель ошибки!
				КонецЦикла;
			Исключение
				А=1; // Нет узла! Пропускаем!
			КонецПопытки;
		КонецЦикла;
		Сообщить("Прочитали ХМЛ");
	Исключение
		Инф = ИнформацияОбОшибке();
		Сообщить(ПодробноеПредставлениеОшибки(Инф) );
	КонецПопытки;

КонецПроцедуры ПоказатьПозже приходит на ум "заплатка":
Попытка
				Узлы = Узел.DOG;
			Исключение
				Продолжить; // Нет узла! Пропускаем!
			КонецПопытки;
Тестовая ошибка будет диагностирована правильно (например тег/атрибут отсутствует).
Контрагент № 1, Наименование учредители
Договор № 1, Наименование учредители
{ВнешняяОбработка.тестТехнологииЧтенияXMLЧерезXDTO.МодульОбъекта(43)}: Деление на 0
F = 1/0; // Модель ошибки!
Кстати, получается не вижу разницы - объектXDTO можно передавать в процедуры дальше как структуру - тоже большой плюс.
Осталось только запись откатать :) Исправленную версию обработки с файлов XML прилагаю (схема не менялась).
тестТехнологииЧтенияXMLЧерезXDTO.epf
Вопросы:
1. Что не так (может отдельными методами нужно по чтению ХМЛ)? Или еще как-то?
2. Почему все-таки схема xsd не грузится в конфигуратор? Статьи по фабрике и схемам читал, но там не все понятно. Метод интересен, т.к. быстрота чтения и также фабрику XDTO использует перспективная технология веб-сервисов и прочие.
3. Можно ли как-то читать с сохранением быстроты методики фабрики XDTO файлы большого размера без преобразования их заголовков методами СтрЗаменить для добавления в тег http:\\<Что-то непонятное с locajhost> и также смысл этих адресов-имен? На редактирование же требуется время, а на передающей стороне из-за таких конструкций очень сильно возрастает размер файла?
4. Можно ли как читать все это дело (по контрагенту все его договора) как при последовательном чтении.
5. Не проверял еще, но не будет ли при такой технологии переполняться ОЗУ на очень-очень больших файлах (1-2 Гб) - Хоть тут и последовательное чтение методом ЧтениеТекста "за раз" (я про ДокументDOM)?
Вот сообщение об ошибке:
ТестСтрока Контрагенты: N=2, Фирма1
{ВнешняяОбработка.тестТехнологииЧтенияXMLЧерезXDTO.МодульОбъекта(38)}: Ошибка при вызове метода контекста (ПрочитатьXML)
ДоговорыXDTO = СвояФабрикаXDTO.ПрочитатьXML(ЧтениеXML, ТипДоговорXDTO); // НА ЭТОЙ СТРОКЕ ОШИБКА!!!
по причине:
Ошибка при вызове метода объекта модели XDTO.
Неверный параметр.
Ниже код обработки:
Процедура ТестXDTO() Экспорт
	Попытка
		ЧтениеТекста = Новый ЧтениеТекста(ПутьЗагрузки, КодировкаТекста.UTF8);
		СтрокаXML = ЧтениеТекста.Прочитать(); // Для проверки технологии XDTO читаем до конца, а не порциями
		СтрокаXML = СтрЗаменить(СтрокаXML, "<KON", "<KON xmlns=""http://localhost/testXML"" ");
		СтрокаXML = СтрЗаменить(СтрокаXML, "<DOG", "<DOG xmlns=""http://localhost/testXML"" ");

		ЧтениеXML = Новый ЧтениеXML;
		// Ниже в УстановитьСтроку(<СтрокаXML>, <Параметры>, <НаборСхемXML>) - ТРИ ПАРАМЕТРА!
		//Набор схем XML, используемых при проверки читаемого документа XML.
		//Если набор схем указан, но не проверен и включена проверка документа XML,
		//то будет выполнена проверка набора схем.
		ЧтениеXML.УстановитьСтроку(СтрокаXML); //<НаборСхемXML> - Вопрос заодно про третий параметр и его смысл, т.к. в статье описан другой прием

		РезультатРазборки = Новый Массив;
		ЧтениеXMLСхемы = Новый ЧтениеXML;
		Макет = ПолучитьМакет("схемаXSD");
		СтрокаXSD = Макет.ПолучитьТекст(); // Макет текстовый!
		ЧтениеXMLСхемы.УстановитьСтроку(СтрокаXSD);
		ПостроительDOM = Новый ПостроительDOM;
		ДокументDOM = ПостроительDOM.Прочитать(ЧтениеXMLСхемы);
		ПостроительСхемXML = Новый ПостроительСхемXML;
		СхемаXML = ПостроительСхемXML.СоздатьСхемуXML(ДокументDOM);
		НаборСхемXML = Новый НаборСхемXML;
		НаборСхемXML.Добавить(СхемаXML);

		СвояФабрикаXDTO = Новый ФабрикаXDTO(НаборСхемXML);
		ТипКонтаргентXDTO = СвояФабрикаXDTO.Тип("http://localhost/testXML",    "KON");
		ТипДоговорXDTO    = СвояФабрикаXDTO.Тип("http://localhost/testXML", "DOG");

		КонтрагентыXDTO = СвояФабрикаXDTO.ПрочитатьXML(ЧтениеXML, ТипКонтаргентXDTO);

		Для каждого ТестСтрока Из КонтрагентыXDTO.KON Цикл
			Сообщить("ТестСтрока Контрагенты: N="+ТестСтрока.N+", "+ТестСтрока.Наименование);// Тест чтения - проверка механизма - дальше более-меннее понятно.
		КонецЦикла;

		// Вопрос: Как быть дальше если нужно последовательно читать внутри одного контрагента все договоры (как в последовательном переборе)?
		ДоговорыXDTO    = СвояФабрикаXDTO.ПрочитатьXML(ЧтениеXML, ТипДоговорXDTO); // НА ЭТОЙ СТРОКЕ ОШИБКА!!!
		Для каждого ТестСтрока Из ДоговорыXDTO.DOG Цикл
			Сообщить("ТестСтрока договоры N "+ТестСтрока.N);// Тест чтения - проверка механизма - дальше более-меннее понятно.
		КонецЦикла;

	Исключение
		Инф = ИнформацияОбОшибке();
		Сообщить(ПодробноеПредставлениеОшибки(Инф) );
	КонецПопытки;

КонецПроцедуры ПоказатьПлатформа 8.3.6.2041 режим исполнения: толстый клиент, конфигурация нетиповая 1С:Весовой терминал (почти с нуля написана).
Буду раз любой консультации кто сталкивался с подобными трудностями внедрения новой технологии. Тут важно понять смысл стоит ли использовать по быстроте и простоте и когда лучше "по-старому" :)
in.xsd
тестТехнологииЧтенияXMLЧерезXDTO.epf

А вообще - спасибо. У меня всё руки не доходили померять, в результате исходил из пристрелки "на глазок". Рад, что ваши наблюдения подтвердили мои приблизительные замеры.
Эх, ещё бы посмотреть, что больше съедается, куда кэшируется...
Быстродействие практически такое же как и при использовании ФабрикиXDTO и ПакетаXDTO
:
Недопустимо работать с большими XML документами с помощью объектов встроенного языка, предназначенных для обработки файлов целиком: текстовые документы в ТекстовыйДокумент, XML в ДокументDOM и HTML в ДокументHTML, а также создавать в памяти XDTO-пакеты размером с весь XML-файл целиком.
В противном случае, весь файл загружается в оперативную память целиком. Исключения составляют отдельные случаи, когда необходим произвольный доступ к содержимому файла, к какой-то конкретной его части.
Следует использовать объекты для последовательной записи и последовательного чтения: ЧтениеXML, ЧтениеТекста, ЗаписьXML, ЗаписьТекста, с помощью которых можно прочитать файл порциями и расходовать память экономно.
При использовании механизмов XDTO неправильно зачитывать в память весь XML-файл целиком (ФабрикаXTDO.ПрочитатьXML(ЧтениеXML)). Вместо этого следует зачитывать XML-файл последовательно, с помощью объекта ЧтениеXML, а его отдельные фрагменты (теги) десериализовывать с помощью фабрики XDTO.
Если подавать на вход фабрики XDTO не весь документ, а частями (в тестовом примере каждый ПриходныйОрдер отдельно), то несколько снижается быстродействие - при 100 000 записях с 31 сек до 35. В программировании всегда так - экономим память - ухудшаем быстродействие и наоборот. Экономия памяти не самоцель. Обрабатывать как единое целое или по частям XML документ стоит выбирать для каждого конкретного случая
		ЧтениеHTML = Новый ЧтениеHTML;
		ЧтениеHTML.УстановитьСтроку(СтрокаHTML);
		ПостроительDOM = Новый ПостроительDOM;
		ДокументHTML = ПостроительDOM.Прочитать(ЧтениеHTML);
Они, как правило, относительно небольшого размера, поэтому быстродействие приемлемое. Я сейчас делаю один проект и в нём как раз есть получение страниц с сайта и их разбор. В цикле дёргаются и разбираются порядка ста страниц.
Почти весь полезный программный код в статье - поэтому скачивание и не сильно требуется
Функция находится в модуле общей команды РазобратьXML
их файла xml можно самому собрать xsd-схему, есть консольная утилита xsd.exe
По крайней мере мои попытки использовать эту программу оканчивались неудачей - полученный xsd файл проще было не доделывать до кондиции, а создать свой вручную.
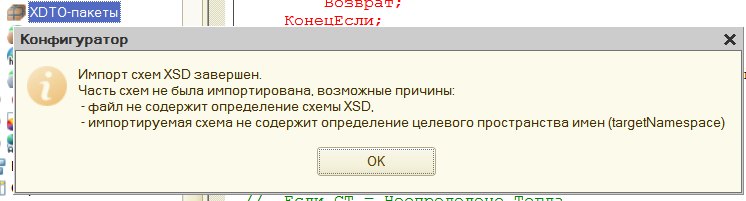
Часть схем не была импортирована, возможные причины:
-файл не содержит определение схемы XSD.
-импортируемая схема не содержит определение целевого пространства имен (targetNamespace)
прилагаю схему XML, батник
pause
Формат входного файла простой: выгружаются элементы справочника контрагенты, в атрибутах несколько параметров и - подчиненные элементы договоры тоже с минимумом атрибутов (фрагмент in.xml):
<?xml version="1.0" encoding="UTF-8"?>
<ROOT>
<KON ЭтоГруппа="true" Родитель="" ИНН="" КПП="" КодПоОКПО="" Наименование="учредители" НаименованиеПолное="" НалоговыйНомер="" РегистрационныйНомер="" РасширенноеПредставлениеИНН="" РасширенноеПредставлениеКПП="" КодГосударственногоОргана="" Комментарий="" N="1"/>
<KON ЭтоГруппа="false" Родитель="" ИНН="5501555666" КПП="550101001" КодПоОКПО="" Наименование="фирма1" НаименованиеПолное="ООО "Фирма1"" НалоговыйНомер="" РегистрационныйНомер="" РасширенноеПредставлениеИНН="" РасширенноеПредставлениеКПП="" КодГосударственногоОргана="" Комментарий="" N="2">
<DOG НомерДоговора="" ДатаДоговора="0001-01-01T00:00:00" Наименование="Основной договор" Организация="ООО "Фирма1"" ВидДоговора="СПокупателем" ВидВзаиморасчетов="" УстановленСрокОплаты="false" СрокОплаты="0" НаименованиеДляСчетаФактурыНаАванс="" ПорядокРегистрацииСчетовФактурНаАвансПоДоговору="" Комментарий="" N="3"/>
<DOG НомерДоговора="" ДатаДоговора="0001-01-01T00:00:00" Наименование="основной" Организация="ООО "Фирма2"" ВидДоговора="СПокупателем" ВидВзаиморасчетов="" УстановленСрокОплаты="false" СрокОплаты="0" НаименованиеДляСчетаФактурыНаАванс="" ПорядокРегистрацииСчетовФактурНаАвансПоДоговору="" Комментарий="" N="4"/>
</KON>
Заголовок cхемы xsd:
<xs:schema id="ROOT" xmlns="" xmlns:xs="http://www.w3.org/2001/XMLSchema" xmlns:msdata="urn:s chemas-microsoft-com:xml-msdata">
<xs:element name="ROOT" msdata:IsDataSet="true" msdata:Locale="en-US">
<xs:complexType>
<xs:choice minOccurs="0" maxOccurs="unbounded">
<xs:element name="KON">
<xs:complexType>
<xs:sequence>
<xs:element name="DOG" minOccurs="0" maxOccurs="unbounded">
<xs:complexType>
<xs:attribute name="НомерДоговора" type="xs:string" />
<xs:attribute name="ДатаДоговора" type="xs:string" />
<xs:attribute name="Наименование" type="xs:string" />
Может проблема в заголовке схемы xsd?
Хотело бы проверить новую технологию XDTO на быстродействие и удобство чтоб впоследствии переписать код обработок загрузки-выгрузки больших файлов. Хотелось бы проверить методы № 4 и № 5 из статьи.
start xsd.bat
xsd.exe
В первом методе, ИМХО, быстродействие тормозит вот это : МассивВСтроку(). Проверь без него, т.е. вообще не нужно использовать ТекущийПуть. Он нужен только в том случае, если есть неуникальные имена узлов, а в примере их нет
Кстати, никто не в курсе, ЧтениеУзловDOM сразу берёт всё (т.е. требует памяти) или идёт последовательно?
{Обработка.ЗагрузитьДанныеXML(1128)}: Ошибка чтения журанала регистрации: C:\Documents and Settings\voronov\Рабочий стол\Журнал регистрации1.xml
{Обработка.ЗагрузитьДанныеXML(1057)}: Неверный формат
ВызватьИсключение Ошибка;
Увы. У вас есть наработки с поддержкой 8.2 или 8.3 форматов журнала регистрации?
В прилагаемой конфигурации есть только два первых способа разбора, остальные отсутствуют. Копипастинг не получится :)
Листинги же этих способов в тексте даны мелкими картинками, на небольшом экране сломаешь глаза.
Но в остальном - прекрасное пособие для начинающих.
Использую 4-вариант (ФабрикаХДТО), некоторые поля могут быть нобязательные, поэтому приходится проверять их наличие самописной функцией (вернее дёргать значение свойства через неё):
Функция СвойствоХДТО(пОбъектХДТО,пИмяСвойства,пЗначениеПоУмолчанию = Неопределено)
	лКоллекцияСвойств = пОбъектХДТО.Свойства();
	лСвойствоХДТО = лКоллекцияСвойств.Получить(пИмяСвойства);
	Если лСвойствоХДТО = Неопределено Тогда
		Возврат пЗначениеПоУмолчанию;
	Иначе
		Возврат пОбъектХДТО.Получить(лСвойствоХДТО);
	КонецЕсли;
КонецФункции
ПоказатьЕще хотелось бы понять. Само по себе открытие файла XML уже занимает какие-то ресурсы, зависящие от размера файла. Есть предположение, что при открытии происходит проверка валидности файла. Есть информация по этой теме?
А то в последнее время приходится работать с XML сложной структуры просто огромных размеров. приходится извращаться. Иначе клиент валится по нехватке памяти. Про быстродействие молчу.
1. Когда всего один подчиненный узел тип ОбъектXDTO, а когда больше одного СписокXDTO - но это уже решается "человеческими" методами при переборе коллекции (выяснилось при разборе большого файла.
2. Даже при ручном указании в схеме xsd типов даты "datatime" и вещественного числа "decimal" (в обработке ) вместо string все равно приходится "парсить" вручную как при классическом методе ЧтениеXML конструкцией XMLЗначение(Тип("Дата") , УзелДог.ДатаДоговора ); или XMLЗначение(Тип("Число") , УзелДог.ВещественноеЧисло10_2); Возможно я тут ошибся в типах схемы (есть ли более совершенные редакторы с автораспознаванием типов)? Не зря автор статьи писал про то что он делает схему руками (может не те параметры командной строки)? Фрагмент схемы ниже:
<xs:complexType>
<xs:attribute name="НомерДоговора" type="xs:string" />
<xs:attribute name="ДатаДоговора" type="xs:datatime" />
<xs:attribute name="Наименование" type="xs:string" />
<xs:attribute name="Организация" type="xs:string" />
<xs:attribute name="ВидДоговора" type="xs:string" />
<xs:attribute name="ВидВзаиморасчетов" type="xs:string" />
<xs:attribute name="УстановленСрокОплаты" type="xs:string" />
<xs:attribute name="СрокОплаты" type="xs:string" />
<xs:attribute name="НаименованиеДляСчетаФактурыНаАванс" type="xs:string" />
<xs:attribute name="ПорядокРегистрацииСчетовФактурНаАвансПоДоговору" type="xs:string" />
<xs:attribute name="Комментарий" type="xs:string" />
<xs:attribute name="ВещественноеЧисло10_2" type="xs:Decimal" />
<xs:attribute name="N" type="xs:string" />
</xs:complexType>
</xs:element>
Ниже окончательный вариант который читает большие файлы:
// ПРОБЛЕМА № 1 - есть ли узел (и есть ли метод без Попытка-исключение?)
			Попытка
				УзлыДог = Узел.DOG;
			Исключение
				Продолжить; // Нет узла! Пропускаем!
			КонецПопытки;

			// ПРОБЛЕМА № 2 - сколько этих узлов 1 или больше (тип то разный ОбъектXDTO или СписокXDTO из этих самых объектов)?
			Если ТипЗнч(УзлыДог) = Тип("СписокXDTO") Тогда
				Для Каждого УзелДог из УзлыДог Цикл
					Сообщить(""+Символы.Таб+"Договор № "+УзелДог.N+", Наименование "+УзелДог.Наименование+" - (Тип узла СписокXDTO у КА много договогов)"); // Обработка всех договоров (если есть) контрагента как подчиненных узлов
					//F = 1/0; // Модель ошибки!
				КонецЦикла;
			ИначеЕсли ТипЗнч(УзлыДог) = Тип("ОбъектXDTO") Тогда
				УзелДог = УзлыДог; // Еще заплатка для однотипности передаваемого объекта "в обработку"
				XMLЗначение(Тип("Дата") , УзелДог.ДатаДоговора ); // - Опять старые проблемы - вручную десериализовывать по типам XMLЗначение(Тип("Дата") , УзелДог.ДатаДоговора )
				Сообщить(""+Символы.Таб+"Договор № "+УзелДог.N+", Наименование "+УзелДог.Наименование+" - (ОДИН договор у КА и тип узла ОбъектXDTO"); // Обработка всех договоров (если есть) контрагента как подчиненных узлов
			Иначе
				ВызватьИсключение("Неизвестный тип XDTO в строке ");
КонецЕсли; ПоказатьНо, в целом не нужно вручную мучиться с набивкой структуры для дальнейшей обработки. Для простых файлов с одинаковой структурой такой метод более "прост" по сравнению с "классическим" если XML получен не из 1С.
Ниже результат чтения в строке сообщений 1С:
Контрагент № 1, Наименование учредители
Контрагент № 2, Наименование Фирма1
Договор № 3, Наименование Основной договор - (Тип узла СписокXDTO у КА много договогов)
Договор № 4, Наименование основной - (Тип узла СписокXDTO у КА много договогов)
Контрагент № 5, Наименование Тесть КА и 1 договор (тип объектXDTO, а не список)
Договор № 6, Наименование Когда всего 1 договор (тип объектXDTO, а не список) - (ОДИН договор у КА и тип узла ОбъектXDTO
Контрагент № 7, Наименование Последний без подчиненных договоров!
Прочитали ХМЛ
Вот такое вот "веселое" знакомство при переходе на новую технологию (еще если глюков не будет).
in.xml
<xs:schema xmlns:xs="http://www.w3.org/2001/XMLSchema" </xs:schema>
и 1С все прекрасно прочитает. Можно не париться ни с пакетами XDTO (3 вариант), ни со схемой (4 вариант). Все равно, какие бы типы элементов и атрибутов ты не определил в схеме, 1С их читает как string.
Также, если XML-файл не содержит реквизита URL-пространство имен, то это не помеха для чтения.
Почему не прикрепить .rar, в котором прикрепить как .cf, так и сами обработки отдельно?
В документации сказано:
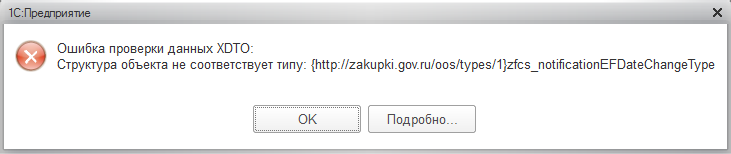
При попытке чтения вываливается с ошибкой..
ЧтениеXML = Новый ЧтениеXML();
ЧтениеXML.ОткрытьФайл("C:\1\fcs_notificationEFDateChange_0373100133116000101_8918.xml");

ТипXDTO = ФабрикаXDTO.Тип("http://zakupki.gov.ru/oos/types/1", "zfcs_notificationEFDateChangeType");
Извещение = ФабрикаXDTO.ПрочитатьXML(ЧтениеXML, ТипXDTO);
Кто-то читал файлы с госзакупок при помощи поставляемой схемы? Подскажите в чем может быть ошибка?

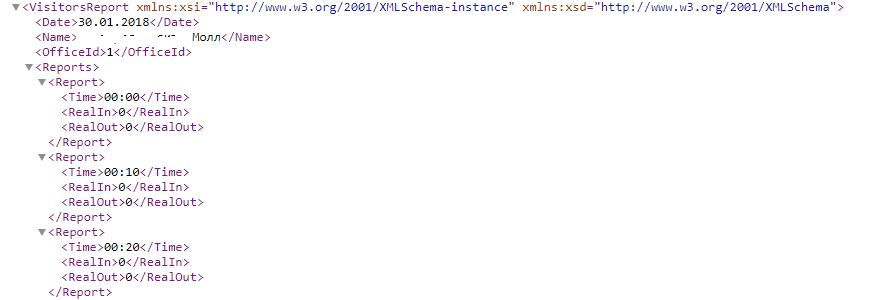
есть такой xml-файл
можно для него использовать 5 метод?
и можно xmlns передавать из файла или нужно его задавать заранее?
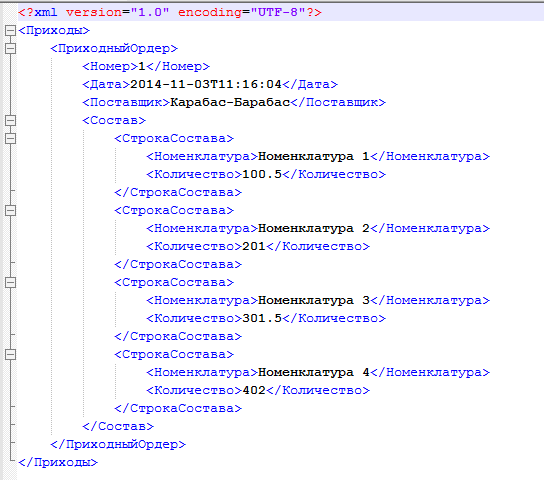
Вот упрощенный вариант понятного чтения в несколько строк небольших файлов, на примере типичного документа с табличной частью (сверка актов из 1с 77):
ЧтениеXML	= Новый ЧтениеXML;
ЧтениеXML.ОткрытьФайл(Файл.ПолноеИмя);
АктыXDTO	= ФабрикаXDTO.ПрочитатьXML(ЧтениеXML);
Акты		= Новый Структура("ОрганизацияИНН,ОрганизацияНаименование,КонтрагентИНН,КонтрагентНаименование,Договор,ОрганизацияФИО,ОрганизацияДолжность,КонтрагентФИО,КонтрагентДолжность,ДатаНачала,ДатаОкончания,Операции");
ЗаполнитьЗначенияСвойств(Акты, АктыXDTO);
Акты.Вставить("Операции", Новый Массив);
Для Каждого ОперацияXDTO Из АктыXDTO.Операция Цикл
	Операция	= Новый Структура("Номер,Операция,Дебет,Кредит,Согласован");
	ЗаполнитьЗначенияСвойств(Операция, ОперацияXDTO);
	Акты.Операции.Добавить(Операция);
КонецЦикла; // Для Каждого Операция Из АктыXDTO.Операция
// Не забываем закрывать, господа:
ЧтениеXML.Закрыть();
Показать<Контрагент xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:type="CatalogRef.Контрагенты">3722b978-d17a-11e5-89f0-001fc663b5b0</Контрагент>
Все объекты без проблем читаются методом = ФабрикаXDTO.ПрочитатьXML(ЧтениеXML)
и только контрагент имеет один атрибут type со значением CatalogRef.Контрагенты, куда девается ссылка?
Пакеты xdto вообще не использую, так как все объекты нормально читаются, но походу надо создать маленький пакет специально для этой строки.
Подскажите пожалуйста, как должен выглядеть этот микро-пакет или надо всё-таки создавать огромный пакет для всех объектов?
ОбъектXDTO.Body.DocumentObject_СписаниеСРасчетногоСчета[0].Контрагент.Последовательность().ПолучитьТекст(0)Возникла неудобная ситуация с обработкой списка в XML.
Если в списке одна строка, то возникает ошибка при попытке выполнить цикл, т.к. ЗаявкаXDTO.POSBreakages.POSBreakage является почему-то объектом XDTO, а если несколько строк, то ЗаявкаXDTO.POSBreakages.POSBreakage видится как СписокXDTO и обход проходит нормально, можно выкрутиться через попытку исключение, но красивое решение пока не удалось найти.
Для Каждого СтрокаPOSBreakages Из ЗаявкаXDTO.POSBreakages.POSBreakage Цикл
СтрокаPOSBreakagesСтруктура = Новый Структура("POSBreakage_ID,SC_POSBreakage_ID,POSBreakage_Name");
СтрокаPOSBreakagesСтруктура.POSBreakage_ID = СтрокаPOSBreakages.POSBreakage_ID;
СтрокаPOSBreakagesСтруктура.SC_POSBreakage_ID = СтрокаPOSBreakages.SC_POSBreakage_ID;
СтрокаPOSBreakagesСтруктура.POSBreakage_Name = СтрокаPOSBreakages.POSBreakage_Name;
ДокументЗаявкаСтруктура.POSBreakages.Добавить(СтрокаPOSBreakagesСтруктура);
КонецЦикла;
Предложите лучший вариант.
Цикл... Иначе не цикл ...
но почему-то образец разбираемого документа содержит только узлы, а как же атрибуты?
<СвСчФакт НомерСчФ="000076456/52-5221" ДатаСчФ="11.06.2020" КодОКВ="643">
Не получаю доступа к узлу rerturn.
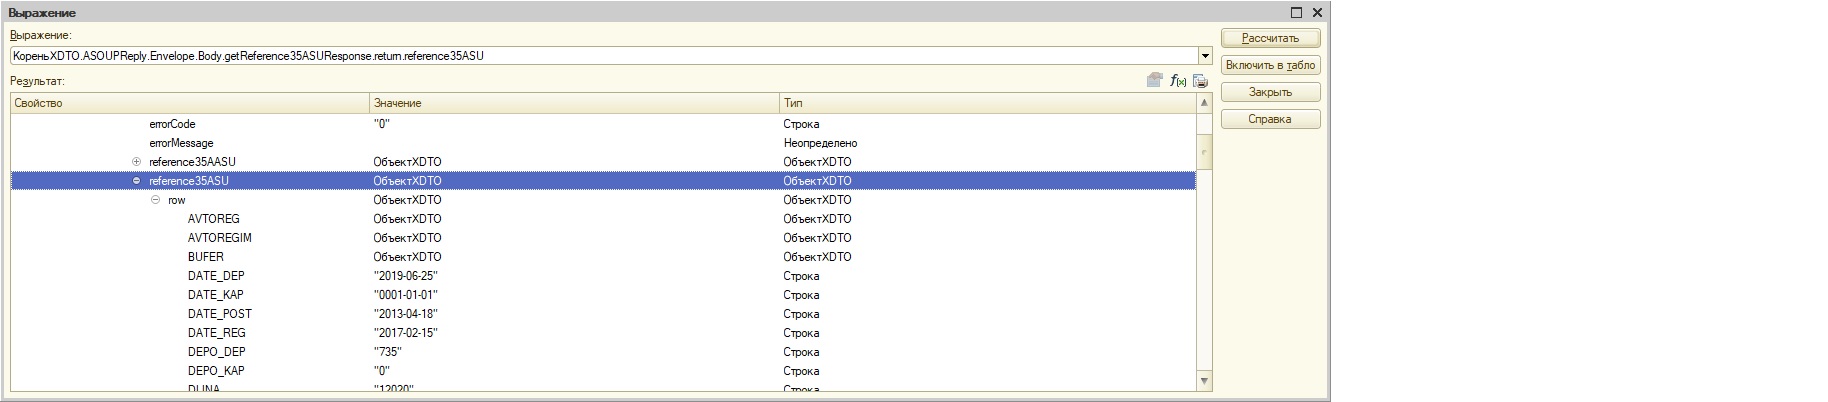
Приходиться получать доступ через: КореньXDTO.ASOUPReply.Envelope.Body.getReference35ASUResponse.return.reference35ASU
ну и значения некторые если пустые объектXDTO
Можно и без схемы читать
лФабрика.ПрочитатьXML(лЧтение); тоже самое получается
(для любителей COM-объектов; не использует механизмы платформы для работы с XML)
//Файл

РасположениеФайла = "C:\Orgstructure.xml";
ФайлXML = Новый Файл(РасположениеФайла);
Если Не ФайлXML.Существует() Тогда
	Возврат
КонецЕсли;

//ТЗ

КонтентXML = Новый ТаблицаЗначений;


//ADODB

СоединениеADO = Новый COMОбъект("ADODB.Connection");
СоединениеADO.Open("Provider=MSDAOSP.1; Data Source=Msxml2.DSOControl.4.0;");  //Версии классов ОС можно проверить в реестре в HKCR

НаборДанныхADO = Новый COMОбъект("ADODB.RecordSet");
НаборДанныхADO.Open(ФайлXML.ПолноеИмя, СоединениеADO);

//Типы

ТипДанныхChapter = 136;

//Парсинг

//Для одноуровневой иерархии

Для Каждого Узел Из НаборДанныхADO.Fields Цикл  //Корень

	Если Не Узел.Type = ТипДанныхChapter Тогда
		Продолжить;
	КонецЕсли;

	НаборДанныхТаблица = НаборДанныхADO.Fields(Узел.Name).Value;  //Узел

	Пока Не НаборДанныхТаблица.BOF = Истина         //Запись в узле
		И Не НаборДанныхТаблица.EOF = Истина Цикл

		Стр = КонтентXML.Добавить();

		Для Каждого ПолеЗаписи Из НаборДанныхТаблица.Fields Цикл //Поля записи

			ИмяКолонки = ПолеЗаписи.Name;

			Если ИмяКолонки = "$Text" Тогда
				Продолжить;
			КонецЕсли;

			Если КонтентXML.Колонки.Найти(ИмяКолонки) = Неопределено Тогда
				КонтентXML.Колонки.Добавить(ИмяКолонки);
			КонецЕсли;

			Стр[ИмяКолонки] = ПолеЗаписи.Value;

		КонецЦикла;

		НаборДанныхТаблица.MoveNext(); // переход на след. позицию курсора

	КонецЦикла;

КонецЦикла;


//освобождение

Если НаборДанныхADO.State = 1 Тогда
	НаборДанныхADO.Close();
КонецЕсли;

Если СоединениеADO.State = 1 Тогда
	СоединениеADO.Close();
КонецЕсли;

НаборДанныхADO = Неопределено;
СоединениеADO = Неопределено;


//обработка ТЗ

Для Каждого Стр Из КонтентXML Цикл


	//
КонецЦикла; ПоказатьВы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 311011
Создание 05.11.14 15:51
Обновление 05.11.14 15:51
Просмотры 433357
Загрузки 1028
Рейтинг
840
Комментарии 107
Код открыт Не указано
Рубрики Файловый обмен (TXT, XML, DBF), FTP Загрузка и выгрузка в Excel
Кому Разработчик
Тип файла Конфигурация (md, cf)
Платформа 1С:Предприятие 8
Конфигурация 1C:Бухгалтерия
Операционная система Не имеет значения
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Абонемент ($m)