Как мы сделали выгрузку данных из 1С с помощью ИИ
Интеграция - Перенос данных 1C
Трудности перевода
Я расскажу о том, как вызревала дата-инфраструктура в нашей компании: с чего все началось, чем закончилось, как мы этот путь прошли и с чем боролись.
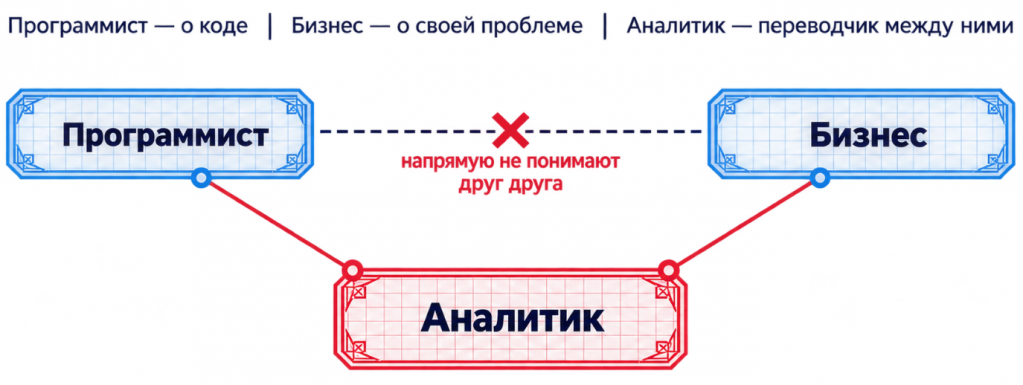
Любой проект автоматизации начинается с трудностей перевода. Бизнес приходит к разработчикам, говорит: «Мне нужна некая бизнес-ценность, желательно в деньгах, в валюте». Но программист не понимает этих терминов, не понимает каких-то бизнесовых историй. Программист хочет внятное техническое задание.
Такая библейская история: проектное управление, гибкие технологии и все такое. В этой истории как спасательный круг появляется аналитик. Аналитик – очень полезный и важный человек, который связывает программиста и бизнес, помогает им договориться, понять друг друга. При этом он несет, по сути, всю ответственность за этот дата-проект, потому что, кроме него, никто не понимает, что происходит. Программист ничего не понимает про бизнес, бизнес ничего не понимает про технологии. Аналитик понимает и тех, и других, но сделать тоже много чего не может.
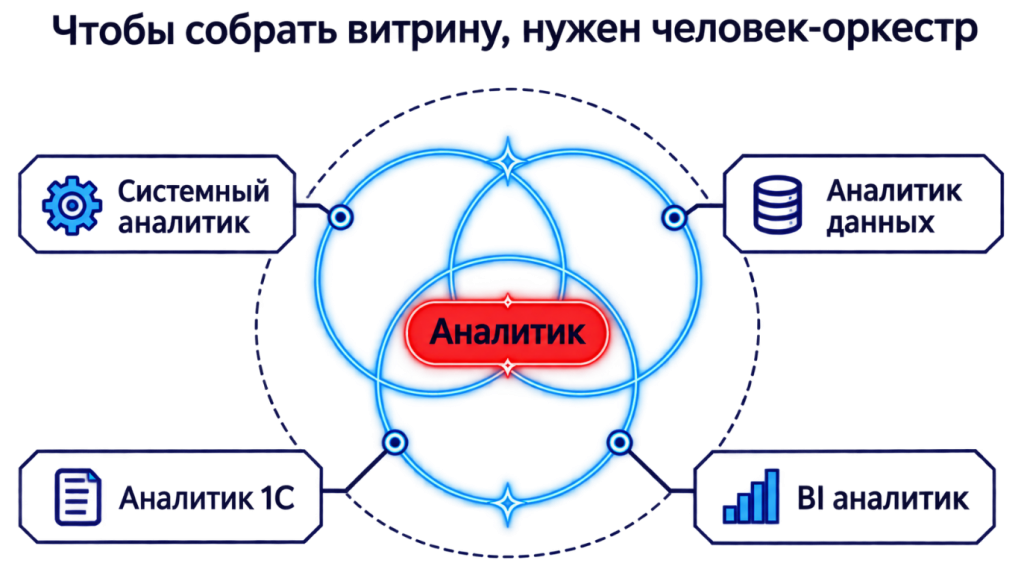
Получается очень важный, удобный и ответственный человек. А в дата-проектах и подавно, потому что слово «аналитик» такое классное.
Системный аналитик – надо всех понять, всех связать, объяснить, поставить задачки.
Аналитик данных – тоже аналитик. Просто какие-то запросики пишешь, в хранилище вроде тоже без разработки, можно пока обходиться без программиста.
BI-аналитик – тоже аналитик. Взял, поставил BI-платформу, что-то настроил, отчеты вывел, и все счастливы. Плюс ему приходится быть аналитиком 1С.
Получается такой аналитик в четвертой степени – очень важный и нужный персонаж, который при всем этом несет ответственность за дата-проект.
Первый заход: аналитик своими руками
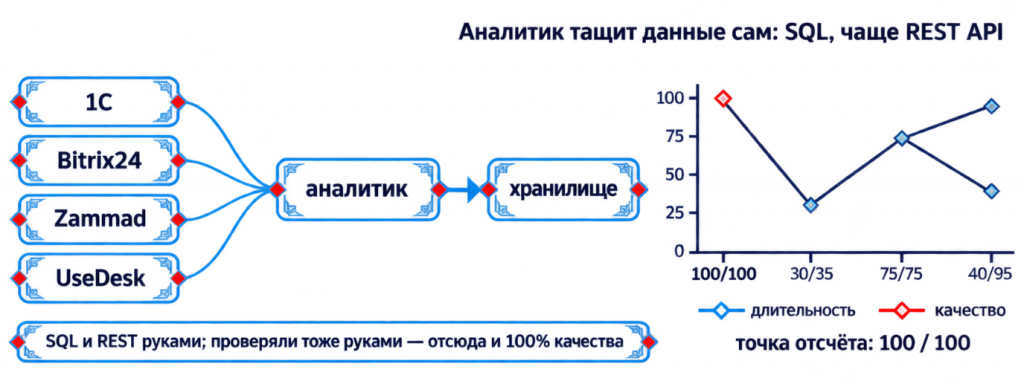
В нашей компании было все ровно так же. У нас лоскутная автоматизация: не какой-то монолит на одном продукте, а целый зоопарк информационных систем, из которых нам потребовалось сделать сквозную аналитику.
Мы взяли аналитика обыкновенного, посадили его и говорим: «Давай-ка сделай нам отчетность».
Разумеется, он сделал это так, как смог. Полез в 1С выгружать отчеты-файлики, в Битрикс – в REST-сервисы, в каких-то других информационных системах – в базы SQL. Что-то выгрузил, собрал это воедино, предоставил отчет.
Конечно, это не может жить, просто потому что аналитик такое инфраструктурное решение не предоставляет. Он делает какие-то разовые акции, разовые выгрузки, достигает локально поставленных задач. Просто хорошо, продуктивно, качественно, как разработчик, он сделать не может.
Давайте зафиксируем эту позицию ручной выгрузки как 100% результата, 100% эффекта и длительности. Просто потому что аналитик это прожил, он руками все сделал, проверил. Это 100% результата.
Второй заход: аналитик с ИИ
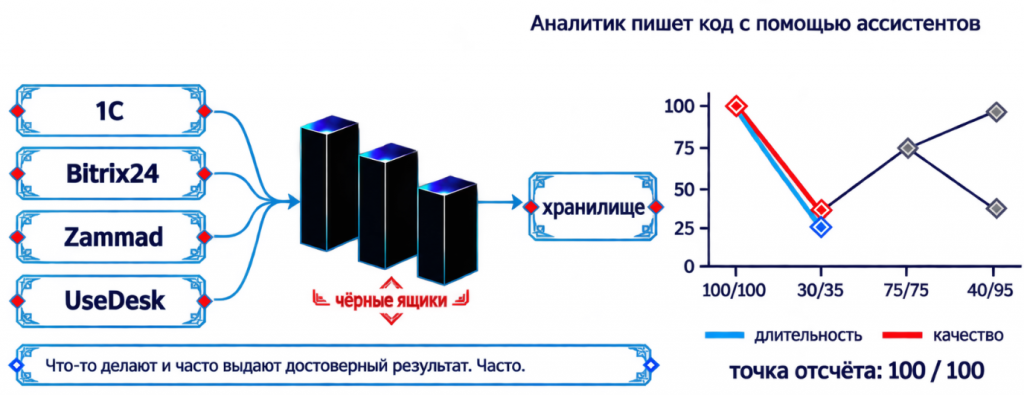
Пару лет назад на волне хайпа появились ИИ-агенты, с которыми мир кардинально преображается.
Дали аналитику агента, оплатили подписку и говорим: «Давай-ка теперь, друг, сделай нам конвейер данных».
Разумеется, аналитик пошел, что-то навайбкодил, наделал каких-то коннекторов на Python. И это даже как-то выгружается, собирается в какие-то модели и отчетность.
Разумеется, эта история тоже не будет продуктивной, просто по той причине, что там много черных ящиков, которые что-то делают, а аналитик не может это проверить.
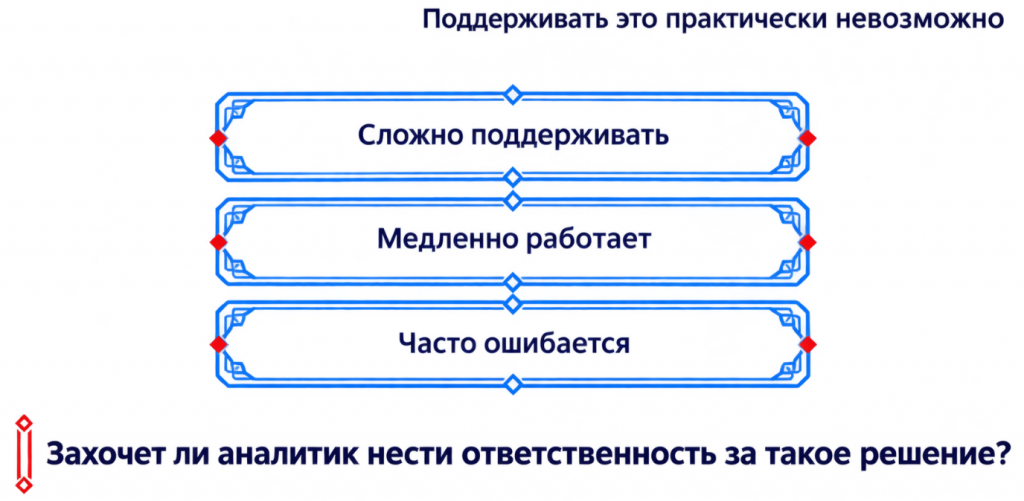
Это невозможно поддерживать. Аналитик не программист, он в код не залезет, не провалидирует вход-выход и так далее.
Это все будет медленно работать, потому что агенты будут использовать те инструменты, которые им доступны.
Например, для выгрузки данных из 1С можно использовать OData. Очень простой нативный инструмент, программный интерфейс для ИИ-агента. Программа будет дружить с программой. Все понятно, доступно, для него по крайней мере.
Но, конечно, это не работает быстро. Те, кто сталкивался с OData, знают, что там уже на объемах больше 100 000 строк все начинает отваливаться, глючить, медленно работать.
Кроме того, агенты – страшные вруны. Они очень достоверно могут что-то тебе в моменте рассказать. Ты, возможно, даже проверишь, подкорректируешь его, и он тебе выдаст правду.
Но дело в том, что все тест-кейсы он не покроет. Просто все на свете предусмотреть и знать нереально. Поэтому нет-нет да он соврет.
Представьте, что на этом уже считаются премии, планируются проекты. Не дай бог, это еще в каком-нибудь медучреждении работает и на этом завязаны жизни людей. Тогда вообще кошмар.
Конечно, аналитик не то чтобы не захочет, он в принципе не может нести за это ответственность. Потому что он классный парень, он сделал, решил задачу так, как смог в моменте времени теми инструментами, которые ему были доступны.
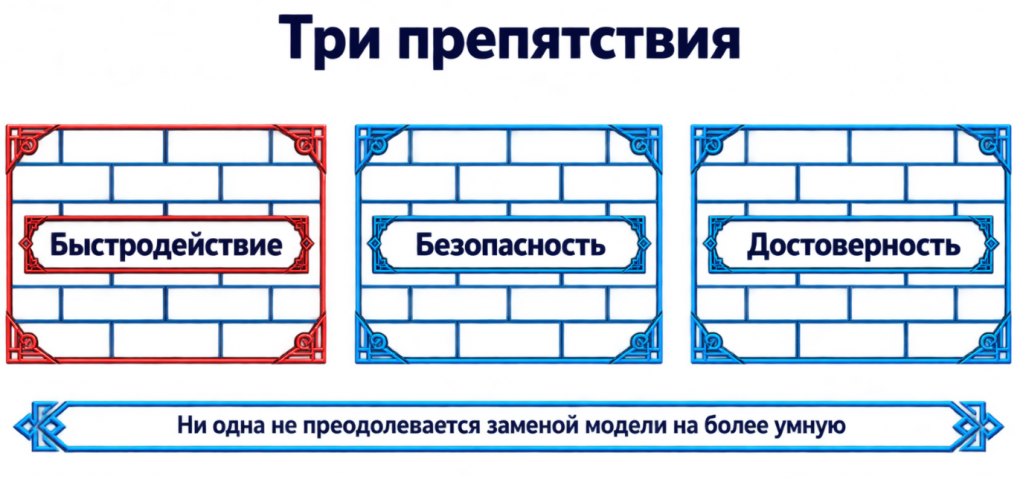
При этом преимущества, которые аналитик получил при работе с ИИ, прежде всего скорость разработки, всех потрясли. И хотелось сохранить эти преимущества и нивелировать недостатки: улучшить быстродействие выгрузки, побороться с безопасностью, потому что зарубежные модели и все такое, и повысить доверие к данным.
Быстродействие
Первая проблема – быстродействие. У нас она решалась с помощью продукта «Экстрактор».
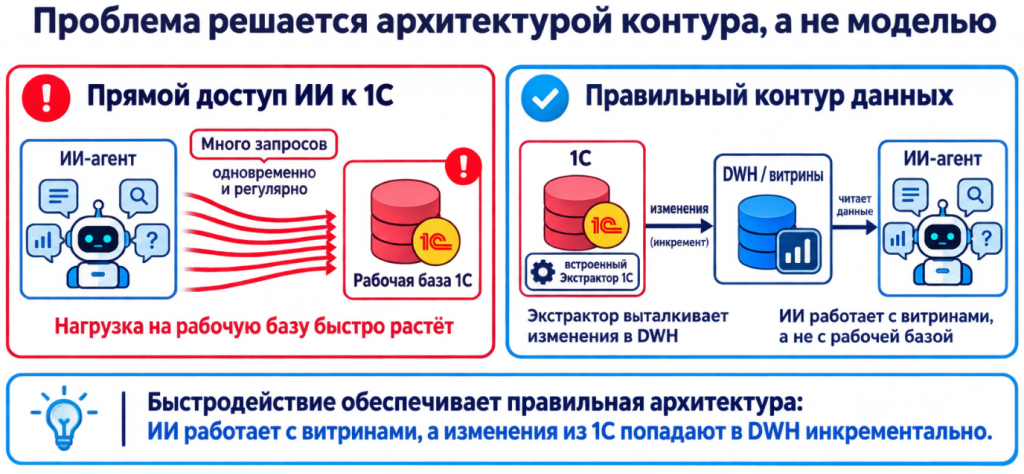
Представим прямой доступ агента в 1С. Вы открываете ему двери через веб-публикацию, говорите: «Ходи в OData и строй мне аналитику ad hoc, по запросу. Какая у меня выручка за февраль?»
Классно. Он пошел, выполнил запрос по регистру или по документам. Это будет быстро, если речь идет, допустим, о феврале.
А если мы хотим аналитику год к году или какую-то оборачиваемость? Надо взять остатки, надо взять продажи, все это соединить. Это будет много запросов, много данных, и система начнет захлебываться.
Мы внедрили Экстрактор. Это инструмент, расширение для 1С, которое выгружает данные инкрементально, многопоточно, по расписанию, выталкивает данные по событийной модели в хранилище.
И здесь инфраструктурное, концептуальное отличие в том, что агент уже ходит не в саму 1С, не мучает и не пытает ее каждый раз по запросу. Он ходит в хранилище, совершенно никак к 1С не обращаясь.
То есть все данные из 1С уже лежат в хранилище и никого не беспокоят.
Безопасность
Вторая проблема – безопасность.
Есть классные зарубежные умные модели: GPT, Claude и так далее. Многих беспокоит, что какие-то важные персональные, секретные данные могут туда утечь. И это никого не радует.
Здесь может быть несколько решений.
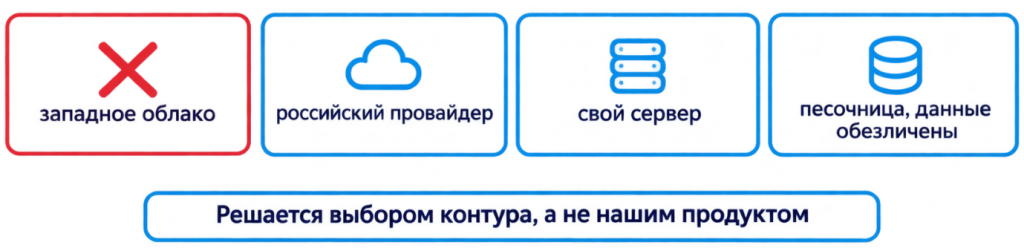
Можно просто перейти на отечественных провайдеров, на отечественные модели от Сбера, от Яндекса. Может, они догонят зарубежные модели когда-нибудь в ближайшее время.
Другой вариант – использовать локальную модель. Купить какой-нибудь сервер, поставить туда Qwen пободрее.
Или просто разделить персональные и неперсональные данные, обезличить их, маскировать и скармливать агентам только то, что можно скармливать.
Проблема решаемая.
Достоверность
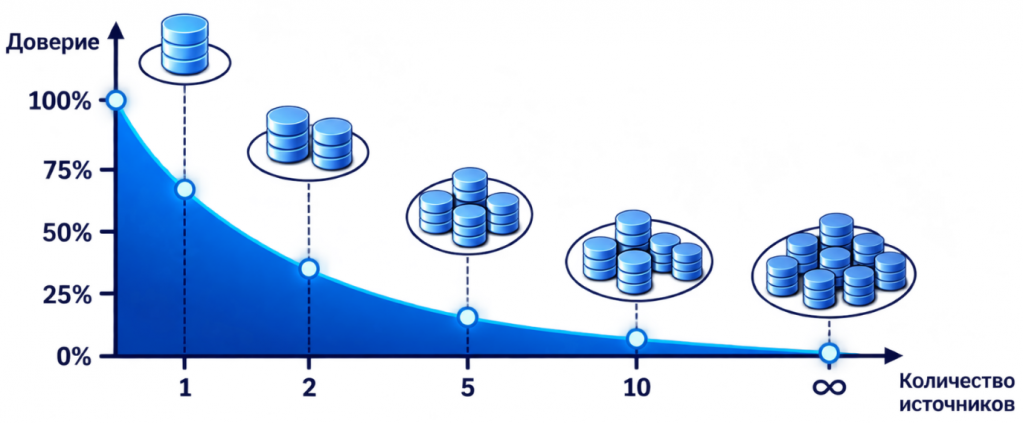
Что касается достоверности, то чем больше источников данных, тем больше черных ящиков, находящихся в черных ящиках в черной комнате, и тем меньше доверия ко всей этой истории.
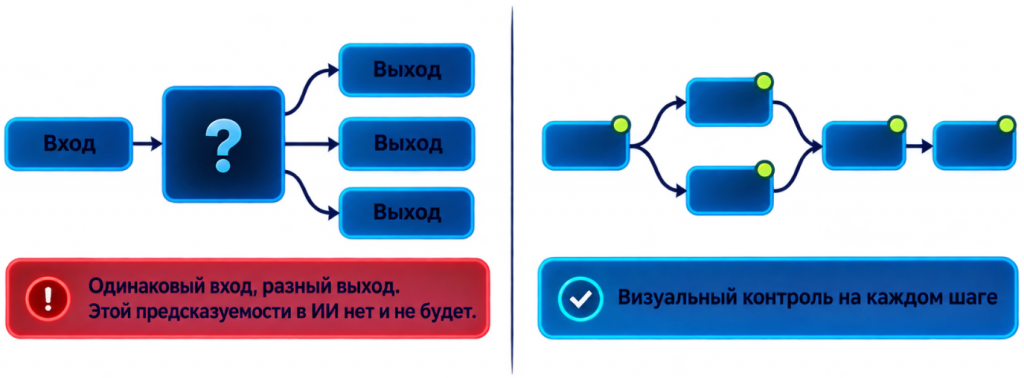
Мы пришли к тому, что нужно просто уйти от этих черных ящиков. История должна быть проверяемой.
Всем понятны блок-схемы. Допустим, все любят Airflow за то, что он наглядный, можно проследить путь трансформации данных.
Но в том же Airflow все DAG'и вам придется писать, все этапы трансформации. Это тоже программный код, который вам нагенерирует агент и к которому нет особого доверия.
Поэтому нужно сделать так, чтобы были законтрактованные DAG'и, ноды, кубики трансформации, за которые будет отвечать программист.
Такие кубики можно проверять. Что-то подали на вход, получили результат на выходе, его видно глазами. Человек-аналитик может это проконтролировать, провалидировать, сказать: «Окей, этот шаг трансформации выполнен правильно».
Такие кубики, ноды, складываются в сценарий. И аналитик может от источника до результата, полученного на выходе, все проверить и проконтролировать.
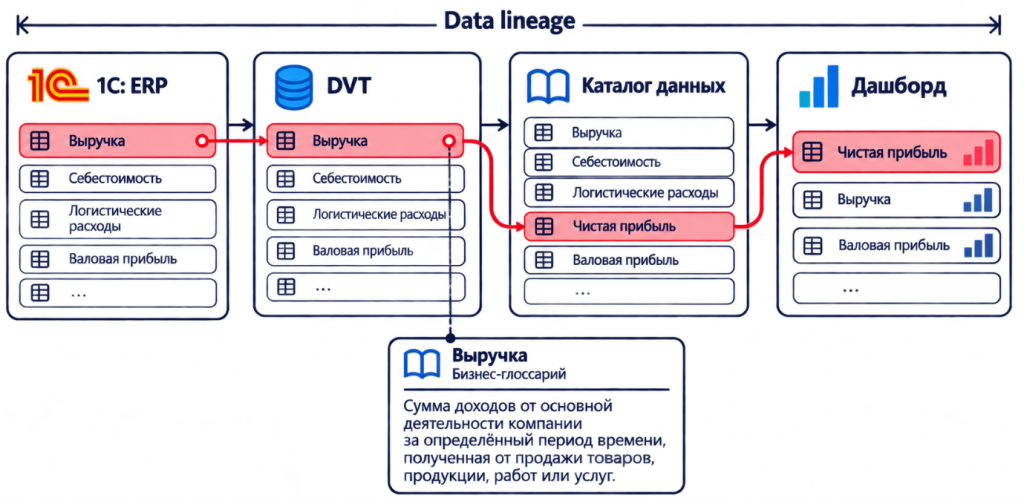
Но этого мало, потому что сценарии могут вырастать до довольно больших объемов. Начнешь в них просто путаться. Человек путается, и агент тоже не поймет. Там много похожих показателей, он не разберется, какие из них смотреть.
Поэтому пришлось внедрить в эту историю элементы дата-каталога. Нужно было обеспечить прослеживаемость данных – Data Lineage, то есть от итоговых агрегатов до первоисточников через все шаги трансформации данных.
Плюс к этому накинуть бизнес-глоссарий, то есть описательную часть каждой таблички, каждой колоночки. И тогда и человеку, и агенту будет понятно, как с этим работать.
Трансформер данных
Получился трансформер данных – визуальный ETL на нодовой системе.
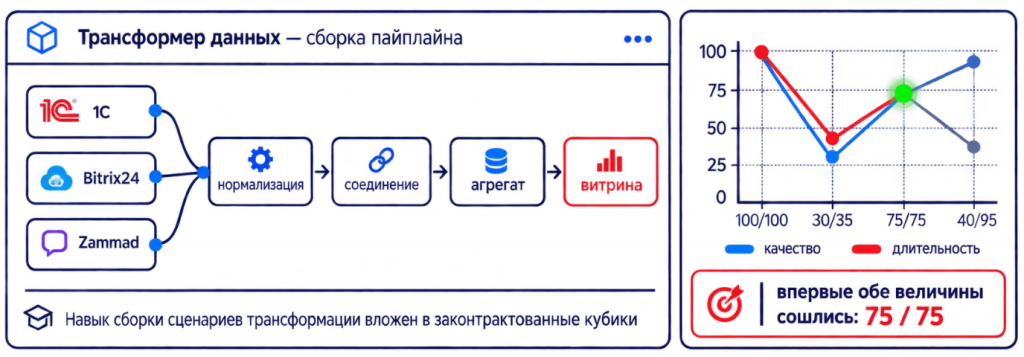
Он подключается через Экстрактор к 1С, подключается к Битрикс, у него есть коннекторы и к другим информационным системам.
В нем выполняете нормализацию, консолидацию, бизнес-описание, на выходе получаете витрину данных для каких-то задач.
Это может быть задача интеграционного характера: из 1С в 1С переложить или из 1С в BI, просто хранилище построить.
На этом шаге еще нет ИИ. Продукты Экстрактор и Трансформер повышают качество работы и за счет low-code ускоряют ее.
Архитектура: ИИ-агент управляет Экстрактором и DVT через MCP
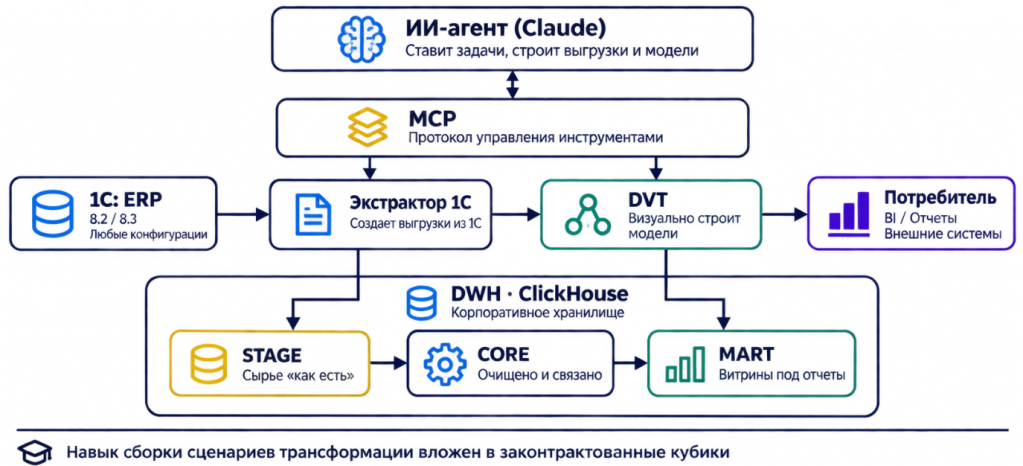
Разумеется, мы хотели сохранить все те преимущества, которые получили при внедрении агентов. Дело оставалось за малым – просто подключить агентов к нашим продуктам, к Экстрактору и Трансформеру.
Разработали MCP-сервер. Пришлось, правда, поступиться некоторыми принципами разработки Экстрактора. До недавнего времени он полностью работал в 1С без веб-публикации. Такое требование по безопасности часто встречается у заказчиков.
Но если хотите использовать агента, придется сделать веб-публикацию. На этом веб-сервисе описаны все методы Экстрактора, а в MCP – все правила взаимодействия с ним.
И теперь, просто введя какой-то промпт в агента, можно получить прямо сразу в хранилище табличку, наполняемую инкрементально, с теми измерениями, которые вам нужны. Буквально за полминуты.
А дальше с сырого слоя данных этапы трансформации и формирования хранилища выполняются уже на Трансформере данных. Это как раз тот визуальный ETL на нодовой системе.
Чем мы накормили модель
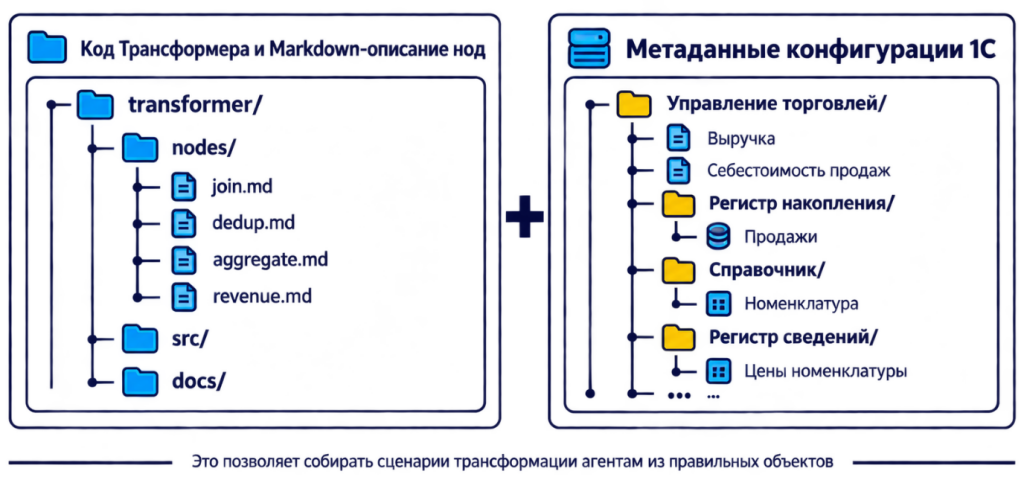
Для того чтобы это все работало, нужно было накормить модель, во-первых, всей метой 1С: конфигурацией 1С плюс бизнес-смыслами этих объектов, которые разработчик туда вложил. Информация общедоступная, находится в интернете. Ничего секретного тут нет. Скормили, научили.
Плюс, чтобы Трансформер работал, взяли весь его код, тоже скормили.
Там каждая нода описана в MD-файле: что она делает, как тестирована, что на входе, что на выходе. И начали получать первые результаты.
Разумеется, результаты были, они работали. Но работало это не совсем правильно. Это еще один шаг обучения модели.
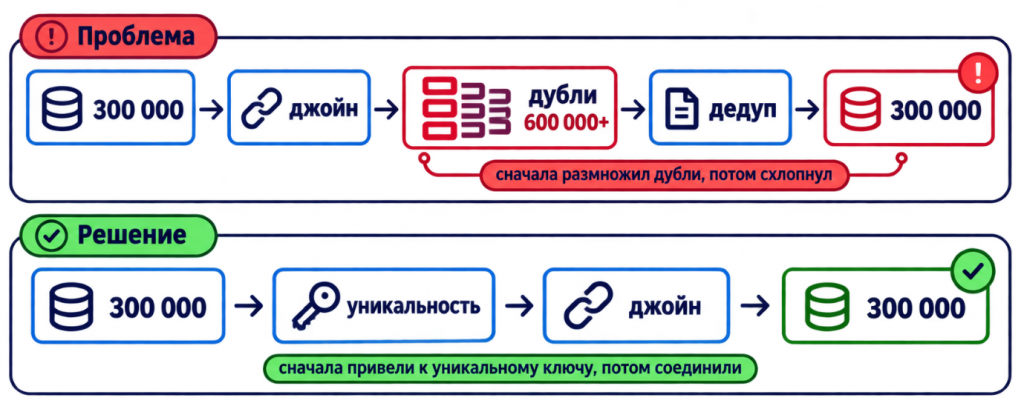
Допустим, первая проблема. Попросили ее P&L собрать условный. Она взяла, написала огромный SQL-запрос – одна нода в сценарии. Вроде задача решена, но не совсем так, как хотелось бы – неправильно.
Объяснили: «А давай-ка ты теперь нам сценарий собирай понятный, из законтрактованных кубиков». И тогда это уже стало понятно, приятно читать и проверять.
Плюс агент сначала соединял все, что можно, потом дедуплицировал, получая нужные результаты, но не совсем правильным путем.
Короче, базовый курс молодого бойца по дата-инженерии ему скормили, и он стал делать все правильно.
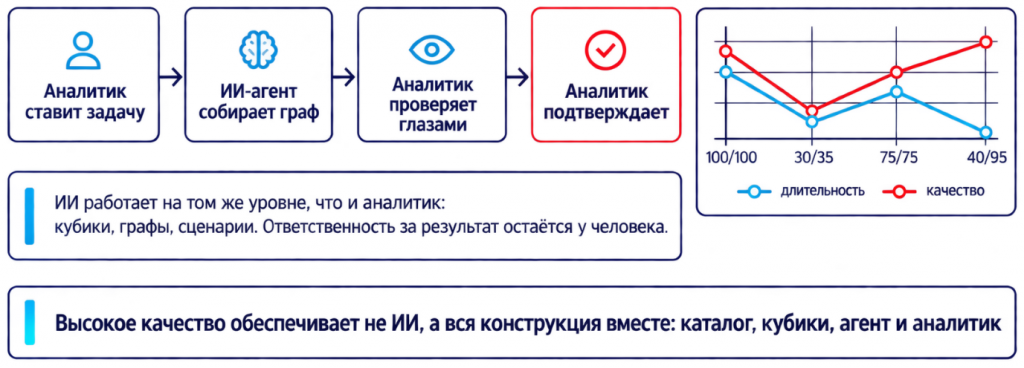
Таким образом, агент стал ассистентом аналитика по выгрузке и трансформации данных, по разработке хранилища.
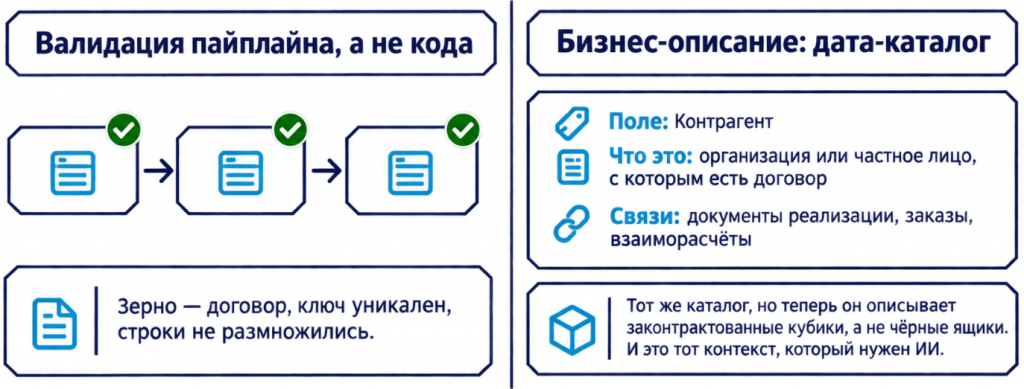
Его результаты аналитик может проверять, валидировать глазами, создавая доверие к данным за счет законтрактованных кубиков и бизнес-описания сценария.
Один уровень абстракции
Это то, что обеспечивает единый уровень абстракции и взаимодействия с ИИ-агентом.
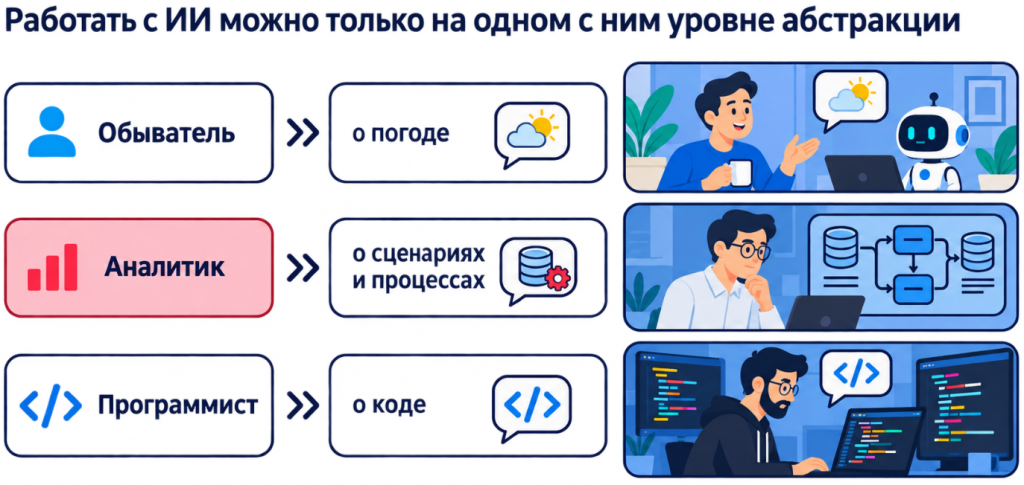
В начале мы говорили о том, что аналитик несет ответственность за то, что разработал программист, и не совсем понимает, что там внутри. То есть делегирует ответственность программисту. Аналитик не может сам валидировать, проверять код, проводить код-ревью и так далее. Поэтому поднимаем уровень абстракции на уровень аналитика.
Аналитики хорошо понимают схемы, диаграммы, понимают бизнес-описания. И на этот уровень абстракции мы подняли взаимодействие агента и нашего главного персонажа.
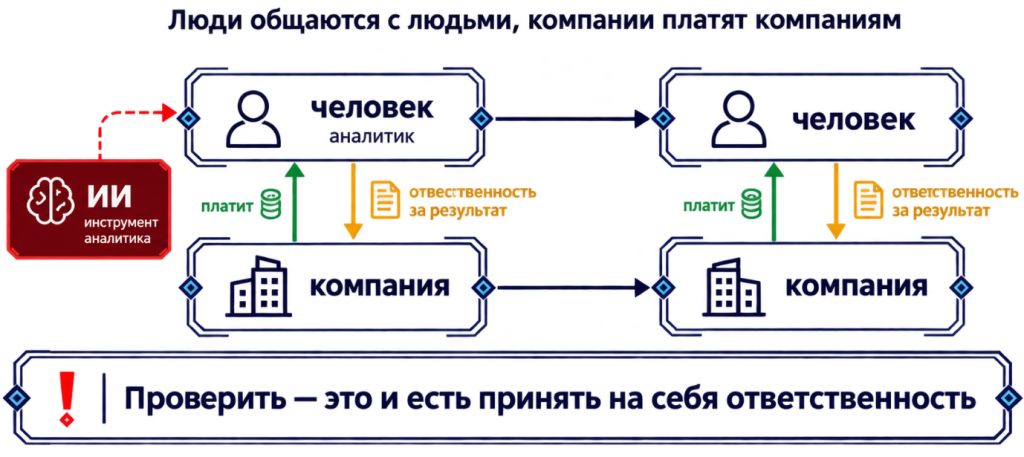
Весь этот контроль, единый уровень абстракции – это то, что позволяет аналитику нести ответственность за весь проект.
Теперь, используя ИИ, он получает проверяемые, воспроизводимые результаты и может передавать эту ответственность дальше. Человек передает ответственность компании, компания сдает проект другой компании, все друг другу заплатили, все довольны.
Так, пройдя путь от ручных выгрузок из Excel и прямого доступа к SQL и REST до использования ИИ-агентов, мы автоматизировали поток данных из 1С в аналитику.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TECH EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

