Запрос против рекурсии или разузлование номенклатуры
Учетные задачи - Логистика, склад и ТМЦ
Бесплатные
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Узнавайте о новых бесплатных решениях в нашей телеграм-группе Инфостарт БЕСПЛАТНО
| Наименование | Скачано | Бесплатно |
|---|---|---|
|
ЗапросПротивРекурсии.epf
.epf 12,64Kb
1174
|
1174 | Скачать бесплатно |
Вы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Программисты при произнесении слов "граф" или "дерево" , не задумываясь продолжают : "Понятно.. это рекурсия !" . Не вдаваясь в дискуссию о том , почему рекурсия в БД есть синоним неэффективности, мы на простом примере рассмотрим решение задачи "разузлования" номенклатуры принципиально "нерекурсивным" методом. Выберем эпиграф для статьи :
"Запрос в БД - это сила. Рекурсия - это зло ."
§ 1. Где и зачем это нужно ?
На предприятиях ,осуществляющих сборку сложных изделий (летательных аппаратов, электровозов, судов), состоящих из тысяч и десятков тысяч комплектующих, актуальна задача ведения спецификаций изделий.В статье мы рассмотрим одну из частей этой задачи - "разузлование" номенклатуры : по спецификации изделия определить состав и количество "элементарных", входящих в него составляющих. Все известные способы решения такой задачи - "медленные"и время выполнения может доходить в реальных задачах до нескольких минут.
Какой же из "медленных" способов - самый быстрый, надежный , эффективный ?
Достаточно ли встроенных возможностей платформы 1с для решения таких задач ?
§ 2. Постановка задачи.
На нижеприведенном рисунке изображено два способа отображения графа "Спецификации" :
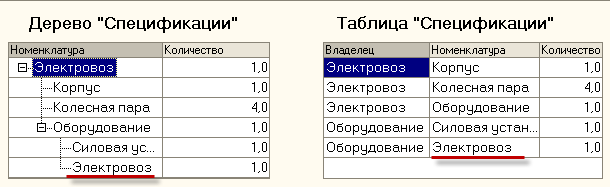
Рис. 1. Два способа отображения графа.
В базе данных (БД) такой граф хранится в табличной форме , поэтому в дальнейшем мы будем рассматривать таблицу "Спецификации" в качестве исходных данных. Итак , сформулируем задачу разузлования "узко" для изображенного примера : для номенклатуры "Электровоз" найти все составляющие его номенклатуры , неимеющие подчиненных ("детей") с расчетом необходимого количества .Т.е. в качестве решения мы должны получить таблицу :
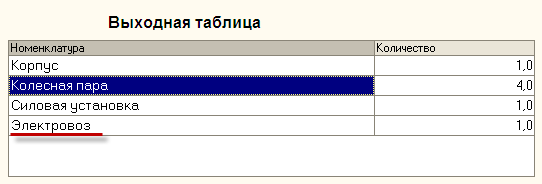
Рис. 2. Выходная таблица.
§ 3. Решение.
Преобразуем заданную в условии задачи таблицу "Спецификации", добавив колонку
"КодНоменклатуры" :
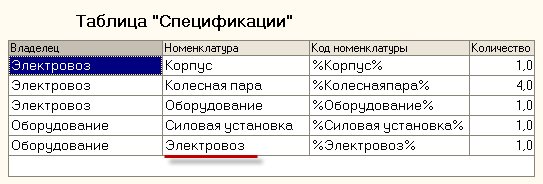
Рис. 4. Таблица "Спецификации".
Создадим временную таблицу "ВремТаблица0" с единственной записью ,содержащей
номенклатуру "Электровоз" :
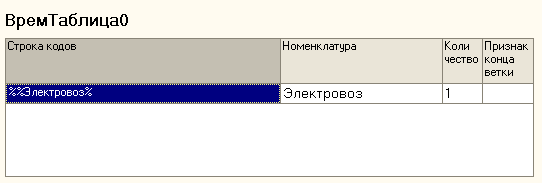
Рис. 5. Начальная таблица ВремТаблица0.
Начальные данные заданы. Рассмотрим код обработки :
ТекстЗапроса = "ВЫБРАТЬ
| ЕСТЬNULL(Спец.Номенклатура, Исх.Номенклатура) КАК Номенклатура,
| Исх.Количество * ЕСТЬNULL(Спец.Количество, 1) КАК Количество,
| Исх.СтрокаКодов + ЕСТЬNULL(Спец.КодНоменклатуры, """") КАК СтрокаКодов,
| ВЫБОР
| КОГДА Исх.ПризнакКонцаВетки > 0
| ТОГДА Исх.ПризнакКонцаВетки
| КОГДА Спец.КодНоменклатуры ЕСТЬ NULL
| ТОГДА 1 // нормальное завершение ветки
| КОГДА Исх.СтрокаКодов ПОДОБНО Спец.КодНоменклатуры
| ТОГДА 2 // зацикливание
| ИНАЧЕ 0 // ветка продолжается
| КОНЕЦ КАК ПризнакКонцаВетки
|ПОМЕСТИТЬ Последующая
|ИЗ
| Исходная КАК Исх
| ЛЕВОЕ СОЕДИНЕНИЕ Спецификация КАК Спец
| ПО (Исх.ПризнакКонцаВетки = 0) // соединяемся только тогда, когда ветка продолжается
| И Исх.Номенклатура = Спец.Владелец
|;
|УНИЧТОЖИТЬ Исходная
|;
|ВЫБРАТЬ ПЕРВЫЕ 1 Посл.Номенклатура
|ИЗ Последующая КАК Посл
|ГДЕ Посл.ПризнакКонцаВетки = 0";
//Цикл получения выходной таблицы
Для Счетчик =0 по КоличествоЦиклов+1 Цикл
Запрос.Текст = СтрЗаменить(ТекстЗапроса,"Исходная","ВремТаблица"+ Счетчик);
Запрос.Текст = СтрЗаменить(Запрос.Текст,"Последующая","ВремТаблица"+(Счетчик+1));
РезультатЗапроса = Запрос.Выполнить();
Если РезультатЗапроса.Пустой() Тогда
Счетчик = Счетчик + 1 ;
Прервать;
КонецЕсли;
КонецЦикла;
На рис. 5-8 расмотрены промежуточные временные таблицы алгоритма во всех циклах решения.
Рис. 5 Таблица ВремТаблица0.
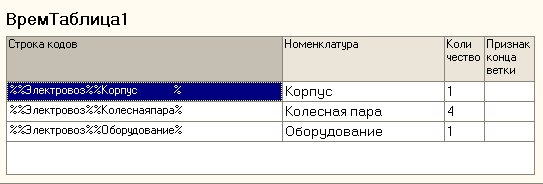
Рис. 6. Вид таблицы после исполнения первого цикла ( перед началом второго).
В колонке ""СтрокаКодов" накапливаются все коды номенклатуры текущей ветки.
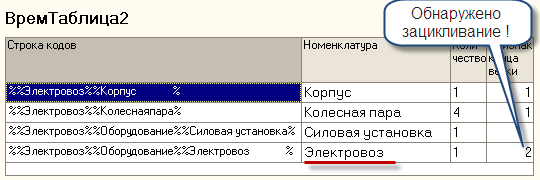
Рис. 7. Вид таблицы после исполнения второго цикла . Обратите внимание ,
обнаружено зацикливание , но работа "по графу" продолжается. Следующий цикл
- третий.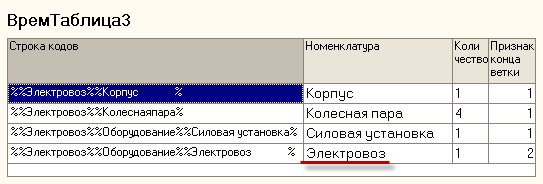
Рис. 8. Вид таблицы после исполнения третьего цикла. Все записи таблицы имеют
ненулевой ПризнакКонцаВетки - осуществляется выход из цикла.
ВремТаблица3 содержит все необходимые данные для вывода результатов решения :
- графа ошибок ( по колонке "СтрокаКодов" для номенклатуры "Электровоз" получаем дерево "Ошибки")
- выходной плоской таблицы номенклатур
Замечания.
- применен последовательный поуровневый обход графа , т.е . принципиально "нерекурсивный" метод решения.
- количество обращений к БД при таком обходе равно уровню графа , увеличенному на 1.
- 99.9% времени исполнения алгоритма занимает выполнения запросов к БД .
§ 4. Тест по быстродействию.
Чтобы оценка быстродействия была предельно конкретной , в качестве среды выберем - демонстрационную конфигурация БП 1.6(2.0) и представим два лёгких теста начального заполнения справочника "СпецификацииНоменклатуры", реализованных в обработке "ЗапросПротиврекурсии.epf". Нижеприведенные тесты-"миллионники", надеюсь, с лихвой перекрывают все возможные случаи медленного "разузлования" в реальных задачах. Действительно , практически невозможно представить себе предприятия , на которых бы справочник Номенклатура имел размер более 300 000 записей и уровень графа, описывающего Спецификацию сложного изделия, превышал бы число 20.
Тест № 1. "Десять"
Справочник "СпецификацииНоменклатуры" содержит 6-уровневый 10-арный граф , имеющий 1 000 000 различных ветвей и при обходе такого графа таблица ВремТаблица6 на выходе цикла алгоритма содержит 1 000 000 записей. Но сам справочник "СпецификацииНоменклатуры" в своей табличной части содержит лишь 60 записей.
Проще говоря , корневому элементу подчинены 10 элементов, каждому из которых подчинен одинаковый набор из десятка следующих элементов и т.д.
Тест № 2. "Два"
Справочник "СпецификацииНоменклатуры" содержит 20-уровневый бинарный граф , имеющий 1 048 576 различных ветвей и при обходе такого графа таблица ВремТаблица20 содержит 1 048 576 записей. Но сам справочник "СпецификацииНоменклатуры" в своей табличной части содержит лишь 40 записей.
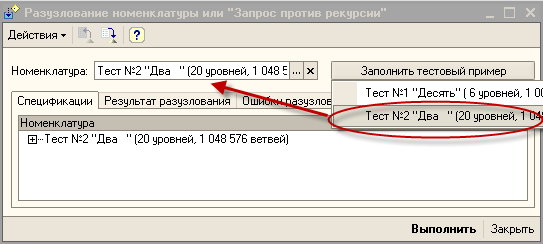
Рис. 9. Быстрое (4-6 сек) создание тестового примера в обработке "ЗапросПротивРекурсии.epf"
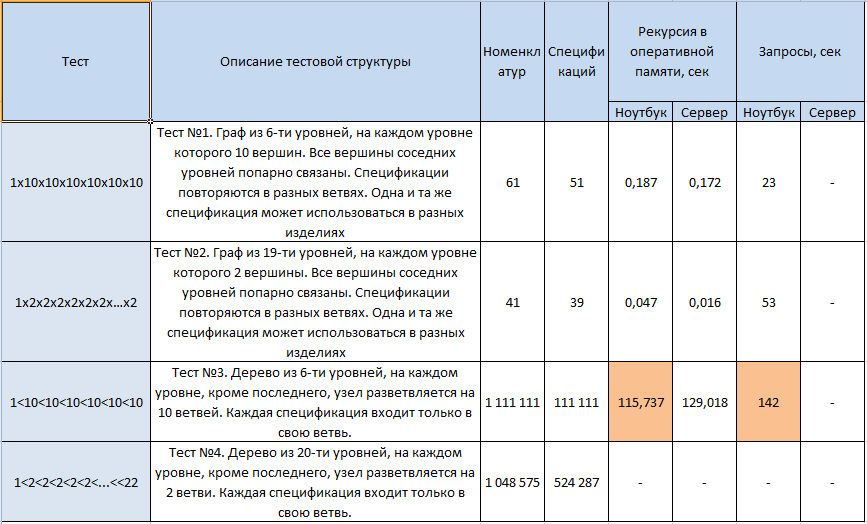
Небольшой объём исходных данных в тестах №1 и №2 порождает иллюзию : сейчас загрузим всё в таблицу значений и в оперативной памяти всё "быстренько" порешаем с помощью рекурсии. Прозрение к любителю рекурсии приходит после замера времени выполнения. Автор провёл опрос среди знакомых специалистов и для Теста №1 получил следующую информацию (приводится обобщенно , со слов авторов) : Разузлование номенклатуры для Теста № 1 140-220 сек в файловом варианте. Понимая всю условность приведенной информации , автор самостоятельно реализовал простейшую имитацию рекурсионного алгоритма :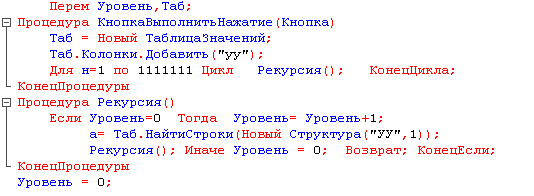
Рис. 10. Имитация рекурсионного алгортима. Количество циклов 1 111 111 равно количеству узлов в графе
теста №1.
В этой имитации "ничего нет". В ней заведомо многократно меньше операторов , таблица значений пуста, затратный контроль зацикливания не осуществляется и т.д. Время выполнения этой имитации лишь на 15%-20% меньше времени выполнения обработки "ЗапросПротивРекурсии.epf" в тесте №1 . Стал очевиден качественный вывод : рекурсионный алгоритм проигрывает и проигрывает много.
Приведем результаты тестирования для обработки "ЗапросПротивРекурсии.epf". Замеры производились для "теплого"(второго) запуска обработки как в клиент -серверном, так и в файловом варианте. Нижние пределы диапазонов приведены как оценки значений, полученных на компьютере автора. Про верхние пределы диапазонов : скажем так , автору не удалось найти такие серверы и такие рабочие станции для файлового режима , на которых бы время выполнения было хуже. Итак , оценки (подчеркиваю , оценки) для "среднеофисных" серверов и локальных станций с оперативной памятью 1Гб.
Тест № 1 "Десять"
|
Для файлового варианта |
25-60 сек |
| Для клиент- серверного варианта | 25-60 сек |
Тест № 2 "Два"
|
Для файлового варианта |
60-150 сек |
| Для клиент- серверного варианта | 120- 300 сек |
Рис.11. Результаты тестирования.
§ 5. Для любопытных.
В статье ни слова не сказано о сравнении по быстродействию с другими не-1совскими реализациями решения тестов №1и №2. А вдруг всё дело только в том , что 1с-овский интерпретатор неэффективен ? Может быть , если реализовать задачу на Си или Delfi, то удастся достичь лучшего быстродействия, чем указано в теме ? Или , может быть , использовать "чисто" TSQL ? Прогноз автора : НЕТ. НЕ ПОМОЖЕТ. Такая Рекурсия всё равно проиграет запросу 1с. Но буду рад ,если появятся публикации на эту тему с другими мнениями.
Прошу только помнить, что в статье идет речь не о "заточке" для тестов №1 и № 2, а об универсальной обработке произвольного графа ( в общем случае, циклического), которая " в среднем" оптимальна, на взгляд автора, для решения задачи "разузлования" на предприятии. Это значит , что таблица Спецификации может иметь миллионы записей и это существенно не скажется на быстродействии представленной обработки (в клиент-серверном варианте). Это значит также , что алгоритм различные графы и деревья , содержащиеся в таблице Спецификации, обрабатывает одинаково и априорно (на входе) не имеет никакой "подсказывающей "информации о характере графа .
Второй вопрос , который никак не затронут в статье : как нам не попасть на "миллиард" ? как оптимизировать работу с повторениями элементов при "разузловании" ? Можно заметить ,в частности, что при отсутствии контроля зацикленности можно было вставить в демонстрационный запрос "СГРУППИРОВАТЬ ПО " и тогда время выполнения по тесту № 1 было бы меньше 2 сек. Подход же с контролем зацикленности сложнее, и, думаю, мало востребован в практических задачах учета. "Миллиард" оставим без рассмотрения. В обработке "ЗапросПротивРекурсии.epf" лишь применено ограничение на размер промежуточных временных таблиц.
§ 6. Заключение
Автор убежден , что встроенных возможностей платформы 1с без использования рекурсии вполне достаточно для создания надежного и эффективного механизма "разузлования".
Главное же преимущество, на взгляд автора, представленной демонстрационной обработки не в том , что она выиграет по скорости выполнения у какой-то другой "рекурсионной обработки", а в том , что она более технологична и надежна - вся тяжесть вычислений (99.9%) ложится на сервер БД и мы "отвязываемся" от слабости клиента.
Статья была уже написана , когда я на ИС получил информацию и поверхностно познакомился с подходами к задаче "разузлования" , применяемыми в реальных, "вполне взрослых" проектах . Подходы эти несколько смутили. Но не отменили главного вывода статьи : применение рекурсии в задачах "разузлования" ( в постановке см.§2) избыточно.
§ 7. Благодарности
Автор приносит благодарности всем участникам дискуссии , предшествующей появлению данной статьи :
Hogik ,Tango , Wkbapka , Арчибальд , Ildarovich, ILM. Эти авторы разными способами и с разной силой толкали к пониманию новой для меня задачи "разузлования".Спасибо.
Вступайте в нашу телеграмм-группу Инфостарт
См. также
Оптовая торговля Розничная торговля Логистика, склад и ТМЦ Анализ продаж Пользователь 1С:Предприятие 7.7 1С:Предприятие 8 1С:Управление производственным предприятием 1С:ERP Управление предприятием 2 1С:Комплексная автоматизация 1.х 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 1.6 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 10 1С:Управление торговлей 11 1С:Розница 2 1С:Розница 3.0 Розничная и сетевая торговля (FMCG) Оптовая торговля, дистрибуция, логистика Беларусь Украина Россия Казахстан Управленческий учет Платные (руб)
Автоматизация заказа поставщику через 1С. Загрузка прайсов, анализ цен, управление заказами в УТ 10.3, УТ 11, КА2, УНФ, УПП, ERP, Розница 2
39141 руб.
21.04.2017 113527 212 44
Рабочее место Оптовая торговля Розничная торговля Логистика, склад и ТМЦ Ценообразование, анализ цен Бухгалтер Пользователь 1С:Предприятие 8 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Розничная и сетевая торговля (FMCG) Оптовая торговля, дистрибуция, логистика Управленческий учет Платные (руб)
Расширение для работы с номенклатурой: отображение остатков, цен, изображений, аналитики по каждой позиции, подбор товаров в документы через корзину и оптимизация интерфейса.
17284 руб.
26.04.2016 688155 1573 669
Обмен с ГосИС Логистика, склад и ТМЦ Разработчик Пользователь 1С:Предприятие 8 1С:Розница 2 1С:ERP Управление предприятием 2 1С:Бухгалтерия 3.0 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Розница 3.0 Россия Платные (руб)
Внешняя обработка для инвентаризации кодов маркировки в системе "Честный знак". Позволяет быстро определить и списать коды маркировки проданного, испорченного, утраченного (полный перечень причин списания указан ниже) товара, которые всё ещё числятся за организацией. Привести в соответствие остатки маркированного товара программы 1С и системы "Честного знака".
6649 руб.
09.01.2024 22179 229 30
Логистика, склад и ТМЦ Бухгалтер Пользователь 1С:Предприятие 8 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Оптовая торговля, дистрибуция, логистика Управленческий учет Платные (руб)
Модуль ответственное хранения в 1С 8.3 для складов и фулфилмент-операторов: учет чужого товара, приемка на хранение, передача, возвраты, акты, адресный склад и работа с товарами поклажедателей.
89900 руб.
09.06.2020 58328 47 60
Загрузка и выгрузка в Excel Розничная торговля Логистика, склад и ТМЦ Ценообразование, анализ цен Прайсы Системный администратор Разработчик 1С:Предприятие 8 1С:Комплексная автоматизация 1.х 1С:Розница 2 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Управленческий учет Платные (руб)
Загрузка номенклатуры из файлов Excel (xls, xlsx, ods, csv, mxl) в УТ11, КА 2, ERP 2, Розница 2. Задействованы все возможности конфигурации - заполнение реквизитов номенклатуры, дополнительных реквизитов и сведений, характеристики, доп.реквизиты и сведения характеристик. Дополнительные обработки для расширения возможностей.
12444 руб.
29.10.2014 237920 777 544
Монитор заказов Оптовая торговля Розничная торговля Учет рабочего времени Логистика, склад и ТМЦ Пользователь 1С:Предприятие 8 1С:Управление нашей фирмой 1.6 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 Управленческий учет Платные (руб)
Модуль для комплексного управления логистикой в 1С. Расширение совместимо с любыми конфигурациями от 1С:УНФ до 1С:УТ и ERP
105000 руб.
11.08.2016 68876 50 62
WEB-интеграция Рабочее место Оптовая торговля Розничная торговля Логистика, склад и ТМЦ Пользователь 1С:Предприятие 8 1С:Бухгалтерия 2.0 1С:Бухгалтерия 3.0 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 1.6 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 10 1С:Управление торговлей 11 1С:Розница 2 1С:Розница 3.0 Оптовая торговля, дистрибуция, логистика Россия Управленческий учет Платные (руб)
Программный продукт "Управление доставками в 1С" позволяет обмениваться с личным кабинетом Boxberry, СДЭК, Энергия, Почта России, DPD, ПЭК, Grastin, Деловые Линии, КСЕ, Dalli, ЯндексДоставка. Упрощает создание заявок и резервирование заказов прямо в интерфейсе 1С
24400 руб.
10.03.2016 76178 321 100
Логистика, склад и ТМЦ 1С:Предприятие 8 Россия Платные (руб)
Подсистема автоматизированного управления складом AS WMS для конфигураций на платформе 1С 8. AS WMS – готовое решение для эффективного управления, хранения и учета на адресном складе. Внедрение системы AS WMS способствует быстрому отбору товара, ускорению инвентаризации, снижению зависимости от персонала, исключению пересорта. AS WMS встраивается в любую конфигурацию на платформе 1С 8 и работает как единая система без обменов. В учетной системе нет необходимости менять процессы под AS WMS (например, вводить ордерную схему), AS WMS использует стандартные документы по товародвижению вашей учетной системы.
50000 руб.
26.07.2023 14530 64 0
Функция СписДетей(Узел, Цепь);
Рез = СоздатьОбъект("СписокЗначений");
ТЗ_Дуги.ВыбратьСтроки();
Пока ТЗ_Дуги.ПолучитьСтроку() = 1 Цикл
Если ТЗ_Дуги.Количество = 0 Тогда
Продолжить;
КонецЕсли;
Если ТЗ_Дуги.Отец = Узел Тогда
Если Найти(Цепь, ТЗ_Дуги.Сын.Код) > 0 Тогда
ТЗ_Дуги.Количество = 0; // Разорвали связь
Иначе
Рез.ДобавитьЗначение(ТЗ_Дуги.Сын.Код,""+ТЗ_Дуги.Количество);
КонецЕсли;
КонецЕсли;
КонецЦикла;
Если Рез.РазмерСписка() = 0 Тогда
Возврат "";
Иначе
Возврат Рез;
КонецЕсли;
КонецФункции
//__________________________________________________________ ПоказатьЭто реализованный в алгоритм получения всех цепочек в графе. Он вполне совпадает с алгоритмом в статье, однако не имеет отношения к запросам. Аналог временной таблицы (очередной) из статьи - это СледСписок (цепочек в графе). Функция СписокДетей - полный аналог Конструкции ВЫБОР (и остатка текста запроса). Разница в том, что в УдлиннитьЦепи у меня явным образом эти цепи перебираются, а у автора стоИт ВЫБРАТЬ (из временной таблицы) и ПОМЕСТИТЬ вместо моего ДобавитьЗначение.
Таким образом, словоформа "ЗапросПротивРекурсии" здесь, пожалуй, неуместна. Возможно, "ЗапросПротивЦикла" ?
Ну, а сравнение цикла (самого внешнего) с рекурсией - это совсем другая тема, подробно обсуждавшаяся в
Где-то тААк вООт...
Я уже писал тебе , что алгоритмов работы с графом - "тьмы и тьмы и тьмы " . Сами по себе эти алгоритмы , как и представленный в этой статье, - очевидны , просты , НЕИНТЕРЕСНЫ. За месяц я просмотрел "тучу" алгоритмов - образцовых, доморощенных, школьных. Если хочешь , еще раз пройдусь по интернету и вышлю тебе сколько нужно похожих алгоритмов : 2 ? 5 ? 10 ? Так вот .
Это истоптанная вдоль и поперек поляна и говорить о первенстве или об авторстве просто смешно .Перебирая реализации , независимо от того "на чём" ? я задавал только один вопрос : "Сколько секунд на тест № 1 ?" . Получал ответ , и говорил автору "спасибо, не нужно."
Цель этой публикации - не изобрести НОВЫЙ алгоритм, а решить "узко-конкретный" вопрос :
КАКИМ ДОЛЖЕН БЫТЬ В СУБД САМЫЙ БЫСТРЫЙ , САМЫЙ НАДЕЖНЫЙ АЛГОРИТМ РАБОТЫ С ГРАФОМ ? И КАК ЕГО РЕАЛИЗОВАТЬ ?
Я ответил на него как мог.
Для тебя лично :
На твоем компьютере (если в нем более 1 Гб оперативной памяти)
в файловом варианте в демонстрационной конфигурации 1сv8 БП 1.6 или БП 2.0 время
выполнения теста №1 "Десять" 25 - 60 сек. (неофициально надеюсь , на 18 сек как у меня )
P.S. На всякий случай, просмотрел тему (у меня IE8) - там четко написано и выделено Жирным щрифтом Тест № 1 "Десять", далее идет таблица с результатами тестирования , в первой строке таблицы две колонки :
файловый вариант --------------------- 25 -60 сек
Т.е. предлагаю обмениваться числовыми характеристиками.
Тогда всё упростится и истина , надеюсь, станет ближе.
Обработка твоя должна быть универсальной , т.е. не "заточкой" для теста №1 с известной регулярной структурой, а эффективной для любого графа. Это значит , и то что алгоритм твой при начале работы - ничего не знает ( не обладает априорной информацией) о характере графа.
Извиняюсь , если обидел таким разжёвыванием.
Сразу оговорюсь: Таблицу, описывающую граф, я создаю не из справочника, а непосредственно. На тесте №1 замерить результат я не смог: он менее секунды. Тогда я к листьям из этого теста прицепил по 10 дуг со случайно выбранными концами (т.е. разузловываем не просто дерево, а с возможными циклами с 10 миллионами возможных путей длины 8). В этом случае разузлование длится около секунды, но заведомо меньше 2-х.
Работал локально, база ДБФ-ная. 1С не перезапускал. Одна хитрость: кроме ТЗ_Дуги я использовал ТЗ_Узлы с колонками "Отец" и "СписокДетей", т.е. описание графа избыточно, примерно как в первоначальном тексте
Прекращайте писать запросы!
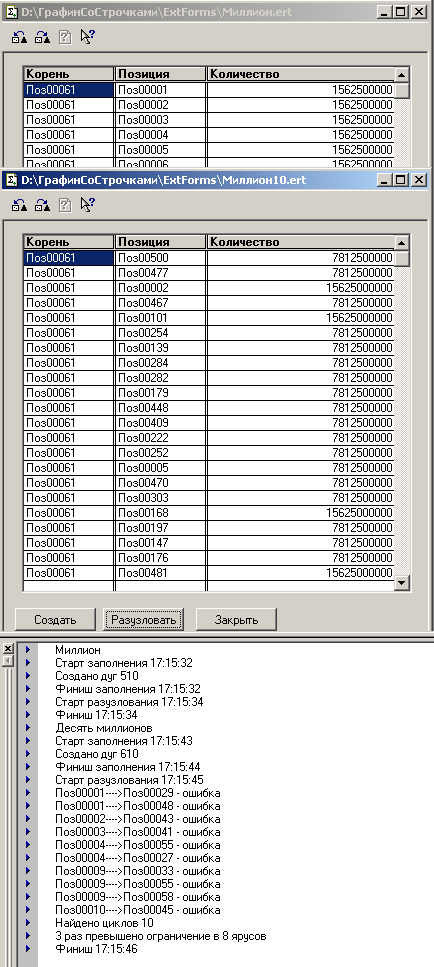
Я полагал , что постановка аналогична той что в текущей теме . Дана таблица значений:
Владелец, Номенклатура, Количество - задается начальный корень "владелец" и всё - поехали !
Или
Родитель, Ребенок , количество - задается начальное значение Родитель" и всё !
Ты уж тогда опиши , что у тебя задано и что нужно найти.
Или представь обработку .ert
Для меня то , что ты написал полный ребус.
Есть конкретный отец.
По ней я делаю еще одну ТаблицуЗначений Отец, Дети
Дети - это СписокЗначений Сын,Строка(Количество) - мне в семерке неудобно искать всех сыновей каждый раз, я уж один раз ее (таблицу дуг) перелистаю.
Потом разузловываю. Все за 1 секунду.
Я даже хлопнул в ладоши - " Это по-нашему ! Ай, да Арчибальд !"
Ты щелкнул "миллионный граф" , как и Сергей, - за секунду и даже не насторожился : этого сделать еще никому и нигде не удалось .
Теперь по существу. Будем плясать от печки - от постановки задачи.
Графы номенклатуры (спецификации) в БД хранится в табличном в виде см. рис. 1 текущей темы . Другими словами , Таблица с колонками
Владелец,Номенклатура, Количество полностью и однозначно описывает любой граф номенклатуры текущей конфигурации.
Любые другие дополнительные структуры для хранения информации о графе ( в твоей обработке это "глТЗ_Узлы") - избыточны, и могут применяться в реальных проектах для ускорения обработки графа. Эта избыточность , как неизбежное зло, приводит к "геморрою" при модификации графа (согласованные изменения нужно проводить сразу в нескольких таблицах и следить за целостностью)
Вот они-то, эти избыточные структуры, и не должны использоваться при решении.
Еще раз. Когда стартует твой алгоритм ( у тебя процедура "Разузлование")
он должен иметь на входе справочник с реквизитами Владелец,Номенклатура,КОличество ( у тебя это таблица "глТз_Дуги") . ВСЁ ! Точка.
В ней должен быть полностью описан исходный граф .
Ты же на входе имеешь две таблицы глТЗ_Дуги и глТЗ_Узлы.
Вот и весь секрет : в миллион раз упростив задачу - ты решил её за секунду.
Для графов существует множество задач, и для решения их могут и должны использоваться разные представления. Для разузлования я выбрал глТЗ_Узлы, формирую эту единственную таблицу простейшим запросом (см. рис.) и при разузловании пользуюсь только ей. Никаких избыточных структур. Решал бы я другую задачу - возможно, я бы использовал еще какое-нибудь представление.
Ну, а дополнительное условие - не преобразовывать структуру - напоминает известную историю, когда у пациента удаляли гланды, а тот по условию должен был держать рот закрытым.
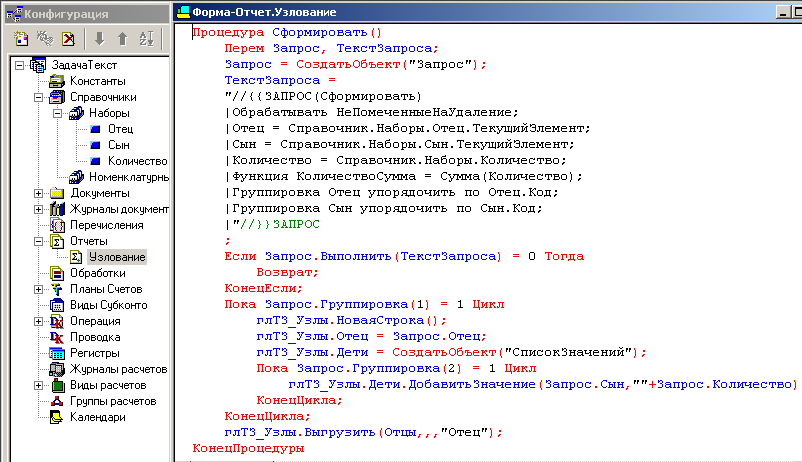
В постановке задачи текущей темы четко сказано, что мы имеем на входе :
Таблицу Владелец,Номенклатура,Количество
( у тебя это Справочник.Наборы со структурой Отец,Сын,КОличество). И Все !
Эта и только эта таблица должна быть известна при старте алгоритма,
все другие структуры должны создаваться внутри процедуры Разузловать(),
по которой мы контролируем время.Это требование настолько элементарное ,
что я не собираюсь его доказывать.
Что же мы имеем в твоей обработке ?
Внутри процедуры Разузловать() идет обращение к таблице глТЗ_Узлы , которая
создана вне процедуры Разузловать(), вне зачета времени.
Серьезное ли это нарушение ? - Отвечаю: Да .
Достаточное ли основание , чтобы прекратить дальнейшее рассмотрение кода ? - Отвечаю : Да .
Вывод : автор обработки решает какую-то свою задачу , отличную от той, которая задана в теме.
Судя по всему , мы говорим каждый о чем - то своём.
В каждом предложении комментарии (2) , уверен , непонимание настолько зашкаливает , что я даже не знаю с какого места начинать разговор.
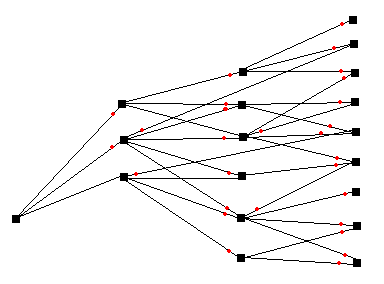
По поводу роста времени я имел ввиду не рост в зависимости от числа уровней, обусловленной природой задачи, а дополнительный рост времени, обусловленный тем, что мы не сворачиваем таблицу после каждой итерации... хотя, Вы, наверное, правы.
Но! - Это легко контролировать при записи каждой спецификации! Так что такой контроль нужно просто перенести в другой модуль - вот такое решение!
Как же сделать , какие предусмотреть дополнительные структуры (справочники), которые :
1. Автоматически изменяются при записи элемента спецификации (изменении узла графа).
2. Обладают "ускоряющими " свойствами при построении графа.
Здесь возможны варианты и варианты. Думаю , это тема отдельного разговора.
Пока выяснять это рано.
( для меня , конечно, потому что я не знаю возможно ли здесь общее решение без привязки к конкретной задаче (конкретному виду графов)).
Ставлю "плюс" на сообщение (2) от Александра (Арчибальд) - ВСЁ сказано.
Однако, автору рекомендую:
1) Провести замеры не для "теплого" запуск своего алгоритма.
2) Подсчитать реальное количество операций ввода/вывода на сервере.
3) Вспомнить, что индексная структура таблицы БД уже есть - "дерево".
Скажу грубо.
Проведено, в очередной раз, тестирование эффективности кэширования системы ввода/вывода ОС-а (для файлового режима) и СУБД (для клиент-серверного режима).
Хотя, я полностью согласен с утверждение автора:
"...встроенных возможностей платформы 1с...вполне достаточно..."
для тех задач, для которых ОНО предназначено. ;-)
P.S.
Поправка к "Автор провёл опрос... для Теста № 1...140-220 сек.".
Без использования 1С.
Для файлового варианта: 35 сек.
Для клиент- серверного варианта: 70 сек.
Алгоритм - тупой обход "дерева" рекурсией или циклом (не имеет значения).
И это время не зависит от "вида дерева".
Рабочих таблиц в алгоритме не создаётся.
Исходная таблица не подвергалась "ревизии".
Т.е. никаких дополнительных полей, индексов, фильтров и т.д. - не создавалось.
Теперь, к сожалению , о более общих вещах.
Для кого-то совершенно очевидных , для кого -то - нет.
Владимир , поверьте мне - не мы первые спорим в этом мире .
Размышлизмами можно делиться до бесконечности.
За тысячи лет человечество выработало некие правила, азы ведения споров, выяснения ,(пусть и несовершенного) некоторого приближения к истине.
Первое правило : наличие критерия. Я его предложил в теме : тест №1 и тест № 2 и вопрос СКОЛЬКО ?
Если Вы его не принимаете ( имеете право !), то предлагайте свой или закончим.
Если принимаете то :
Приводите результаты тестирования :
Ваш вариант (кратко какой ) :
1. Номер теста .
2. Время выполнения.
На той же машине - мой вариант (файловый или клиент -серверный) :
1. Номер теста .
2. Время выполнения.
На одной одной машине объективно сравниваются два разных решения.
Сравнение - есть основа анализа. Никакого анализа без сравнения быть не может .
Вы понимаете ?
Приводить одни результаты без приведения результатов для альтернативного варианта - бессмысленно. Если результаты будут сочтены интересными обеими сторонами, то стороны разбираются и выясняют, как могут, истину.
Но вначале ( Внимание !) не размышлизмы, а факты. Вы готовы к такому конкретному разговору ?
Если что-то показалось обидным - то виноват .
Но как еще проще объяснить , совершенно очевидные вещи - я просто искренне не знаю. Мы играем по правилам , или мы не играем вовсе.
Игорь.
Вы не читаете мои сообщения. :-(
1) "На одной одной машине объективно сравниваются два разных решения."(с)
С самого начала обсуждения я Вам сказал, что сравнивать абсолютными величинами - бред. Сказал Вам, что еще и разные среды программирования, разные СУБД, разные ОСы и т.д. Нет! Вы упорно хотели получать от меня абсолютные величины. Вы их получили...
И вы теперь меня спрашиваете: "Вы понимаете ?"(с)
2) "...меня не интересуют алгоритмы ,как таковые. Меня интересуют объективные тесты"(с)
Тесты - чего? Тесты "результатов"?
3) "Сравнение - есть основа анализа. Никакого анализа без сравнения быть не может."
Вам на протяжении всей темы про запросы предлагалось сравнивать.
4) "Вы готовы к такому конкретному разговору ?"
Я, давно, с Вами веду конкретный разговор. И не получаю ответов на самые просты вопросы. Ну хоть на пункт #2 из сообщения #15 - дайте ответ.
5) В моём сообщении #15 есть "P.S.", как замечание к конкретным данным из Вашей публикации. Но есть и другой текст. Вы его прочли?
Как говорится: "Платон мне друг, но истина дороже!" -
Я переписал свой алгоритм на Ваш случай - типовую БП (хранение спецификаций в отдельном справочнике).
У меня получилось (только файловый вариант):
Тест №1 - 0,468 сек.
Тест №2 - 0,172 сек.
Как будете проверять?
Вообще я приложил к своей статье внешний отчет для БП, но сам его на БП не проверял (у меня в базе только минимум объектов).
Давайте договоримся о сценарии тестирования и сравнения.
Итак, сравниваются две универсальных обработки работы с графом
Первое. Нужно выбрать площадку(среду) для сравнения.
Предлагаю демо-конфиграцию БП 1.6 или БП 2.0.(как самую распространенную конф-ию) .Она должна быть у Вас и у меня.
Второе. У Вас и у меня должны быть сравниваемые внешние обработки.
Обе обработки должны быть тщательно отлажены и проверены авторами в БП1.6(2.0).
Чтобы не было возгласов "Ой! я тут исправлю - ой! тут не проверил".
Т.е. по-врослому.
Третье.Авторы обмениваются произвольными тестами заполнения Справочника СпецификацииНоменклатуры и сравнивают результаты тестирования.
Если три пункта (совершенно очевидных) принимаются, то начинаем .
Если ДА, то первым тестом от меня будет граф 1-10-10-10-10-10-10 со всеми уникальными значениями. Ведь у нас с Вами не заточки под тесты №1 и №2, а универсальные обработки для работы с графом. А для универсальных обработок
первое свойство - работоспособность и устойчивость. Вначале его проверим , а потом уж будем соревновать в скорости.
Договорились ?
1. БП 1.6.
2. Мне потребуется денек (отвлекают тут меня) на тщательную отладку (на всякий случай).
3. Согласен.
4. Первый тест принимается.
5. Еще хотелось бы электровоз найти. Хотя бы без наименований в виде списка (Код-Код-Количество).
5. Приз - "плюсик" к статье от проигравшего победителю.
6. Разумные сроки на ответы (не часы).
Какой вариант выберем в качестве основного ?
Файловый или клиент-серверный ?
(обычно сравнения и тесты делаются для клиент-серверного варианта , как более устойчивого и предсказуемого на больших объёмах, но - дело Ваше)
(просто у меня трехзвенка только на работе)
Теперь об удобстве сравнения и анализа. Сравниваемые обработки должны обладать таким развитым интефейсом,
чтобы пользователь мог быстро интерактивно проверить созданный граф, внести специальные ошибки и посмотреть результат. Не буду же я гадать правильно ли создан огромный граф рассматриваемой обработкой или нет ?
Т.е. я это должен сделать интерактивно как пользователь , а не ковыряя чужой код, и не ломая голову над созданным графом в виде таблицы.
Иначе пустые споры : "правильно-неправильно" затянутся , как у меня с Владимиром.
Предлагаю (но не настаиваю) скачать обработку ЗапросПротивРекурсии.epf и посмотреть как в ней решены вопросы контроля и какие созданы средства для быстрой проверки.
Еще раз - мы рассматриваем вопрос как создать удобные и быстрые средства контроля и анализ ошибок , а не сам алгоритм (он у каждого свой). Грубо говоря - договоримся и создадим оснастку
Игорь.
Спасибо за замеры.
Однако в этих замерах "SQL сервер не перезапускался"(с).
Т.е. такие замеры меня не интересуют.
(0)
По публикации.
Автор, в очередной, раз доказал (показал) что один запрос лучше, чем много. ;-)
Для этого была выбрана одна из самых неудобных задач в теме реляционных СУБД - обход дерева. Добавлено несколько дополнительных условий, усложняющих решение задачи методом простого обхода дерева - проверка цикличности, подсчет "изделий". Использовались термины не относящиеся к сути задачи - "рекурсия", "разузлование", "спецификация". При сравнении различных методов (не алгоритмов!) обработки информации применялись подтасовки фактов. Например: замеры от разных людей в разных средах, самостоятельное "тестирование" рекурсии...
И сделан очевидный вывод, что лучше когда вся "тяжесть вычислений (99.9%) ложится на сервер БД"(с).
Автор не утруждается анализом "процессов" происходящих на сервере. Типа, "с глаз долой из сердца - вон". На мои просьбы провести "подсчет" количества операций ввода/вывода на сервере - не отвечает. Вопрос кэширования на стороне сервер автора не интересует. Допустим, мы выделили каждому пользователю свой сервер. Или поставили один - ооо-чень мощный компьютер (сервер). Но выделить каждому пользователю свою базу данных у нас, не очень, получится. Т.е. задача сервера - не только обеспечивать "мощей" пользователей, а еще и обеспечивать доступ к общим данным. И это одна из важнейших задач сервера БД. В разных СУБД (и их ЯМД) используются различны инструменты для обеспечения пользователям "одновременный" доступ к информации. Кроме самих инструментов СУБД используются еще и "смысловые" приемы при разработке приложений - специфичная схема БД, разбиение задачи на "отчет" (только чтение) и обновление, интерактивный или пакетный режим и т.д.
К чему, я это всё.
А к тому, что автору имеет смысл определиться - он "обход дерева" делает для отчета (выходной формы) или еще для чего. Судя по выбранным инструментам (запрос) - для отчета. Отчета для подсчета количества "изделий в спецификации". Посчитали - напечатали. А если в момент подсчета другой пользователь изменил "дерево"? Нельзя такое допускать в выбранном автором алгоритме раскручивания дерева (или можно?). Решения два - блокировать всю исходную таблицу, ведь "мы ничего не знаем о дереве"(с) или создавать полную копию исходной таблицы, блокируя ей на момент копирования. Первое - понятно. Т.к. 20 секунд блокировки при множестве желающих работать (не только отчетами) с "деревом" - многовато... Второе - лучше. Благо таблица маленькая и копируется только средствами центральной машины. Но тогда это "чистый отчет". Т.е. никакого воздействия данными отчета на исходную таблицы БД - невозможно. Но тогда почему её не передать клиенту, и не сделать обработку на машине пользователя любым, красивым, методом. Передача - один запрос, по сети за две секунды (для таблицы в 1111111 записей), а без сети - 1 секунда.
Но в реальной жизни с иерархическими структурами НАШИХ задач работает множество пользователей одновременно (интерактивно). Одни смотрят, другие обновляют. И СУБД должна обеспечивать всех пользователей достоверной информацией. Способы такого обеспечения известны - блокировки. Но это другая тема. ;-) В этом важно только одно - быстрое чтение/обновление минимального количества узлов дерева за одну "транзакцию". Т.е. в запросной технологии - запрос на узел дерева (грубо говоря). Без запросной технологии "чтение/обновление" узла без запроса. ;-) Но т.к. алгоритм обработки гораздо сложней чем подсчет изделий, то осмелюсь предположить, что на обработку одного узла придется выполнять либо множество запросов, либо осуществлять его обработку на стороне клиента.
Т.е. подводя итог моему, сумбурному, изложению предлагаю тему "Мы пишем запросы" переименовать в "Мы пишем отчеты запросами". А для отчетов самое оно - использовать запросы. Нужно только изменить схему базы данных под этот инструмент. Что в продуктах 1С и сделано. И никаких задач типа "обход дерева", "нарастающие итоги" и т.д. Для НАС таких задач просто не существует... ;-)
- Почём твоя скотина , ковбой ?
- Что Вы знаете о скотине , мистер ... В далекие времена , когда воды Миссисипи были полны и скотина бегала сама по себе...
- Почём твоя скотина , ковбой ?
Понятно , что мистер ничего не знает о скотине, а ковбою есть что сказать о труде животновода и вопрос о качестве мяса ой-как непрост .
Но нужна числовая характеристика в виде цены как некий ориентир, стоит ли продолжать разговор ?
Нужно узнать хотя бы порядок цены . Рассказ животновода о качестве скотины , как он его понимает, можно потерпеть и послушать в одном случае - когда объявляется цена в приемлемом диапазоне. Понимая , что вопрос быстродействии каждого алгоритма очень непрост , тем не менее нужен какой-то ориентир , начальный критерий отбора для реализации решения конкретной задачи "разузлования". Этот критерий - время исполнения по тесту № 1 должно лежать в диапазане 15-30 сек для "среднеофисных"
рабочих станций и для "среднеофисных" серверов. Пусть грубо, пусть много"НО" - но критерий есть.
Почему такой ? - потому что, тогда в реальных "немиллионных" задачах быстродействие
будет более, чем удовлетворительным.
А теперь подумайте , будет ли "мистер" слушать рассказы о непростой работе сервера при объявлении "цены" алгоритма в 200 сек, когда нужно 20 ?
Не судите строго "мистера", когда он обрывает собеседника :
Так, почём твоя скотина, ковбой ?
Игорь.
Вы всё о "числах" говорите.
А я Вам говорю, что Ваш алгоритм не работает.
Что толку считать за 20 секунд на тестовой задаче.
Примеряться к реальной 20/10=2 сек., если он НЕ РАБОТАЕТ.
Я Вам выдал все замеры с пояснение - где работоспособный алгоритм проигрывает. Дал заранее (!!!) опровержение Вашего утверждения про "что 1с-овский интерпретатор неэффективен ?"(с) Пояснил, на пальцах, почему используется в реальных задачах обход дерева "по всем вершинам". Попросил Вас провести замеры Вашего алгоритма в реальных условиях - мимо. Выдал "числа" близкие к "заветному числу", но для работоспособного алгоритма - мимо. И т.д.
Я не ставлю "минусы" за реально проделанную работу автором.
Ставил "минус", только, на публикации украденные или нарушающие правила ресурса.
Но за такую "работу" поставлю.
Халтура и верхоглядство это.
Да еще и с элементами откровенного вранья.
Только не понимаю - зачем Вы это делаете... :-(
В статье приведен взгляд автора на оптимальный алгоритм работы с графом, приведены результаты такого тестирования , которое доступно автору.
Прикреплен файл с реальной обработкой в реальной среде Демо-конфигурации БП 1.6.
Желающий может всё проверить .
Конкретная же цена Ваших альтернативных решений 140- 220 сек - слишком высока для мистера.
Что же до минуса ... Никаких обид.
Про Ваши замеры - "специально для меня".
По поводу строчки "вылетело SQL".
На "моей" СУБД стартовый объем занимаемой памяти - 254 мегабайт.
В процессе обхода дерева в миллиард вершин дошло до 320 мегабайт.
Рабочих таблиц не использую... ;-)
Так что посмотрите обработку для УПП в прикрепленном файле.
Разузлование проходит быстро, ошибки зацикливания тоже ищутся.
Поэтому , строго говоря , в код обработки должны быть внесены изменения :
во временную таблицу Спецификации (процедура КнопкаВыполнитьНажатие()) должны копироваться не все спецификации , а только те, для которых установлено в регистре что это основная спецификация . Примерно так .
Если сможете сделайте - я выставлю в теме это как Ваш файл .
И еще одна просьба : приведите , пожалуйста пример насколько быстро разузловывается "самая большая Ваша номенклатура".
{Форма.Форма(34)}: Ошибка при вызове метода контекста (Выполнить): {(2, 14)}: Поле не найдено "Спец.Ссылка.Владелец"
Спец.Ссылка.<<?>>Владелец КАК Владелец,
Запрос.Выполнить();
по причине:
{(2, 14)}: Поле не найдено "Спец.Ссылка.Владелец"
Спец.Ссылка.<<?>>Владелец КАК Владелец,
"работа же с памятью практически всегда будет эффективнее ... объем информации в данном случае не имеет значение, т.к. на себя эту задачу берет операционная система..."(с)
Ярослав.
Поиск волшебных палочек продолжается? ;-)
У Игоря - "запросы". У Вас - "операционная система".
В моём сообщении #33 не опечатка в части количества записей.
Т.к. у меня формат таблицы от "1С 7.7", то это около 77 гигабайт.
В "1С 8.х", думаю, размер записи больше будет.
Читайте таблицу в память, считайте время закачки, покупайте новый "сервер"...
Истин общих - нет.
Если рассматривать вопрос в контексте данной темы , то в статье как раз и показано что запрос эффективнее, чем использование рекурсии в оперативной памяти. И намного.
См. Рис.9 в теме.
Ярослав.
1) "все что касается работы с памятью прикладным программистам не доступно"(с)
Доступно.
2) "за это отвечает операционная система"(с)
Допустим. Но размер используемой памяти "заказывает приложение". Существуют ограничения количественные и "качественные" (одновременный доступ к данным с разных ЭВМ). И для уменьшения потребного размера необходимо в памяти иметь только нужную и возможную информацию. Этим, в частности, и занимается СУБД. А если в одной таблице, например, лежат "деревья" для разных "тепловозов" и требуется обработать конкретный "тепловоз" - надо отобрать нужные данные из таблицы БД. В схеме БД в постановке от Игоря - отобрать нужные данные равносильно решить конечную задачу.
3) "за это отвечает операционная система и что код будет работать быстрее"(с)
Для обсуждаемой темы, нет никакой связи в ответственности ОС-а и скорости кода.
4) "если это будет работа с массивами данных в памяти, а не запросы..."(с)
Безусловно. Остаётся НУЖНЫЕ данные рационально положить в память.
(53)
"Прекращайте писать запросы!"(с)
Александр.
А если нету никаких других средств обработки данных в БД?
И даже в НАШЕЙ "1С 7.7" SQL-ной версии всё делается запросами.
Для примера (примера !!!).
Метод ВыбратьЭлементы().
В DBF-ной версии ничего не выбирается. Это только установка на первую запись множества. А в SQL-ной версии это передача от сервера клиенту всего множества элементов справочника. А если они все не нужны приложению? А если приложение вызывает этот метод многократно?
ЗЫ И вообще некорректно сравнивать рекурсию с запросами. Запрос - это выборка из БД. Рекурсия - это способ перебора различных списков. Можно пользоваться запросами вместе с рекурсией. Рекурсия дает минимальный и прозрачный код. Перебор не очень очевиден и удобен - посмотрите сколько строк вы написали, чтобы сделать обход дерева. Если говорить о скорости - иногда приходится отказываться от рекурсии, но не всегда и не обязательно.
ЗЗЫ. Если говорить о задаче разузловки - я бы использовал рекурсию, запросы и кэш (либо ввиде временной таблицы, либо ввиде соответствия).
Как гипотеза - принимается.
Добиться каких-то практических результатов от специалистов по TSQL не удалось.
Сам испытываю от такого подхода предельный скепсис, но буду рад , если появятся какие-то решения уже скорее не на ИС.
Но от рекурсии отказался из-за тормозов и не поленился написать вложенный 6 раз цикл.
Так было быстрее. Правда , потом оказалось , что одно изделие имеет уровень 7...
Если же перейти к реализациям на 1с8 , то думаю , здесь рекурсии делать просто нечего. Огромный проигрыш. Известные мне реализации проигрывают поуровневому обходу графа "в лоб" (сверху-вниз) , описанному в теме , от 7 до 10 раз.
Мой прогноз : в 1cv8 c кэшем ли , без кэша ли, с повторным расчетом узлов (хотя не могу себе такого представить), без повторного расчета узлов (только так ,разумеется) рекурсионный подход проигрывает. Проигрывает жестоко , безнадежно.
Да , ладно бы речь о каких-то блохах, скажем,
рекурсионная реализация на "миллионном" тесте № 1 дала 40 сек против 20 сек (всего лишь в 2 раза).
Тут многое можно оспорить в условиях эксперимента , можно привести миллион причин почему это произошло
и требовать пересмотра условий. Даже 80 сек (в 4 раза)еще не дает гарантий. Но 140 сек(в 7 раз) - это перебор.
С другой стороны , конечно , это всего лишь эксперимент одного автора на ИС . И не более того.
В свободное время, смеха ради попробуйте реализовать Тест №1 и запустите свою обработку графа.
Может быть , Вы меня опровергнете ?
Опубликую в теме сразу : так мол и так, Huse доказал... и опроверг все построения автора.
Обещаю.
Моя обработка запускается в любой конфигурации БП1.6(2.0) для платформы 1с8.
Ничего не требует. По кнопке запускается тестовое заполнение миллионного теста и "кнопка выполнить". Всё. См. Рис.9 темы.
|SELECT '" + РадугаСервис.ЗначениеВСтрокуБД(ЗначениеФильтра) + "' ID Into " + ИмяВремТаблицы + "
|
|While @@RowCount > 0
|INSERT INTO " + ИмяВремТаблицы + "
|SELECT
| Спр.ID
|FROM
| $Справочник." + ЗначениеФильтра.Вид() + " Спр
| LEFT JOIN " + ИмяВремТаблицы + " ВремТаб (NoLock) on ВремТаб.ID = Спр.ID
|WHERE
| ParentID In (SELECT ID FROM " + ИмяВремТаблицы + " (NoLock))
| And ВремТаб.ID Is Null
|
|If (SELECT Count(*) From " + ИмяВремТаблицы + " (NoLock)) > 100
| Create Index " + СтрЗаменить(ИмяВремТаблицы, "[#", "[#IX_") + " on " + ИмяВремТаблицы + " (ID)
|";
Это, кстати, от неявной рекурсии принципиально мало чем отличается....
Но за популяризацию идеи - несомненно плюс.
Здесь я вижу один из альтернативных подходов к задачам , подобным "разузлованию" :
откажемся от встроенных возможностей платфомы 1с как неэффективных ! -
и во внешней обработке обратимся к базе 1с через ADO- соединение.
Ну и как ? Насколько помогло ? Каков максимальный граф ? и каково время обработки графа ?
Да это кусок из 1С++ класса, строящий фильтр по условию вхождения в группу справочника.
Для осьмерки, на сколько я знаю, ни метапарсера толкового, ни преобразователя "ссылка <-> идшник в базе" нет.
ЗЫ там, кстати, еще и ошибка сделана - одного Нолока не хватает.
Пойду
Я просто хочу быть понятым.
У тебя на входе Справочник.Наборы , который я как-то хитро неизвестным тебе образом задал. В нем не один граф, в нем все графы номенклатуры предприятия.
Задаю тебе точку входа и ВСЁ.
Если ты рассмотришь задачу под таким углом зрения - ты всё поймешь. Именно так она ставится в реальных задачах разузлования. Так она стоит и у меня.
Другие разновидности задачи - ТРИВИАЛЬНЫ.
(81) Мало того , тест № 2 (20 уровней), такой же миллионник как и Тест№1, приведен здесь для того , чтобы утверждать универсальность обработки:
представленная обработка обработает граф произвольного вида до 20 уровня с миллионом уникальных узлов за время за 120-300 сек + время копирования справочника+время выгрузки миллиона элементов на форму в табличное поле.
Итого примерно 120-400 сек.
(82) Мой универсальный алгоритм будет работать тем дольше, чем больше уникальных узлов он обрабатывает.
Мы имеем граф (1-10-10-10-10-10-10).
Твой алгоритм пошагово модифицирует граф:
1. (10)-10-10-10-10-10
2. (100)-10-10-10-10
3. (1000)-10-10-10
4. (10000)-10-10
5. (100000)-10
6. (1000000)
И в результате обрабатывает 1 111 111 элементов.
Мой алгоритм:
1. 1-10-10-10-10-(10)
2. 1-10-10-10-(10)
3. 1-10-10-(10)
4. 1-10-(10)
5. 1-(10)
6. (10)
И в результате обрабатывает 60 элементов.
Если граф будет
1-10-100-1000-10000
Твой алгоритм:
1. (10)-100-1000-10000
2. (1 000)-1000-10000
3. (1 000 000)-10000
4. (10 000 000 000)
Будет обрабатывать 10 001 001 010 элементов
Мой алгоритм:
1. 1-10-100-(10000)
2. 1-10-(10000)
3. 1-(10000)
4. (10000)
Будет обрабатывать 40 000 элементов
Если не веришь - напиши тест №4 и убедись.
1. Запустил файловый режим.
Нажал твою кнопку "Выполнить1" для специально приготовленного миллионного теста с уникальными узлами .
Примерно через 25 мин . через диспетчер задач прервал выполнение 1сПредприятия.
2. Взял Тест №1. Интерактивно ( табличное поле Спецификации это позволяет) внес в спецификации зацикливание. Дальше смотри рисунок .
2.
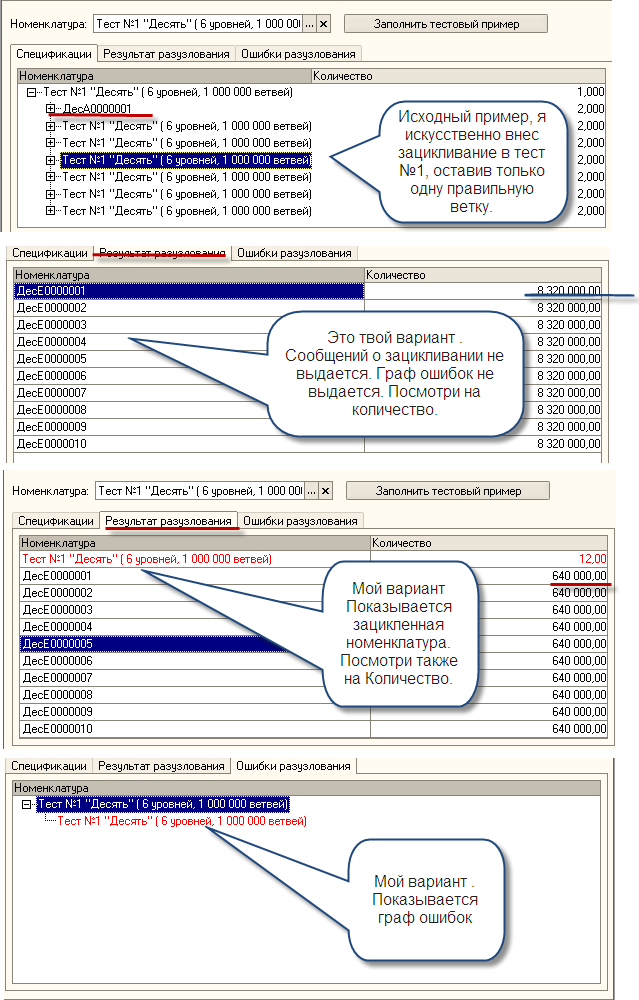
Вместо того чтобы чему то научиться из моего кода, ты предпочел придумывать ситуации где он не работает. Зачем тебе тогда этот пост? Покрасоваться?
PS Моя единственная цель написания кода - было реабилитировать рекурсию. Рекурсию я реабилитировал, а тебя убеждать или заставлять выполнять какие то обещания, которые ты опрометчиво надавал - это не ко мне.
Еще раз : здесь рассматриваются не обработки "заточки", чтобы быстренько решить тесты №1и №2, а универсальные обработки больших графов с обязательным контролем зацикливания. Тесты же №1 и №2 - это быстрые заполнялки при минимальном объеме информации.
Если рассматриваются "универсальные" обработки , то первым испытанием было :
проверить устойчивость на миллионном графе (1 111 111 уникальных узлов) твою обработку. Т.е. Если размер Справочника СпецификацииНоменклатуры вырос в десятки тысяч раз - то это не должно так существенно сказываться на твоей обработке.
Твоя обработка была прервана примерно через 25 мин. Если желаешь - я скажу тебе
точное время. А лучше сам напиши тест заполнения по Тесту №1 только уникальными значениями.
Вторым условием - было правильный контроль зацикливания. Он у тебя отсутствовал.
На Рисунке к посту (88) -всё есть.
Все выводы (88) ты можешь подтвержить или опровегнуть самостоятельно. И рассказать здесь - что не так. И где я не прав.
Пока же результаты (88) настолько красноречиво играют против рекурсии , что по-моему каких-то комментариев более не нужно.
(84) Huse , надеюсь мы закончили тестирование и вопросов больше нет.
(89) Арчибальд, мне нужно от тебя словесное уведомление ,
1. Что на входе алгоритма (процедура Разузловать()) у тебя только справочник Отборы структурой Отец , Сын, Количество и одна выбранная Позиция номенклатуры и ВСЕ !
2. Я могу заполнить твой справочник как угодно , каким угодно по виду миллионным графом с уникальными элементами или с любыми зацикливаниями и твоя обработка а ) не вылетит б) покажет хотя бы строкой все зацикленные ветки , которые я внес.
Арчибальд .Без таких явных двух словесных подтвержений тестирование обработки и контроль бессмысленно.
(91) Ildarovic, тоже жду словесного подтверждения :
1. Ваша обработка должна быть работоспособной в БП 1.6 (2.0), предыдущая обработка была с ошибками и вылетала. Разбирать код её я не стал.
1. Что на входе алгоритма у Вас только справочник СпецификацияНоменклатуры одна выбранная номенклатуры и ВСЕ !
2. Я могу заполнить Ваш справочник как угодно , каким угодно по виду миллионным графом с уникальными элементами или с любыми зацикливаниями и Ваша обработка
а ) не вылетит б) покажет хотя бы строкой все зацикленные ветки , которые я внес.
Сергей, Без таких явных трех словесных подтвержений тестирование обработки и контроль бессмысленно.
Дополнительно для Сергея.
Сравнительная таблица которую Вы прислали стоит очень недорого. Надо начинать с проверки устойчивости и правильности Вашей обработки. И мы начнем с проверки миллионного теста со всеми уникальными значениями.
Дополнение. Всеми этими свойствами , разумеется обладает представленная в теме
обработка ЗапросПротивРекурсии.epf . Т.е. вопрос :
Почём твоя скотина , ковбой ?
- я задал вначале себе.
1. Обработка работоспособна в БП1.6, приложена к статье. На предыдущей было черным по белому написано - "для БП (не проверялась!)".
1. Именно так - на входе ссылка на разузловываемую номенклатуру.
2. Заполняйте справочник как угодно. Обработка а) не вылетит б) покажет узел, входящий в цикл (выдача цепочки не нужна (обосновано в тексте программы) и на быстродействии не сказывается).
Можете привязаться только к пункту 2б, но это бессмысленно. Мне просто не хотелось идти у Вас на поводу и делать проверку цепочки таким ненадежным способом как поиск кода (наименования) в строке пройденного пути - ведь об уникальности кодов (наименований в справочнике мы не договаривались!). Перечень цепочек может быть слишком большим и не говорит о конкретном месте ошибки. Нужен анализ, который у Вас тоже не делается.
Также можете попривязываться к тому, что я делаю засечку "финиша" в момент возврата результата в виде соответствия - требование вывода в табличный документ ? появилось позже. Вывод (уточните для меня еще раз, куда) сразу сделаю.
А все таки пришлите свою заполнялку для дерева 1 111 111, чтобы я мог убедиться в послойном заполнении, можете проверить мою - работает не три часа, в 1,5 - рекурсия ;) !
1.требования вывода в табличный документ - у меня нет. Если есть то укажите.
Результат разузлования должен выводится на форму в виде табличного поля (таблицы значений).
2. Как же пользователь узнает где ошибка в графе ? как он её будет искать ?
У меня выдаются первые 100 ошибок в виде графа - причем именно там где они произошли (можете убедиться ) и пользователь может интерактивно их тут же исправить. Скажите как я проконтролирую правильность вашей обработки если мне выдастся просто сообщение для миллионного графа : элемент такой -то ? где его искать и в каких местах спецификации если он повторяется в 1000 спецификаций и лишь в одной из них он зацикливается ??
В условии задачи указана БП 1.6 - в этой конфигурации в справочнике Номенклатуры коды уникальны.
Что предложите ?
1. Сколько цепочек будет выведено как циклические (без ограничений 100), если в тесте №2 ввести в две спецификации нижнего уровня две разных номенклатуры первого (уровни с нуля) уровня. Как выбрать ошибочную связь? (На самом деле в цепочках нужно посчитать дуги и проверить только самые часто встречающиеся - такой результат будет самым точным, но такой анализ выходит за рамки задачи).
Я бы предложил для поиска ошибок отдельную процедуру (функцию), на вход которой подается ошибочный узел из моего диагноза.
Вывод перепишу.
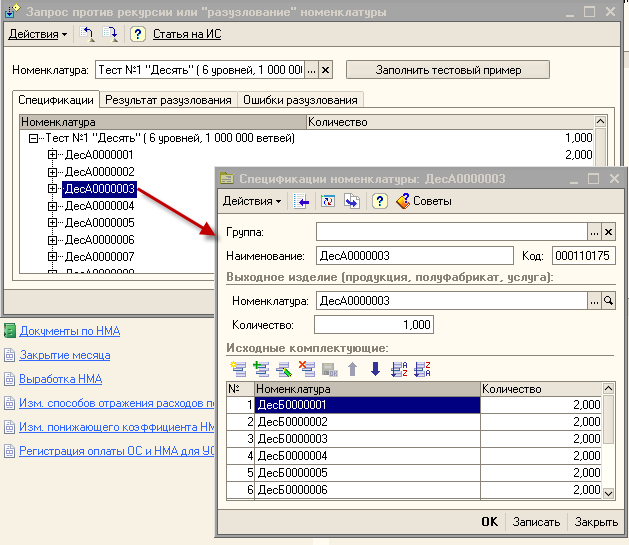
В демо БП запустите обработку. Заполните тестовый пример Тест № 1.
В табличном поле спецификации появится сформированное дерево с корнем Тест № 1.
Интерактивно открывайте любую ветку появится форма элемента справочника "СпецификацияНоменклатуры" -
исправляйте её как хотите. Вносите зацикливания и смотрите на странице панели "Ошибки",
что получится после "кнопки выполнить".
Только , Вадимир, в 8-ке два пользователя параллельно могут открыть форму элемента справочника.
При записи, правда, у последнего из двух попытавшихся записать этот элемент возникнут проблемы .
Игорь, спасибо за пояснения отличий 8-ки от 7-ки. ;-)
Но, не про "проблемы" записи я Вам напомнил.
Прочтите, пожалуйста, моё сообщение #32 целиком.
Там есть слова: "Т.е. никакого воздействия данными отчета на исходную таблицы БД - невозможно". Готов дать пояснения...
P.S. Еще раз не удержусь - напишу.
Мне очень понравилось сравнение НАШЕЙ темы с "ковбоем, мистером и скотиной".
Однако у "скотины" кроме цены есть еще масса характеристик.
И если "мистер" собирается покупать "скотину" для людей или себя, то он, прежде всего смотрит на "скотину". А уже потом справляется о цене. И обсуждает разные нюансы выращивания "скотины".
А если "м..." собирается перепродать "скотину" и наварить на этом, то это уже другое название покупателя на букву "м". Его интересует прежде всего цена...
Игорь.
Вы, опять, в моих сообщения читаете только знакомые Вам слова. :-(
P.S.
Всё - я "отписываюсь" от данной темы обсуждений.
Пора заняться написанием очередного отчета для пользователей (людей).
У меня же нету СКД... ;-)
Свои исследования я на этом заканчиваю, научившись по ходу дела быстро обрабатывать большие графы в памяти.
Вот моя итоговая таблица

По результатам закономерности из (113) смогу синтезировать тест в пользу любой гипотезы. Синтетические тесты, поэтому, малоинтересны.
Даешь ЭЛЕКТРОВОЗ!
Поднимитесь вверх по теме и посмотрите . что произошло с обработкой Huse на нерегулярном графе ? Не сделано главного : Ваша обработка не проверена на работоспособность и устойчивость на специально для этого созданном графе.
Ваша обработка же универсальная , устойчивая, работоспособная.
Неужто неинтересно узнать правду , что произойдет с Вашей обработкой в миллионном графе с нерегулярной структурой ?
А если речь о специально созданном тесте, то вот Вам тест из моего ФОКУСА - "Матрешка".
Создайте спецификацию всем известной матрешки из вложенных друг в друга миллиона матрешек (пусть это будет тест №5). Вообще определите максимальную вложенность матрешек, решаемую Вашим методом. За
вначале мы разберемся с обработкой Сергея , а потом обсудим обработку Арчибальда.
Я скачал обработку Сергея из его темы с названием что-то вроде : "Супер-быстрая обработка для БП 1.6".
Постараюсь сегодня доложить результаты .
1. Что на входе алгоритма (процедура Разузловать()) у тебя только справочник Отборы структурой Отец , Сын, Количество и одна выбранная Позиция номенклатуры и ВСЕ !
2. Я могу заполнить твой справочник как угодно , каким угодно по виду миллионным графом с уникальными элементами или с любыми зацикливаниями и твоя обработка а ) не вылетит б) покажет хотя бы строкой все зацикленные ветки , которые я внес.
По первому пункту ДА.
По Второму пункту. а) ДА, б) при нахождении каждого зацикливания сообщается начало и конец ветки и ветка "обрезается". То есть ДА.
Дополнительно: я явно указываю предельную длину цепочки. При превышении цепочка обрезается. Однако этот момент не критичен, можно этого и не делать - работоспособность сохраняется.
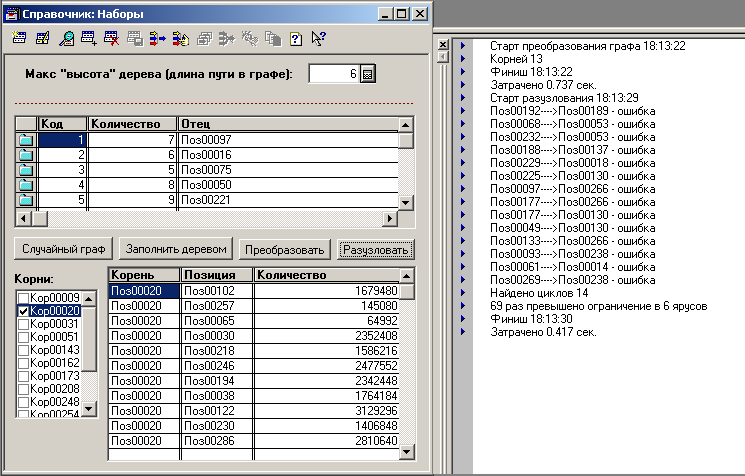
Корень-Эл357-Эл31-Эл11-...Эл20- Эл54-Эл78--...Эл20.
Эту строку - ветку от корня я увижу целиком ? как сейчас на экране ?
так , как в моей обработке (только в строковом виде ) ?
P.S. Прошу поверить это не дурь и не придирки -
иначе я не проверю правильность контроля зацикливания.
не найдет её и пользователь, который работает со спецификациями, тот для которого всё и предназначено.
ты мне мне ответишь какую ветку (в виде строки выдаст твоя обработка).
А пока другой пример попроще,из моей обработки.
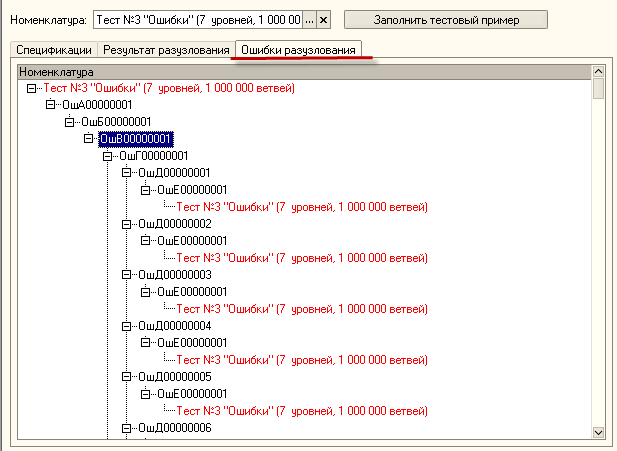
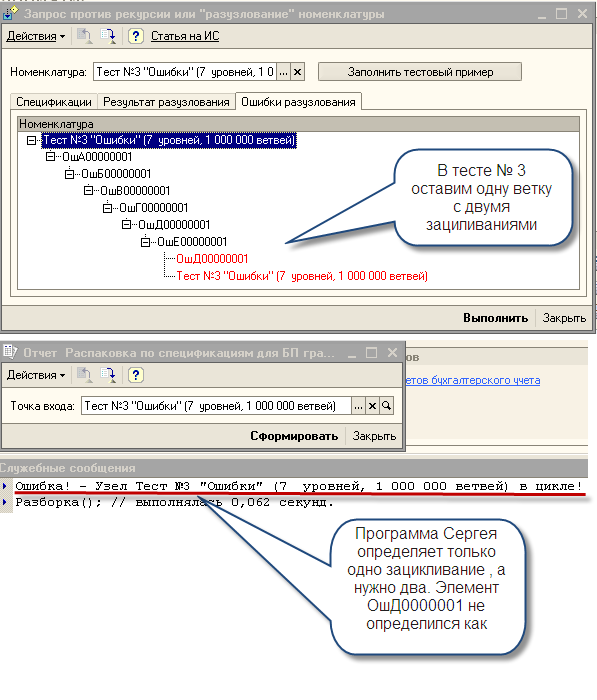
Номенклатура "Тест №1 "Ошибки" была специально зациклена на 7 уровне.
И программа выдала все ветки ошибок.
В предыдущем посте я неправильно сформулировал .
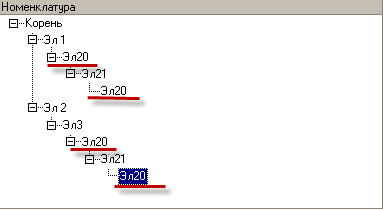
Я ожидаю увидеть у тебя две ошибочных ветки в виде строк :
Корень-Эл1-Эл20-Эл21-Эл20;
Корень-Эл2-Эл3-Эл20-Эл21-Эл20;
Почему ?
Потому что , что же я буду лазить по всем спецификациям и искать где он еще встречается ?
Всего должно получиться 6 уровней и 1 111 111 уникальных узлов.
Каждый самостоятельно исследует свою обработку на этом графе и сообщает здесь результаты ( если сочтет это возможным).
Цель - узнать цену своей обработке в реальных "боевых" условиях.
Напоминаю , у нас с Вами "универсальные" обработки и должны незначительно зависеть
от повторяемости элементов в графе.
Результаты приводим для теплых(второй , третий) запусков обработки.
Если нужно потом рассмотрим и холодный запуск, а пока только теплые.
Два режима - файловый и клиент-серверный.
То есть Вы вообще не читали мои посты: про ФОКУС, про деревья - это все про данный тест. :cry: Я писал их, зная результаты работы своей программы на этом тесте. Только вот, называя условия этого теста боевыми, Вы лукавите! - могу сослаться на Ваше же высказывание.
И , вообще-то , оказался прав.
Ну что ж , Арчибальд пусть делает миллионный тест , а я завтра проверю у себя. И мы продолжим беседу по Вашей обработке.
Сергей.
А добавьте, пожалуйста, в свою таблицу мои результаты. ;-)
Колонка "без запросов", строка "1<10<10<10<10<10<10" (нижняя).
Файловый - 35 сек. Клиент-серверный - 70 сек.
На самом деле - меньше.
Я замерял на загруженной другими задачами машине.
Ну, и на моей системе нет такого понятия - "файловый".
Т.к. БД всегда одинаковая.
Меняется только способ передачи "пакетов"
Грубо говоря - меняется только "протокол".
Сергей.
Там нет никакого подхода.
Я с самого начала приводил тексты и тесты для "лобового" обхода, именно, дерева со схемой БД из темы "стартового" форума. Рекурсия - текстом из пяти строк. Но в рекурсивной функции не используется запросы. Т.е. это не мой подход, а подход СУБД имеющей не только запросный ЯМД.
По поводу внести мои замеры в свою таблицу - это шутка для Игоря по его методе сравнения результатов тестов... ;-)
Ты щелкнул за секунду миллионные регулярные графы с известной структурой с мизерным объемом информации.
Как только же дело дошло до главного реального испытания, по которому и определяется быстродействие реального
решения ты проиграл примерно в 8 раз. Время примерно 10(!!!) мин. Нужно продолжать ?
Критерий был определен заранее. Условия известны участникам. Перед тестированием ни у кого вопросов не возникало. И вот после получения результатов появились сомнения : а зачем это нужно ? а в тепловозе оказывается всего 11 111 узлов и т.д.
Арчибальд , тема ведь бесконечная.
Я бы хотел зафиксировать главный факт :
Согласно принятым известным участникам условиям мы выяснили , что твой суперскоростной алгоритм непригоден для известных , указанных больших объемов информации.
С другой стороны , что мешает тебе открыть новую дискуссию , в которой будут другие условия ( для "тепловозов" 11 111) ? Это будет совсем,совсем другая тема .
И я со своим запросом туда даже не сунусь.
Теперь по поводу нереальности задачи. Думаю, что такие большие графы обрабатываются совсем не в машиностроительной отрасли. Это вполне реальная задача.
Ты задал превосходный вопрос ! Если представить себе гипотетическую ситуацию решения такой задачи в 1с. То такая задача может быть решена :
1. Только в клиент-серверном варианте , причем никаких процедур на клиенте !
При решении таких задач и проявится огромное , чудовищное преимущество представленного алгоритма перед реализациями в духе Арчибальда или Сергея.
Чем больше объем данных тем больше преимущество запроса перед "рукопашным" кодингом - Сергей здесь не даст мне соврать он испытал это.
Спасибо за вопрос ! Пишите запросы !
Справочник "СпецификацииНоменклатуры" содержит 6-уровневый 10-арный граф , имеющий 1 000 000 различных ветвей и при обходе такого графа таблица ВремТаблица6 на выходе цикла алгоритма содержит 1 000 000 записей. Но сам справочник "СпецификацииНоменклатуры" в своей табличной части содержит лишь 60 записей.
Проще говоря , корневому элементу подчинены 10 элементов, каждому из которых подчинен одинаковый набор из десятка следующих элементов и т.д.
Давай уж. Я по твоим правилам поиграл, попробуй ты по моим.
Прочитай все мои посты к тебе , все тщетные предупреждения , что ты пишешь универсальную обработку , а не решаешь заполнялки Тестов №1 и №2. Ты уж самостоятельно , все это проверь.
Тесты №1 и №2 это быстрые поверялки реального универсального алгоритма
- ты и Сергей предупреждались об этом неоднократно ! Тщетно ! Вы с Сергем сделали заточки по тестам №1 и №2.
Теперь читаем тему :
Прошу только помнить, что в статье идет речь не о "заточке" для тестов №1 и № 2, а об универсальной обработке произвольного графа ( в общем случае, циклического), которая " в среднем" оптимальна, на взгляд автора, для решения задачи "разузлования" на предприятии. Это значит , что таблица Спецификации может иметь миллионы записей и это существенно не скажется на быстродействии представленной обработки (в клиент-серверном варианте). Это значит также , что алгоритм различные графы и деревья , содержащиеся в таблице Спецификации, обрабатывает одинаково и априорно (на входе) не имеет никакой "подсказывающей "информации о характере графа .
Теперь
Т.е. Вы согласились с тем, что задача решается проще для программиста и работает быстрей?
Если:
1) Не использовать запросы.
2) Использовать "рекурсию".
3) Не использовать 1С 7.7 и 8.х.
4) Строить схему БД не под конкретную задачу, а для решения разных задач в многопользовательской среде.
Контроль зацикливания должен быть безусловным, т.е. любое зацикливание должно быть отловлено.
Чтобы можно было проверить правильность контроль зацикливания должен выдаваться по окончанию граф ошибок. Иначе как пользовтаель исправит эту ошибку в огромном графе ?
Если снять контроль зацикливания - задача становится тривиальной и неинтересной.
**** Начато тестирование Тест №1 "Десять" ( 6 уровней, 1 000 000 ветвей)
Общее время выполнения 1
**** Начато тестирование Тест №2 "Два   " (20 уровней, 1 048 576 ветвей)
Общее время выполнения 0
**** Начато тестирование Тест №3 "Ошибки" (7  уровней, 1 000 000 ветвей)
Общее время выполнения 0
Если запущу повторно первый тест тоже 0 выдаст.
Вот код, вставленный в твою обработку и выведенный на отдельную кнопку:
Функция ПолучитьСостав(Запрос,Кэш,Номен,КолВо=1)
	Запрос.Текст = "ВЫБРАТЬ
	               |	Спец.Номенклатура,
	               |	Спец.Количество
	               |ИЗ  Справочник.СпецификацииНоменклатуры.ИсходныеКомплектующие КАК Спец
	               |ГДЕ (НЕ Спец.Ссылка.ПометкаУдаления И Спец.Ссылка.Владелец = &Узел)";
	Запрос.УстановитьПараметр("Узел",Номен);
	тз=Запрос.Выполнить().Выгрузить();
	Если тз.Количество()=0 Тогда
		Возврат 0;
	Иначе
		тз0=тз.СкопироватьКолонки(); развернули=Ложь;
		Для каждого эл из тз Цикл
			тз1=Кэш[эл.Номенклатура];
			Если тз1=Неопределено Тогда
				Кэш.Вставить(эл.Номенклатура,1);
				тз1=ПолучитьСостав(Запрос,Кэш,эл.Номенклатура,эл.Количество);
				Кэш.Вставить(эл.Номенклатура,тз1);
			КонецЕсли;
			Если тз1=0 Тогда
				стр=тз0.Добавить();
				стр.Номенклатура=эл.Номенклатура; стр.Количество=эл.Количество*КолВо;
			ИначеЕсли тз1<>1 Тогда
				развернули=Истина;
				Для каждого эл1 из тз1 Цикл
					стр=тз0.Добавить();
					стр.Номенклатура=эл1.Номенклатура; стр.Количество=эл1.Количество*КолВо;
				КонецЦикла;
			КонецЕсли;
		КонецЦикла;
		Если развернули Тогда тз0.Свернуть("Номенклатура","Количество"); КонецЕсли;
		Возврат тз0;
	КонецЕсли;
КонецФункции

Процедура КнопкаВыполнитьНажатие1(Кнопка)
	Если Не ЗначениеЗаполнено(Номенклатура) Тогда
		 Предупреждение("Не заполнена Номенклатура !",20);
		 Возврат;
	КонецЕсли;
	НачДата = ТекущаяДата();
	Результат.Очистить();
	Ошибки.Строки.Очистить();
	Сообщить("**** Начато тестирование "+Номенклатура);
	Запрос = Новый Запрос;
	Кэш=Новый Соответствие;
	Результат=ПолучитьСостав(Запрос,Кэш,Номенклатура);
	Сообщить("Общее время выполнения "+ (ТекущаяДата()-НачДата));
КонецПроцедуры
ПоказатьКод особо не оптимизировал. Если бы работало тормозно - занялся бы, а так работает быстро ну и пофиг с ним.
Я так понимаю , что ты создал универсальную обработку ? которая раскрутит любой граф , каким бы он не был с любым зацикливанием ? Например, если в тесте № 1 все 1 111 111 узлов уникальны ( не повторяются) , то также быстро всё будет ? У меня - да . А у тебя ?
В остальном она раскрутит любой граф. Насчет так же быстро - нет. Когда все узлы графа будут уникальны - скорость приблизится к твоему алгоритму. Единственное твой выиграет, потому что меньше команд выполняет. Поэтому надо будет оптимизировать код, который я написал - возможно использовать временные таблицы и Группировку, а не Соответствие. Тогда скорость будет примерно одинакова с твоим алгоритмом.
Другое дело что в жизни такой уникальный граф - редкость. Поэтому сейчас создавать такую обработку неинтересно. Главное я доказал - рекурсия совершенно не при чем.
Твой алгоритм неэффективно работает на поставленной задаче - вместо того, чтобы обработать 50 узлов - он делает перемножение и обрабатывает больше. Поэтому работает 50 секунд вместо 1-ной (у меня по-крайней мере).
Простая логика - у каждого своя.
Если я тебя правильно понял , то твой универсальный алгоритм в тесте №1 , если в графе все узлы уникальны , даст время в 20 000 раз более медленное, чем в придуманном для простоты контроля и удобного тестирования тесте №1.
Т.е. работоспособность в реальных задачах на миллионном произвольном графе мы о не можем гарантировать.
А теперь сравни :
представленная в теме обработка ЗапросПротивРекурсии.epf на миллионном графе со структурой теста № 1 при любой уникальности (неповторяемости) узлов даст один и тот же результат. (увеличится время копирования Справочника СпецификацияНоменклатуры во врем.таблицу , увеличится время выгрузки миллиона выходных записей запроса на форму, но само разузлование будет длиться столько же +-10%.
Приведенный в статье метод (не подход, а метод как одновременное разузлование и контроль циклов в одном запросе) имеет некоторый выигрыш перед другими только в одном случае: КОГДА ГРАФ ЯВЛЯЕТСЯ ДЕРЕВОМ. Стоит ветвям пересечься, метод проигрывает в сто и тысячи раз. Деревья - это гораздо более простой граф для алгоритмической обработки. В дереве у любого узла всегда есть уровень: для контроля зацикленности проверьте, чтобы в спецификации указывались только элементы следующего уровня и все! Распихивать древовидную спецификации одного изделия по объектам ИБ при этом даже нет смысла - на части спецификации нет внешних ссылок! Достаточно одной спецификации из миллиона элементов (с указанием для каждого порядка сборки - пути). А скрещивать УЖА (поиск циклов) и ЕЖА(разузлование) в одном запросе на практике? - будете иметь 200 секунд вместо 0,017!!!
Успехов в написании правильных запросов!
На узлах дерева всегда можно определить отношение порядка - например, порядок левостороннего обхода, присвоить этот "порядок" каждому узлу (в виде действительного числа, чтобы при вставке не менять "порядок" других узлов), и выбирать все подчиненные узлы как узлы, "порядок" которых помещается между "порядком" данного и следующего через более высокий уровень узла.
Спецификации в виде дерева можно записать в скобочной форме для интерпретации, использовать ЛИСП как в AutoCAD и так далее, но это уже совсем другая история!
Тема "Как не попасть..."
Тестируемый файл
"Внешний отчет суперскоростное разузлование (быстрее нельзя!) для БП1.6"
1с8.1 релиз 8.1.15.14 среда проверки :Демо Бп 1.6 и Демо БП. 2.0.
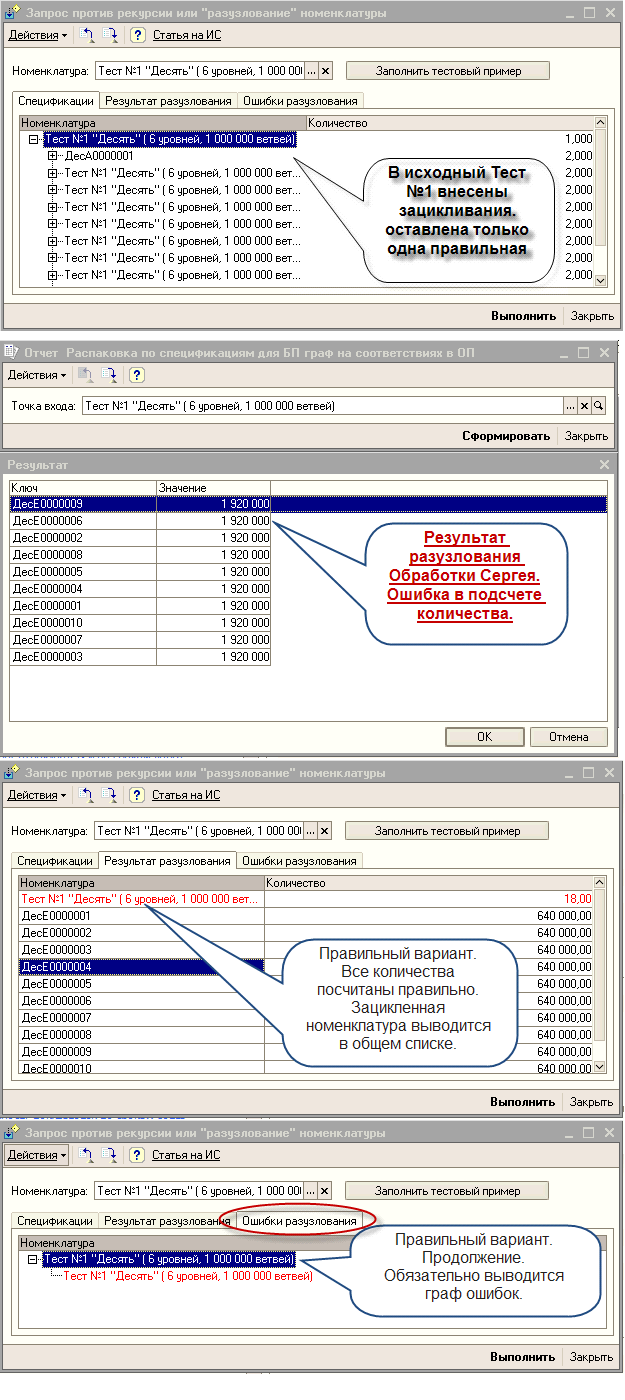
Использовалась та же методика проверки правильности расчета количества, как и в (88) для обработки Huse. Реультат тот же . Обнаружен неверный расчет количества.
1. Запускаем 1с81 , "чистая" демо БП 1.6.
2. Запускаем ЗапросПротивРекурсии.epf , создаем новую тестируемую номенклатуру
"Тест № 1.." (кнопка "заполнить тестовый пример").
Затем повторяем это действие и в итоге имеем в справочнике "Номенклатура" две номенклатуры с одинаковыми именами ("Тест №1..") и соответствющими им подчиненными элементами (справочник "спецификацииНоменклатуры" содержит два одинаковых графа).
3. Для последней созданной номенклатуры совершаем интерактивно в обработке ЗапросПротивРекурсии.epf искусственное зацикливание на 1 уровне см. прикрепленный файл.
4. Действия для 1-3 повторил для Демо БП 2.0 - результат тот же.
Правильное количество для каждой номенклатуры должно быть 640 000.
Тестирование прекращено.
Заявленная обработка не обладает верным функционалом.
Ну и так как у Вас два одинаковых графа с одинаковыми названиями вершин, то и скриншот ситуацию не проясняет. Гадать не хочу -
перечислите строки, которые добавили и в какие спецификации. Номенклатуру желательно с кодами, раз у Вас она с одинаковыми названиями!
Непонятно это:
- я не знаю, какая номенклатура создана последней (второй корень?)
- почему интерактивно?
- почему в обработке?
- почему искусственное? (у Вас бывает естественное зацикливание?)
- что такое зацикливание на первом уровне? (уровни считаются с нулевого?)
В обработке ЗапросПротивРекурсии.epf :
Последовательно друг за другом запускаем тест №1. Получаем две корневых номенклатуры для двух одинаковых по структуре графов .
Используем для внесения зацикливаний последнюю из созданных номенклатур.
Затем на панели Спецификации разворачиваем дерево для тестируемой номенклатуры см.Рисунок 1 и интерактивно правим любой элемент справочника
СпецификацииНоменклатуры . Вот я интерактивно и внес такие изменения в корневую спецификацию "Тест № 1" такие зацикливания.
Слушайте проще попробать вам самому чем мне столько писать. Пробуйте.
Своим ответом Вы не добавили мне никакой нужной информации. Будем гадать.
Пока рабочая версия такая: Видимо, наши с мистером Хьюзом обработки натыкаются на какую-то особенность Вашей процедуры заполнения. В эту пользу говорит то, что:
1. При создании в аналогичной структуре, построенной моей обработкой, тех же замыканий, ошибки не происходит (пробуйте);
2. При перещелкивании первой (правильной) строки в первой спецификации ошибка исчезает (пробуйте).
Буду разбираться дальше...
Но все же обращу внимание на следующие противоречия в Ваших
1. Вы говорите, что зацикливания вносятся в спецификацию последней созданной номенклатуры, то есть во второй граф. Но в результате разузлования созданной последней номенклатуры должны были бы получиться вершины E11 - Е20, а на скриншоте - Е01 - Е10, как будто разузловывается первый граф.
2. Если и в (119) и в (88) вносились одинаковые исправления в первой спецификации, оставляя правильной первую строчку, то почему в Вашем ответе в (88) 12 возвратов в корень, а в (119) - 18. Кстати, в итоговой таблице корень вообще не должен фигурировать как не терминальная вершина.
На Вашей и моей машине легальным способом достигнут одинаковый повторяющийся результат :
Неверный подсчет количества.
Доказано, Ваша обработка обладает НЕВЕРНЫМ функционалом.
Вывод :
Отсюда следует , в настоящий момент , что все заявления о СУПЕРскорости Вашей обработки , сравнительные таблицы
и т.д. и т.п ничего не стоят.
Если в мой обработке , Вы найдете такой же грех с неверным расчетом- я буду вынужден признать то же самое.
О деталях - потом.
Поправил несколько символов в строке 11 формы, обработку с исправлениями перевыложил. - Игорю спасибо!
Исправления:
1<10<10<10<10<10<10 (~ 1 000 000 узлов) оценка 600 реальность 630
1<10<10<10<10<10 (~ 100 000 узлов) оценка 50 реальность 40
1<10<10<10<10 (~ 10 000 узлов) оценка 4 реальность 3.3
1<10<10<10 (~ 1 000 узлов) оценка 0.3 реальность 0.3
1<10<10 (~ 100 узлов) оценка 0.02 реальность 0.12
Т.е. имеет место еще и предсказуемость.
Только стоит ли нам еще препираться?
Я буду говорить, что две ошибки - ситуация редкая, исправьте одну - ищите вторую и т.п.
Потом буду говорить, что Ваша программа не проходит тест "Матрешка",
т.е. не может решить не абстрактную,
а конкретную задачу - раскрыть спецификацию обычной матрешки.
Потом "Матрешку" зациклю где-нибудь на 100-м (или 500-м) уровне и скажу,
что Ваша программа и циклов не находит.
Я готов и дальше это делать - истина то одна и никуда Вы от нее не уйдете.
Я прекрасно понял и принципы работы Вашей программы и принципы Вашего подхода
и закономерности, которые позволяют определить,
насколько большое время будет затрачено Вашей программой на обсчет того или иного графа.
Из сотни номенклатур не я - пользователи могут легко построить набор спецификаций,
которые Ваша программа не обсчитает за все время жизни Вселенной!
что аргументами можно победить незнание, а невежество так победить нельзя.
Несколько "цивилизованных" программистов Вам доказывают, что умножение быстрее сложения.
Это не метафора, здесь рассматривается именно этот случай (с точки зрения общей алгебры).
Вы же каждый раз приводите в пример случай сложения разных предметов.
Да еще хотите, чтобы ошибки перечисления этих предметов назывались так же,
как делает Ваша незамысловатая, суперстарательная и супер-гипер-трудоемкая
обработка.
управления навигационным комплексом самолета, Вы бы были осмотрительнее в выборе методов решения задач.
А бухгалтер - он и не такие издевательства стерпит.
В общем, пользователь Вам судья! Но я бы предпочел, чтобы Вы признали, что нельзя считать
запрос, который работает миллионы лет, победившим рекурсию. И честно, без уверток написали об этом в своей статье.
Ибо, как говорят мои коллеги - "отрицательный результат - тоже результат".
Этот поступок был бы достоин уважения.
А так - извольте...
В Вашей обработке НЕПРАВИЛЬНО считается циклом ссылка с незаданным - нулевым количеством!
То есть номенклатура всего лишь упомянута в спецификации, ее количество там не задано, оно нулевое. Вес дуги равен нулю. В нашей задаче это - фактическое отсутствие связи - инцидентность равна нулю!
Проверил на Вашей обработке: стер количество из зацикливания в корень в тесте №3, а ошибка все равно показывается! - могу скриншоты привести. Курам на смех!
Хотите, чтобы моя обработка показывала цикл - проставьте в спецификации ненулевое количество!
Что есть зацикливание ?
Зацикливание - есть факт нахождения в одной элементарной ветке графа двух одинаковых узлов , другими словами "родитель" является одновременно и "ребенком".
Точка.
Этот факт и должна зафиксировать обработка независимо от других условий.
Вы привносите в это определение дополнительное условие :
и "родитель" и "ребенок" должны ненулевое количество. С чего Вы это взяли ?
Из того , что в Вашем алгоритме так удобнее ?
Теперь сравните что информативнее, полезнее для пользователя , работатющего со спецификациями :
- при Вашей обработке пользователь ничего не узнает о явной ошибке зацикливания
если у "зациклившей" количество равно нулю.
- при моей обработке пользователь обязательно увидит зацикливание и сам определит что с ним делать .
Этот пример зацикливания для того и приведен , чтобы показать слабость Вашего алгоритма . Если исправите , то продолжим . У меня есть еще , что сказать, по поводу Вашего алгоритма.
Только будьте осторожнее с такими привычками, заполняя, например графу анкеты "Состав семьи":
Строка "Жена". В графе количество ставите "0". Не говорите никому в этом случае, что у Вас есть "связь с женой". Неправильно поймут! Загремите прямо на "Дагомысскую".
Про зацикливание я уже и не говорю.
Игорь! Прекращайте спорить с очевидным! - Примеров, показывающих слабость моего алгоритма нет! Кстати, потестировал я тут Вашу обработку (Тест№3): Нажимаю - жду - жду - жду. Самого-то не раздражает? А у меня: нажал "выполнить" - сразу ответ! - Красота!
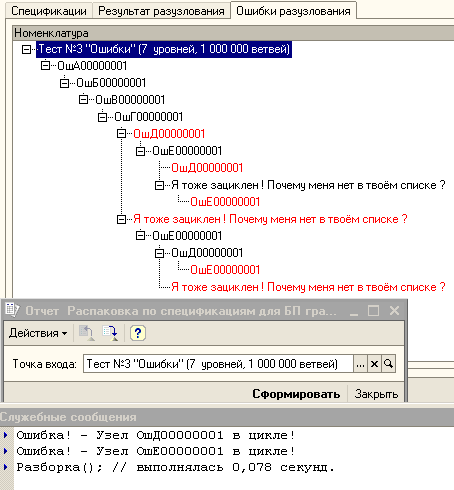
Но все же считаю такое толкование содержания спецификации грубой ошибкой. Например, при указании в таможенной декларации "короны Российской Империи" в количестве 0, обработка Игоря будет старательно разбирать виртуальную корону на бриллиантики, вместо того, чтобы заниматься поиском реальной контрабанды. При таком походе можно посчитать убийством убийство нуля человек, а победой обработки ее победу над нулем других обработок.
Чтобы не затягивать сериал, предлагаю параллельно проверить обработки на тесте "Матрешка" и заранее придумать объяснение тому, что "универсальная" обработка "запрос в цикле" не работает в конфигурациях, в которых коды номенклатуры не уникальны в пределах всего справочника.
Мы начали рассматривать вопрос о Вашей обработке :
соответствует ли она заявленному функционалу ? или правильно ли осуществляется контроль зацикливания ?
Без решения этого принципиального вопроса невозможно двинуться дальше.
Итак , я жду Вашего ответа на (163).
После Вашего ответа на (163) пора уже обсудить вопрос :
сколько нужно обнаружить ошибок в определении зацикливанияв в Вашей обработке ,
чтобы прекратить тестирование.
Например , если Вы исправляете ошибку (163) и я Вам предъявляю СериюЧетвертую.png
- то тестирование завершается и объявляется , что "Разработка Сергея не обладает заявленным функционалом".
Или хотя бы назовите номер серии.
Мы решим этот принципиальный вопрос и , обещаю , приступим к полному рассмотрению вопроса о недостатках обработки ЗапросПротивРекурсии.epf (они разумеется, существуют).
Вы лично объявили разночтение в трактовках цикла в спецификациях принципиальным вопросом, а чем обоснуете?
Но это все "лирика". В следующем посте будет "физика".
Я бы отвечал быстрее, но Вы очень скупо описываете свои действия при тестировании. Лучше были бы .xml - выгрузки спецификаций. Так что пока подождите - воссоздаю условия теста.
Это НЕ ошибка!!! Вот аргументы:
Есть два разных подхода: Ваш и мой.
Ваш подход: выдать пользователю 100 ? первых цепочек вершин, содержащих циклы;
Мой подход: выдать пользователю для ВСЕХ циклов по ОДНОЙ содержащейся в каждом цикле вершине.
В (163) Вы создали граф из дуг Г->Д, Д->Е, Г->Я, Я->Е, Е->Д, Е->Я. Этот граф содержит два цикла: Д->Е->Д и Я->Е->Я.
При моем подходе в выдаче содержались две вершины: Д, входящая в первый цикл и Е, входящая в оба. Это я считаю правильным.
Вы ошибочно считаете, что оператору поможет перечисление цепочек, содержащих циклы. Но - таких цепочек могут быть сотни тысяч!
В своем же тесте №3, (ничего не убирая! - не жульничайте!) добавьте связь ОшЕ00000002 -> Тест№3. Вы не увидите эту ошибку в Вашей выдаче,
хотя она будет только второй!!! Чтобы ее увидеть, Вам придется вывести не 100, а 100 001 ошибочных цепочек.
И только 100 001-ая будет содержать всего вторую ошибочную связь!
Так в каком подходе ошибка? В Вашем или моем? Ответьте аргументировано! Разберите мой пример!
Плавно переходим к недостаткам ЗапросПротивРекурсии.epf
Что же означает (163) ?
Я уже повторяюсь. Но лучше плясать от печки. От постановки задачи.
Что есть зацикливание ?
Зацикливание есть факт когда узел выступает в качестве и "родителя" и "ребенка".
Обработка должна безусловно отобразить такие обнаруженные факты зацикливания.
Не "рассуждая" хорошее это зацикливание и его надо зафиксировать ,
или это "безвредное" зацикливание (с нулевым количеством ) и его можно не фиксировать.
Один из аргументов для такого подхода в (161) специально для Арчибальда(166) :
- при Вашей обработке пользователь ничего не узнает о явной ошибке зацикливания
если у "зациклившей" количество равно нулю.
- при моей обработке пользователь обязательно увидит зацикливание и сам определит что с ним делать .
Вопрос "Что делать с "безвредным зацикливанием" ?" - это не вопрос наших обработок графа.
Это вопрос пользователя, работающего с графом, или последущей обработки. Текущая обработка обязательно должна зацфиксировать зацикливание. И ВСЁ!
Я утверждаю , что любой другой подход "есть дорога в Ад", то есть (163).
Отсюда вытекают важнейшие следствия.
Теперь конкретно Для Сергея.
Чтобы ее ( увидеть, Вам придется вывести не 100, а 100 001 ошибочных цепочек.
Кхе-кхе...
У меня действительно стоит выдавать только ПЕРВЫЕ 100 ошибок.
Заметьте , у меня содержится во временной таблице ПОЛНЫЙ граф ошибок , а выдается только 100.
Сколько хочу столько и выдам.
Я посчитал ,что 100 первых вполне достаточно для начала работы пользователя над ошибками.
Сделано это в демонстрационных целях и не более того .
Тестируя программу , я задал 1 000 000 ошибок и не дождался выполнения запроса по ошибкам (т.е. построения графа ошибок). С другой стороны , ничто не мешает БЫСТРО выдавать параллельно общее количество ошибок для информирования пользователя.
+(171) Завтра закончу, так как теперь нужно убрать дублирование функционала и заново протестировать...
Вы признаете поражение? Признаете, что запрос проиграл рекурсии? Скажите об этом четко!
И еще ...
Мне вдруг пришло в голову, что Вы настаиваете на Вашем якобы правильном способе контроля зацикливания не из упрямства (каюсь, считал именно так), а просто потому, что не знаете классического способа такого контроля (ну, пропустили тему, с кем не бывает).
Потратьте несколько минут, проглядите по диагонали вольное изложение этого метода.
Итак, задача:
"В некотором произвольном графе (подграфе) требуется определить ошибочные связи, приводящие к зацикливанию".
Метод решения:
1. Допустим, что ошибки независимы. Это дает возможность считать более вероятными сначала однократные, потом двухкратные, потом трехкратные ошибки и так далее. Все практические алгоритмы поиска ошибок построены на этом допущении.
2. В результате допущения 1 исходная задача становится оптимизационной: найти минимальное количество связей, разрыв которых делает граф ациклическим.
3. Оптимизационная задача 2 решается методами динамического прораммирования, например, методом ветвей и границ (МВГ). МВГ - это метод сокращенного (границами) перебора (ветвей). Сильно упрощая, можно сказать, что сначала мы размыкаем по одной связи, проверяя, не исчезла ли ошибка. В графе тест №3 на это понадобится максимум 0,122 х 510 дуг - максимум 50 секунд, а реально - гораздо меньше!
Что же дает этот метод решения: он выдает оператору не миллион циклических цепочек (пусть и в виде дерева - в нем Вы сами путаетесь - это говорит (163), где Вы были вынуждены размыкать правильные связи, чтобы показать двойную ошибку).
Он выдает чаще всего единственное правильное решение - ошибочную связь! В худшем (гораздо реже на практике) - некоторое множество связей, из которых оператор делает выбор.
Моя обработка только контролирует (определяет наличие) всех ошибок зацикливания, показывает диагностические признаки (симптомокомлекс) в максимально компактном виде, чтобы в дальнейшем можно было найти ошибку по-умному.
Ваш "наивный" метод делает только на первый взгляд больше. Избыток информации в данном случае - зло для оператора! В случае ста уровней в тесте №1 и зацикливания ОшГВ00000001 -> Тест №3 Ваша обработка
страшно сказать когда выдаст ГУГОЛ (10 в степени 100) цепочек циклов!
А моя обработка через 50 секунд выдаст результат разузлования и одну ошибку (Узел Тест №3 в цикле)!
Подход типа Вашего (запрос в цикле ??? - моветон!) немного выигрывает у рекурсии только в одном редком случае неповторения спецификаций.
Когда граф является ДЕРЕВОМ. Но и в этом случае он НЕ ДОЛЖЕН ПРИМЕНЯТЬСЯ!
Поскольку для этого специального случая, как я уже писал в этой теме раньше (поищите!) должны применяться специальные методы. Запрос будет к одной таблице без всяких циклов и соединений!
Менее чем за 10 секунд для дерева 1 111 111 он выдаст Вам результат разузлования!
По прежнему ждем, что Вы сделаете правильные выводы в аннотации к Вашей статье :D .
Ваша обработка тестировалась честно с Вашего согласия и по известным правилам.
У Вас было достаточно времени в МОЕЙ ТЕМЕ привести ВСЕ СВОИ аргументы в пользу СВОЕЙ обработки.
Вы собрались писать НОВУЮ обработку (175). Обсуждать её в своей теме я не намерен.
Для всех остальных (кто дочитал до конца) сообщаю (позиция обоснована в моих постах в этой теме):
ВЫВОДЫ СТАТЬИ О ПРЕИМУЩЕСТВАХ ПРИВЕДЕННОГО ЗАПРОСА ПРОТИВ РЕКУРСИИ - НАГЛАЯ И СОЗНАТЕЛЬНАЯ ЛОЖЬ!!!
Попробуйте. Докажите свою правоту.
Честным выводом из рассмотрения решений на тестах №1 и №2 из статьи было бы отрицание заявленного эпиграфа, поскольку на этих тестах "запросная" техника Игоря проигрывает на 1-2 порядка альтернативным алгоритмам.
Касательно нулевого количества на дуге, кстати, я тоже согласен, что это не зацикливание. При разузловании такая дуга на порождает потомков (порождает нулевое количество потомков), значит, не мешает корректному подсчету составляющих, т.е. не является критической ошибкой. У меня алгоритм проверки зацикливания как раз обнулял количество на ошибочных дугах, после чего разузлование корректно выполнялось. Игорь же просто не смотрит на количество при построении цепочек - ну, нравится ему лишняя работа...
Как-то так...
Позвольте и мне сказать.
Надеюсь, что вы оба прочтете.
Вы решаете разные задачи!
Игорь делает уклон на сферу СУБД, а Сергей (и Александр) на численные методы.
Игорю, думаю, надо было с самого начала определить задачу так, чтобы и мысли не было рассматривать "графины". Печально, но в теме СУБД очень мало мест где можно применять "математику". В задаче от Игоря её нет вообще.
Игорь сам-себя запутал и других людей запутал. О мотивах этой "запутки" я сказал выше по теме. У Игоря и в обсуждении на форуме, и в данной статье идет "полная путаница" терминов и задач.
Пример "разузлования" (условно!!!).
Колесо автомобиля.
Шина (1 шт.).
Обод (1 шт..
Камера (1 шт.).
Грузик (от 0 до 10 штук).
Но описано само изделие - его состав. А какая будет шина ничего не сказано. На этой позиции могут быть разная шина - производитель, сезонность, вес, цена, поставщик и т.д. Т.е. это (в нашем примере) жестко узел с степенью - четыре. Т.е. описан "каркас" изделия. И это дерево, естественно - без циклов. Часто, заранее, с подсчитанным количеством "входимости" позиций в "каркас". А количество изделий подсчитывается простым запросами с Sum()-ами. ;-)
Для работы с таким деревом требуется не выборка множества узлов, а получение одного узла "соотнесенного" с его родителем и детьми. Это делается не запросом и не "закачкой" в память информации - в СУБД это возможно, но это не есть корректные способы взаимодействия приложения с БД. Почему? Мне казалось, что я об этом сказал многократно в форуме до появления данной стать. Оказывается - нет :-(
А если в задаче строго дерево, то единственный тест (по классификации от Сергея) - под номером три. Всё остальное не имеет отношение к дереву. Т.е. это частные задачи с элементами "фокусов" не в сфере СУБД.
Сравните свои скорости на третьем тесте. Для деревьев с разными степенями и уровнями. И разойдитесь. В сфере СУБД, всё остальное не имеет смысла...
Я благодарю авторов Huse,Арчибальда, Сергея , не только обсуждавших задачу "разузлования" , но и представившими свои разработки .
Для меня была важна сама форма эксперимента : открыто обсудить и протестировать в теме альтернативные разработки нескольких авторов.
Насколько это понравилось публике и самим авторам мне судить трудно. Но я старался, чтобы это было интересно.
Обработка должна содержать АБСОЛЮТНЫЙ ("очень тупой"), а не относительный как у Сергея, контроль зацикливания. Далее. Мало иметь список ошибок - нужно строить их граф. Простой список малоинформативен и неудобен как для пользователя, так и для дальнейшей автоматической обработки. То есть , если вы "по-взрослому" ставите задачу для Заказчика ,вы должны понимать что от простого списка проку никакого и граф ошибок просто необходим.И уже на начальном этапе стало понятно , что затраты на ведение графа ошибок будут огромными.
Если вы "по-взрослому" ставите задачу для Заказчика , то конечно должны предусмотреть "отвязку" от слабости клиента (слабое быстродействие, ограниченный объем оперативной памяти и др.), т.е чем меньше кода на клиенте - тем лучше.
Эти соображения и легли в основу обработки ЗапросПротивРекурсии.epf и обеспечили как её недостатки, так и достоинства.
PS Знаю один завод, купивший MRP за 70 млн.руб. Завидую черной завистью и записываюсь к Автору на курсы. )))))))))))))))))))
Господа. Ни у кого из вас
ни у Владимира,
ни у Хьюза,
ни у Сергея ,
ни у Арчибальда не было никаких шансов.
Потому что ни один из вас не увидел ловушки в условии "безусловного контроля зацикленности".
Рассмотрим пример на рисунке, на котором завалился Сергей.
Начнем с того что, в машине рисунков нету. Нужно последовательно обойти весь граф
побывав в каждом узле и построив все возможные ветки.
Двигаемся по одинарной ветке , пока не сработало зацикливание.
Напоминаю, зацикливание есть факт нахождение на любой из веток от корня до вершины двух одинаковых элементов.
Все ! такие факты мы должны выявить.
Начинаем движение вслепую.
Ветка 1. А-Б-В- Г- Я_тоже - Е - Я_ТОЖЕ. На последнем сработало зацикливание , движение прекращаем.
Ветка 2. А-Б-В- Г- Я_тоже - Е - Д - Е.
Ветка 3. А-Б-В- Г- Д - Е - Д.
Ветка 4. А-Б-В- Г- Д - Е - Я_Тоже - Е
Итого З элемента (Е- дважды)
Только такой , самый "тупой" и надежный метод обхода дает постоянный состав зацикленных элементов Е,Д,Я_тоже НЕ ЗАВИСЯЩИЙ от порядка обхода.
Если же мы начнем "хитрить", чего-то оптимизировать при обходе, как в ваших алгоритмах , то потеряем элемент.
Причем "хитрый" вариант обхода может выдавать разный состав элементов в зависимости об порядка обхода.
Алгоритм Сергея, например, выдал только Е и Д.
А что это за контроль , который выдает разный, неполный состав зацикленных элементов.
Любому из вас я могу задать вопрос : "Чем потерянный Я_Тоже хуже , чем Е и Д ? Почему вы его не отловили ?". Действительно , раз пропущен зацикленный элемент - значит нарушено условие контроля зацикленности.
Значит , чтобы выполнить условие контроля зацикленности в ваших алгоритмах нужно реализовать этот самый "тупой" контроль и так или иначе хранить все ветки графа. А это конец.
Конец скорости, конец надежности (памяти клиента может и не хватить).
Я старался для вас , господа ! Надеюсь, вам понравилось.
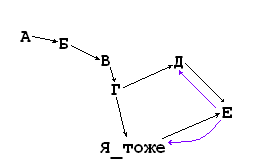
Выводы, которые Вы сделали в (183)
ОШИБОЧНЫ! Они опровергаются тем, что я написал в (177). Ну поверьте! Если действительно хотите понять, почему, я могу ответить не на форуме в Вашей теме, где Ваше непонимание Вы называете моими ошибками, а в личной переписке. Перечитайте (177) еще раз, напишите мне лично, что Вам непонятно, с чем Вы не согласны. Я постараюсь объяснить.
Если вы хотите постараться для меня :
создавайте СВОИ темы,
спорьте,
опровергайте ,
придумывайте свои конкурсы ,
устанавливайте свои правила ,
шутите САМИ , на СВОИХ условиях и в СВОИХ темах !
А для тех , кто ничего не понял - последняя шутка автора :
я вот об этом куске кода из сабжа:
//Цикл получения выходной таблицы
Для Счетчик =0 по КоличествоЦиклов+1 Цикл
Запрос.Текст = СтрЗаменить(ТекстЗапроса,"Исходная","ВремТаблица"+ Счетчик);
Запрос.Текст = СтрЗаменить(Запрос.Текст,"Последующая","ВремТаблица"+(Счетчик+1));
РезультатЗапроса = Запрос.Выполнить();
Если РезультатЗапроса.Пустой() Тогда
Счетчик = Счетчик + 1 ;
Прервать;
КонецЕсли;
КонецЦикла;
Что мешает гг коллегам увидеть здесь рекурсию? Может быть, то - что они не знакомы с содержательной частью этого термина?
У меня даже родилась умная мысль : Много чего на много чего похоже.
Чтобы ты больше не путался - Пример для тебя.
Что такое "реккурентность" и что такое "рекурсия" ?
Реккурентность - это свойство какой либо последовательности.
Рекурсия - это вычислительный прием.
Пример, который ты привел(цикл в теме) подобен следующему:
н=0;
Пока Истина Цикл
     н=н+1;
КонецЦикла;
В этом примере-Цикле порождающем натуральный ряд чисел мы наблюдаем реккурентность,
каждый последующий член последовательности зависит от предыдущего и отличается от него на единицу.
Но только сумашедший скажет , что мы здесь используем рекурсию(явно или неявно), как вычислительный приём.
По аналогии :
//Цикл получения выходной таблицы
Для Счетчик =0 по КоличествоЦиклов+1 Цикл
Запрос.Текст = СтрЗаменить(ТекстЗапроса,"Исходная","ВремТаблица"+ Счетчик);
Запрос.Текст = СтрЗаменить(Запрос.Текст,"Последующая","ВремТаблица"+(Счетчик+1));
РезультатЗапроса = Запрос.Выполнить();
Если РезультатЗапроса.Пустой() Тогда
Счетчик = Счетчик + 1 ;
Прервать;
КонецЕсли;
КонецЦикла; ПоказатьПоследовательность получаемых временных таблиц также обладает свойством реккурентности,
Но получаем все эти таблицы с помощью ЦИКЛА. Рекурсии, как вычислительного приема здесь нет и в помине.
Никакого рекурсионного определения тела запроса - НЕТ.
Пример использования Рекурсии как вычислительного приема приводить не буду. Надеюсь , ненужно.
Но рекурсивная программа не может вызывать себя бесконечно, иначе она никогда не остановится, таким образом в программе (функции) должна присутствовать еще один важный элемент - так называемое терминальное условие, то есть условие при котором программа прекращает рекурсивный процесс.
У тебя, Игорь, косвенная рекурсия, только не через процедуру ку, а через запрос, что роли не играет. А терминальное условие у нас с тобой - одно и тоже.
Сдавайся, короче.
Арчибальд и Танго - хорошие люди, ерунду не скажут.
Может и ,правда, сдасться ?
Но жаль поста (188). Я же старался. Показать ,
что рекурентность это прежде всего свойство некоторой последовательности.
Мы говорим , что натуральный ряд рекрентен (обладает рекурентным свойством) , т.е.
каждый член этого ряда
А(N) = A(N-1)+1
Теперь мы говорим , мы получим натуральный ряд без рекурсии ( без этого вычислительного приема),
только при помощи "Цикла"
н=0;
Пока Истина Цикл
н=н+1;
КонецЦикла;
Я еще раз : торжественно вам объявляю ЗДЕСЬ НЕТ РЕКУРСИИ (вычислительного приема , т.е. обошлись без рекурсивного вызова процедуры)).
В этом же смысле , я заявляю в представленной обработке НЕТ рекурсии.
Есть обычный Цикл. С его помощью мы получаем последовательность таблиц ,
каждая последующая из которых получена из предыдущей определенным преобразованием.
О неявной рекурсии имело бы смысл говорить , если бы я организовал нечто
1. Цикл + стек
2. если бы имело место в моей процедуре
В моей обработке нет ни того, ни другого.
Если вы настаиваете , что рекурсия в обработке присутствует , то тогда она присутствует и в коде получения натурального ряда.
Так что , уважаемые Танго и Арчибальд не сдамся. И не просите.
и даже плюсиков еще насшибаешь.
просто когда деревья станут маленькими посмотри на эту строчку:
РезультатЗапроса = Запрос.Выполнить();
в нем ты вызываешь процедуру ку
а в отличие от натурального ряда в бесконечном цикле (реккуррентность) ты имеешь и второй признак - точку выхода из цикла, окончание рекурсии.
Засим прошу извинить,. покидаю твои темы. Ну, пока деревья у тебя еще большие.
Тема разузловывания, или, по другому, вычисление состава изделия не просто актуальна в перечисленных примерах (летательные аппараты, электровозы, суды) - она там корневая. Обсчет изделения (по комплектующим, по затрачиваемым на изделие материалам, по затрачиваемой работе на изделие и т.д. и т.п) осуществляется только на основании собранного состава изделия. Именно на эти расчеты ориентируются конструктора, технологи, экономисты, бухгалтеры и прочие службы.
Имел счастье работать на предприятии, где собирают паровозы. Сколько в паровозе узлов и деталей - можно представить.
В разное время были испробованы различные подходы к реализации задачи разузловки, вот некоторые самые интересные:
- полный сбор на T-SQL (рекурсивным запросом) и "выплёвывание" результата в темповый иерархический справочник. Если результат грамотно подготовлен, а именно уже раскидан по владельцам в иерархическую структуру еще в T-SQL, то простейший запрос уже 1С с "УПОРЯДОЧИТЬ ПО ИЕРАРХИИ" выдаёт дерево очень быстро. Метод хорош, но весьма сложен по реализации и поддержке;
- тоже самое, но с "выплёвыванием" результата в XML и получением дерева 1С уже из XML. Тоже неплохой вариант, ибо 1С работает с XML очень быстро;
- последний вариант, насколько я знаю, не внедрённый еще, заключался в заново перепродуманной :) и грамотно переделанной структуре базы с целью максисмального использования регистров и их мощных механизмов виртуальных таблиц. Вроде как давал по производительности самый лучший результат.
хренюшка в том, что хотят 1сную фишку, т.е чтоб и обновление на УПП накатывалось по одной кнопке, и чтоб паровозы летали
Тут 1С должна работать с СКД, которая в данном случае не Система Компоновки Данных, а Система Конструкторской (и технологической) Документации. И не фиг пытаться впихать в 1С абсолютно всё - подавится
Это путь в никуда. В этих табличках будут повторяющиеся агрегаты. И при изменении состава одного агрегата придется менять все таблички, в которые он входит.
С одним только НО.
И это НО - центральное во всей теме. Как контролировать зацикленность в таблице описывающей ВСЕ изделия на предприятии :
Родитель,Ребенок, Количество.
Эта таблица компактна и удобна при хранении информации - всё в одном флаконе.
Но неудобна при получении таблицы разузлования.
При отсутсвии контроля зацикливания - задача тривиальна и малоинтересна.
При абсолютном котроле зацикливания всё становится не так просто.
К какому падению "алгоритмов" привело "легкое" отношение к контролю зацикливания можно почитать поднявшись вверх по комментариям. Представленный алгоритм в теме дает удовлетворительное быстродействие ~20сек на разузлования миллионного графа см.Тест №1 - что для реальных "паровозов" более чем приемлемо.
При этом никакие дополнительные, ускоряющие структуры хранения информации о графе не используются.
Возможно, поэтому статья опубликована также в разделе "1с рекомендует" .
Желание разузловывать паровозы в 1С (хоть бы и в УПП) равносильно желанию безрукого импотента заняться онанизмом.
Тут 1С должна работать с СКД, которая в данном случае не Система Компоновки Данных, а Система Конструкторской (и технологической) Документации. И не фиг пытаться впихать в 1С абсолютно всё - подавится
1С обсчитывает паровозы тока в путь :). В полном соответствии с ЕСКД выдает документацию, ведомости всякие и пр. Считает технологию и экономику. Это не УПП - у нас была полностью написанная софтина с нуля. Что-то типа аппиуса. Кто, кстати, видел аппиус в последнее время? Насколько быстро он считает тяжелые сборки?
Вопрос целесообразности написания своей конфы, а не использования чего-то готового, конечно, важен, но это чистый холивар :). Не каждое машиностроительное предприятие полного цикла, с несколькими тыщами слоняющихся по цехам и кабинетам людей готово перетряхивать свои бизнес-процессы ("дык так уже 30 лет работает и ничего") ради "какой-то там автоматизации". К сожалению, в большинстве случаев это так...
А вообще, 1С вполне нормально использовать для этих целей, поскольку легко интегрироваться с бухией, зарплатой и пр. В конце концов, в 1С можно накодить всё что угодно, были бы прямые руки,.. а прямой доступ к sql даёт вообще огромные возможности (хотя и возможностей 1С предостаточно).
будет не быстро, а очень-очень быстро, если структуру табличек спроектировать под конкретные паровозы. ххх каждого паровоза - свою табличку.
Проблема быстроты даже больше не самого сбора состава касается - он накоживается достаточно успешно разными способами - а сбора состава на дату. Обычно всех интересует, а как выглядел этот узел месяц назад, а что сейчас, а что будет с н-ным изменением. В итоге, хранится вся история изменений узлов, деталей. Плюс, если на чисто конструкторский скелет навешивать мясо в виде технологических материалов (которые тоже, кстати, могут быть иерархичны )) ) и нормирования труда, что в свою очередь, также хранится с историей, то подобный обсчет весьма и весьма тяжел.
Конечно, под каждое изделие никак "своих" табличек не делается :).
Циклические сборки, да - это весело :) Порой приходилось объяснять даже конструкторам, что класть пакет в сумку, сумку в чемодан, а чемодан в пакет нехорошо и работать такой паровоз не будет :).
Проблему цикличности можно отчасти решить тупо и просто, по-идиотски так (прошу не пинать!) - никакой даже самый большой паровоз не содержит, не содержал и не будет содержать более 7 уровней вложенности. Понимаете? :) Проверяем, скажем, на 12 циклов и всё - цикличность. Быстро и просто. Решение не математическое, а чисто практическое. Другое дело, что вопрос а в каком узле требует, да, дополнительных изысканий.
Возможно, для судов, например, всё не так радужно, конечно :)
17??!! Сурово!! (Что-то я даже засомневался по поводу своих семи, надо завтра уточнить у коллег). Может это с полной раскладкой каких-нить пультов управления, которые обычно идут как покупные изделия? Или какие-то иные принципы у конструкторов, ведь бывает, что и укрупняют узлы и, наоборот, разбивают.
Нужно не только выдать сообщение о цикличности, дескать , такой-то элемент зациклен, а также показать все зацикленные ветки графа. Чтобы пользователь сориентировался в графе и сам исправил ошибку. Вот как реализован интерфейс для пользователя в текущей теме см. рисунок ниже. Название элементов смысла здесь не имеет.
Показаны все зацикленные ветки, зацикленные элементы изображены красным. Журить пользователя ненужно - пользователь сам выбирая тот или иной элемент может интерактивно исправить спецификацию и избавиться от зацикленности.
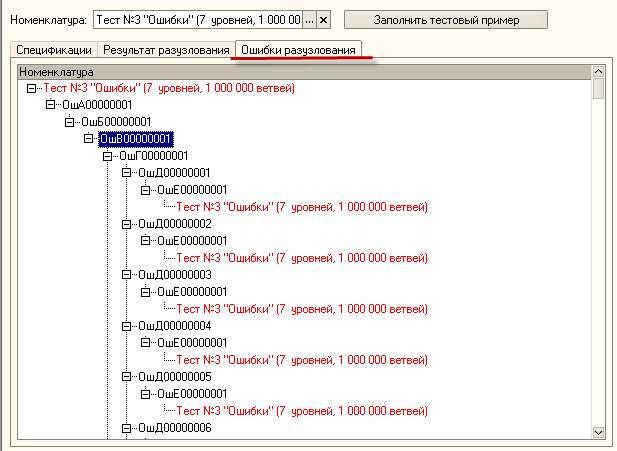
Здесь всё сложнее. И если при разузловании используется лишь движение "сверху - вниз" и применяется простое умножение, то здесь более сложные соотношения. В таких задачах особенно важно представить пользователю ясную картину расчета и возможного зацикливания.
Про "паровозы". Хотелось бы узнать про вашу софтину :
1. максимальное количество узлов при разузловании графа спецификаций (1 000 000 есть ?)
2. максимальное количество уровней графа
3. время разузлования
Имею возможность представлять, то о чем говорит romansun, так как участвовал в разработке, задача там обособленная и изначально решалась с попыткой догнать семерых зайцев по дороге прихватить еще и слона. Поэтому все эти танцы с T-SQL и XML в итоге, с появлением временных таблиц в 1С, ушли в небытие.
Решилось все продуманной структурой решающей только то, что нужно решить (без слонов). Подготовленные данные поступали в СКД, а там уже и иерархия и все остальные прелести.
(221)
1. До миллиона может и не доходило, но план продукции на пол года под 800 тысяч был.
2. Уровней до 10.
3. На эти 800тыс. 40 секунд максимум на разузлование, далее смотря какой отчет СКД, простейший довольно быстро.
пс. на предыдущих вариантах все работало гораздо дольше, полугодовой план мог и по 20 минут курить бамбук (но там больше проблема блокировок была))) )
Кстати, тут еще вопрос железа ессно! )
Время указанное ~40 сек (+-5 ) суммарно соответствует у меня
1. Обработке 6-уровневого графа с миллионом уникальных узлов.
2. Выводу выходной плоской таблицы разузлования ( 1 000 000 строк) на форму.
3. Самое важное в это время входит абсолютный контроль зацикливания , подразумевающее построение полного дерева содержащего весь пройденный граф , а не только ветки содержащие зацикливания.
Так вот если пункт 3 у вас отсутствует (он многократно замедляет разузлование) или контроль зацикливания неабсолютен (облегчен) и пользователь после разузлования не имеет полной картины пройденного графа -
то , пожалуй, сравнивать нечего.
Другими словами, контроль зацикливания - это и есть тот самый слон, без которого публика заскучает.
См. рис. (220).
1. У нас до 10 уровней ветки бывали. Если "уникальных узлов" означает количество строк в линейной таблице вида "Родитель, Элемент, количество", то примерно схоже +/-
2. Аналогично. При этом полей в таблице ~ 40 (многие из них при разузловании рассчитываются и находятся по хитрому - это наш слон).
3.
К вопросу зацикливания я подошел намного проще.
Так как задача первоначально была посчитать нормативы, то такие ошибки как цикличность считаются очень грубыми и правятся на момент обнаружения.
Поэтому проверка цикличности происходит банально по достижению максимально допустимого уровня вложенности. Например 30.
При обнаружении данного факта, разузлование останавливается и запускается процедура разбора того, что именно тут зациклилось, благо данные то все вот они во временных таблицах. Структура позволяет отследить каждый элемент по веткам дерева. Далее обнаруживается ветка с повторяющимися спецификациями и выводит их пользователю на дознание. "Ошибка: Спецификация "такая то" циклична! Разузлование невозможно!".
Конструктор видя такой момент, тут же правит спецификацию и далее все ок.
В итоге на дальнейших этапах использования разузлования ошибок не возникает. Конструктор проверяет свои спецификации до их утверждения.
Публика счастлива :)
Но на универсальность, на общее решение , конечно, не тянет и не сработает в сложных случаях.
Есть примеры более сложного зацикливания , чем А-В-С-А, и тогда пользователю , чтобы исправить зацикливание, совершенно недостаточно выводить одну ветку , а нужно видеть всю картину (весь граф с зацикленными элементами). Примеры такого зацикливания - это разного рода кольца.
Пример простейшего кольца , который в текущей теме вызвал столько споров изображен ниже.
Кроме того ограничение уровней неэффективно для случая когда например :
все ветки графа имеют уровнеь вложенности 20 , а одна или несколько 67 (пример невыдуманный).
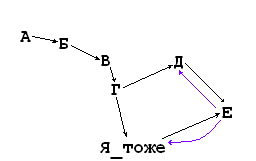
Да действительно случаи у нас совершенно разные. У нас задача была по производству где такого рода ситуация, называется заимствованием и вполне нормальна и не является цикличностью.
У вас же видимо с бюджетированием что то связанное?
Да, всё так - помощь зала помогла :). Сам я уже не фигурирую на том предприятии как 2 с лишним года - последней инфой не владею поэтому.
По поводу 'лишь движение "сверху - вниз"' скажу, что и в другую сторону тоже есть - задача применяемости как раз "снизу-вверх".
В целом, не везде же сложные и большие сборки шоп проверять их на цикличность-то.
Пример: небольшое предприятие выпускает железные ящики для противопожарного оборудования - уровней вложенности ну от силы два (может три, хотя вряд ли ). Зато номенклатура ящиков большая. Им проверка на цикличность ваще не уперлась. Зато посмотреть где и сколько применяются какие-нить болты - да, очень нужно.
Вот и всё. Почему бы рекурсивно не собрать применяемость не ставя перед собой глобальные задачи? Я придерживаюсь позиции, что в каждом конкретном случае необходимо решать отдельно, ибо 1С - это не фундаментальная наука, а прикладное программирование. ))
PS. Как же решает этот вопрос аппиус таки? Всё-таки серьёзная коммерческая разработка, они ж по идее не дожны "опуститься" до уровня прямолинейных решений. ))
Ну, а в каждом конкретном случае , разумеется , такой контроль можно или отключить или "облегчить".
С огромным интересом прочитал статью о разузловании.
У меня вопрос практического характера.
Сейчас потихонечку пишем для собственных нужд конфигурацию для автоматизации учета входящих заявок в ИТ-отдел.
В основе лежит объект "Работа" типа "Задача".
К сожалению, обнаружилось, что данный вид объекта ("Задача") не поддерживает иерархичность, а нам очень хочется реализовать именно иерархичность задач.
Например: корневая задача "Установка принтера" имеет четыре вложенные задачи - "Поиск и согласование модели", "Оформление оплаты", "Оформление сопровождающих документов", "Установка и настройка".
В идеале, количество уровней должно быть неограниченным.
Добавил для объекта "Работа" (тип "Задача") реквизит ссылочного типа ("Работа") - "Родитель".
Возникла задача графического отображения дерева задач. Сделал формирование дерева рекурсией с выводом на экран в дерево значений.
Работает, однако, медленно.
У меня следующий вопрос:
В 8.2 можно для ДинамическогоСписка формы списка указать произвольный запрос.
Если туда подставить запрос, выдающий на выходе иерархическо дерево задач по реквизиту "Родитель", то должно получиться очень красиво.
Вторую неделю бьюсь, никак не могу сформулировать нужный запрос.
Подскажите, пожалуйста, коллега, реализуема ли в принципе такая задача средствами запроса и, если да, то в каком направлении копать.
имеется исходная таблица из двух колонок - "Задача" и "Родитель". (см.картинку "Исходные данные").
В соответствии со статьей применяем к ней запрос вида:
"ВЫБРАТЬ
ТЗ.Родитель,
ТЗ.Задача
ПОМЕСТИТЬ ТЗ
ИЗ
&ТЗ КАК ТЗ
;
////////////////////////////////////////////////////////////
ВЫБРАТЬ
ТЗ.Задача КАК Задача1,
ТЗ1.Задача КАК Задача2,
ТЗ2.Задача КАК Задача3,
ТЗ3.Задача КАК Задача4
ИЗ
ТЗ КАК ТЗ
ЛЕВОЕ СОЕДИНЕНИЕ ТЗ КАК ТЗ1
ЛЕВОЕ СОЕДИНЕНИЕ ТЗ КАК ТЗ2
ЛЕВОЕ СОЕДИНЕНИЕ ТЗ КАК ТЗ3
ПО ТЗ2.Родитель = ТЗ3.Задача
ПО ТЗ1.Родитель = ТЗ2.Задача
ПО ТЗ.Родитель = ТЗ1.Задача
ИТОГИ
ВЫБОР
КОГДА Задача2 ЕСТЬ NULL
ТОГДА Задача1
КОГДА Задача3 ЕСТЬ NULL
ТОГДА Задача2
ИНАЧЕ Задача3
КОНЕЦ КАК Задача4
ПО
Задача1,
Задача2,
Задача3
;
////////////////////////////////////////////////////////////
УНИЧТОЖИТЬ ТЗ"
На выходе получаем не очень понятное, а точнее, совсем непонятное дерево значений (см. картинку "Что получилось")
А то, что мне надо нарисовано на картинке "Что надо".
На всякий случай приложил обработку, с помощью которой проводил эксперименты над таблицой значений.
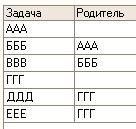
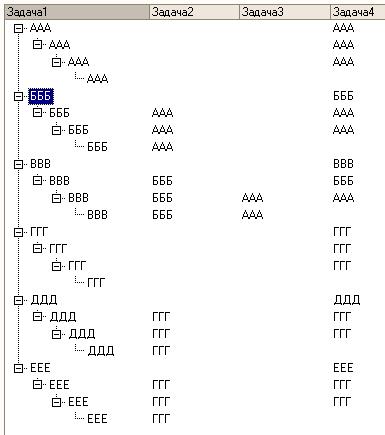
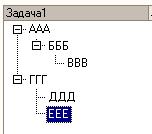
так нахаляву, запросом, вот такое дерево, как в что надо.JPG вы не получите.. это возможно только если б у вас был иерархический справочник и вы б писали, скажем, УПОРЯДОЧИТЬ ПО <тра-ля-ля> ИЕРАРХИЯ
в запросе без иерархии, только итогами, у вас будет, как бы это сказать, одинаковые по структуре ветки. Т.е. в ветке "ААА" три уровня, значит и везде три уровня... Ибо ИТОГИ ПО работают на все строки, а не только на некоторые ж :). По сути, на желаемом скрине сейчас "ИТОГИ ПО а, б, в" и "ИТОГИ ПО г, д" как-то оказались вместе :)
Насколько я правильно понял и помню прочитанную Хрусталёву, в СКД как раз таки можно замутить свою иерархию на основе табличного представления.
Ты ничего не напутал ?
Если имеется таблица с двумя колонками
Родитель , Ребенок
то ты утверждаешь , что такую иерархию "можно замутить" в СКД ?
Не зли меня.
дык мож и напутал, я ж Хрусталеву под подушкою не держу
я говорю про что, собственно, вот, к примеру, дерево вида как из запроса
выбрать ссылка
из Справочник.номенклатура
упорядочить по ссылка иерархия
мы в неиерархическом справочнике фиг получим. Это как раз тот вид, который интересует Kaperang. Но, что-то на тему иерархии и получения какой-то там "своей" иерархии я у Хрусталевой видел. Признаю, эта глава меня не интересовала и я её просто пролистал. Если был неправ, готов покаяться в ереси.
1. Таблица с двумя колонками :
Родитель, Ребенок
содержит ПРОИЗВОЛЬНЫЙ ГРАФ.
В котором возможно зацикливание, возможна ситуация, что Ребенок принадлежит двум различным Родителям.
Возможны какие угодно кольца.
Тут ни Хрусталева , ни СКД не помогут. Мало того , НЕ МОГУТ помочь в принципе.
2. Иерархический справочник описывается ДЕРЕВОМ (частный случай графа).
В нём , описанные выше случаи невозможны по определению.
Нет зацикливания, Ребенок может принаждежать только одному родителю и проч.
Поэтому для ДЕРЕВА , и только для него, возможно применение СКД .
"ВЫБРАТЬ
ТЗ.Родитель,
ТЗ.Задача
ПОМЕСТИТЬ ТЗ
ИЗ
&ТЗ КАК ТЗ
;
////////////////////////////////////////////////////////////
ВЫБРАТЬ
ВЫБОР
КОГДА ТЗ2.Задача ЕСТЬ NULL
ТОГДА ТЗ1.Задача
КОГДА ТЗ3.Задача ЕСТЬ NULL
ТОГДА ТЗ2.Задача
КОГДА ТЗ4.Задача ЕСТЬ NULL
ТОГДА ТЗ3.Задача
ИНАЧЕ ТЗ4.Задача
КОНЕЦ КАК Поле1,
ВЫБОР
КОГДА ТЗ2.Задача ЕСТЬ NULL
ТОГДА NULL
КОГДА ТЗ3.Задача ЕСТЬ NULL
ТОГДА ТЗ1.Задача
КОГДА ТЗ4.Задача ЕСТЬ NULL
ТОГДА ТЗ2.Задача
ИНАЧЕ ТЗ3.Задача
КОНЕЦ КАК Поле2,
ВЫБОР
КОГДА ТЗ2.Задача ЕСТЬ NULL
ТОГДА NULL
КОГДА ТЗ3.Задача ЕСТЬ NULL
ТОГДА NULL
КОГДА ТЗ4.Задача ЕСТЬ NULL
ТОГДА ТЗ1.Задача
ИНАЧЕ ТЗ2.Задача
КОНЕЦ КАК Поле3
ИЗ
ТЗ КАК ТЗ1
ЛЕВОЕ СОЕДИНЕНИЕ ТЗ КАК ТЗ2
ЛЕВОЕ СОЕДИНЕНИЕ ТЗ КАК ТЗ3
ЛЕВОЕ СОЕДИНЕНИЕ ТЗ КАК ТЗ4
ПО ТЗ3.Родитель = ТЗ4.Задача
ПО ТЗ2.Родитель = ТЗ3.Задача
ПО ТЗ1.Родитель = ТЗ2.Задача
ИТОГИ ПО
Поле1,
Поле2,
Поле3
;
////////////////////////////////////////////////////////////
УНИЧТОЖИТЬ ТЗ"
Теперь выдает следующий результат - см. картинку "Что получилось - 2". Уже гораздо ближе.
Но все равно, еще не совсем то - нужно - см.картинку "Что надо"

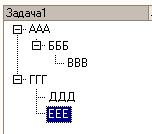
т.е. колонки 2 и 3 у вас перейдут на соответствующие позиции в колонке 1... Но полностью нужный вид таким образом получить не получится.
в почерках. -- Это же п-проблема Бен Б-бецалеля. К-калиостро же доказал,
что она н-не имеет р-решения.
-- Мы сами знаем, что она не имеет решения, -- сказал Хунта,
немедленно ощетиниваясь. -- Мы хотим знать, как ее решать.
-- К-как-то ты странно рассуждаешь, К-кристо... К-как же искать
решение, к-когда его нет? Б-бессмыслица какая-то...
-- Извини, Теодор, но это ты очень странно рассуждаешь. Бессмыслица
-- искать решение, если оно и так есть. Речь идет о том, как поступать с
задачей, которая решения не имеет. Это глубоко принципиальный вопрос..."
Аркадий и Борис Стругацкие. "Понедельник начинается в субботу"
Можно поиграться и задавая ошибки зацикливания смотреть как они отображаются в дереве, т.е. какого вида получается дерево
Такое отображение достигается
1. в результате выгрузки запроса с итогами в дерево
2. при помощи процедур событий в табличном поле.
Обычный запрос с всеми итогами выгружается в дерево на форме.
Почему же получается картинка такая "что надо" ?
Нужно посмотреть процедуру в модуле формы
ОшибкиПриВыводеСтроки(Элемент, ОформлениеСтроки, ДанныеСтроки)
В этой процедуре найдите строки
 	КодТекНоменклатуры = ДанныеСтроки["Уровень"+ДанныеСтроки.Уровень()];
	Если Не ЗначениеЗаполнено(КодТекНоменклатуры) Тогда
	  //ОформлениеСтроки.Ячейки.Уровень0.Видимость = Ложь;
	  ДанныеСтроки.Родитель.Строки.Удалить(ДанныеСтроки);
    Иначе
Так при выводе строки удаляются ненужные(пустые ветки).
Топорно , может быть, но для демонстрационной версии - вполне сойдет.
Получается , что дерево очищается от лишних веток только в видимой области.
Эта небольшая хитрость вызвана вот чем . У меня дерево может содержать до миллиона веток.
Если бы я очищал дерево в цикле перед выводом на форму , то было бы совсем грустно.
С другой стороны , а что нужно пользователю ? Нужно видеть правильное дерево.
Ну так он его и видит . А то что он не видит хм.. ему и не нужно.
ну там статья у Ish_2 в основном про сравнение скорости вывода дерева из результата запроса и через СКД. Вывод дерева из результата выполнения запроса сурьёзно тяжелее чем аналогичные действия в СКД. Это уже зафиксированный факт :)
а тут мы говорим про сам приём, когда в ИТОГИ ПО колонки "заводятся" в одну путём манипуляций с ВЫБОР КОГДА ТОГДА. На скрине

колонки 1,2 и 3 таким образом заводятся в колонку 4. Это позволяет получать привычное по виду дерево уже в самом запросе. К слову, на скрине надо было "поле4" поставить первым в выборке для наглядности... А так всю красоту не видно ))
Но никакой такой или иной способ не позволит получить разноструктурные ветки в одном дереве в запросе. Поэтому дальнейшую обработку, если кому надо, осуществляют уже по готовому дереву после вывода. В частности речь идет об убирании лишних итоговых строк, о чем в (240) и написано.
Хотя, думаю, меня и такой вариант устроит.
Добавил в свою тестовую обработку две процедуры, реализующие чистку дерева значений на лету. От себя добавил проверку на строк уровень ниже, чтобы сразу избавиться от ненужных плюсиков.
   Процедура ДеревоЗначенийПриВыводеСтроки(Элемент, ОформлениеСтроки, ДанныеСтроки)


	Если ДанныеСтроки <> Неопределено Тогда
		УбратьЛевыхРодителей(ДанныеСтроки);
		Для каждого Ветка Из ДанныеСтроки.Строки Цикл
		   УбратьЛевыхРодителей(Ветка);
		КонецЦикла;
	КонецЕсли;


КонецПроцедуры

Процедура УбратьЛевыхРодителей(ДанныеСтроки)

		ДанныеРодителя = ДанныеСтроки["Поле"+(ДанныеСтроки.Уровень()+1)];
		Если Не ЗначениеЗаполнено(ДанныеРодителя) Тогда
			ДанныеСтроки.Родитель.Строки.Удалить(ДанныеСтроки);
		КонецЕсли;

КонецПроцедуры ПоказатьИтоговый вариант запроса выглядит так:
ВЫБРАТЬ
ТЗ.Родитель,
ТЗ.Задача
ПОМЕСТИТЬ ТЗ
ИЗ
&ТЗ КАК ТЗ
;
//////////////////////////////////////////////////////////// ПоказатьРезультат выполнения - в картинке "Что получилось - 3". Если снять признак "Видимость" с колонок "Поле 1...3", то практически идентичен тому, что мне было нужно.
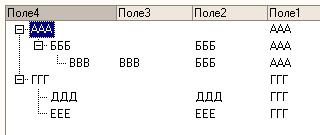
Теперь, насколько я понимаю мне, для того чтобы можно было использовать данное решение на практике, нужно еще две функции:
первая - возвращает цифрой количество уровней вложенности.
вторая - по полученной от первой функции цифре генерит текст запроса с нужным количеством уровней вложенности и подсовывает его в свойство "Запрос" динамического списка.
как то так.
Использую такой же принцип разузлования давно (в СУБД, но не в 1С), количество номенклатуры около 50000, уровень вложенности спецификаций 9-10, с получением пооперационного цикла (последовательность операций по каждой номенклатуре) уровень вложенности возрастает до 50-70.
При реализации в 1С сходной проверки на зацикливание столкнулся со следующей проблемой - ограниченность длины СтрокиКодов в 1024 знака. При превышении будет ошибка на неправильные параметры "+", да и ПОДОБНО на клиент-серверной реализации с длинными неограничеными строками не рекомендуется использовать из-за особенностей реализации (по крайней мере на MS-SQL).
Поскольку в моем случае длина кода(однозначно определяющее уровень вложения) + символ разделения, достаточно большая, ограничение действует уже на 10 уровне.
Сталкивался ли кто с подобной проблемой и есть ли какие-нибудь мысли как реализовать проверку по другому, не выходя за рамки запросной концепции.
з.ы. в своем случае длину кода к сожалению уменьшить не могу.
Что имеем в типовых конфигурациях 1с ? Длина кода+ 2 символа "%" = 12 символов.
Получаем что максимальная вложенность 1024/12 ~ 85.
То есть применимо в огромном подавляющем количестве случаях.
Даже трудно представить граф с уровнем 85 в практических задачах.
В Вашем случае , ничего кроме простого и очевидного на ум не приходит :
ввести новое дополнительное уникальное поле длиной 10 символов для идентификации объекта и использовать его при построении графа.
Но направление понятно - каким-то образом сократить размер текста, определяющего уникальность элемента, что бы уложиться в ограничение.
Однако результат получается нестабильный - добавиться еще один уровень вложения и престанет работать...
С чистым составом - все хватает, с операционным составом сложных сборок - совсем другой разговор.
Дело не в этих мелочах. Сообщите если не трудно максимальный уровень вложенности.
Интерес представляют эксперименты в УПП для графа уровня не ниже 8-9 и количеством узлов не менее миллиона.
Предполагаю, что общее время разузлования в таком случае не превысит на "среднеофисном клиент-сервере" 1 мин.
Весь сыр -бор в текущей теме разгорелся из -за двух "миллионных " тестов (см. тему) Тест №1 и Тест № 2.
Проверьте своё решение.
Если Ваш контроль зацикливания - абсолютен , то сообщите свои секунды.
Если > 40 сек в Тесте № 1
И больше 2мин. в Тесте № 2 - просьба не беспокоить.
В данной же статье рассматриваются рецептуры другого размера , речь идет о графах , содержащих 1 000 000 узлов ( тест № 1 в статье) , 2 000 000 узлов ( тест № 2 в статье) . Короче говоря , рассматриваются не бифштексы , а пароходы , тепловозы и самолеты.
Разные области применения - разные алгоритмы.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 78285
Создание 23.11.10 14:30
Обновление 05.07.11 09:44
Просмотры 73472
Загрузки 1174
Рейтинг
120
Комментарии 262
Код открыт Не указано
Рубрики Логистика, склад и ТМЦ
Кому Разработчик
Тип файла Внешняя обработка (ert,epf)
Платформа 1С:Предприятие 8
Конфигурация 1С:Комплексная автоматизация 1.х
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Бухгалтерский учет
Доступ к файлу Бесплатно (free)

