Скорость сложения строк большой длины в 1С разными методами (конкатенация строк)
Разработка - Механизмы платформы 1С


Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Итак, смоделируем сначала условие задачи.
Задача
Необходимо написать функцию, которая возвращает в строковую переменную текст вида:
Это тестовая строка 1
Это тестовая строка 2
Это тестовая строка 3
...
Это тестовая строка N
Где N - число строк.
Разобрать несколько способов получения такой переменной.
Так же сделать график скорости работы в зависимости от N и сравнить получившиеся функции по производительности.
Решение
На самом деле, несмотря на вымышленность задания подобная задача в реальной жизни, в том или ином виде встречается сплошь и рядом. Есть большой цикл в котором мы результат складываем в текстовую переменную суммой нескольких строк. Так вот, было замечено, что для большого цикла и текста, время выполнения операции сложения строк растет нелинейно и для большого количества итераций не позволительно долго.
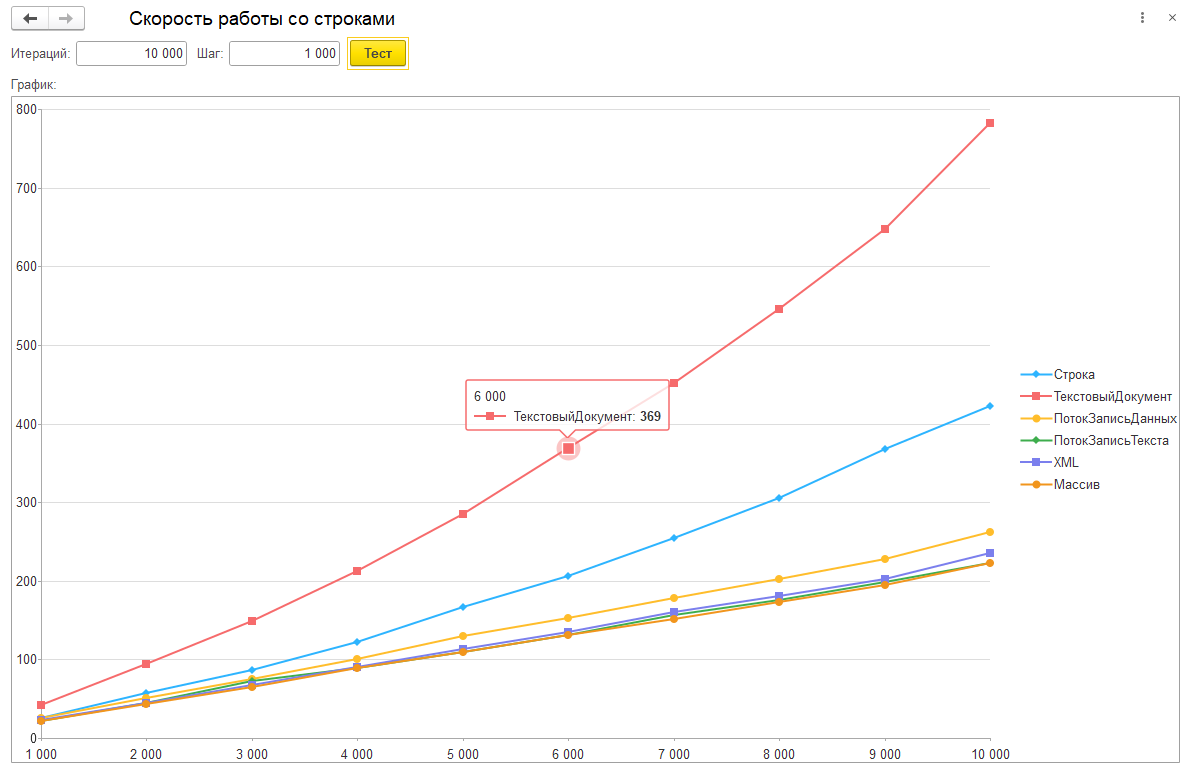
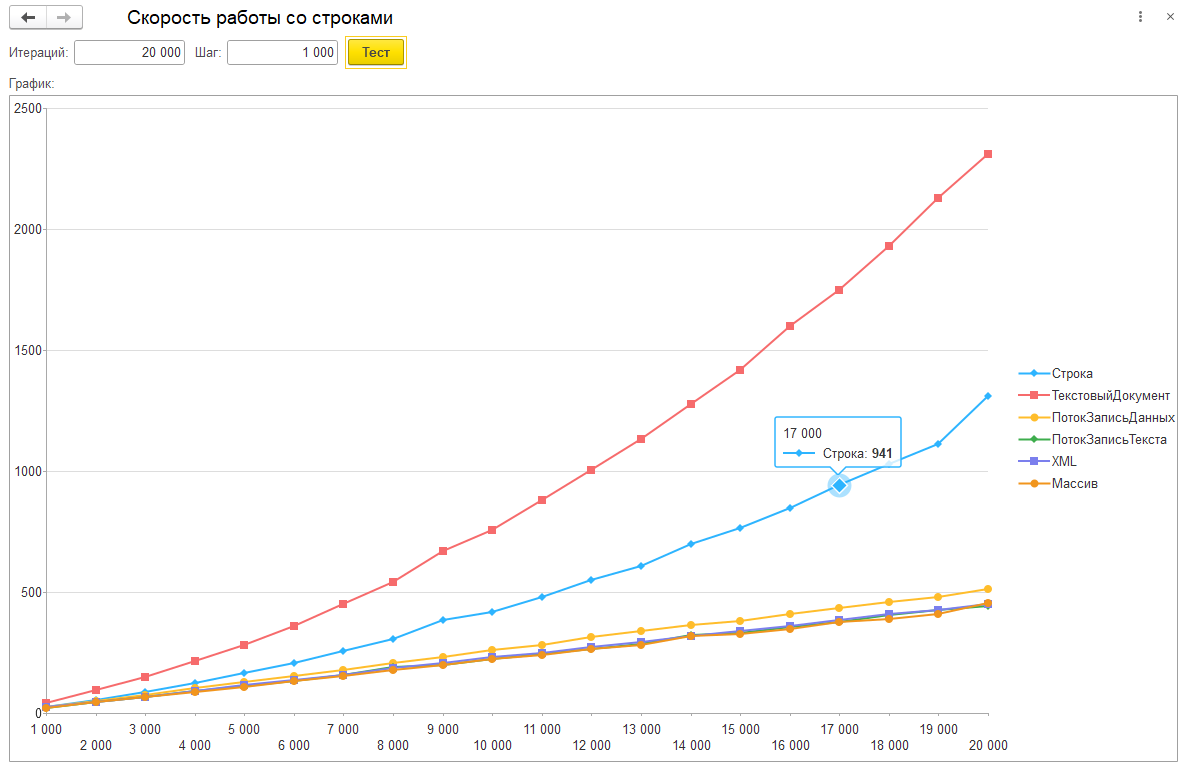
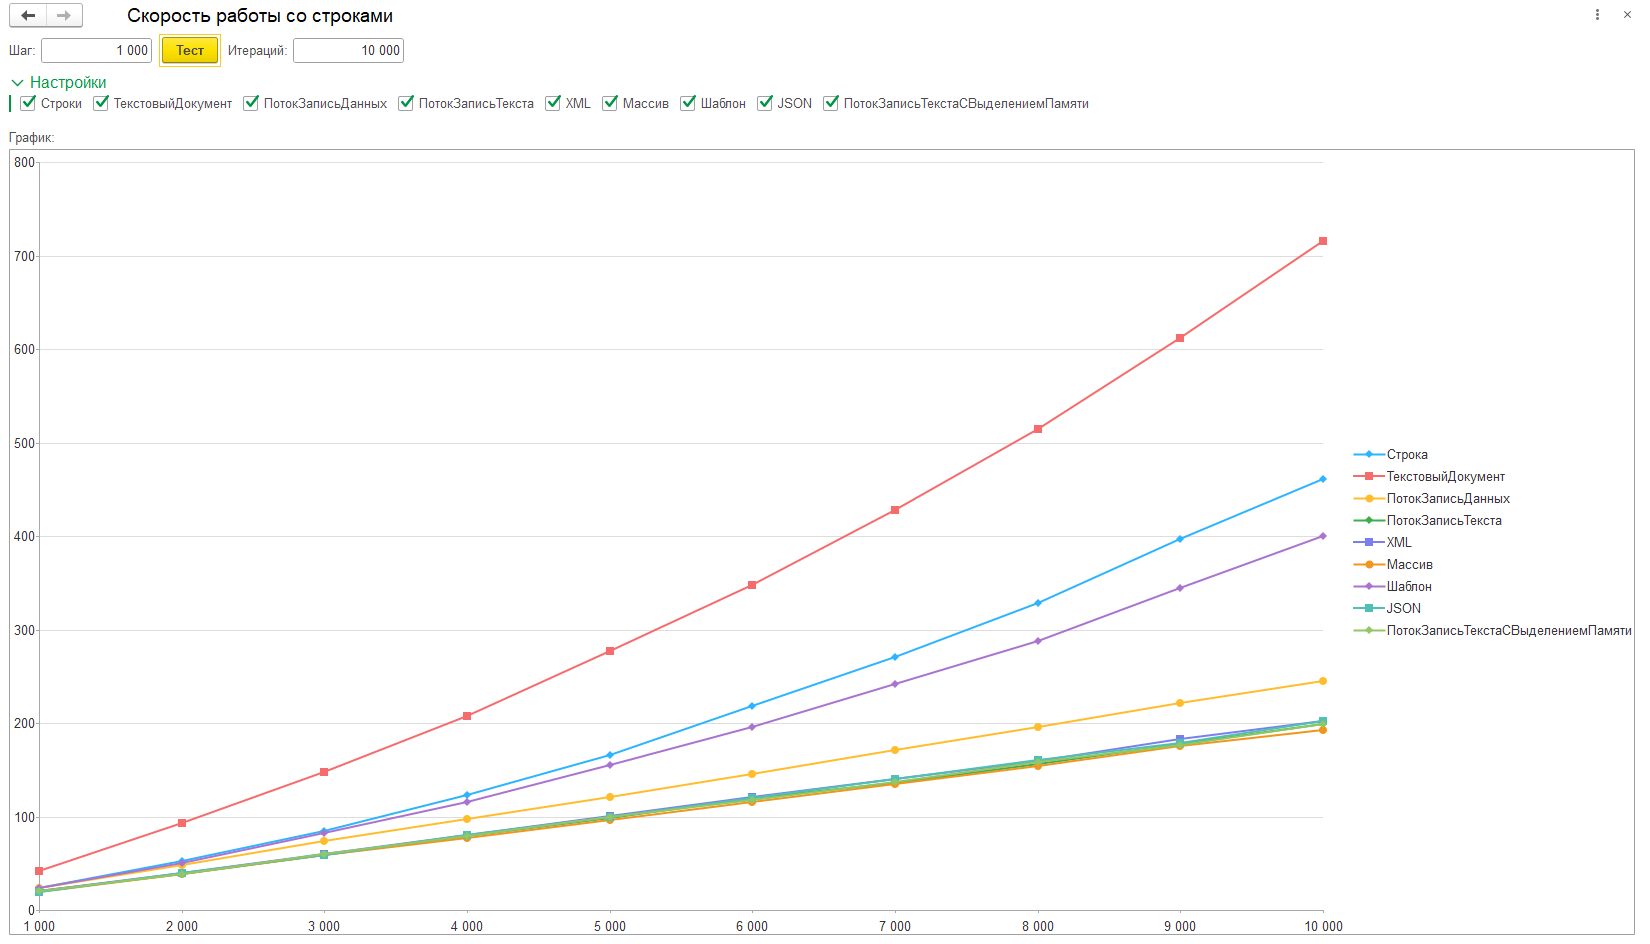
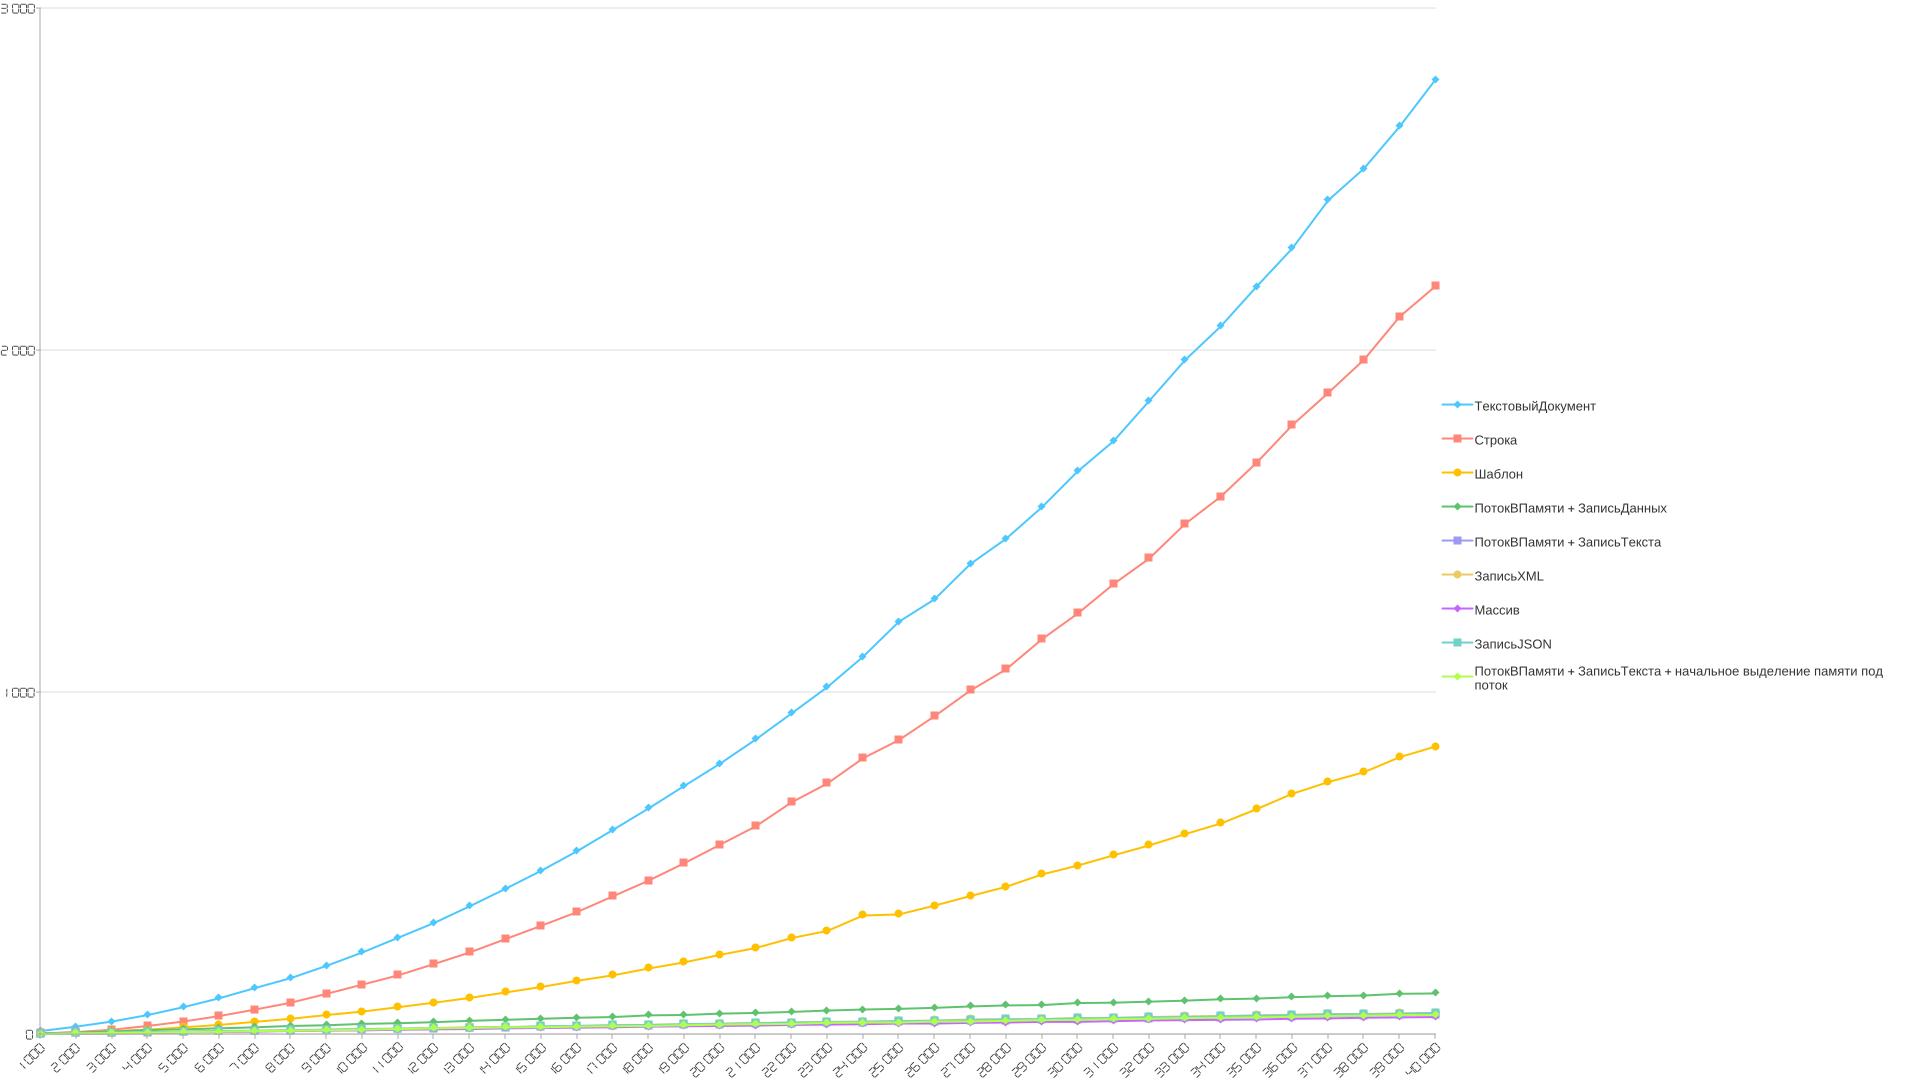
Где по оси Х у нас идет количество итераций, а по Y - время в миллисекундах.
1. ТекстовыйДокумент. Как мы видим, этот способ работает медленнее всего:
Результат = Новый ТекстовыйДокумент;
Для Индекс = 1 По КоличествоИтераций Цикл
    Результат.ДобавитьСтроку("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
Строка = Результат.ПолучитьТекст();
2. Строка. Затем у нас идет обычная работа со строкой:
Результат = "";
Для Индекс = 1 По КоличествоИтераций Цикл
    Результат = Результат + "Это тестовая строка " + Строка(Индекс) + Символы.ПС;
КонецЦикла;
3. Шаблон. Интересный предложение по реализации от coollerinc. Отнесся к этому методу скептически изначально, т.к. работа со строками никуда не девается, но ради чистоты эксперимента, добавил тест.
Результат = "";
Шаблон = "%1 %2";
Для Индекс = 1 По КоличествоИтераций Цикл
	Результат = СтрШаблон(Шаблон, Результат, "Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Как я и ожидал, результат не очень... После 10000 итераций способ становится самым медленным (на скриншоте этого не видно, но по факту это так).
4. Далее по скорости идет работа с ПотокВПамяти + ЗаписьДанных:
Результат = Новый ПотокВПамяти;
ЗаписьДанных = Новый ЗаписьДанных(Результат);
Для Индекс = 1 По КоличествоИтераций Цикл
    ЗаписьДанных.ЗаписатьСтроку("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
ЗаписьДанных.Закрыть();
Строка = ПолучитьСтрокуИзДвоичныхДанных(Результат.ЗакрытьИПолучитьДвоичныеДанные());
5. ПотокВПамяти + ЗаписьТекста. Как оказалось, со строками этот способ работает быстрее, чем ПотокВПамяти + ЗаписьДанных, хотя по идее, корни у них общие, в плане механизмов работы:
Результат = Новый ПотокВПамяти;
ЗаписьТекста = Новый ЗаписьТекста(Результат);
Для Индекс = 1 По КоличествоИтераций Цикл
    ЗаписьТекста.ЗаписатьСтроку("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
ЗаписьТекста.Закрыть();
Строка = ПолучитьСтрокуИзДвоичныхДанных(Результат.ЗакрытьИПолучитьДвоичныеДанные());
6. ЗаписьXML, тоже работает быстро. Выглядит как какая-то магия:
Результат = Новый ЗаписьXML;
Результат.УстановитьСтроку();
Для Индекс = 1 По КоличествоИтераций Цикл
    Результат.ЗаписатьБезОбработки("Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Строка = Результат.Закрыть();
7. Массив. В массив можно складывать строки и в конце использовать функцию СтрСоединить:
Результат = Новый Массив;
Для Индекс = 1 По КоличествоИтераций Цикл
    Результат.Добавить("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
Строка = СтрСоединить(Результат, Символы.ПС);
8. ЗаписьJSON, работает быстро. Спасибо Rustig, который подсказал добавить и такой вариант для тестирования.
Результат = Новый ЗаписьJSON;
Результат.УстановитьСтроку();
Для Индекс = 1 По КоличествоИтераций Цикл
	Результат.ЗаписатьБезОбработки("Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Строка = Результат.Закрыть();
Изначально было подозрение, что это будет работать быстрее чем ЗаписьXML, но это оказалось не так. Тесты показывают примерно одинаковое время работы с вариантом 6. Видимо все дело в том, что есть общие механизмы в реализации этих объектов платформы и, видимо, реализация метода ЗаписатьБезОбработки одинаковая.
9. ПотокВПамяти + ЗаписьТекста + начальное выделение памяти под поток. Думалось, что это хороший вариант для тех случаев, когда изначально известен размер данных. Спасибо Perfolenta.
Результат = Новый ПотокВПамяти(КоличествоИтераций * 16 * (СтрДлина("Это тестовая строка ") + 4));
ЗаписьТекста = Новый ЗаписьТекста(Результат);
Для Индекс = 1 По КоличествоИтераций Цикл
	ЗаписьТекста.ЗаписатьСтроку("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
ЗаписьТекста.Закрыть();
Строка = ПолучитьСтрокуИзДвоичныхДанных(Результат.ЗакрытьИПолучитьДвоичныеДанные());
Длину строки умножаем на 16 накинул на кодировку в UTF-8 и на количество итераций. Получаем примерный размер для потока. Именно примерный. В таки у нас эксперимент и выделенного размера должно быть достаточно. Но оказалось, что по скорости, что с выделением начального объема памяти, что без выделения, все работает примерно одинаково. В комментариях к статье есть мои размышления на эту тему в сторону Capacity.
Замечания и оговорки
При тестировании наткнулся на интересное. На рабочем компьютере медленнее всего работал ТекстовыйДокумент, а потом Строки, а в форуме, на скриншотах, уже самые медленные Строки, а потом ТекстовыйДокумент вместе с Шаблоном. Вопрос. Почему на разных машинах не одинаковая тенденция? Речь именно о тенденции графиков, а не времени выполнения. Т.е. если ТекстовыйДокумент самый медленный на одном компьютере по сравнению с другими, то по идее он должен и на другом быть самым медленным в сравнении, ведь механизм один и тот же. Но это не так. Вопрос остается открытым... Это хорошо видно в обсуждении.
Предварительные выводы
Если у вас строки не большой длины, то можно обойтись и простой суммой двух строковых переменных, вида: Строка1 + Строка2. Если строк достаточно, много то ни в коем случае не использовать работу с ТекстовымДокументом. Лучше выбрать что-то другое. Например, ПотокВПамяти + ЗаписьТекста. Это способ, который позволит работать с длинными строками как в памяти, так и из файла.
Удивило так же, что ПотокВПамяти с начальным выделением памяти не дает прибавки в скорости. Причем не только ощутимой, а вообще нет никакой прибавки.
Почему при работе со строками разными методами, такой большой разброс по времени выполнения - вопрос и, на мой взгляд, самое удивительное в этом, что конкатенация обычных строк - это не самый быстрый способ сложения строк...
Ну а какой из способов использовать - выбирать вам.
Прилагаю обработку, в которой можно поэкспериментировать введя свои значения итераций.
Тестировалось на платформе 8.3.19.1264
PS: Приготовьтесь, что ждать результата теста придется долго :)
PPS: В процессе написания обработки были использованы публикации:
Формирование строки большой длины
Варианты конкатенации строк в 1С и замеры производительности
Готовое решение
ККТ-ОНЛАЙН 54-ФЗ: Обработка для работы онлайн касс АТОЛ, ШТРИХ, VIKI PRINT и т.д. МАРКИРОВКА (Разрешит. режим) + ЭКВАЙРИНГ + БЕСПЛАТНЫЙ ДЕМО
Универсальная обработка для фискальных регистраторов! Подключайте любые ККТ, включая Веб сервер АТОЛ, без обновления 1С и работайте с несколькими кассами одновременно. Тестовый доступ — бесплатно!
Вступайте в нашу телеграмм-группу Инфостарт
обработка замер производительности график производительность конкатенация строки сложение
См. также
Механизмы платформы 1С Разработчик Бесплатно (free)
Разберем 15 мифов о работе платформы «1С:Предприятие 8» – как распространенных, так и малоизвестных. Начнем с классики: «Код, написанный в одну строку, работает быстрее, чем многострочный». Так ли это на самом деле?
16.07.2025 45649 TitanLuchs 109
Работа с интерфейсом WEB-интеграция Механизмы платформы 1С Бесплатно (free)
Веб-интерфейсы повышают качество внешнего вида приложений 1С, предсказуемы с точки зрения верстки, позволяют организовать удобные и высокопроизводительные рабочие места для пользователей. Расскажем об особенностях разработки веб-интерфейсов на React внутри 1С, двустороннем взаимодействии 1С и JavaScript, а также сборке веб-приложения в одностраничный файл.
19.06.2025 18661 zeegin 15
Механизмы платформы 1С Работа с интерфейсом Разработчик Стажер 1С:Предприятие 8 Бесплатно (free)
Про ООП в 1С и о том, как сделать свой код более кратким и выразительным при помощи использования текучего интерфейса (fluent interface).
03.02.2025 26021 bayselonarrend 127
Механизмы платформы 1С Разработчик 1С:Предприятие 8 Бесплатно (free)
В этой статье подробно рассматривается работа с JSON в XDTO в 1С:Предприятие. Вы узнаете, как сериализовать и десериализовать объекты XDTO в JSON, интегрировать 1С с веб-сервисами и API, а также корректно обрабатывать данные при обмене. Разбираются особенности работы с коллекциями, использование функций восстановления и частые ошибки при работе с JSON и XDTO.
30.01.2025 33263 user2122906 10
Механизмы платформы 1С Файловый обмен (TXT, XML, DBF), FTP Разработчик 1С:Предприятие 8 Бесплатно (free)
Этот материал познакомит вас с механизмом XDTO (XML Data Transfer Objects) в 1С и научит эффективно использовать его возможности. Мы разберёмся, как работать с XML-схемами, создавать модели данных, манипулировать объектами XDTO, а также сериализовать и десериализовать их в XML. Вы узнаете, как использовать XDTO для интеграции с внешними системами, избегать типичных ошибок и оптимизировать код. К концу вы будете уверенно применять XDTO для решения сложных задач обмена данными и автоматизации процессов.
17.01.2025 55714 user2122906 13
Механизмы платформы 1С WEB-интеграция Разработчик 1С:Предприятие 8 Бесплатно (free)
В платформе 8.3.27 появилась возможность использовать WebSocket-клиент. Давайте посмотрим, как это все устроено и чем оно нам полезно.
14.01.2025 46760 dsdred 110
Механизмы платформы 1С Разработчик 1С:Предприятие 8 Бесплатно (free)
Особенности "Знач" и разбор документации к нему.
10.01.2025 26436 VAAngelov 60
Механизмы платформы 1С Разработчик Стажер 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Эта небольшая статья - некоторого рода шпаргалка по файловым потокам: как и зачем с ними работать, какие преимущества это дает.
23.06.2024 40432 bayselonarrend 24
Результат = "";
Шаблон = "1% 2%
|";
Для Индекс = 1 По КоличествоИтераций Цикл

Результат = СтрШаблон(Шаблон, Результат ,  "Это тестовая строка " + Строка(Индекс) );

КонецЦикла;
Обычную работу со строкой(Результат = Результат + "Это тестовая строка " + Строка(Индекс) + Символы.ПС;), когда большие строки и несколько слогаемых, лучше не использовать. Фактически это интерпретируется примерно так:
ПромежуточныйРезультат1 = Результат + "Это тестовая строка ";
ПромежуточныйРезультат2 = ПромежуточныйРезультат1 + Строка(Индекс) ;
Результат = ПромежуточныйРезультат2 + Символы.ПС;
Это одновременно в нескольких переменных хранится почти одно и тоже, что отжирает память.
ПромежуточныйРезультат1 = Результат + "Это тестовая строка ";
ПромежуточныйРезультат2 = ПромежуточныйРезультат1 + Строка(Индекс) ;
Результат = ПромежуточныйРезультат2 + Символы.ПС;
Это одновременно в нескольких переменных хранится почти одно и тоже, что отжирает память.
Проверил ваш вариант. Он на графике фиолетовый.
Уступает вообще всем вариантам на больших значениях итераций. Чуть-чуть его видоизменил:
Результат = "";
Шаблон = "%1 %2";
Для Индекс = 1 По КоличествоИтераций Цикл
	Результат = СтрШаблон(Шаблон, Результат, "Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Вот здесь было обсуждение - продолжение темы потоков
2. Запись в json насколько быстрее записи в xml? Мне кажется, запись в джейсон должна быть быстрее.
3. Использование смешанных технологий - частями собираем тексты, абзацы, параграфы, блоки в цикле, затем последовательно их соединяем в промежуточные строки (или сразу в итоговую строку), затем промежуточные строки собираем в итоговую строку.
4. Работу со строками можно также увидеть и проанализировать в технологии обменов - для транспорта собирается не один большой файл, а несколько небольших файлов - стоит проверка на количество отправляемых данных - один файл формируется , например, только для не более 1000 объектов. То есть все понимают, что собрать и отправить файл большего размера - это значит столкнуться с другими проблемами на каждом шаге - сборка большого файла, отправка по интернету, далее чтение большого файла....На каждом шаге есть свои ограничения... Поэтому возможно лучше в цикле собрать несколько файлов, а не один итоговый....И будет быстрее.
5. Как прочитать и обойти весь справочник Номенклатура? Можно через запрос, и получить "нехватку памяти", а можно через объектную модель Выборка = Справочники.Номенклатура.Выбрать(); Пока Выборка.Следующий() Цикл....
Собственно ограничения заложены изначально, поэтому обход цикла и сборка файла должны проходить с пониманием ограничений - на твоем компе какое железо? тот же самый алгоритм на моем ноуте будет работать в два раза медленнее и вылетит в ошибку нехватки памяти...
6. Современные технологии позволяют распараллелить вычисления
Задача собрать строку - хорошо распараллеливается: ИтоговаяСтр = Стр1 + Стр2 + Стр3
- полагаю, выигрыш может быть положительный.
В статье, я пытаюсь решить классическую задачу с которой сталкивается каждый, а именно: работа со строками большой длины, в цикле с формированием большого текста. Это может быть большой HTML-документ (я в курсе про DOM-модель и про его формирование другим способом), большой какой-то текстовый файл и его обработка, или в большом цикле работа со строками и т.д. и т.п. Мое "микро-исследование" про влияние размера строк на скорость работы.
Понятно, что от компьютера к компьютеру скорость работы будет отличаться, но я думаю, что график работы как раз для этого случая. Он позволяет увидеть общую тенденцию. Как пример: на больших строках самый медленный - это ТекстовыйДокумент. Это будет так хоть на мощном компьютере, хоть на "дохлом" ноуте.
Теперь о конструктиве. По п.6 надо подумать как это втиснуть в текущий тест.
(3)
Замер используемой памяти? Хм. Когда в 1С появился профилировщик памяти? ТЖ, насколько я знаю, позволяет включить мониторинг утечек памяти, но здесь то утечек памяти нет, да и моментом очистки памяти разработчик в явном виде управлять не может. Включить и выключить мониторинг потребляемой памяти для конкретной процедуры в 1С, опять же, на сколько я знаю, такой возможности нет. Если ошибаюсь и это возможно, то поправьте меня пожалуйста. Был бы признателен. Спасибо.
в твоем микро-исследовании ты написал:
2. ЗаписьXML, тоже работает быстро. Выглядит как какая-то магия:
Результат = Новый ЗаписьXML;
Результат.УстановитьСтроку();
Для Индекс = 1 По КоличествоИтераций Цикл
Результат.ЗаписатьБезОбработки("Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Строка = Результат.Закрыть();
Хотелось бы увидеть разницу с записью в джейсон. Есть предположение, что магия будет интересней.
Особенно при записи текста для html-страницы.
Замысел понял.
Проверил, примерно одинаково работают. Причем где-то дольше XML, где-то JSON на 1-2 единицы. Так что примерно равны по скорости. Как я понимаю, равенство потому, что используется метод ЗаписатьБезОбработки и там и там. А т.к. скорее всего внутри ЗаписьXML и ЗаписьJSON имеют в реализации общего класса-предка, который с записанными строками без обработки работает одинаково.
Проверяемый блок кода:
Результат = Новый ЗаписьJSON;
Результат.УстановитьСтроку();
Для Индекс = 1 По КоличествоИтераций Цикл
	Результат.ЗаписатьБезОбработки("Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Строка = Результат.Закрыть();

В платформе 1с имеются известные способы обхода нехватки памяти и ускорения обхода цикла для большого массива данных. Простой и показательный пример со справочником Номенклатура - об этом также на ИТС написано - не держать в памяти весь массив данных, а последовательно его считывать - это обычная практика работы с большими массивами данных.
Задача записи длинной строки (которая формируется в цикле) - делится собственно на две -
1) откуда и как берутся сведения (данные) - как раз я привел пример как можно ускорить в целом алгоритм
2) как записывать в строку - последовательно или кучей - как раз это и есть та классическая задача, с которой ты начал.
Еще раз, скорость прохождения алгоритма для Записи строки (любой вариант возьми) по справочнику Номенклатура будет разным для случая обхода через объектную модель и через Запрос по всему справочнику и дальнейшему обходу по результату выполнения запроса....
В общем разная скорость сначала считывания данных, и скорость записи в строку - для определенного варианта постоянна. Итоговая скорость разная...
И кстати, если обратить внимание на скриншоты в публикации и в форуме, то можно заметить разницу между скоростью работы со строками и текстовым документом.
В публикации самый медленный ТекстовыйДокумент, а потом Строки, а в форуме уже самые медленные Строки, а потом ТекстовыйДокумент.
Дело в том, что публикацию я писал на работе, а там стоит компьютер на AMD Ryzen 3700 + 32 Гб ОЗУ, а в форуме я отвечаю на компьютере Intel Core-i5 9600К + 32 Гб. Отсюда такая разница. Интересно, почему такой разброс на машинах с разной архитектурой...
Также предположу, что на работе может стоять ECC-память, которую дома вообще никак не поставить (ибо там 9600К)

Соответственно, предварительно накапливая строки, мы получаем возможность выделить память один раз и скопировать все строки в итоговую за один проход... общее выделение памяти будет больше, а фрагментация меньше...
Можно попробовать ещё вариант через ПотокВПамяти, но не так как у автора, а с предварительным выделением памяти под суммарную длину строк, если длина всех строк заранее известна... дело в том, что если заранее не указать необходимый размер потока, то в игру вступает внутренняя логика автоматического увеличения размера буфера при добавлении данных, что ведет к дополнительным расходам...
С текстовым документом особая история, т.к. внутри себя, при добавлении строки он скорее всего сканирует её на предмет наличия разделителей строки...
Провел тест и ничего особо не меняется при назначении сразу нужного объема.
Скорее всего там все обстоит точно так же, как и в других ЯП с подобными структурами. Насколько я знаю есть несколько стратегий работы с памятью с использованием Capacity (емкость), которую не надо путать с размером.
Грубо говоря, Capacity - это объем сколько занимает память под объект, когда реальный размер занимаемых данных полностью заполнен этот объем увеличивается. Причем не на 1, а сразу в 2 раза, или как-то еще.
Таким образом, ПотокВПамяти не перераспределяет память каждый раз, когда что-то вставляется, а только тогда, когда дополнительная память исчерпана.
Пример как оно работает в других ЯП (схематично): Пусть начальное количество элементов в массиве - 0, начальное значение Capacity массива - 8, и размер одного элемента 1 байт (для простоты).
Теперь в цикле мы добавляем по 1 элементу в массив. Как только количество элементов станет равным 8, Capacity (емкость) увеличится до 16, как только количество элементов станет 16, Capacity увеличится до 32, когда дойдет до 32, произойдет увеличение и выделение памяти сразу под 64 элемента и т.д.
Такой подход позволяет достаточно быстро увеличить емкость массива и на больших массивах перераспределение памяти будет происходить не часто. При этом память будет использоваться достаточно экономно.
Понятно, это всего лишь пример. В реальной жизни увеличение Capacity может быть не на 2, а на 1.5 или еще как-то, как решат разработчики. Да и вообще там все несколько сложнее, на самом деле :)
Использовал код:
Результат = Новый ПотокВПамяти(КоличествоИтераций * 16 * (СтрДлина("Это тестовая строка ") + 4)); // UTF
ЗаписьТекста = Новый ЗаписьТекста(Результат);
Для Индекс = 1 По КоличествоИтераций Цикл
	ЗаписьТекста.ЗаписатьСтроку("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
ЗаписьТекста.Закрыть();
Строка = ПолучитьСтрокуИзДвоичныхДанных(Результат.ЗакрытьИПолучитьДвоичныеДанные());
Показать
например, если избавиться от лишних итераций цикла, то сразу можно получить большой выигрыш:
КоличествоИтераций=100000;

Стр="";
Для Индекс = 1 По 1000 Цикл
    Стр=Стр+"Ф";
КонецЦикла;

т=ТекущаяУниверсальнаяДатаВМиллисекундах();
Результат = Новый ПотокВПамяти(КоличествоИтераций * 16 * (СтрДлина(Стр) + 4)); // UTF
ЗаписьТекста = Новый ЗаписьТекста(Результат);
Для Индекс = 1 По КоличествоИтераций/10 Цикл
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
    ЗаписьТекста.ЗаписатьСтроку(Стр);
КонецЦикла;
ЗаписьТекста.Закрыть();
Строка = ПолучитьСтрокуИзДвоичныхДанных(Результат.ЗакрытьИПолучитьДвоичныеДанные());
Сообщить(ТекущаяУниверсальнаяДатаВМиллисекундах()-т);


т=ТекущаяУниверсальнаяДатаВМиллисекундах();
Результат = Новый ПотокВПамяти;
ЗаписьТекста = Новый ЗаписьТекста(Результат);
Для Индекс = 1 По КоличествоИтераций Цикл
    ЗаписьТекста.ЗаписатьСтроку(Стр);
КонецЦикла;
ЗаписьТекста.Закрыть();
Строка = ПолучитьСтрокуИзДвоичныхДанных(Результат.ЗакрытьИПолучитьДвоичныеДанные());
Сообщить(ТекущаяУниверсальнаяДатаВМиллисекундах()-т);
ПоказатьКогда же я запускаю этот же код на своей Перфоленте, то версия с предварительным выделением памяти работает быстрее в среднем на 11%, как и предполагалось...
Ещё одна странность, я просто копипастил Ваш код, но у меня в 1С ТекстовыйДокумент работает значительно быстрее, чем простая конкатенация строк, Не так уж и много отставая от потоков... возможно это зависит от версии платформы...
И ещё, в Вашем коде для простой конкатенации можно сделать одно маленькое улучшение, значительно увеличивающее производительность, надо всего-лишь взять часть выражения в скобки:
Результат = "";
Для Индекс = 1 По КоличествоИтераций Цикл
    Результат = Результат + ("Это тестовая строка " + Строка(Индекс) + Символы.ПС);
КонецЦикла;
Да! По правилам то, что в скобках вычисляется первым, а потом добавить к большой строке одной строкой, а если без скобок, то все подстроки добавляются к большой строке по очереди, что при работе с большими строками будет медленней. Отличное предложение.
Или вообще остановиться на конкатенации константной строки - чтобы исключить затраты времени на её формирование!
Но замечание, безусловно, архиполезное - но существенное только для прямой конкатенации строк!
Для чистоты эксперимента, стоило бы проверить такой вариант:
Переменная1 = "Это тестовая строка 1";
Переменная2 = "Это тестовая строка 2";
...
Переменная1000 = "Это тестовая строка 1000";

//***начать отсчет времени ***

МассивСтрок = новый Массив();
МассивСтрок.Добавить(Переменная1);
МассивСтрок.Добавить(Переменная2);
...
МассивСтрок.Добавить(Переменная1000);
Строка = СтрСоединить(МассивСтрок, Символы.ПС);

//*** Закончить замер времени ***

Сообщить(Строка); ПоказатьРезультат = Новый Массив;
Для Индекс = 1 По КоличествоИтераций Цикл
Результат.Добавить("Это тестовая строка " + Строка(Индекс));
КонецЦикла;
Строка = СтрСоединить(Результат, Символы.ПС);
А что если рассмотреть строку как небольшую "книгу"?
Книга - это двумерный массив (n,m) - где n - количество страниц, m - количество строк на странице
сначала собираем книгу цикл в цикле, затем цикл в цикле обращаемся к СтрСоединить страница за страницей...
Кол-во строк = 1000 ? тогда книгу можно представить как 20-ть страниц по 50 строк....
Если подобная задача касалась бы разметки html-страницы, я бы еще попробовал использовать Соответствие, ключами которого были бы условно говоря <заголовок1><тело1><что-то еще>, а значениями были бы как раз-таки строки... это для простой html-страницы...
для сложной html-страницы попробовал бы использовать структуру + массивы - как раз по подобию древовидной структуры json
Результат = Новый Массив(КоличествоИтераций);
Для Индекс = 0 По КоличествоИтераций-1 Цикл
Результат[Индекс] = "Это тестовая строка " + Строка(Индекс+1));
КонецЦикла;
Строка = СтрСоединить(Результат, Символы.ПС);
вот код 4-х примеров (сценариев алгоритма)
Старт = ТекущаяДата();

	//первый пример
	Результат = "";
	Для Индекс = 1 По КоличествоИтераций Цикл
		Результат = Результат + "Это тестовая строка " + Строка(Индекс) + Символы.ПС;
	КонецЦикла;

	Стоп = ТекущаяДата();
	Сообщить(Стоп - Старт);

	//второй пример
	Старт = ТекущаяДата();

	КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	Книга = Новый Массив;
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	//Результат = СтрСоединить(Книга, Символы.ПС);
	Результат = "";
	Для Индекс = 0 По КолСтраниц-1 Цикл
		Результат = Результат + Книга.Получить(Индекс);
	КонецЦикла;

	Стоп = ТекущаяДата();
	Сообщить(Стоп - Старт);

	//третий пример
	Старт = ТекущаяДата();

	Книга = Новый Массив(КолСтраниц);
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	//Результат = СтрСоединить(Книга, Символы.ПС);
	Результат = "";
	Для Индекс = 0 По КолСтраниц-1 Цикл
		Результат = Результат + Книга.Получить(Индекс);
	КонецЦикла;

	Стоп = ТекущаяДата();
	Сообщить(Стоп - Старт);

	//четвертый пример
	Старт = ТекущаяДата();

	Книга = "";
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга = Книга + Страница;
	КонецЦикла;

	Стоп = ТекущаяДата();
	Сообщить(Стоп - Старт);
Показатьвот результат:
65
1
0
2
у меня нет функции СтрСоединить() - я ее заменил на обход массива

С прямой конкатенацией строк уже выше (15) упомянули, что крайне важна скобочная оптимизация! В идеале (для чистоты замеров) - везде (во всех ваиантах) вынести это вычисление в отдельной переменной, которую уже конкатенировать разными способами (ну или просто использовать константную строку - для данного теста этого достаточно). А вы в последующих тестах вообще работали с готовыми строками!
И не понятно, зачем так всё усложнять?
Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	//первый пример
	Результат = "";
	Для Индекс = 1 По КоличествоИтераций Цикл
		Результат = Результат + ("Это тестовая строка " + Строка(Индекс) + Символы.ПС);
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);

	//второй пример
	Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	Книга = Новый Массив;
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + ("Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС);
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	//Результат = СтрСоединить(Книга, Символы.ПС);
	Результат = "";
	Для Индекс = 0 По КолСтраниц-1 Цикл
		Результат = Результат + Книга.Получить(Индекс);
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);

	//третий пример
	Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	Книга = Новый Массив(КолСтраниц);
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + ("Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС);
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	//Результат = СтрСоединить(Книга, Символы.ПС);
	Результат = "";
	Для Индекс = 0 По КолСтраниц-1 Цикл
		Результат = Результат + Книга.Получить(Индекс);
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);

	//четвертый пример
	Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	Книга = "";
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + ("Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС);
		КонецЦикла;

		Книга = Книга + Страница;
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);
ПоказатьРезультат для 30 000 строк и 60 строк на страницу:
15 581
2 985
2 711
2 963

для первого приближения и больших данных всегда можно использовать ТекущаяДата() - она покажет сравнительно и относительно разницу между алгоритмами.
(37)
переписал алгоритм со скобочной оптимизацией - в итоге время прохождения алгоритма увеличилось в 5 раз! в моем случае оптимизации не произошло!!! давайте предметно говорить - как нужно скобки расставить чтобы был выигрыш в алгоритме?
(37)
не понял к чему? у меня продемонстрирован пример 3 - за счет алгоритма через "книги и страницы "- смотрите пример 3 - алгоритм ускорился в 60 раз !
мне интересен был только алгоритмический подход... а не синтаксический....

для замера другой функцией:
Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	//первый пример
	Результат = "";
	Для Индекс = 1 По КоличествоИтераций Цикл
		Результат = Результат + "Это тестовая строка " + Строка(Индекс) + Символы.ПС;
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);

	//второй пример
	Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	Книга = Новый Массив;
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	//Результат = СтрСоединить(Книга, Символы.ПС);
	Результат = "";
	Для Индекс = 0 По КолСтраниц-1 Цикл
		Результат = Результат + Книга.Получить(Индекс);
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);

	//третий пример
	Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	Книга = Новый Массив(КолСтраниц);
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	//Результат = СтрСоединить(Книга, Символы.ПС);
	Результат = "";
	Для Индекс = 0 По КолСтраниц-1 Цикл
		Результат = Результат + Книга.Получить(Индекс);
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);

	//четвертый пример
	Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	Книга = "";
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга = Книга + Страница;
	КонецЦикла;

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);
Показатьрезультат для 30 000 строк и 60 строк на странице:
39 682
766
524
719

ТекстовыйФайл = Новый ЗаписьТекста();
ТекстовыйФайл.ЗаписатьСтроку()Но "ЗаписьJSON" ещё немного быстрее - при том же количестве кода (хотя при присединении более длинных строк происходит незначительное снижение производительности относительно "ЗаписьXML")!
Но быстрее всего - это варианты с "Массив+СтрСтоединить()" - рекомендуются для постоянного использования в современных конфигурациях и версиях платформы!
Эти варианты тяготеют к методике применения "StringBuilder" в C#
Причём вариант с предварительным выделением памяти под массив не даёт сколько-нибудь заметного прироста производительности (всё и без него работает очень быстро; начинаешь задумываться - может 1С оптимизировала работу с коллекцией "Массив" и ввела-таки экстенсивное выделением блоков памяти в резерв для следующих элементов?) - выполнение на 100K и 1М итераций (кол строк) дало даже обратный результат - выделение памяти заранее даже оказалось медленнее (а оба варианта с массивом были даже медленнее чем "ЗаписьJSON") - но это скорее всего артефакт чистоты эксперимента - всё-таки 1М cтрок заполняются достаточно долго! Да и в реальной практике такое количество - очень большая редкость! Тут скорее даже размер строки важнее - чем количество итераций.
Если провести анализ:
То инструкции алгоритма вида
ЗаписьТекста.ЗаписатьСтроку(Стр);
ЗаписьXML.ЗаписатьБезОбработки(Стр);
Массив.Добавить(Стр);
Массив[Индекс] = Стр;
Относительно друг друга занимают примерно одно и то же время (в % от выполнения всего алгоритма - причём примерно в 2 раза меньше времени - чем уходит на инструкции цикла "Для Индекс = 1 По КоличествоИтераций Цикл КонецЦикла" - что меня сильно удивило) - скорее всего почти все затраты времени - это передача значения переменной (скорее всего просто ссылки, без копирования всей области памяти - так как от размера Стр соотношение не меняется) и вызов метода обхекта с переключением контекста на его модуль реализации).
Финальное же формирование строки - методами
ПолучитьСтрокуИзДвоичныхДанных(ДвоичныеДанныеИзПотокаВПамяти)
Закрыть()
СтрСоединить()
Почти не оказывают влияния (чем больше итераций - тем меньше их влияние, при сохранение итоговой длины строки; ну разве что СтрСоединить() чуть-чуть медленнее, чем Закрыть() записей XML/JSON и чуть-чуть быстрее чем ПолучитьСтрокуИзДвоичныхДанных() ).
Тем самым - основные затраты - это цикл - весь блок это более 99% всего времени во всех вариантах!
Тогда вывод такой - во всех указанных вариантах собственно обработка конкатенации строк идёт очень быстро - побочные затраты на цикл и вызовы методов объектов (в т.ч. скрытые - при присвоении индексированной ячейке массива значения) - куда более значительны и составляют почти всё время выполнения!
Работа с Массивом и функцией СтрСоединить - чуть быстрее, но она есть только с некоторого релиза 8.3 совместимости конфигурации и платформы. Работа с ЗаписьXML - является классической, старой, проверенной и почти такой же производительной!
Предварительное выделение памяти для Массива - как ни странно - играет даже обратную роль - может чуть снизить производительность (причём даже не за счёт затрат на конструкторе (хотя они тоже есть - но не значительны), а именно на присвоении значения ячейке массива по индексу (впрочем эти затраты тоже не значительны - но они находятся в цикле)).
Применение же классической конкатенации строк сильно проседает по производительности при числе строк свыше 1000. До 100 строк можно использовать и рядовую конкатенацию строк - друге способы не будут иметь значительного превосходства. А до 1000 строк - затраты времени по-прежнему будут фактически не велики (с учётом, что внутри цикла будет ещё какой-то продуктивный алгоритм) даже для рядовой конкатенации - но тут, конечно, ещё многое зависит от объёма строк - как быстро будет расти итоговая строка.
При числе итераций свыше 1000 всё зависит от затрат времени на продуктивном алгоритме внутри цикла - если он более 1 секунды на итерацию - тоже можно не заморачиваться на затраты времени на конкатенацию строк. В циклах свыше 10000 тыс строк уже настоятельно рекомендую выбрать любую оптимизацию конкатенации строк - даже если продуктивная часть будет ещё дольше - уж больно много времени будет занимать рядовая конкатенация строк.
Варианты с постраничным разбиением на массивы, предложенные в (33)-(38) - оказались не стабильны (всё зависит от размеров строк и их количества - разные размеры страниц бывает по-разному эффективны) - но все они, как минимум незначительно, проигрывают описанным выше вариантам - поэтому заворачиваться с постраничным разбиением смысла нет!
Некоторые мои замеры (мс): |
|---|
| 100Kx100
Строка: 322 601 ЗаписьТекста: 3 668 ЗаписьXML: 3 627 ЗаписьJSON: 3 597 Массив: 3 502 Массив(Кол): 3 550 1Kx100 Строка: 31 ЗаписьТекста: 32 ЗаписьXML: 31 ЗаписьJSON: 31 Массив: 31 Массив(Кол): 32 1Kx10000 Строка: 3 077 ЗаписьТекста: 156 ЗаписьXML: 63 ЗаписьJSON: 46 Массив: 63 Массив(Кол): 47 10Kx100 ЗаписьXML: 303 ЗаписьТекста: 296 ЗаписьJSON: 297 Массив: 297 Массив(Кол): 297 10Kx10000 ЗаписьТекста: 1 592 ЗаписьXML: 672 ЗаписьJSON: 523 Массив: 547 Массив(Кол): 515 100Kx1000 ЗаписьТекста: 4 261 ЗаписьXML: 3 324 ЗаписьJSON: 3 225 Массив: 3 101 Массив(Кол): 3 122 1Mx100 ЗаписьТекста: 30 760 ЗаписьXML: 30 470 ЗаписьJSON: 33 150 Массив: 30 556 Массив(Кол): 29 850 |
Код:
Процедура Тест(КоличествоИтераций, Стр)
	//Стр2 = Стр + Символы.ПС;
	//т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	//Результат = "";
	//Для Индекс = 1 По КоличествоИтераций Цикл
	//    Результат = Результат + Стр2;
	//КонецЦикла;
	//Сообщить("Строка: "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));

	т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	Результат = Новый ПотокВПамяти;
	ЗаписьТекста = Новый ЗаписьТекста(Результат);
	Для Индекс = 1 По КоличествоИтераций Цикл
	    ЗаписьТекста.ЗаписатьСтроку(Стр);
	КонецЦикла;
	ЗаписьТекста.Закрыть();
	ДД = Результат.ЗакрытьИПолучитьДвоичныеДанные();
	Строка = ПолучитьСтрокуИзДвоичныхДанных(ДД);
	Сообщить("ЗаписьТекста: "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));

	т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	Результат = Новый ЗаписьXML;
	Результат.УстановитьСтроку();
	Для Индекс = 1 По КоличествоИтераций Цикл
	    Результат.ЗаписатьБезОбработки(Стр);
	КонецЦикла;
	Строка = Результат.Закрыть();
	Сообщить("ЗаписьXML: "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));

	т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	Результат = Новый ЗаписьJSON;
	Результат.УстановитьСтроку();
	Для Индекс = 1 По КоличествоИтераций Цикл
	    Результат.ЗаписатьБезОбработки(Стр);
	КонецЦикла;
	Строка = Результат.Закрыть();
	Сообщить("ЗаписьJSON: "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));

	т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	Результат = Новый Массив;
	Для Индекс = 1 По КоличествоИтераций Цикл
	    Результат.Добавить(Стр);
	КонецЦикла;
	Строка = СтрСоединить(Результат, Символы.ПС);
	Сообщить("Массив: "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));

	т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	Результат = Новый Массив(КоличествоИтераций);
	Для Индекс = 0 По КоличествоИтераций-1 Цикл
	    Результат[Индекс] = Стр;
	КонецЦикла;
	Строка = СтрСоединить(Результат, Символы.ПС);
	Сообщить("Массив(Кол): "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));

	//СтраницаКолСтрок = 40;
	//т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	//КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	//Книга = Новый Массив(КолСтраниц);
	//Для Индекс1 = 0 По КолСтраниц-1 Цикл
	//
	//	Страница = "";
	//	Для Индекс2 = 1 По СтраницаКолСтрок Цикл
	//		Страница = Страница + Стр2;
	//	КонецЦикла;
	//
	//	Книга.Добавить(Страница);
	//КонецЦикла;
	//
	//Результат = "";
	//Для Индекс = 0 По КолСтраниц-1 Цикл
	//	Результат = Результат + Книга.Получить(Индекс);
	//КонецЦикла;
	//c = ТекущаяУниверсальнаяДатаВМиллисекундах();
	//Сообщить("Массив страницы("+СтраницаКолСтрок+"): "+(c-т));
	//
	//СтраницаКолСтрок = 60;
	//т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	//КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	//Книга = Новый Массив(КолСтраниц);
	//Для Индекс1 = 0 По КолСтраниц-1 Цикл
	//
	//	Страница = "";
	//	Для Индекс2 = 1 По СтраницаКолСтрок Цикл
	//		Страница = Страница + Стр2;
	//	КонецЦикла;
	//
	//	Книга.Добавить(Страница);
	//КонецЦикла;
	//
	//Результат = "";
	//Для Индекс = 0 По КолСтраниц-1 Цикл
	//	Результат = Результат + Книга.Получить(Индекс);
	//КонецЦикла;
	//c = ТекущаяУниверсальнаяДатаВМиллисекундах();
	//Сообщить("Массив страницы("+СтраницаКолСтрок+"): "+(c-т));
	//
	//СтраницаКолСтрок = 100;
	//т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	//КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	//Книга = Новый Массив(КолСтраниц);
	//Для Индекс1 = 0 По КолСтраниц-1 Цикл
	//
	//	Страница = "";
	//	Для Индекс2 = 1 По СтраницаКолСтрок Цикл
	//		Страница = Страница + Стр2;
	//	КонецЦикла;
	//
	//	Книга.Добавить(Страница);
	//КонецЦикла;
	//
	//Результат = "";
	//Для Индекс = 0 По КолСтраниц-1 Цикл
	//	Результат = Результат + Книга.Получить(Индекс);
	//КонецЦикла;
	//c = ТекущаяУниверсальнаяДатаВМиллисекундах();
	//Сообщить("Массив страницы("+СтраницаКолСтрок+"): "+(c-т));
	//
	//
	//СтраницаКолСтрок = 1000;
	//т=ТекущаяУниверсальнаяДатаВМиллисекундах();
	//КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	//Книга = Новый Массив(КолСтраниц);
	//Для Индекс1 = 0 По КолСтраниц-1 Цикл
	//
	//	Страница = "";
	//	Для Индекс2 = 1 По СтраницаКолСтрок Цикл
	//		Страница = Страница + Стр2;
	//	КонецЦикла;
	//
	//	Книга.Добавить(Страница);
	//КонецЦикла;
	//
	//Результат = "";
	//Для Индекс = 0 По КолСтраниц-1 Цикл
	//	Результат = Результат + Книга.Получить(Индекс);
	//КонецЦикла;
	//c = ТекущаяУниверсальнаяДатаВМиллисекундах();
	//Сообщить("Массив страницы("+СтраницаКолСтрок+"): "+(c-т));

КонецПроцедуры
Показать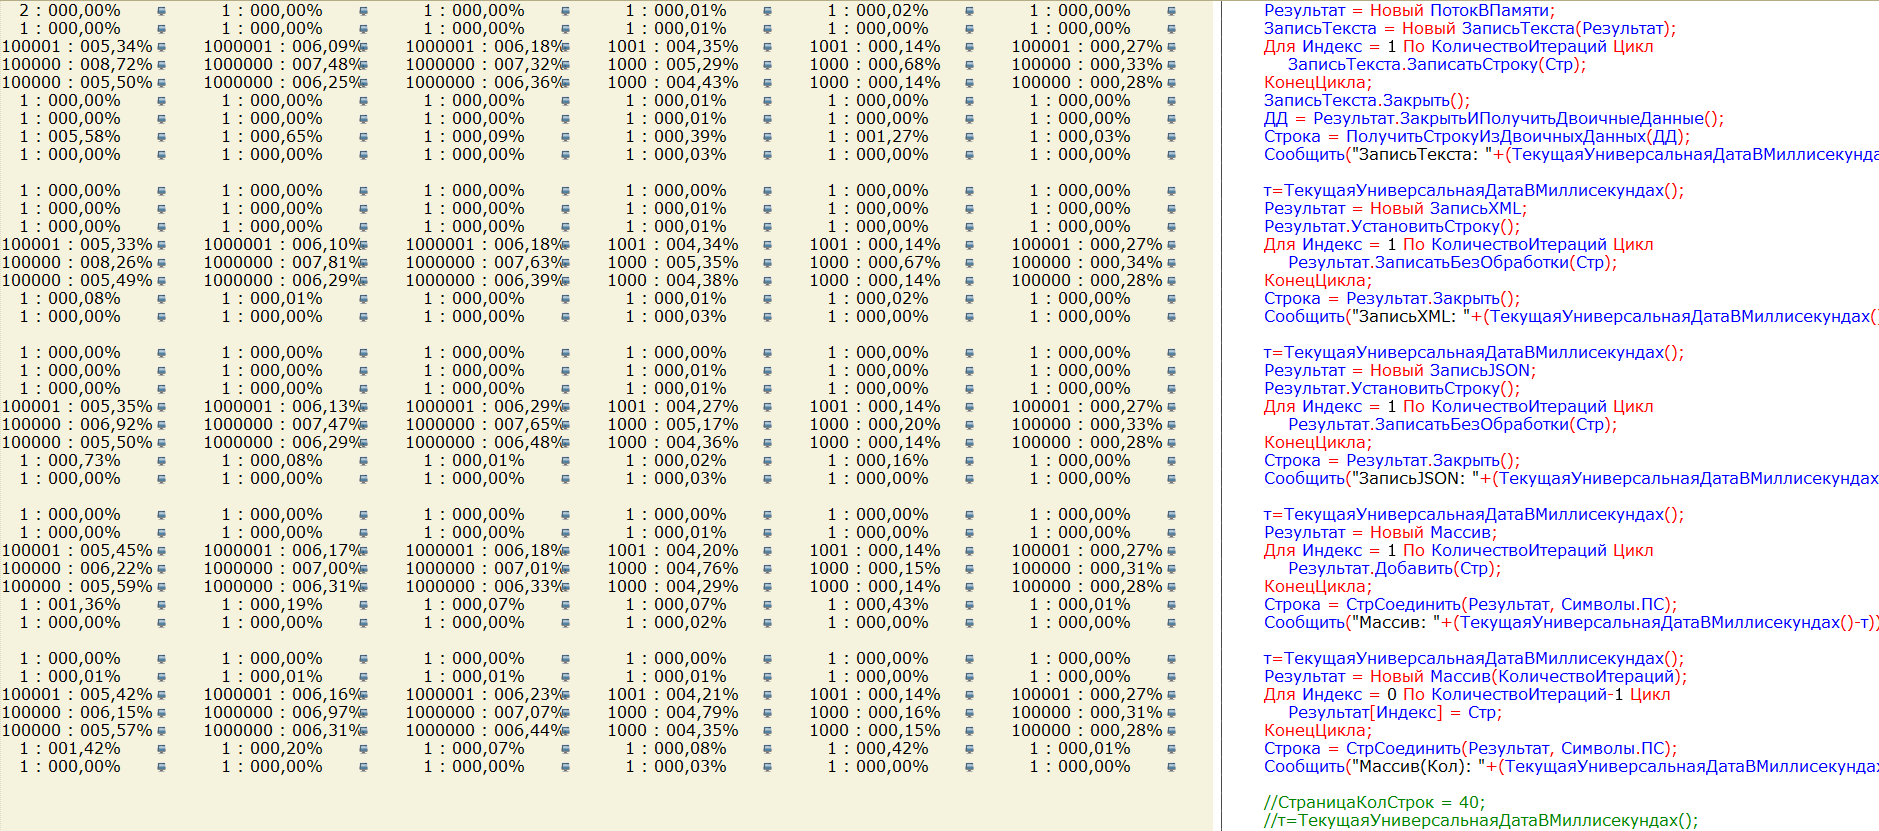
Про Capacity мое предположение почему выделение памяти заранее под Массив не ведет к тотальному увеличению скорости.
По поводу того, что ваши результаты не соответствуют моим, тоже есть. На разных машинах все может быть по разному. Общие тренды сохраняются плюс-минус, но позиции могут отличаться. Например, между компьютерами с процессорами Intel и AMD. Объемом ОЗУ и т.д. Все это в той или иной мере влияет на графики.
Насколько я знаю - ранее (в других алгоритмах работы с массивом) на Инфорстарт уже обсуждалось - что массивы проседают по производительности если их наполнять - без предварительного определения размера - а сейчас вижу обратную картину.
Само собой - у всех по-разному - время зависит от аппаратной составляющей - а вот соотношения - по идеи от нюанса паттерна конкатенируемой строки (у меня везде фиксированная строка - разной длинны) и вероятно особенностей того или иного релиза платформы (интересно влияет ли режим совместимости - по идеи не должен, а вот версия платформы, под которой фактически всё запущено - должна влиять, как и режим упр или не упр приложения).
Суть основновнога вывода в том - что все способы оптимизации примерно одинаково производительны и общие накладные расходы в них берут верх - так что можно брать любой - и использовать, когда число строк в итерациях цикла будет явно больше 100 а то и больше 1000 (включая все циклы верхнего уровня - если они есть) - иначе можно не заморачиваться - оригинальная прямая конкатенация строка будет не особо проседать по производительности!
Забыл упомнить, что тестировал на релизе 8.3.19.1264 64Bit (на клиенте: Core i3 3.5Ghz 16Gb RAM; на сервере по сути ничего не меняется - но у меня тут виртуализация и невозможен чистый эксперимент серверного выполнения), но в 1С Бухгалтерия 3.0 в режиме совместимости конфигурации Версия 8.3.14 в управляемом режиме во внешней обработке). Надо бы ещё другие релизы попробовать - у меня есть 8.3.20.1674 (и конфа для него без установленной совместимости) - но что-то сегодня запускаться не стал (хотя до НГ 100% работал) - позже буду разбираться. Ну и меньшие релизы платформы надо глянуть (именно фактические, а не по режиму совместимости)!
Поэтому итоговую строку (итоговый результат) удобно получать через СтрСоединить(Книга, Символы.ПС)...
Пока что все на уровне интуиции...
Наверное мы о разных вещах - алгоритм не может влиять на то, какие строки ему поручают конкатенировать! Сами строки могут быть результатом работы других алгоритмов, и скажем, быть либо кусками запроса, либо кусками XML/JSON/HTML документов, или ещё чем....
И в этом закавыка для Вашего подхода - он очень чувствителен к размеру этих строк - меняется оптимум количества этих строк на одной странице от их размера!
представим реальную задачу - у нас список из qr-кодов товаров легкой промышленности, около 30 000 марок.
какой алгоритм отработает быстрее?
ваш:
 т=ТекущаяУниверсальнаяДатаВМиллисекундах();
    Результат = Новый Массив(КоличествоИтераций);
    Для Индекс = 0 По КоличествоИтераций-1 Цикл
        Результат[Индекс] = Стр;
    КонецЦикла;
    Строка = СтрСоединить(Результат, Символы.ПС);
    Сообщить("Массив(Кол): "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));
и мой:
Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();
	КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);
	Книга = Новый Массив(КолСтраниц);
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + Марка130символов + Символы.ПС;
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

	Результат = СтрСоединить(Книга, Символы.ПС);

	Стоп = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Сообщить(Стоп - Старт);
Показатьзададим 60 строк на страницу - возьму с неба - не знаю оптимума
сравниваем только эти два алгоритма работы со строками и массивами.
До использования джейсона или xml-записи я бы не додумался....Поэтому пока сравниваем алгоритмы работы со строками...
Но допустим. Я возьму даже строки короче - 10 символов и от 1000 до 1миллиона строк
Более того - я решил добавить ещё несколько тестов ПЛАЦЕБО - "условно" пустые функции, которые не производят конкатенацию вовсе
&НаКлиентеНаСервереБезКонтекста
Функция Пустая(Строка, Стр) экспорт
	Строка = Строка;
КонецФункции

&НаКлиентеНаСервереБезКонтекста
Функция Пустая2(Знач Строка, Знач Стр) экспорт
	Строка = Строка;
КонецФункции
ПоказатьЕсли код из них вовсе убрать - будет примерно в 2 раза быстрее (причём все варианты плацебо примерно одинаково по скорости) - но для тестов решил оставить так - тупо просто присвоение значения переменной себе же - по сути 100% пустышка - максимум что тут должно происходить - копирования ссылки на строку в стек, а потом обратно в ячейку памяти. А ну да - первая функция должна делать это дважды - так как аргументы передаются по в стек ссылке, и нужно их обратно отправить их значения в кучу!
По идеи - первая функция должна работать медленнее - так как ей нужно вернуть результат обратно в кучу!
Но суть не в этом, а в том - что тут нет конкатенации вовсе! Строка не растёт!
Но для эффекта - я передают не пустые строки - а уже заполненные предыдущим тестом - т.е. достаточно длинные!
Так же использую два контекста вызова - текущий (модуль текущей формы) и внешний (модуль второй формы или модуль объекта для сервера - получаются отдельно в начале)
#ЕСЛИ Клиент ТОГДА
	Контекст = ПолучитьФорму("ВнешняяОбработка.КонкатенацияСтрок.Форма.ФормаДоп");
	#ИНАЧЕ
	Контекст = Объект;
	#КОНЕЦЕСЛИ
Итого 4 плацебных вызова функций вид "Пустая_1(Строка, Стр)" (с "_" вызывают внешний контекст, без - текущий).
Ваш алгоритм тоже включил в тест - тестирую страницы 40, 60, 100, 1000 - для наглядности зависимости от размера страниц
Кстати - в этом алгоритме есть ошибка вот тут "КолСтраниц = Цел(КоличествоИтераций/СтраницаКолСтрок);" - при неровном делении - количество страниц будет меньше на 1 - а далее заполнение ориентируется на это количество - в итоге конкатенируется меньше строк. Да и сам алгоритм с книгой, на практике, будет сложнее - ведь ему придётся подстраивать своё заполнение под внешний поток строк (внешний цикл) - вложенные циклы тут буду крайне не желательны - так как встройка такого алгоритма в продуктивную среду может оказаться весьма затруднительной! от того - накладные расходы алгоритма возрастают ещё больше!
Вот результаты (в мс): |
|---|
| 1Kx10
ЗаписьТекста: 32 ЗаписьXML: 31 ЗаписьJSON: 47 Пустая1: 109 Пустая2: 110 Пустая_1: 109 Пустая_2: 109 Массив(Кол): 31 Массив: 31 Массив страницы(40): 31 Массив страницы(60): 16 Массив страницы(100): 31 Массив страницы(1 000): 31 10Kx10 ЗаписьТекста: 297 ЗаписьXML: 297 ЗаписьJSON: 297 Пустая1: 656 Пустая2: 671 Пустая_1: 688 Пустая_2: 687 Массив: 297 Массив(Кол): 296 Массив страницы(40): 297 Массив страницы(60): 312 Массив страницы(100): 375 Массив страницы(1 000): 297 100Kx10 ЗаписьТекста: 2 991 ЗаписьXML: 3 015 ЗаписьJSON: 3 015 Пустая1: 6 530 Пустая2: 6 514 Пустая_1: 6 857 Пустая_2: 6 889 Массив: 2 922 Массив(Кол): 2 921 Массив страницы(40): 3 098 Массив страницы(60): 2 998 Массив страницы(100): 2 953 Массив страницы(1 000): 3 233 1Мx10 ЗаписьТекста: 29 806 ЗаписьXML: 30 845 ЗаписьJSON: 35 834 Пустая1: 85 629 Пустая2: 86 056 Пустая_1: 89 155 Пустая_2: 90 608 Массив: 29 605 Массив(Кол): 29 400 Массив страницы(40): 31 284 Массив страницы(60): 30 262 Массив страницы(100): 34 490 Массив страницы(1 000): 33 545 |
Тесты плацебо просто отжигают - конкатенации нет - а затраты времени на вызовы "условно" пустых функций колоссальные (при этом нагрузки на процессор почти нет)!
Что - в очередной раз показывает - что в данной задаче не важен метод решения (кроме прямой конкатенации) - всё упирается в общие накладные расходы платформенных инструкций цикла и внутренних вызовов - тогда имеет смысл выбирать тот алгоритм, который больше нравится и который удобнее вставить. Для 8.3 платформы я бы выбрал Массив + СтрСоединить() причём нет смысла даже массив заранее создавать заданного размера!
На у оптимальное универсальное число страниц видимо действительно 60 :-D
Но страничный метод всё-равно медленнее или как минимум не быстрее просто единого Массива - так что ещё раз подчёркиваю смысла заморачиваться со страничным методом нет! Это усложнение на пустом месте!
Прилагается скриншот распределения времени по плацебо-функциям в сравнении с распределением времени на алгоритм конкатенации через ЗаписьJSON.ЗаписатьБезОбработки(Стр)
Для 1000 и 100 000 строк по 10 символов
В % затраты времени только на вызов функции (без затрат на её пустую работу)
Ещё добавлю - что при большом количестве строк вызов от вызова затраты времени могут заметно гулять и на разные алгоритмы могут быть на разных местах по эффективности. Как уже сказал ранее - особенно это касается страничных вариантов - они самые нестабильные!

Эта граница для 64-битных процессов грубо находилась в районе 100 килобайт, а для 32-битных процессов 50 килобайт... если общая длина суммируемых строк короче, то скорость конкатенации значительно выше...
В 1С такой границы обнаружить не удается и в целом в 1С конкатенация строк превышающих границу отрабатывает примерно в те же 3-5 раз быстрее, чем в Net... правда, в Net есть StringBuilder, который просто вне конкуренции и работает в 100-200 раз быстрее, чем простая конкатенация...
При каком методе конкатенации? Прямым сложением?
Строки в .NET константные ссылки на область в памяти. Прямое сложение - это создание новой строки, путём копирования в новую область памяти складываемых частей. Если я правильно понимаю механизм CLR - то если такая итоговая строка уже есть в памяти - то копирования не происходит - и просто возвращается ссылка на новую строку (но это надо проверить, так как не совсем ясно как определяется наличие такой строки в памяти).
Чем больше строка - тем больше нужна область в памяти для хранения символов. А память обычно фрагментирована - то есть в ней попросту может не быть свободной области нужного размера - тогда запускается сборщик мусора по полному циклу сборки и реструктуризации памяти данного домена приложения (для .NET Framework, что там с .NET CORE и .NET 5 я не в курсах вовсе - там ведь нет домена приложения). Соответственно при следующей конкатенации - скорее всего придётся искать новую область ещё большего объёма (но последовательная сборка мусора будет уже идти куда быстрее и более предсказуемо - память то уже в целом упорядочена) - о того и падение скорости и сохранение линейного графика времени выполнения. Но 100 кб - это как-то уж очень мало - не такая уж большая область. Кстати - как мерились эти 100кб (по сути это где-то 50K символов в UTF16 - ведь так строки хранятся в .NET; + кроха памяти на пару внутренних полей объекта System.String)?
Вот это реально удивило. Этож насколько падает скорость в .NET - что её 1С так лихо начинает обходить там, где 1С сама уже безбожно тормозит! Это на .NET Framework 4.7? Может другие фреймворки попробовать (не только 4 версию но и 5 и 6, можно ещё и .NET CORE 3.1 попробовать - хоть он и устарел, но там могут быть свои особенности, до слияния в 5 версии с .NET Framework 4).
То что в 1С нет такой просадки - скорее большая удача или попросту иной планировщик памяти в платформе 1С: Предприятие 8 - что не приходится каждый раз под новую строку решать проблемы её размещения!
Всё-таки работу StringBuilder имеет смысл сравнивать с работой СтрСоединить() по массиву в 1С - принцип их работы очень схож (ну разве что у StringBuilder чуть помощнее API форматирования и некоторые общие сервисные функции).
Проблем с резким замедлением у StringBuilder нет - так как изначально строки хранятся в отдельных ячейках ссылок на разные области памяти, а когда доходит до сборки итоговой строки - он сразу знает какого объёма нужна область памяти - сразу её выделяет (если надо - один раз запускается сборщик мусора) и в один цикл копирует туда память из исходных областей. То же делает и СтрСоединить() в 1С.
Вот, если я бы проектировал управляемый ЯП - я бы при конкатенации строк не копировал бы их физически - а конкатенировал лишь список ссылок на фрагменты (в т.ч. на части фрагментов). Вот когда эти фрагменты требовалось бы изменить - это уже другое дело (но опять же - если изменяемый фрагмент входит только в одну строку - то его можно смело менять без копирования; или выделить в отельные фрагменты неизменяемую часть и изменённую - это уже решается в runtime - по фактическому анализу ситуации) - но для строк обычно это плохой дизайн (нужно использовать другие объекты, в т.ч. временно - для проведения массовых изменений) - строки обычно константы или списки констант. По сути - у меня бы строки были продвинутым StringBuilder.
Даже при выделении подстроки - это просто формирование новых границ фрагмента на ту же область памяти - поэтому эффективность была бы не только при конкатенации, но и при подстрочном разбиении строки.
Что-то типа Span коллекций в .NET (и, возможно, но вряд ли, БуферДвоичныхДанных в 1С 8.3)
да, это был эксперимент со String.Concate
Это касается только интернированных строк....
верно, я просто умножил на 2 длину строки после превышения которой скорость резко падала
Это на .NET Framework 4.8.. на других не пробовал... на других конечно могут быть свои особенности..
ну да, выходит, что в 1С хороший алгоритм используется... раньше 1С 8.2 была внутри на COM основана и там использовались строки BSTR, а сейчас не знаю...
только что сравнил... StringBuilder обгоняет 1С Массив+СтрСоединить примерно в 10 раз...
скорее всего из-за медленной работы самого цикла заполняющего массив...
да, идея отличная, особенно с учетом принципа неизменности строк... но почему-то разработчики Net так не сделали... можно наверное это сделать и в своём компиляторе, но это уже сложнее, т.к. придется делать особую аналитику, где обычные строки, а где модерновые, и когда надо одни превращать в другие, ведь язык IL знает только про обычные... у меня в Перфоленте пока только есть анализ обычной последовательной конкатенации и простейшие оптимизации основанные на количестве конкатенируемых строк..
Ооо... не знал - что для этого не литеральные строки явно надо интернировать - жаль... явно этого никто делать почти никогда не будет! А без этого теряется весь смысл их компактезации в памяти! И сохранение памяти, скажем, если я буду читать из
Кстати, как я понял - явное интернирование не убирает из памяти исходный дубль строки - и он будет её занимать (не имея ссылок на него) до очередной чистки мусора - что тоже не очень хорошо!
Не удержался - провёл свой эксперимент на C# и .NET Core 3.1
Хотел отследить моменты выполнения сборки мусора - но адаптированный пример с MSDN у меня не сработал. Но другим путём я, всё-таки, частично отследил моменты сборки мусора.
При посимвольной конкатенации 1М строки примерно происходит более 200K сборок мусора (после примерно 500 сборок новые конкатенированные строки создаются уже в куче поколения 2 - минуя 1 - видимо из-за больших размеров - как раз где-то около 50K символов). Переход на поколение 2 - это первое серьёзное замедление - прибавка одного символа занимает порой 27K тиков. У меня это произошло уже через 420 миллисекунд от начала теста.
Но замедления начинаются ещё до перехода на поколение 2. Первые просадка у меня возникают около 25K символов и потом было ещё несколько - но это разовые пики - скорее всего просто огрехи не чистого эксперимента, ну или при выделении памяти в этом момент были разовые сложности поиска свободного блока нужной длинны - хотя 50KB - это смехотворный блок.
В первом поколение среднее время добавления одного символа около 40тиков - но надо заметить - что оно растёт с ростом строки - оно и понятно - длинная строк - требуется больше время на её копирование при конкатенации.
Но и тут случаются пиковые периодические небольшие, но явно выраженные просадки до 3K до 10K тиков. Скорее всего - всё это связано с задержками выделения памяти. При этом, бывает и обратное - на создание новой конкатенированной строки длиной около 1.5K символов может потребоваться 1-3 тика - это ОООЧЕНЬ мало!
Мне кажется - CLR в .NET делает какую-то оптимизацию операции конкатенации строк - не всегда копируя исходную строку - а именно добавляя символ к концу массива байтов - причём заранее выделяя памяти побольше для таких операций - просадки - это как раз выделения новых блоков памяти!
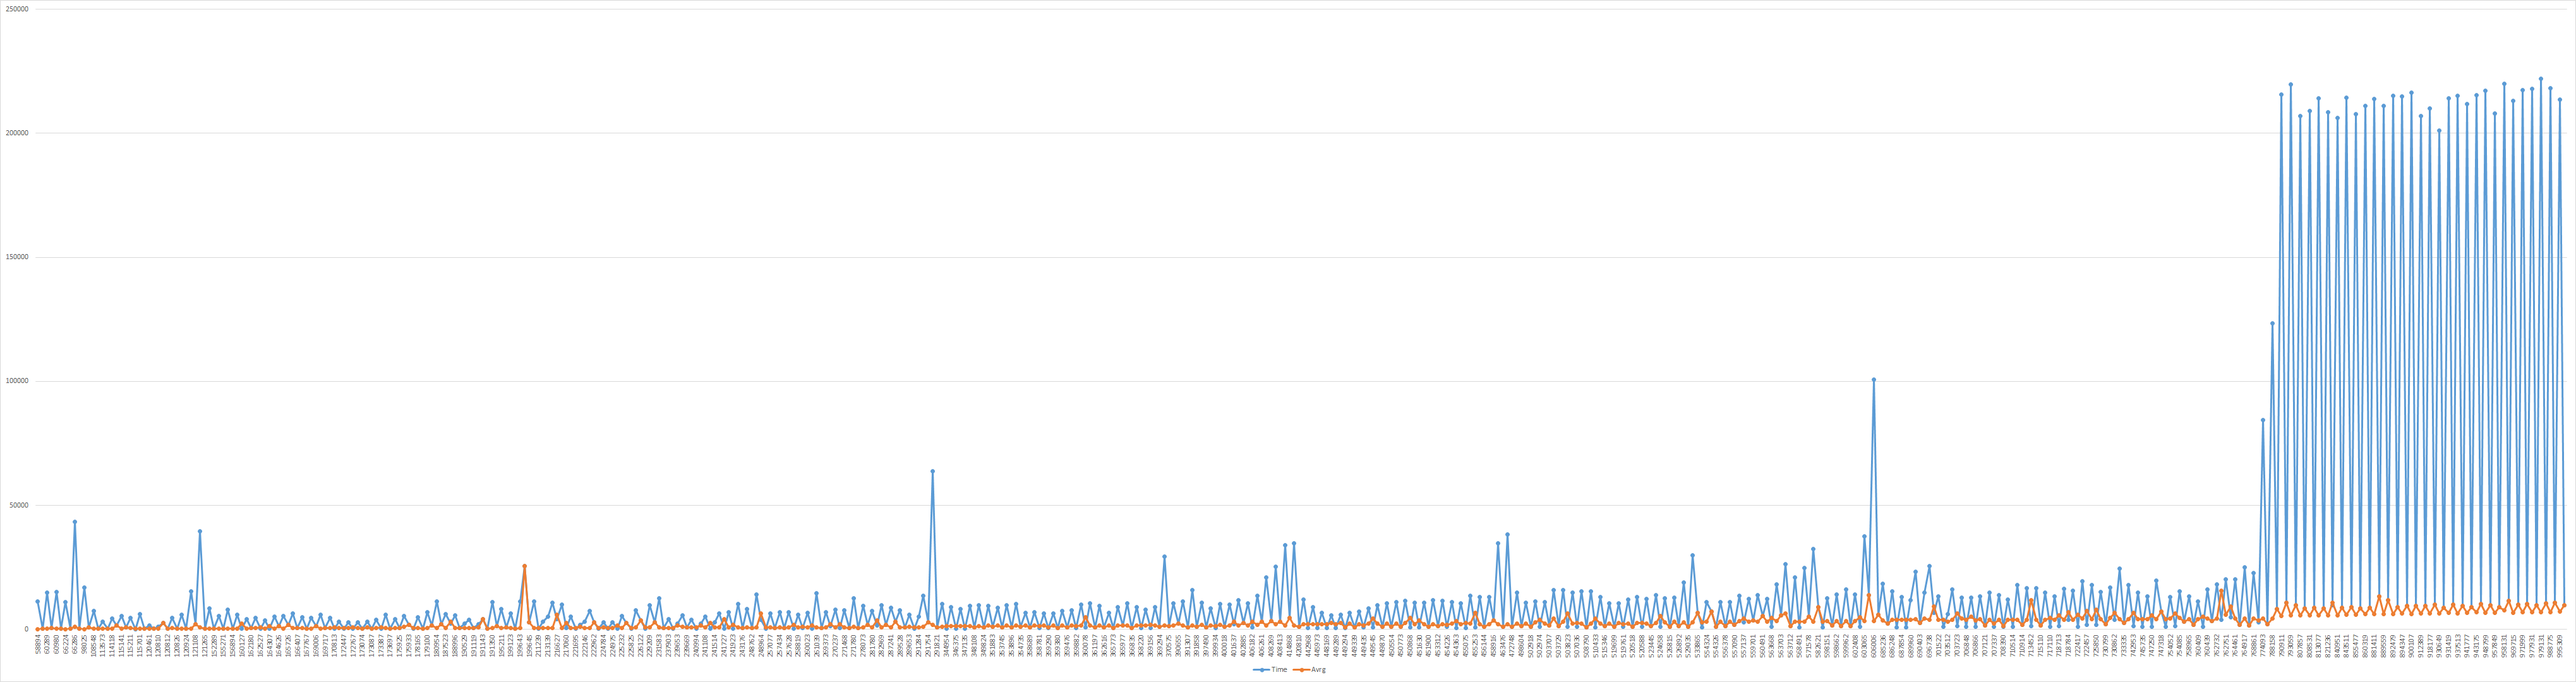
С переходом на поколение 2 ситуация в начале немного меняется - вырастает среднее время добавления символа - где-то до 400тиков - но по-прежнему есть большой разброс. И пиков становится куда больше (в среднем ещё не большие - около 3К-8К) - на графике (прилагается) явно виден забор (показаны большие приросты за которыми сразу же следуют большие падения). Но в целом среднее время добавления тоже начинает расти. Но главное - резко начинает расти количество сборок мусора во втором поколении (где их как раз должно быть мало по архитектуре построения второго поколения управляемо кучи). И пики начинают совпадать с этими моментами сборки мусора.
После 200K символов среднее время вырастает уже до 700тиков. А пики в среднем уже 5К-10К тиков.
Следующий прирост уже около 500K символов. В среднем около 4K тиков требуется на добавление символа. И пиковые задержки становятся более значимыми - около 15K-30K тиков - видом уже и в зоне 2-го поколения кучи начинаются проблемы с выделением памяти под блоки такого большого размера. На отметке 600K с небольшим символов был большой разовый выброс 100K тиков на добавление символа.
Но самое интересное случилось под конец - с отметки 780K символов начались большие выбросы времени конкатенации очередного символа к строке от 123K до 220K тиков. А среднее добавление символа стало около 8K.
Прохождение этого этапа заняло более 60% времени всего заполнения (и около 40% всех сборок мусора)
На лицо проблемы сборки мусора - видимо часто приходилось активно расширять зону памяти поколения 2 - и перемещать туда исходную зону.
Ещё один интересный график - это график корреляции среднего времени добавления символа к удельному приросту времени добавления символа в значимых точках такого прироста, в распределении по шкале количества сборок мусора (удельный прирост - это отношение пиковой единицы прироста к количеству сборок мусора в периоде, где был этот пиковый прирост - т.е. Средний прирост за одну сборку мусора - ведь не каждая сборка мусора образовывала увеличивающийся пик)
На этом графике, на мой взгляд, достаточно чётко видна зависимость пиков среднего времени добавления символа, от пикового удельного прироста времени при очистке мусора в поколении 2. По шкале капительного количества очисток мусора. Линейный рост среднего тут неизбежен из-за удлинения строки.
С 1С такой тест не сравнить - посимвольно 1С Предприятие 8 бы конкатенировало бы строку длиной в 1M более месяца! Но у меня на .NET весь тест занял около 4.5 минут (чистого времени - строго по замерам только операции конкатенации, с высокой точность). Поэтому я не могу сказать - что конкатенация в .NET на длинных строках проседает сильнее, чем на 1C. Ну, конечно, можно попробовать большими порциями конкатенировать строку - и тогда уже сравнить с 1С

не знаю, может я не правильно Вас понял про 1М, но вот такой код 1С на моём ноутбуке выполнила за 291 секунду, т.е. чуть больше 4-х минут...
Строка = "";
т=ТекущаяУниверсальнаяДатаВМиллисекундах();
Для Индекс = 1 По 1000000 Цикл
    Строка = Строка+"Ф";
КонецЦикла;
Сообщить(ТекущаяУниверсальнаяДатаВМиллисекундах()-т);
в то же время Net 4.8 потратил 345 секунд, т.е. почти 6 минут...
Надо учесть, что пустой цикл в 1М итераций на 1С выполняется в среднем 500 мс, а на Net от 0 мс до 7 мс (раз на раз не приходится, да и точность ТекущаяУниверсальнаяДатаВМиллисекундах меньше 15 мс не гарантирована)...
марку нашел в инете на ИС, использовал ее 129 символов: Стр = "010290000024799421tw:C:VWHj*_FeØ918029Ø92mSgFXJhvOUzoXp9S1TpKlUqt5526jYj+haVvxTfSznl0cE6JBXTxBBls+d
ну что ж - и правда мудрить с дополнительными блоками в виде страниц книг - оказалось неоправданно
Результат = Новый Массив(КоличествоИтераций);
Для Индекс = 0 По КоличествоИтераций-1 Цикл
Результат[Индекс] = Стр;
КонецЦикла;
Строка = СтрСоединить(Результат, Символы.ПС);
Сообщить("Массив(Кол): "+(ТекущаяУниверсальнаяДатаВМиллисекундах()-т));
сравните только два алгоритма: вот этот ваш в цитате
и второй мой :
Старт = ТекущаяУниверсальнаяДатаВМиллисекундах();

	Книга = Новый Массив(КолСтраниц);
	Для Индекс1 = 0 По КолСтраниц-1 Цикл

		Страница = "";
		Для Индекс2 = 1 По СтраницаКолСтрок Цикл
			Страница = Страница + "Это тестовая строка " + Строка(Индекс1*СтраницаКолСтрок + Индекс2) + Символы.ПС;
		КонецЦикла;

		Книга.Добавить(Страница);
	КонецЦикла;

Результат = СтрСоединить(Книга, Символы.ПС); Показатьдля данных - любая книга всегда содержит такое кол-во строк на странице, чтобы можно было комфортно держать ее в руке и читать - то есть 40-50-60 строк на страницу... Не нужно 100 строк на страницу - в этом нет ничего научного, и все требует доказательств.... и все же книга как Война и мир содержит много страниц и мало строк на каждой странице - это нормально - это вписывается в мою концепцию....
Я бы конечно не придумал использовать для подобных задач ни xml, ни джейсон.... поскольку не вижу как внутри устроены эти объекты на уровне ООП (что инкапсулировано в их методах и свойствах)... Но я бы заморочился только на строках и оптимизации работы со строками - отсюда мой пристальный интерес к алгоритму обхода строк.... не более и не менее....
а так спасибо за ликбез вам и автору статьи - есть над чем подумать
Пусть такой тест можно считать искусственным - но он может показать более тонкие нюансы в производительности некоторых способов, идущих на меньших объёмах почти на равных (при этом из такого теста можно сразу выкинуть явных аутсайдеров - чтобы оптимизировать масштаб графика - кстати не плохо было бы подписать значения цифр на осях координат).
И да - как было сказано выше - не хватает и графика замера по расходу памяти (как и указание тех характеристик хардварной платформы, на которой производилось тестирование); так же, для полноты картины, как мне кажется, не хватает тестов на разных версиях платформах 1С Предприятие 8. В т.ч. как под Windows так и под Linux.
Неплохо было бы и сравнить графики нагрузки на процессор!
Ну и ещё можно было бы продемонстрировать корреляцию разных методов в зависимости от длины конкатенируемых строк - скажем размерами порций 100, 1К, 10К, 100K, 1000K (естественно не на 1Млрд строк, а не более чем 10K строк).
P.S.
Считаю, что можно было бы сделать и отдельный график для малого количества конкатенируемых строк (до 1000 включительно) - тоже выкинув явных аутсайдеров, чтобы оптимизировать масштаб графика. Где наглядно показать какие методы эффективнее на малых конкатенациях, пусть и эта эффективность в таких операциях и окажется незначительной.
Конечной, такие малые тесты хорошо бы зациклить хотя бы на 1000 (а лучше на 10K-100K) повторов - для достижения статистической точности на малых временных отрезках измерений!
Ведь чаще всего их как раз не так уж и много конкатенируется - зато наглядно будет видно - стоит ли заморачиваться с оптимизацией - и если заморачиваться - то какой способ лучше всего выбрать для универсального применения!
То что Массив наиболее рекомендуем - я уже писал. Но не во всех тестах он лидер - тут многое зависит от длинны конкатенируемых строк. Ну и как я написал ранее - по сути прикладная разница между всем алгоритмами ничтожна (кроме текстового документа) - поэтому можно выбирать любой - это не существенно!
Как бы мое ИМХО тут в том, что не нужно все это большое и требовательное к производительности тянуть в 1С. В 99% это какая-то отдельная задача, реализация которой на питоне/пыхе/даже С++ или ином чем будет занимать не сильно больше времени в части программирования, но сэкономит туеву хучу времени на последующей попытке заставить 1С делать это с приемлемой скоростью. Поэтому 1С-у 1С-ово, а Кесарю кесарево...
Да, безусловно - в других платформах и ЯП это будет быстрее - но на много ли? Для прикладных задач - где конкатенация строк не является ключевой частью алгоритма - будет ли в этом реальный смысл? Тем более - если, скажем, хотя бы данные изначально находятся в СУБД
Поэтому я и говорю, что любой алгоритм (кроме 3-х самых медленных) годится для любых прикладных задач.
И выше уже писал - что для большинства прикладных задач с конкатенацией строк менее 10000 сгодится и обычная конкатенация. А если основные затраты - это именно операция конкатенации - но строк не более 1000 (и средней длинны не более 1000) то и тут нет смысла оптимизироваться вообще - оно и так будет весьма быстро!
И вряд ли передача данных в макет компановки будет работать быстрее, чем СтрСоединить... Но это надо бы протестировать.
Для чистоты эксперимента, если будет время, попробую проверить позже.
Результат = "";
Шаблон = "%1 %2";
Для Индекс = 1 По КоличествоИтераций Цикл
        ТекстСтроки = СтрШаблон("%1%2%3", "Это тестовая строка " , Индекс, Символы.ПС);
	Результат = СтрШаблон(Шаблон, Результат, ТекстСтроки);
КонецЦикла;
ПоказатьА вообще самый быстрый способ по-идее должен быть вместе с СтрШаблон и СтрСоединить:
Строки = Новый Массив;
Для Индекс = 1 По КоличествоИтераций Цикл
        ТекстСтроки = СтрШаблон("%1%2", "Это тестовая строка " , Индекс);
         Строки.Добавить(ТекстСтроки);
КонецЦикла;
Результат = СтрСоединить(Строки, Символы.ПС);
ПоказатьВы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 1577532
Создание 02.01.22 18:30
Обновление 02.01.22 18:30
Просмотры 16032
Загрузки 3
Рейтинг
48
Комментарии 76
Код открыт Да
Рубрики Механизмы платформы 1С
Кому Разработчик
Тип файла Внешняя обработка (ert,epf)
Платформа 1С:Предприятие 8
Конфигурация 1C:Бухгалтерия
Операционная система Не имеет значения
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Абонемент ($m)