Конфликт между заказчиком и разработкой
Очень часто в своей деятельности я вижу конфликт между бизнес-заказчиком и отделом разработки. Причем отдел разработки для заказчика зачастую является черным ящиком, и заказчик мечет гром и молнии, обвиняя этот отдел разработки во всех возможных грехах. Он говорит, что вы все делаете плохо, что вы ничего не успеваете, что у вас ничего не понятно, что вы вообще непредсказуемые, и так далее. В ответ заказчику из сферы разработки обычно летит, что вы сами ничего не понимаете, что вы не правы, и так далее. В результате возникает борьба, которую я наблюдаю почти в каждой второй компании, с которой работаю по долгу службы.
В таких ситуациях, когда меня приглашают, самый главный вопрос – где правда и кто прав? С одной стороны есть мнение заказчика, с другой стороны есть мнение отдела разработки. И, возможно, оба правы с точки зрения своих мнений. Но чтобы понять, где именно лежит эта правда, необходимо провести расследование. И мы с вами это расследование проведем.
Расследование Шерлока Холмса
Кто у нас считается самыми лучшими сыщиками на постсоветском пространстве? Шерлок Холмс и доктор Ватсон.
Представьте себе вечер на Бейкер-стрит. Ватсон косится на скучающего Холмса. Холмс, как всегда по привычке, нюхнув кокса, стреляет в стену и занимается ерундой. Ватсона, возможно, интересует, скучает Холмс или нет, но ответ очевиден.
В этот момент приходит миссис Хатсон и говорит: «Мистер Холмс, к вам разъяренный бизнес-заказчик». Шерлок Холмс сразу преображается и говорит: «Интересное дело, давайте разберемся».
Появляется тот самый разъяренный бизнес-заказчик, он держит в руках какую-то бумажку и вопит на всю Ивановскую, отвечая на недоуменный взгляд Шерлока Холмса. Он кричит: «Эти айтишники совсем (слово можете поставить сами)… Они все факапят, мне постоянно приходится нести финансовые потери, это очень дорого». При этом мой CTO говорит, что я прав. У нас постоянный конфликт, и я, как заказчик, вообще не понимаю, что происходит».
Холмс спрашивает, что за бумажка у него в руках. Заказчик отвечает, что это список факапов в работе IT, который он записал за последние полгода. Он предлагает посмотреть вместе, и вот что там написано:
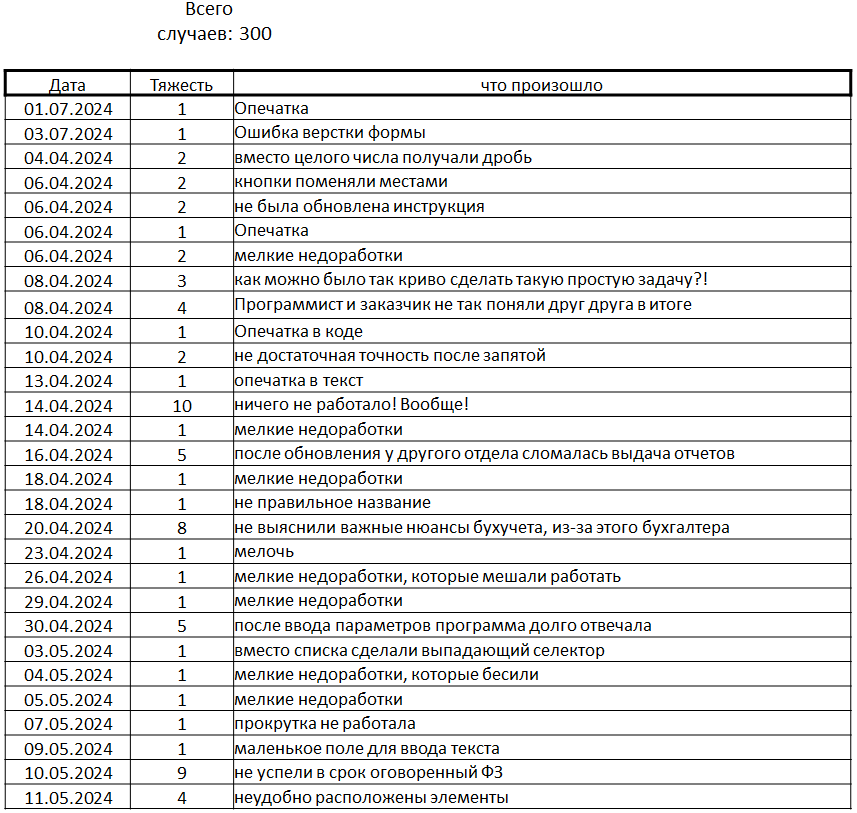
Заказчик даже проставил веса, то есть степень критичности для бизнеса от разных факапов, указал даты и причины. Он говорит: «Вот список доказательств. Видите, как все ужасно!».
Противоречие в интерпретации данных
Холмс спрашивает: «Если у вас есть такой список доказательств, что вам еще нужно? Увольте всех и замените на других». Но заказчик отвечает, что, с одной стороны, у него есть доказательства, а с другой стороны, когда он приходит к своему CTO и говорит: «Вот доказательства, здесь явно видно, что твои ребята плохо работают», тот отвечает: «Вы неправильно интерпретируете данные».
Это частая проблема, когда у нас есть данные, но их интерпретация с разных точек зрения выглядит совершенно по-разному. Заказчик говорит, что он постоянно тушит пожары, не понимает, что происходит, и поэтому просит помочь расследовать это дело, потому что оно сложное и неочевидное. И получается, что даже при наличии данных не до конца непонятно, кто прав.
Заказчик уходит, оставляя Холмсу и Ватсону две бумажки: список и диаграмму.
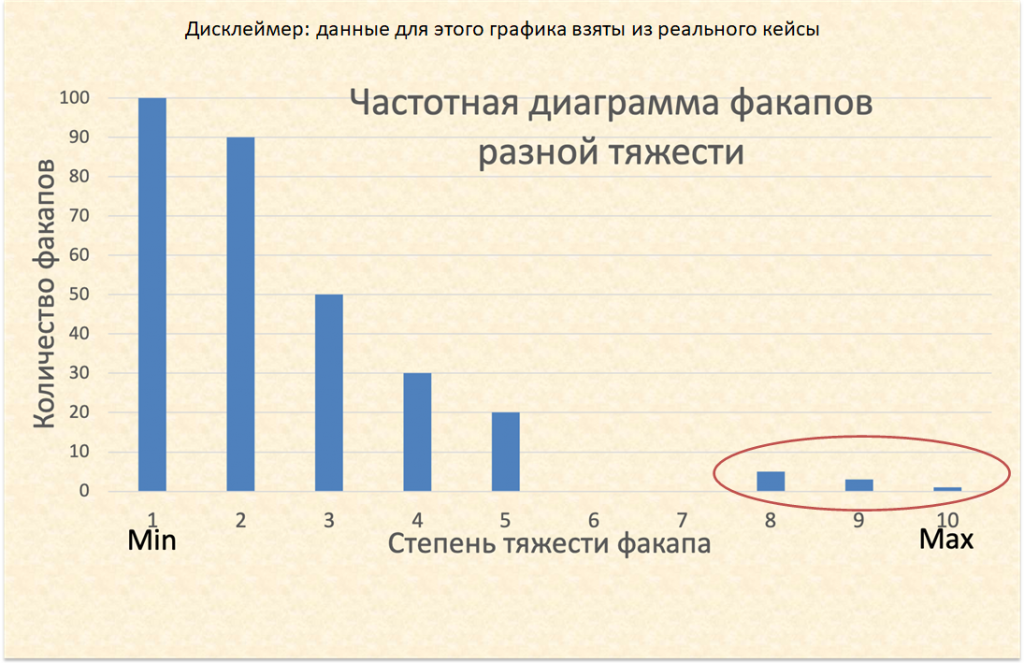
На основе этого списка факапов и их тяжестью, можно выстроить частотную диаграмму тяжести факапов. В начале – минимальные по тяжести факапы с оценкой по горизонтальной шкале 1,2,3, которые не сильно влияют на бизнес. Значения тяжести 8, 9, 10 – это уже заметные для бизнеса факапы, которые игнорировать не получится.
Финансовая травма и когнитивное искажение
С первого взгляда можно подумать, что инцидентов, достойных внимания, то есть тех, которые находятся в хвосте диаграммы, с оценкой 8,9,10, довольно мало. И непонятно, о чем вообще волнуется заказчик. Их мизерное количество – с кем не случается? Но если посмотреть на ситуацию с другого ракурса – с точки зрения денежных потерь для бизнеса – картина выглядит совсем иначе.
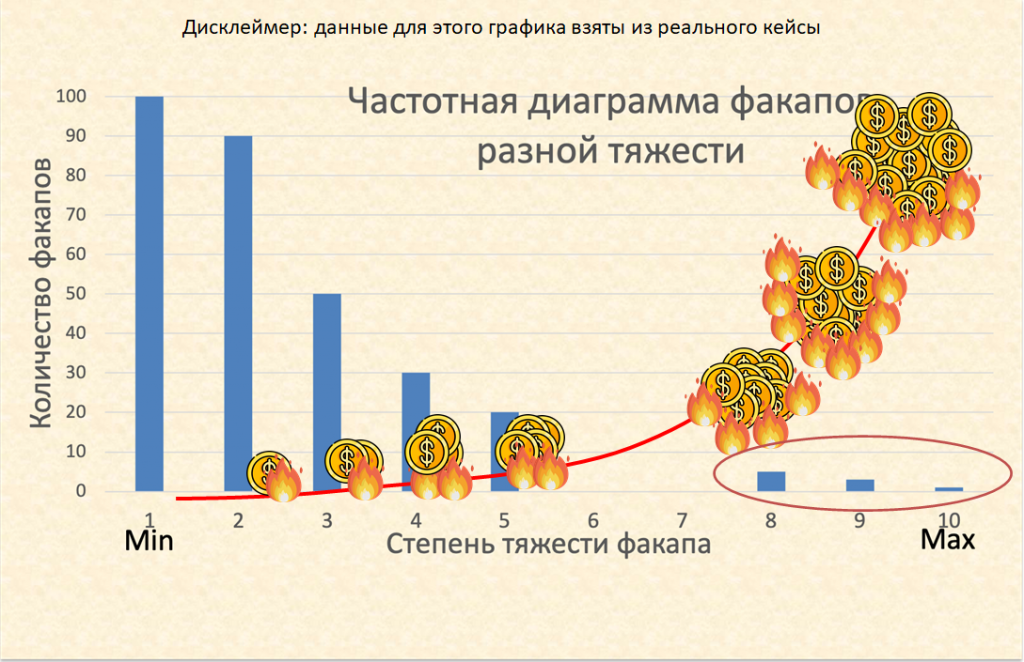
Знакомая ситуация? Редкие инциденты приносят огромные потери. Такое хотя бы раз происходило у каждого. Такой значительный вред заказчик будет помнить. Они закрепятся в памяти, и он будет вспоминать их до конца жизни. Именно на этом он и строит свои предположения о том, что это за люди и насколько хорошо они работают.
Таким образом формируется когнитивное искажение, основанное на финансовой травме. И с этим невозможно спорить.
Математический анализ вероятности инцидентов
Несмотря на то, что эти инциденты кажутся редкими, давайте посмотрим на ситуацию с другой точки зрения. Можно посчитать вероятность того, что факапы тяжестью 8 и 10 произойдут.
Как считается вероятность? Существует простая формула. Если вы когда-то изучали теорию вероятности, она будет для вас очевидна.
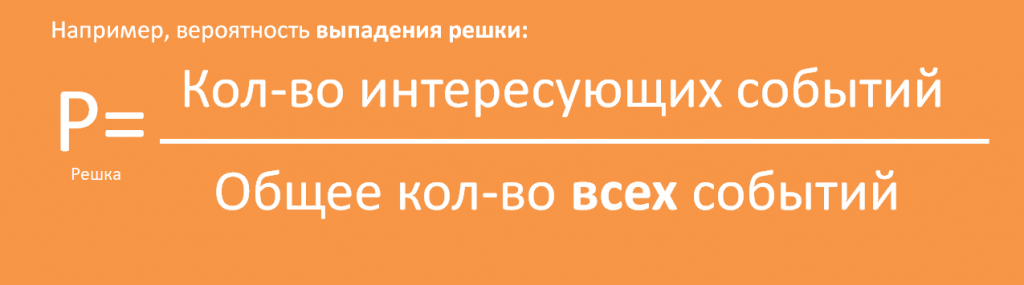
В знаменателе указывается общее количество наблюдаемых случаев. В числителе – количество случаев, которые нас интересуют. Делим одно на другое и получаем вероятность.
Если мы считаем вероятность выпадения решки, то в знаменателе у нас количество всех бросков, а в числителе – количество выпадений решки. Теперь давайте посчитаем.
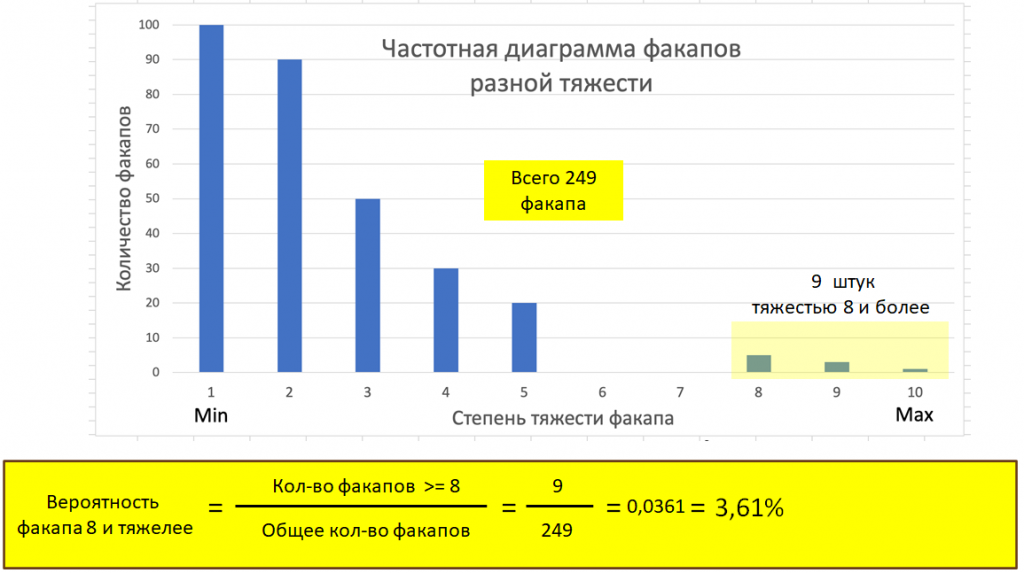
Общее количество факапов на этой диаграмме – 249. Факапов, которые нас интересуют, – 9. Девять, деленное на 249, дает нам 3,6%.
3,6% – это много или мало?
Давайте посмотрим на это с другой стороны. Если вероятность факапа в каждой задаче составляет 3,6%, стоит посмотреть на обратную вероятность – вероятность отсутствия факапа, когда все проходит хорошо. Она составляет 96%. Мы просто вычитаем 3,6 из 100 и получаем 96%.
Возникает ощущение, что беспокоиться не о чем. Вероятность 96% означает, что любая задача при релизе, при поставке и так далее пройдет успешно.
Кумулятивный эффект инцидентов
Теперь давайте смоделируем ситуацию в реальности – не для одной задачи, а для реального процесса.
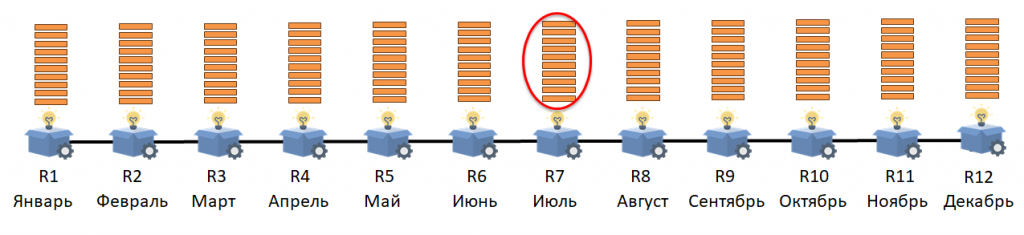
В реальности у нас есть определенная частота релизов. Например, один релиз в месяц, то есть 12 релизов в год. Обычно мы выкладываем не одну задачу, а некоторый объем изменений – то есть несколько задач каждый релиз. Предположим, что в каждом релизе выкладывается примерно 10 задач.
Теперь следите за логикой. Вероятность отсутствия факапа в каждой задаче составляет 96%. Вопрос: какова вероятность того, что релиз пройдет безболезненно и ни одна задача не приведет к факапу?
Это можно посчитать. Вероятности независимых событий перемножаются: P=0,96*0,96*0,96…(и так 10 раз)= 0,66 = 66%
У нас 10 задач в релизе. Вероятность отсутствия факапа в каждой – 96%. Значит, мы 10 раз умножаем 96% на самих себя и получаем значение 66%.
Таким образом, вероятность того, что релиз пройдет без факапов, составляет 66%.
Это хорошая вероятность или нет? Вы бы согласились на такую вероятность?
66% означает, что обратная вероятность – вероятность наличия факапа в каждом релизе из 10 задач – составляет 34%. То есть примерно в каждом третьем релизе возникает какой-то факап.
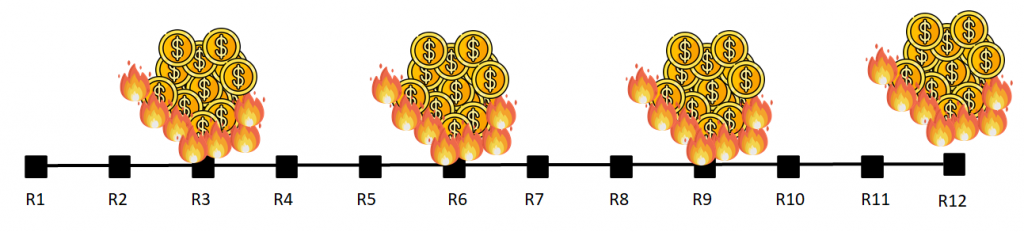
Если у нас 12 релизов в год, то в каждом третьем может срабатывать эта вероятность. С этой точки зрения становится понятно, откуда у заказчика возникает нервное состояние. Понятно, откуда появляется ощущение, что он постоянно тушит пожары. Каждый квартал происходит что-то, связанное с большими финансовыми потерями, и это запоминается.
В результате мы математически показываем, что, несмотря на ощущение редкости инцидентов, накопительно они дают значительный эффект.
Пока это остается предметом спора на уровне мнений между заказчиком и отделом разработки, ситуация не доказуема. Побеждает тот, у кого выше административный вес. Поэтому я всегда призываю и этой статьей иллюстрирую, что в случае спора стоит собрать данные и попробовать посчитать математически вероятность того или иного исхода.
Да, действительно, заказчик ощущает себя в состоянии постоянного пожара. Это классическая ситуация, знакомая любому менеджеру и многим бизнес-заказчикам. Но почему это происходит и как к этому приходят?
Давайте попробуем разобраться в механизме. Это моя версия, я на ней не настаиваю, но считаю, что она имеет право на существование.
Определение «пожара» через матрицу Эйзенхауэра
Сначала определим, что мы будем считать пожаром. Здесь нам поможет матрица Эйзенхауэра.
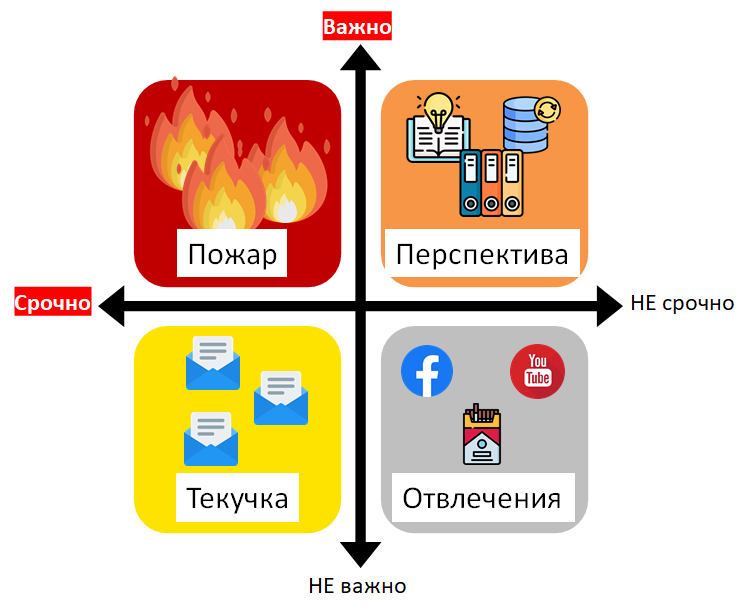
Не срочно и не важно – это отвлечения. Срочно и не важно – это текучка. Важно и не срочно – это задачи на перспективу, которым необходимо уделять внимание. А то, что внезапно становится и срочным, и важным, соответствует определению пожара.
Если ситуация дошла до этого состояния, значит, у нас действительно проблемы. Приходится срочно искать ресурсы, закрывать дыры и реагировать в авральном режиме. Именно это сочетание срочности и важности и является пожаром.
Механизм возникновения пожара
Исходя из моего опыта, обычно это происходит следующим образом:
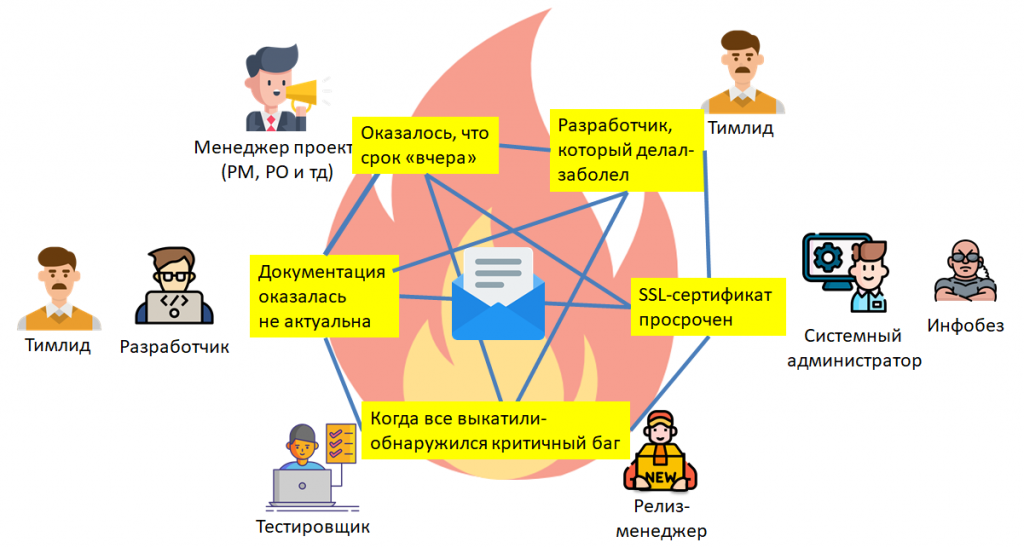
Есть письма. Письма с задачами, хотелками и прочим.
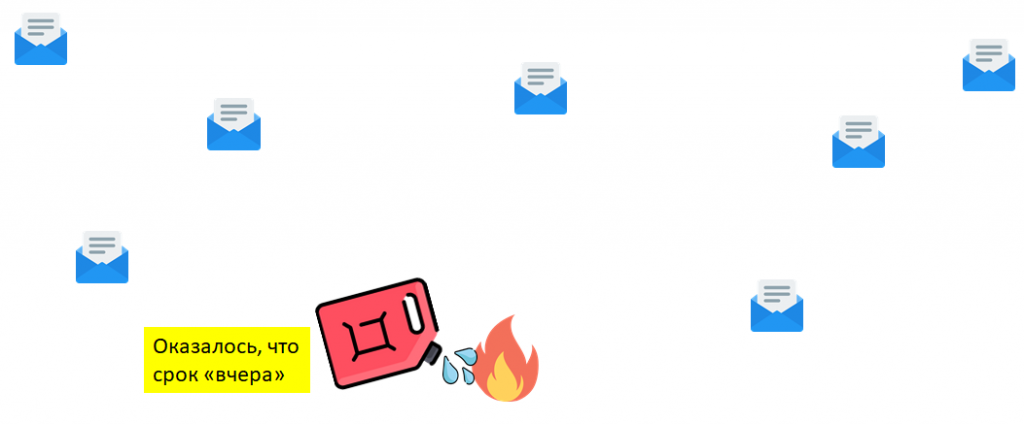
И вдруг среди этих писем появляется одно, в котором содержится неприятная новость: по какой-то задаче срок оказывается вчера.
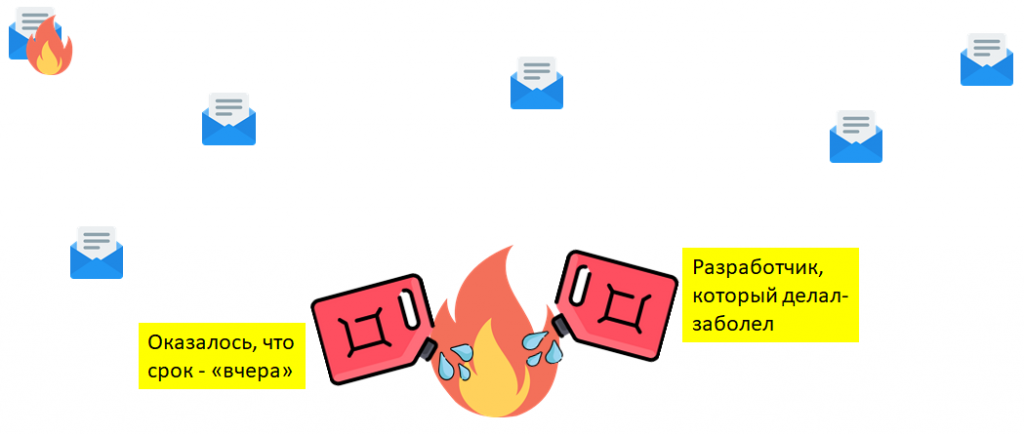
Начинают разбираться. Выясняется, что вмешивается еще один фактор – разработчик, который делал эту задачу, заболел.
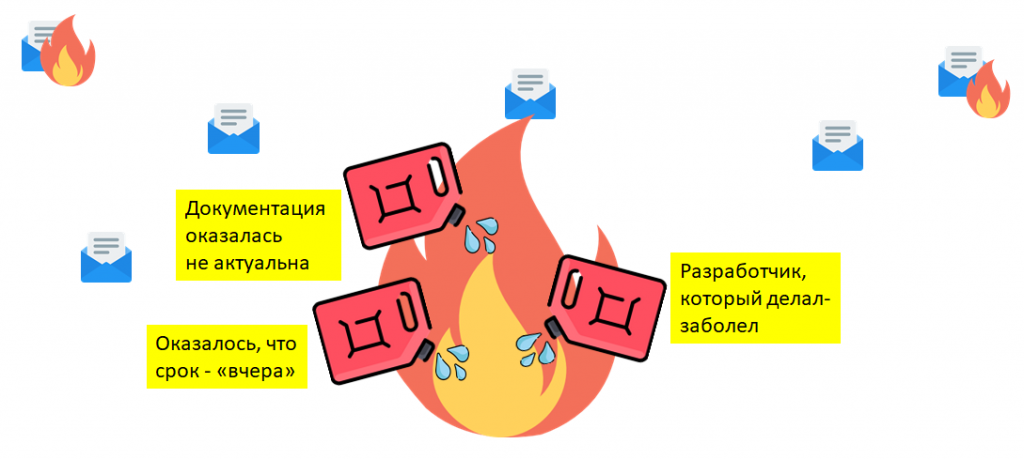
В этот момент огонек начинает разрастаться. Время начинает тратиться, отбираться у других задач. Сбоку тоже начинает постепенно разгораться пожар. Находят другого разработчика, который будет это исправлять. Оказывается, что документация неактуальна.
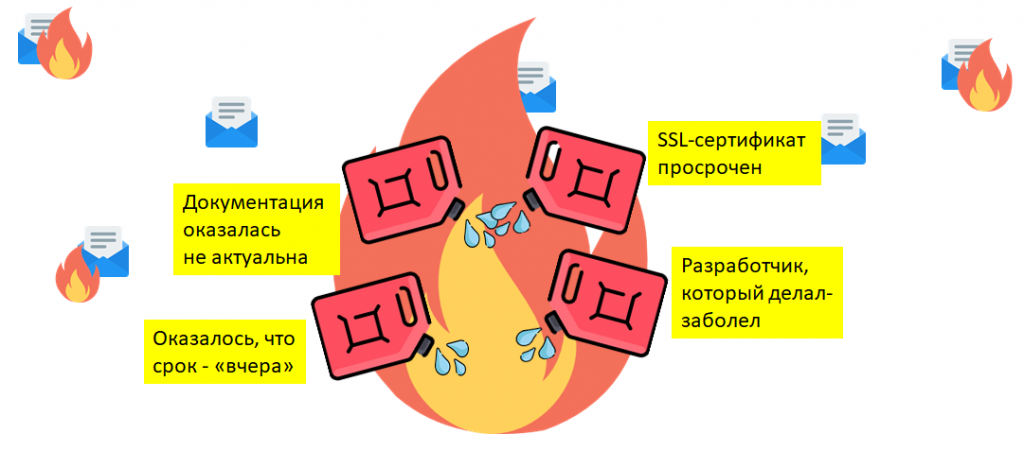
Тем не менее, каким-то образом работа продолжается, изменения выкладываются на прод. Затем выясняется, что какой-нибудь сертификат или лицензия просрочены.
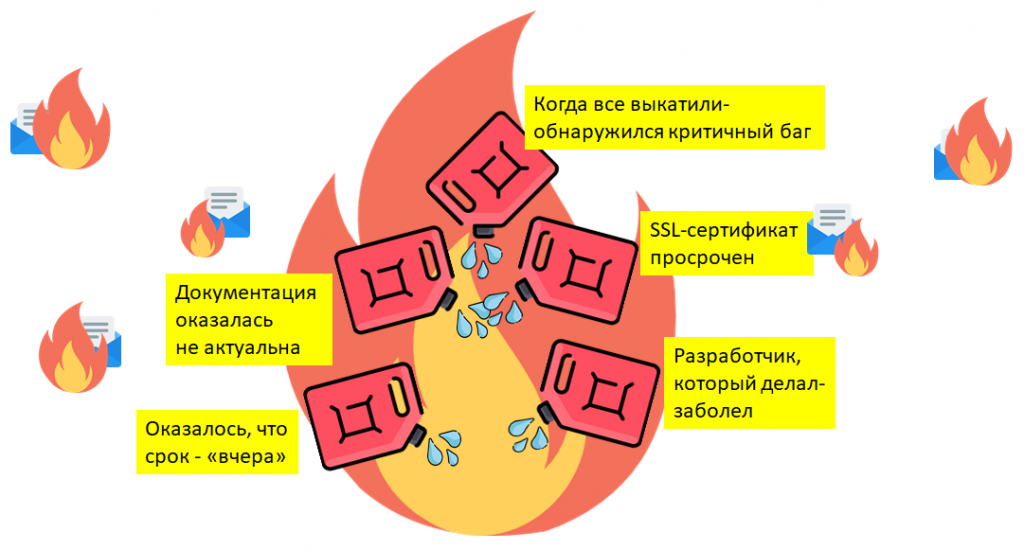
И наконец, когда все выкладывается на продакшен-сервер и отдается пользователю, обнаруживается критический баг.
Вот это и есть пожар. Горит не только корневая задача, с которой все началось, но и все остальные задачи начинают подгорать, потому что ресурсы все больше уходят на тушение этого пожара.
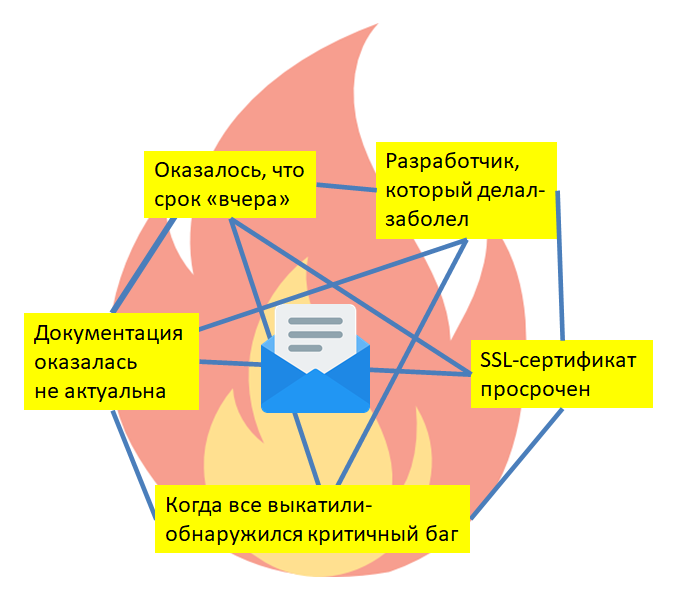
Если разобраться, в чем именно состоит механизм происходящего, становится видно, что здесь складывается комбинация факторов. По отдельности каждый из этих факторов не является критичным. Заболел разработчик – ничего страшного. Документация неактуальна – неприятно, но решаемо. Сроки прежние, дефекта нет, просто меняем одного разработчика на другого и продолжаем работу.
Но когда эти факторы начинают складываться вместе, возникает пожар. По сути, каждый из этих факторов по отдельности – это инцидент, а все вместе – это уже катастрофа.
Различие между инцидентом и катастрофой
Инцидент – это любой сбой в нормальном течении процесса, который мог привести к катастрофическим последствиям, но не привел. Он был близок к этому, но в этот раз ситуация удержалась.
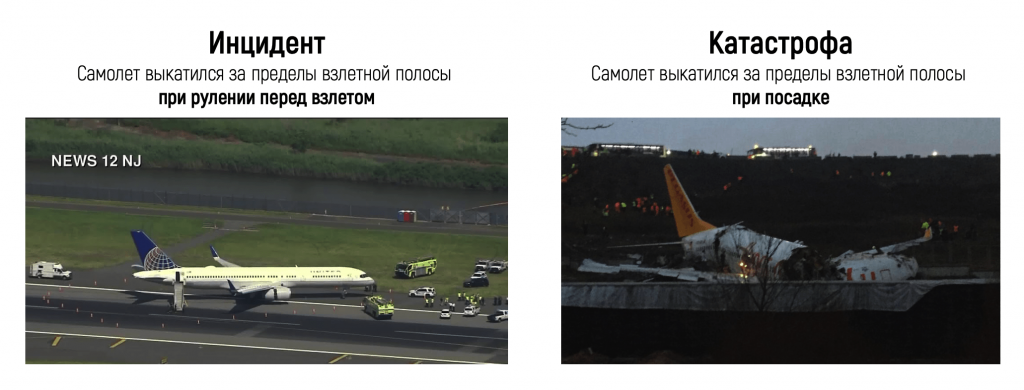
Пример инцидента: самолет выкатился за пределы взлетной полосы при взлете. Он еще не набрал высоту, не оторвался от земли. Это инцидент, но не катастрофа.
Другая ситуация: самолет выкатился за пределы взлетной полосы при посадке. Формально произошло то же самое – самолет выкатился за пределы полосы. Но обстоятельства другие. И это уже катастрофа. Скорее всего, к этому привел набор факторов, которые сложились вместе.
Получается, что для предотвращения катастроф необходимо работать с инцидентами. Мысль очевидная, но за многие годы я очень редко вижу, чтобы кто-то этим системно занимался, и чтобы это входило в чьи-то обязанности. Именно об этом хочется поговорить.
Подход к профилактике катастроф
Как выстроить рабочий процесс, который будет работать с инцидентами на упреждение и не доводить ситуацию до катастрофы? Этот процесс во многом похож на работу сыщиков.
Инциденты регистрируются, классифицируются, расследуются, выявляются корневые причины, и затем эти корневые причины устраняются. На словах все выглядит просто, но на практике этим почти никто не занимается.
Иногда я наблюдаю подобный подход в отделах поддержки, но это редкость, потому что саппорт обычно работает в таком авральном режиме, что у него просто нет возможности остановиться, поднять голову и проанализировать происходящее в долгосрочной перспективе.
Этапы root cause analysis
Регистрация инцидентов – это в основном механическая работа. А вот расследование требует отдельного внимания.
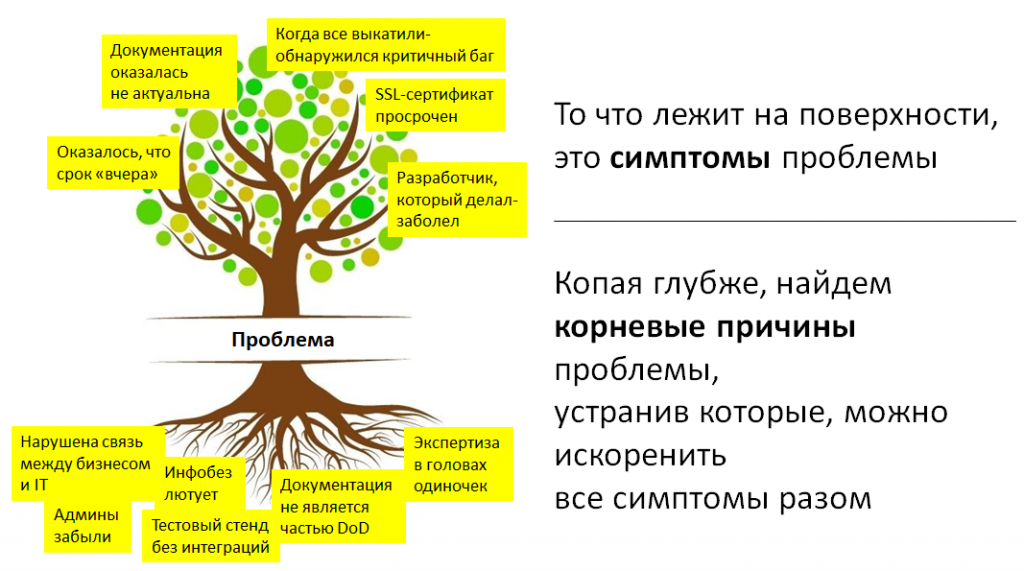
Существует понятие root cause analysis. Многие с ним знакомы. Идея проста: есть симптомы, веточки, лепесточки. Эти симптомы растут из корня. Иногда несколько веточек и лепесточков растут из одного корня. Если докопаться до этого корня, можно устранить целый куст проблем, целый набор инцидентов.
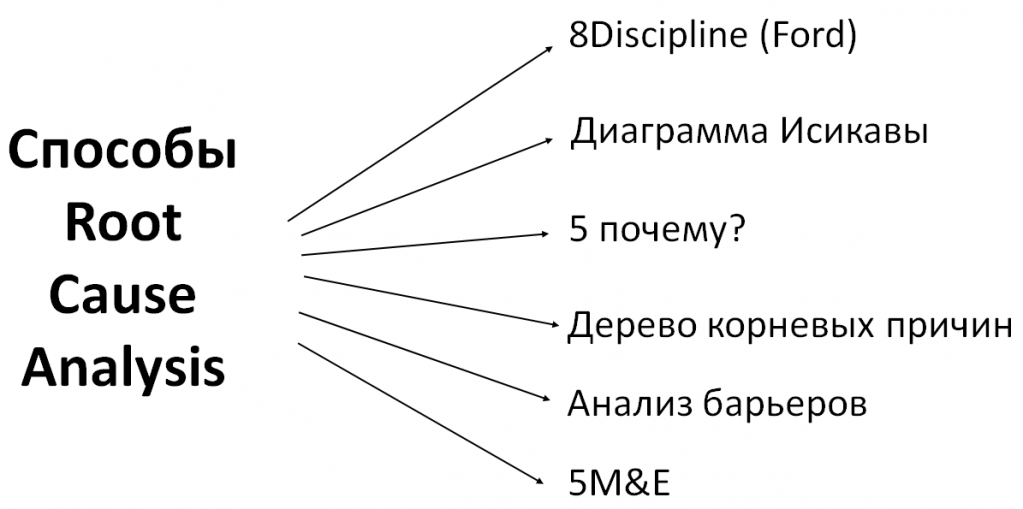
Инструментов root cause analysis существует достаточно много. Перечислены далеко не все. Их можно комбинировать, связывать между собой, переходить от одного к другому. Я расскажу обобщенный алгоритм, который доказал свою эффективность и которым мы пользуемся в своей компании.
Обобщенный алгоритм RCA
Шаг 1. Команда RCA
Первое, о чем стоит говорить – это ответственность. Есть известная фраза, приписываемая товарищу Сталину, о том, что у каждой проблемы есть имя и фамилия. Я не призываю вас буквально следовать его подходу, но сам принцип поиска первопричин полезен. Мы говорим о другом: нам необходимо понять, в чьей зоне ответственности было отследить, заметить и среагировать на инцидент.
В этом смысле я предлагаю смотреть на происходящее так, как об этом говорил Эдвард Деминг. Он утверждал, что 94% проблем возникают не потому, что люди плохие, некомпетентные или плохо работают, а потому что либо система управления выстроена так, что не позволять людям работать лучше, либо текущая система управления неэффективна и требует корректировки. Именно с этой точки зрения стоит рассматривать происходящее.
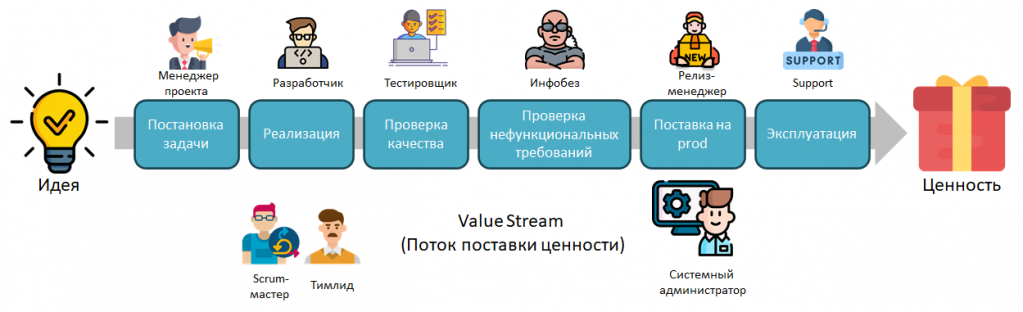
Зону ответственности можно определить. Начать стоит с простого. Любая задача, любая работа проходит определенный путь. Это можно назвать value stream, потоком поставки ценности. В этом потоке есть конкретные этапы: постановка задачи, ее формализация, реализация, проверка качества и так далее. До того, как задача попадет на production server, она проходит множество этапов.
Чтобы определить зону ответственности, полезно сначала визуализировать этот value stream, а затем понять, какая роль за какой участок этого потока отвечает. По сути, это и будет команда root cause анализа. Потому что, особенно когда речь идет о наборе инцидентов, крайне редко бывает так, что сбой произошел в одном месте. Обычно где-то что-то не заметили, где-то затормозили, где-то ждали согласования. В результате все это нарастает и в какой-то момент выстреливает.
Шаг 2. Восстанавливаем хронологию
Команда расследования инцидентов должна включать представителей каждой функции, которая присутствует в этом value stream. Не всех вообще, а отдельных представителей. При этом важно понимать, кто именно участвовал в процессе: имя, фамилию, должность. Это необходимо, чтобы понимать, какими возможностями человек обладал в момент инцидента. Возможно, это был стажер, у которого не было доступов, влияния и возможности что-либо изменить. Это важно учитывать.
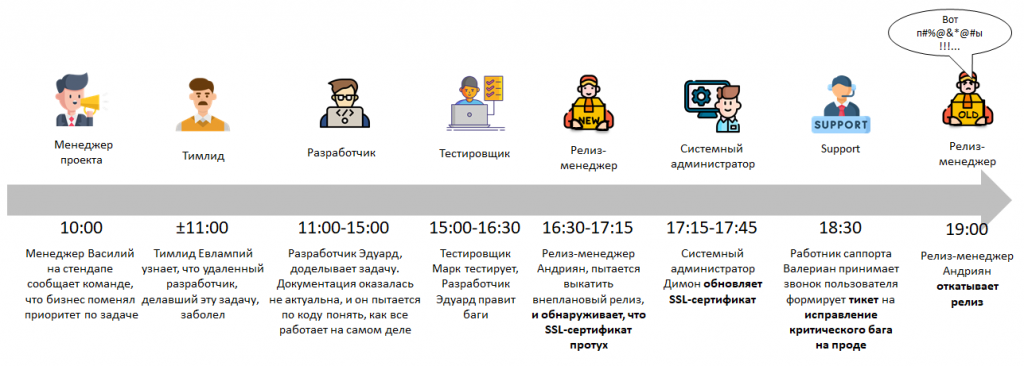
Допустим, мы расследуем инцидент. Утром менеджер обнаруживает, что срок поехал или он его не отследил. Затем тимлид узнает, что разработчик, который делал эту задачу, заболел. Начинают искать другого разработчика. Он пытается разобраться и выясняет, что документация неактуальна, но все же как-то справляется. Тестировщик выполняет свою работу, они обмениваются с разработчиком информацией.
До этого момента ситуацию еще можно было предотвратить. Но когда происходит релиз, последствия становятся практически неотвратимыми. Релиз-менеджер берет задачу и в момент деплоя выясняется, что какой-то сертификат или лицензия просрочены. Он ищет системного администратора, который может помочь. Совместными усилиями они выкладывают изменения на продакшен.
После этого в поддержку поступает звонок: у клиента критическая ошибка. Все происходит вечером, около семи часов. Релиз-менеджер, вспоминая все предыдущие этапы, произносит разные нехорошие слова, откатывает релиз, и так заканчивается его вечер.
Именно эту хронологию нам и нужно восстановить. Нужно понять, как это произошло. Это всегда сочетание факторов. Еще раз подчеркну: практически не бывает так, что проблема возникла в одном-единственном месте.
Повторюсь: важно понимать конкретные должности и опыт конкретных людей, которые участвовали в инциденте.
Шаг 3. Дерево причин
Далее мы собираем этих людей и фиксируем, что произошел такой факап.
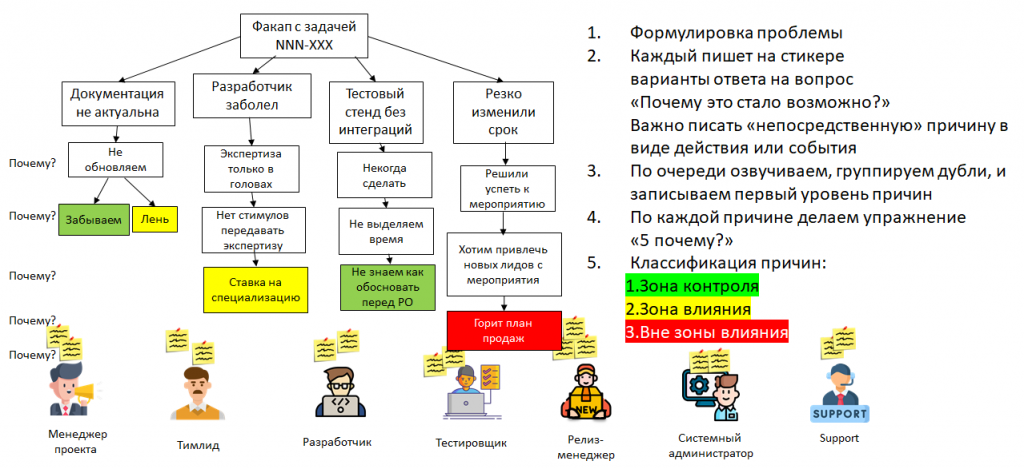
Обычно я делаю это в формате брейншторма. Все участники этого события предлагают свои версии того, что и почему пошло не так, и почему это вообще стало возможным.
Сначала мы просто накидываем идеи в режиме брейншторма. Затем группируем похожие причины и голосуем за те, которые кажутся наиболее обоснованными. После этого используем простой инструмент – метод «5 почему». Большинство с ним знакомо.
Рассмотрим пример. Тестовый стенд оказался без интеграции. Почему? Потому что не было времени сделать. Почему не было времени? Потому что время не выделяется: идет постоянная гонка за результатом, сроками и дедлайнами. Время на технический долг и инфраструктуру не закладывается. Почему не закладывается? Потому что неясно, как обосновать необходимость этого бизнес-заказчику и продакт-оунеру.
Вот до этой точки и нужно докопаться. Это и есть корневая причина.
Далее все выявленные корневые причины необходимо классифицировать. На часть из них мы можем напрямую повлиять – они находятся в зоне нашего контроля. Часть находится в зоне влияния: мы не можем решить их сами, но можем найти людей, которые помогут. А часть находится вне зоны контроля. Например, если горит план продаж, повлиять на это практически невозможно. Это ограничение, которое просто существует. Его нужно принимать так же, как погоду, и учиться жить с ним. Такой анализ должен стать регулярной практикой.
Шаг 4. Контрмеры
Дальше начинается чистая механика. Нужно определить, что с этим делать.
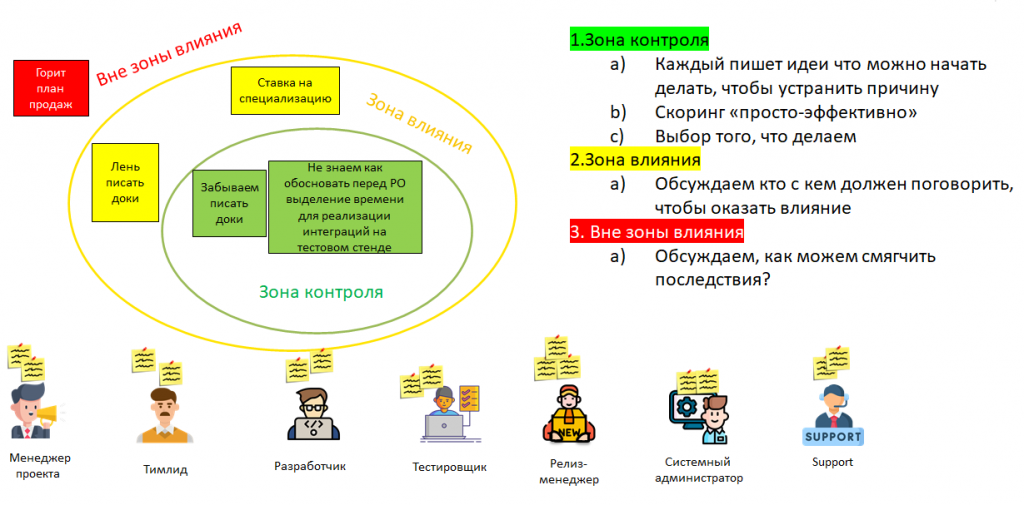
Если причина в зоне контроля, ее нужно запланировать и реализовать: поставить срок, назначить ответственного, включить в план следующего периода. Если причина в зоне влияния, необходимо определить, с кем нужно поговорить и кого убедить, чтобы ситуация изменилась. Если причина вне зоны контроля, остается только думать о том, как минимизировать негативные последствия и как с этим жить.
Опасности при внедрении практики анализа
В конце всегда появляется план действий и понимание того, как мы будем отслеживать изменения. Это уже чистая механика, подробно на этом останавливаться не буду, потому что это очевидно и любому менеджеру знакомо. Однако на этом пути неизбежно возникают опасности. С одной стороны, они понятны. С другой – неприятны.
Первая опасность заключается в том, что люди не будут регистрировать инциденты. Их просят это делать, но они не делают. Причина простая – отсутствует привычка. Эту привычку необходимо формировать.
Я бы предложил начать с определения круга инцидентов или зон инцидентов, которые подлежат обязательной регистрации. Это могут быть отказ в работе корневых функций, без которых невозможно работать, отказ в работе функций, которые приносят деньги, проблемы с функциями, связанными с взаимодействием пользователей: регистрация, авторизация и подобные вещи. Таких зон обычно немного – четыре или пять. Но регистрация инцидентов в этих зонах должна быть обязательной. И отсутствие такой регистрации должно караться.
Вторая проблема состоит в том, что люди не любят делать то, что сложно. Даже если они хотят, процесс вроде открытия Jira, создания тикета, выбора его типа, заполнения текста инцидента быстро надоедает. Обычно на третьем шаге все бросают.
Современные технологии позволяют упростить этот процесс. Можно написать Telegram-бота, который оформляет тикет автоматически. Если сделать процесс простым, инциденты начнут регистрировать.
Также необходимо продумать систему поощрений. Если человек сообщил об инциденте раньше других, особенно если это было в зоне его ответственности, его не нужно ругать. Его нужно поощрять. Он сообщил об инциденте до того, как тот стал катастрофой, и это заслуживает поощрения.
Следующая опасность – люди будут уклоняться от участия в команде RCA. Инцидент зафиксирован, но его еще нужно анализировать. Возникает вопрос, как мотивировать людей участвовать в этом процессе.
Самый очевидный вариант – дежурства. Никто не любит дежурства, но этот механизм работает. Анализ и брейншторм требуют значительных эмоциональных и интеллектуальных затрат. Поэтому возможен другой подход: выделять, например, полдня, когда команда не занимается операционной работой, а занимается только анализом инцидентов. В этом случае не возникает конкуренции между текущей работой и анализом.
Дополнительно можно использовать элементы мотивации: ачивки, грейды, звания вроде «лучший Шерлок Холмс месяца». Конкретные механики каждая команда может придумать сама.
Еще одна серьезная опасность заключается в том, что люди будут «забывать» делать корректирующие мероприятия. Забывать в том смысле, что они формально существуют, но к ним никто не возвращается.
Чтобы этого не произошло, решения должны быть максимально прозрачными. Не должно быть возможности сказать, что человек их не видел, не понял или не помнил. Например, можно использовать Kanban-доску и регулярные встречи не только по рабочим задачам, но и по задачам, которые были приняты по итогам анализа инцидентов.
Необходима петля обратной связи. Одного артефакта обычно недостаточно. Если просто повесить доску или стикеры, со временем они исчезают, а что с ними делать дальше, становится непонятно.
Самый неприятный сценарий – когда после всей проделанной работы симптомы не исчезают. Это означает, что была выявлена не та корневая причина, и анализ придется повторять заново. Такое действительно бывает.
Тем не менее, если эту практику применять регулярно, вероятность снижения количества инцидентов возрастает. Если этого не делать, система, как правило, начинает деградировать.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAMLEAD&CIO EVENT.
Вступайте в нашу телеграмм-группу Инфостарт