Когда внешняя компонента на C++ ускоряет 1С, а когда тормозит её
Разработка - Разработка внешних компонент

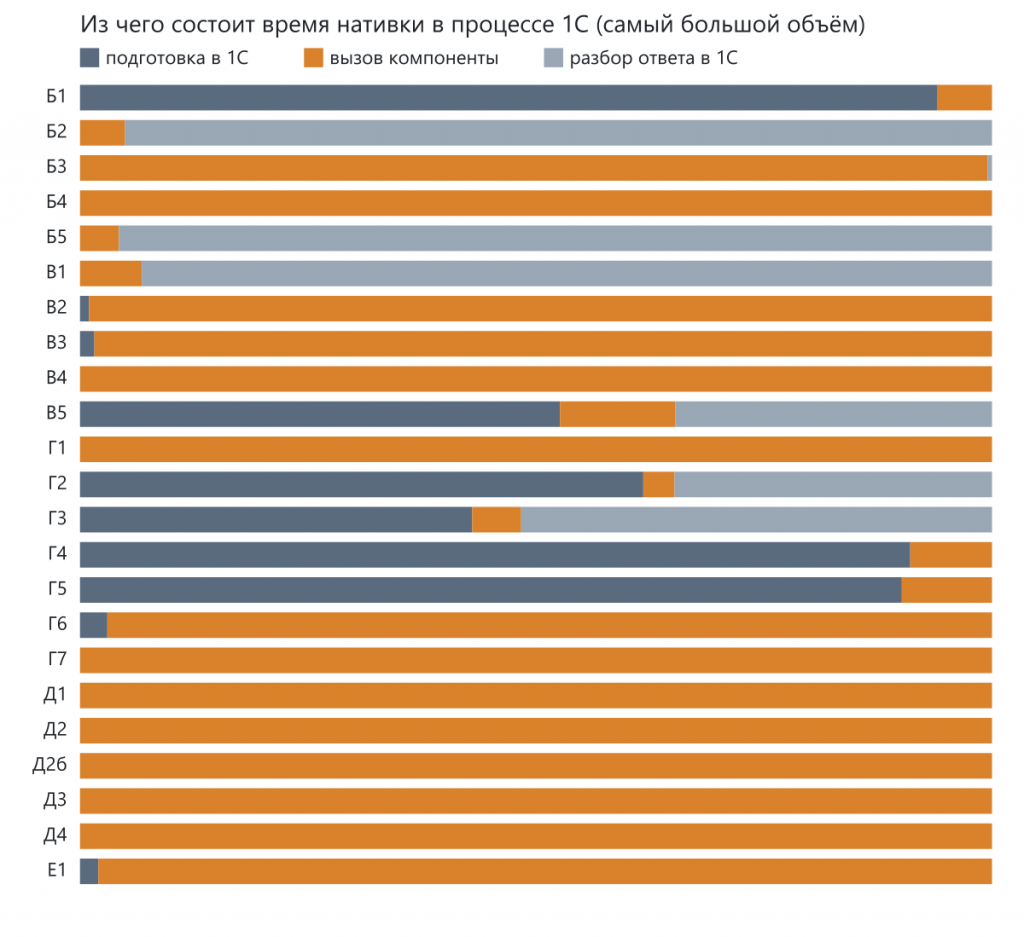


Медленное место в 1С рано или поздно хочется переписать на C++ и подключить внешней компонентой (DLL на C++, технология Native API). Я решил проверить, когда это даёт выигрыш, а когда только добавляет работы. Взял 31 тест: JSON, разбор CSV, поиск по тексту, расстояние Левенштейна, сортировку, статистику, рюкзак, Base64, хеш, построчное сравнение текстов, потоки. Каждую задачу решил на встроенном языке и в своей внешней компоненте и померил от начала до конца.
По дороге выяснилось, что на платформе 8.3.27 скорость компоненты в первую очередь решает одна строка подключения, код на C++ идёт вторым. Об этом первая половина статьи.
Как мерил
Сравнивать компоненту с кодом "как пишут обычно" нечестно: половину выигрыша даёт любая оптимизация на самом 1С. Поэтому у каждой задачи до трёх вариантов на встроенном языке: наивный, оптимизированный (СтрСоединить, Соответствие вместо поиска в цикле, нативные методы коллекций) и платформенный, если в платформе есть готовое средство. Главная цифра - компонента против лучшего из них.
Вход и выход у всех вариантов одинаковые и в обычной для 1С форме: массив структур, таблица значений, текст, двоичные данные. Значит, время компоненты включает подготовку данных в 1С, сам вызов и разбор ответа обратно в коллекции. Эти три фазы замеряются отдельно. Перед замером каждый вариант выполняется один раз, его результат приводится к каноническому виду и сравнивается по MD5 со всеми остальными. Тест, где хоть один вариант дал другое, не считается.
Остальное как обычно: прогрев, пять повторов, медиана, короткие варианты гоняются пачкой до окна в 20 мс (таймер 1С считает целыми миллисекундами). Данные строит свой генератор из зерна 42, поэтому на любой машине они одинаковые. У каждого теста лестница объёмов, чтобы найти, с какого объёма компонента начинает окупаться. Ожидания по каждому тесту я записал до первого замера.
Стенд: Windows 10 x64, Core i7-9750H (6 ядер, 12 потоков), 16 ГБ, платформа 8.3.27.1606, клиент-серверная база, всё выполняется на сервере. Компонента собрана MSVC 19.44 из официального шаблона ИТС, без внешних библиотек. Первый полный прогон случайно шёл на сервере, запущенном с ключом -debug. Потом агент перезапустили без отладки и всё прогнали заново. В статье цифры второго прогона, а разница между ними - в разделе про ошибки.
Сколько стоит сама граница
Первая группа тестов ничего не считает. Она меряет, сколько стоит позвать компоненту и передать ей данные. Первый прогон дал цифры, которые я сначала принял за ошибку:
| Что | 1С | Компонента, подключение по умолчанию | Компонента в процессе 1С |
|---|---|---|---|
| 10 000 пустых вызовов | 12 мс (пустая процедура модуля) | 1 232 мс | 41 мс |
| передать строку 10 млн символов | 0,01 мс | 870 мс | 14 мс |
| вернуть строку 10 млн символов | 0,01 мс | 390 мс | 24 мс |
| 10 МБ двоичных данных туда и обратно | 0,01 мс | 2 161 мс | 17 мс |
Сто двадцать микросекунд на пустой вызов и почти секунда на передачу десяти миллионов символов - это не цена вызова функции в DLL. Так выглядит обмен между процессами. И правда: у метода ПодключитьВнешнююКомпоненту в 8.3.27 появился четвёртый параметр с типом ТипПодключенияВнешнейКомпоненты и двумя значениями, Изолированно и НеИзолированно (в 8.3.20 этих имён в платформе нет). Без параметра компонента на моём сервере ведёт себя ровно как с явным Изолированно. С НеИзолированно пустой вызов стоит около 4 мкс, это последний столбец таблицы.
// Компонента в процессе 1С: вызов почти бесплатный, но её сбой роняет рабочий процесс
Подключена = ПодключитьВнешнююКомпоненту(Адрес, "Nativka", ТипВнешнейКомпоненты.Native,
	ТипПодключенияВнешнейКомпоненты.НеИзолированно);
С изоляцией связаны и две странности, на которые я потратил полдня. Обе есть при изолированном подключении и пропадают при НеИзолированно. Первая: двоичные данные больше 163 803 байт приходят в изолированную компоненту не двоичными данными, а строкой Base64 (в варианте для адресов, с минусом и подчёркиванием, без знаков равенства в конце). Из компоненты двоичные данные больше 70 182 байт возвращаются в 1С тоже строкой. Если компонента ждёт только двоичные данные, она на большом файле просто отказывается работать. Вторая: изолированная компонента, однажды подключённая в базе, там и остаётся. Новая сборка с новым именем подключения и новым именем DLL в пакете в той же базе не подхватывается, отвечает старая, и за день прогонов она не сменилась. Перезапуск сервера её сбросил.
В процессе 1С граница дешёвая, но не бесплатная. Миллион вызовов пустого метода компоненты занял 4 189 мс, миллион вызовов пустой процедуры на 1С - 1 363 мс. Десять миллионов символов уходят в компоненту за 14 мс. Поэтому поэлементный вызов в цикле остаётся антипаттерном: возвести в квадрат 100 000 чисел на 1С - 95 мс, тем же циклом через компоненту - 546 мс, изолированно - 7 930 мс.
Дальше все результаты в двух вариантах: компонента в процессе 1С и по умолчанию.
Где компонента выигрывает в десятки и сотни раз
Там, где на вход уходит немного данных, а внутри много арифметики, интерпретатор 1С проигрывает без шансов. Объём - самая большая ступень, на которой успели оба варианта.
| Задача | Объём | Лучшая 1С | В процессе 1С | Изолированно |
|---|---|---|---|---|
| рюкзак 0/1, 100 предметов | вместимость 50 000 | 6 252 мс | 5 мс | 4,8 мс |
| Монте-Карло, число пи | 1 млн точек | 3 115 мс | 8,8 мс | 8 мс |
| нечёткие дубли (Левенштейн до 2) | 1 000 наименований | 1 403 мс (индекс триграмм) | 6 мс | 16 мс |
| построчный diff (Майерс) | 20 000 строк | 1 205 мс | 7,5 мс | 166 мс |
| расстояние Левенштейна для пар | 10 000 пар | 4 602 мс | 39 мс | 119 мс |
| умножение целых матриц | 100 x 100 | 998 мс | 41 мс | 42 мс |
Пока данных на входе мало и вызов один, режим подключения почти не важен: у рюкзака, Монте-Карло и матриц изолированная компонента идёт вровень. Где это кончается, показывает diff: на вход уходят 20 000 строк текста, и изолированно выходит 166 мс против 7,5. А у матриц видно, куда ушло время: из 41 мс сам расчёт занял 1,4 мс, остальное - перевод матриц в текст в 1С (25 мс) и разбор ответа (14 мс).
Рюкзак, Монте-Карло и матрицы в обёртку обработки не вошли, хотя выигрыш у них самый большой. Это демонстрация принципа: прикладной задачи 1С, которую стоило бы вызывать готовой функцией, за ними нет. В обёртку попадает задача, которая выиграла от 2 раз и встречается в прикладном коде, поэтому из этой таблицы там только нечёткие дубли, Левенштейн и diff.

Где выигрыш есть только в процессе 1С
Самая интересная группа: строка на вход, короткий итог на выход. Компонента читает текст сама, 1С ничего не строит.
| Задача | Объём | Лучшая 1С | В процессе 1С | Изолированно |
|---|---|---|---|---|
| JSON в JSON с переименованием полей | 100 000 записей | 1 376 мс | 49 мс | 1 612 мс |
| сумма и количество по ключу в JSON | 100 000 записей | 1 105 мс (ПрочитатьJSON + Найти в таблице) | 43 мс | 1 253 мс |
| разбор дат и чисел из текста с суммами | 1 млн строк | 2 959 мс (XMLЗначение) | 165 мс | 2 055 мс |
| 50 подстрок в тексте | 10 млн символов | 832 мс (СтрЧислоВхождений) | 229 мс | 2 799 мс |
| Base64, декодирование | 50 МБ | 1 149 мс (Base64Значение) | 324 мс | дольше 10 с |
| разбор CSV с кавычками в массив массивов | 100 000 строк | 962 мс | 375 мс | 1 712 мс |
В процессе 1С переложить JSON быстрее в 28 раз, агрегат по нему в 26, разбор дат и чисел в 18. Изолированная компонента на тех же задачах в лучшем случае в полтора раза быстрее 1С (даты и числа), а на JSON медленнее: десятки миллисекунд расчёта тонут в секунде передачи текста между процессами. У CSV видно другое ограничение: из 375 мс 336 ушло на то, чтобы собрать из ответа массив массивов в 1С.

Где компонента проигрывает в любом режиме
| Задача | Объём | Лучшая 1С | В процессе 1С | Куда ушло время |
|---|---|---|---|---|
| разбор JSON в массив структур | 100 000 записей | 590 мс (ПрочитатьJSON) | 1 133 мс | 1 003 мс - собрать структуры из ответа |
| JSON в таблицу значений | 100 000 записей | 966 мс | 1 480 мс | 1 389 мс - заполнить таблицу из ответа |
| JSON из массива структур | 100 000 записей | 540 мс (ЗаписатьJSON) | 703 мс | 656 мс - склеить структуры в текст для компоненты |
| сортировка целых чисел | 1 млн | 2 701 мс (СписокЗначений) | 3 094 мс | сортировка 167 мс, числа в текст и обратно 2 946 мс |
| регулярное выражение | 10 млн символов | 440 мс (СтрНайтиВсеПоРегулярномуВыражению) | 3 476 мс | std::regex медленнее движка платформы |
| число в строку по одному вызову | 1 млн чисел | 1 219 мс (XMLСтрока) | 7 197 мс | вызов дороже работы |
Почти везде время съела сериализация на стороне 1С. Компонента не умеет вернуть структуру или таблицу значений, только строку или двоичные данные. Если результат нужен коллекцией, его собирает 1С, и это та же работа, которую ПрочитатьJSON делает внутри платформы быстрее. С сортировкой то же самое: миллион чисел компонента сортирует за 167 мс, но перевести их в текст и обратно стоит почти три секунды.
Где-то посередине остались хеш SHA-256 (100 МБ: 469 мс у ХешированиеДанных, 505 мс у компоненты) и массовые замены (10 млн символов, 20 замен: 253 мс у СтрЗаменить, 136 мс у компоненты). Платформенная функция уже работает в машинном коде, и обогнать её одним кодом на C++ трудно. Линейная регрессия на 100 000 точек проиграла: 173 мс на 1С против 268 мс, где 254 мс заняла подготовка пар чисел.
Потоки
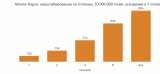
Многопоточность внутри одного вызова - то, чего во встроенном языке нет совсем. Монте-Карло на 50 млн точек в процессе 1С: один поток 372 мс, два 195, четыре 100, восемь 56, все двенадцать 42 мс. В 9 раз на шести физических ядрах. Нечёткие дубли на 3 000 наименований ускорились только с 31 до 11 мс: работы мало, запуск потоков съедает выигрыш. Число потоков у ядер - параметр, по умолчанию один: компонента на сервере, которая без спроса займёт все ядра, мешает остальным сеансам.

Где я ошибся до замеров
- Отладка на сервере. Первый полный прогон шёл на сервере с ключом
-debug, и я этого не проверил заранее. Под отладкой встроенный язык был медленнее в 2,8-4,6 раза: миллион вызовов пустой процедуры 6 286 мс против 1 363, Монте-Карло на миллион точек 8 680 мс против 3 115, diff на 20 000 строк 4 429 мс против 1 205. Компоненту отладка почти не задела. Выигрыши сдулись: diff со 554 раз до 161, нечёткие дубли с 815 до 234, разбор дат и чисел с 43 до 18, агрегат по JSON с 38 до 26. Массовые замены упали с 2,4 раза до 1,9 и не вошли в обёртку. Сортировка из проигрыша в 3 раза стала почти паритетом, потому что ускорился и перевод чисел в текст. - Цена вызова. Я ждал, что пустой вызов компоненты дороже процедуры 1С в 3-10 раз. В процессе 1С так и вышло, в 3 раза. Изолированно - в 100 раз. Режим подключения я не предусмотрел вообще.
- СтрЧислоВхождений. Ждал паритета: поиск в платформе нативный. Компонента в процессе 1С выиграла в 3,6 раза, потому что проходит текст один раз на все 50 образцов, а 1С проходит его 50 раз.
- Base64. Ждал паритета, получил выигрыш в 2,6 раза на кодировании и 3,6 на декодировании. Часть разницы - переводы строк: Base64Строка вставляет их, и для сравнения их пришлось убирать.
- JSON в JSON и агрегат. Ждал выигрыша в 3-20 раз, получил 26-28 в процессе 1С и паритет изолированно.
- Точность. На миллионе точек регрессия не прошла проверку одинаковости: 1С считает десятичными числами и даёт свободный член 49,425190, компонента в double - 49,425202. Эта ступень в вердикт не вошла. Для денег и учёта это повод не переносить расчёт в double без проверки.
- Потоки. Ждал ускорения по числу физических ядер, получил 9 раз на шести ядрах: этому целочисленному счёту, видимо, помогает гипертрединг.
Когда писать компоненту
Правила по цифрам этого стенда, не по ощущениям.
- Сначала строка подключения. На 8.3.27 по умолчанию компонента изолирована, и каждый вызов стоит около 120 мкс, а миллион символов текста - около 90 мс в одну сторону. Изоляция защищает рабочий процесс от падения компоненты, это осознанный выбор платформы. Если компонента своя и проверенная, НеИзолированно убирает эту цену почти целиком. На 8.3.20 этого параметра нет, как там ведёт себя граница, я не мерил.
- Считайте, сколько 1С будет сериализовать. Граница в процессе 1С дешёвая, дорого то, что 1С делает до и после: XMLСтрока на каждое число, структура на каждую строку ответа. Если подготовка и разбор занимают больше, чем лучший вариант на 1С, компонента не поможет при любом C++.
- Выигрывает задача "много считать, мало вернуть". Текст на вход, итог на выход: агрегаты, поиск, разбор с суммированием, сравнение текстов. Или почти пустой вход и много арифметики: динамическое программирование, перебор, моделирование.
- Не соревнуйтесь с платформенной функцией. ЗаписатьJSON, ПрочитатьJSON, сортировка коллекции, ХешированиеДанных, регулярные выражения 8.3.23+ уже работают в машинном коде.
- Никаких вызовов в цикле. Даже в процессе 1С поэлементный вызов в 5-6 раз медленнее, чем то же действие на 1С.
Как повторить у себя
Обработка из статьи - "1С против внешней компоненты на C++: бенчмарк". Компонента лежит в ней макетом и подключается через временное хранилище, класть файлы на сервер не нужно. На вкладке "Замеры" выбираются тесты, число повторов, ступени объёма и режим подключения, результат сохраняется в JSON вместе с описанием окружения. На вкладке "Где нативка выигрывает" - цифры этого стенда и советник: указываете задачу и объём, он оценивает время 1С и компоненты в обоих режимах. Десять выигравших ядер доступны из своего кода как функции обработки: агрегат и переименование полей JSON, разбор CSV, итоги дат и чисел, поиск подстрок, Левенштейн и нечёткие дубли, сравнение текстов, кодирование и декодирование Base64. Без компоненты они считают тот же результат на встроенном языке.
Мне интересно, что получится на Linux: у меня его не было. И вопрос к тем, кто держит свои компоненты в проде: вы подключаете их изолированно или в процессе 1С, и падал ли у вас рабочий процесс из-за компоненты?
Другие наши инструменты:
- "Локальная LLM на встроенном языке 1С" - трансформер, посчитанный на чистом BSL: хорошая иллюстрация того, сколько стоит арифметика в интерпретаторе 1С.
- "Анализ кода внешних обработок" - ищет в коде внешних обработок запросы в цикле, опасные вызовы и хардкод.
- "Помощник перехода на 1С 8.5" - что в конфигурации изменится или сломается при переходе на платформу 8.5.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.


