Лишние индексы в базе 1С на PostgreSQL: как найти, какой реквизит их создал, и как убрать
Разработка - Рефакторинг и качество кода

Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Как найти в базе 1С на PostgreSQL индексы без обращений, точные дубли и индексы, чей ключ - начало другого индекса, и убрать их там, где их создала платформа: через свойство «Индексировать». Проверено на «Нано-УТ» и сервере 1С 8.3.27.
- Индекс платформы убирают свойством «Индексировать» и обновлением конфигурации, а не командой DROP INDEX.
- Признак «уникальный» в базе 1С не говорит о защите данных: платформа добавляет ссылку в ключ почти всех индексов.
- Статистика idx_scan копится с момента сброса; после реструктуризации таблицы окно для неё открывается заново.
- Ручные индексы на таблице 1С в нашем опыте исчезли при пересоздании таблицы платформой.
- Повтор индекса утилита определяет по порядку колонок: индекс лишний, если его колонки - начало другого индекса.
Индекс без обращений в базе 1С сначала связывают с реквизитом и свойством в конфигурации, а потом решают, нужен ли он, на копии базы и с учётом редких отчётов.
Для кого: разработчики и администраторы 1С на PostgreSQL, которые чистят индексы и хотят видеть, какой реквизит каждый из них создал.
- Стенд
- Какие индексы создаёт платформа
- Статистика PostgreSQL и её окно
- Связь индексов с метаданными 1С
- Прогон утилиты на базе с лишними индексами
- Индексы, которые повторяют уже существующие
- Как убрать лишнее: свойство вместо DROP INDEX
- Цена лишних индексов на запись
- Что не проверялось
- Итог
- Источники
- Файл к статье
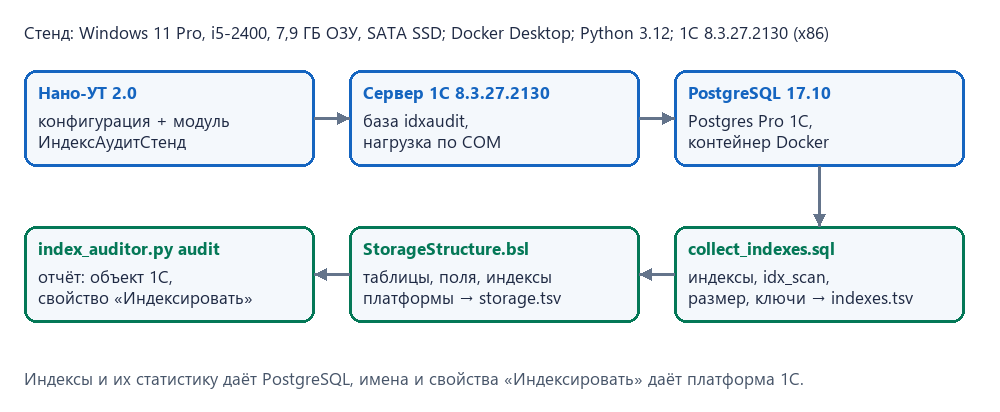
В PostgreSQL таблицы базы 1С называются _document62 и _inforg235, а индексы - _document62_5 и _inforg235_4. Администратор СУБД видит индекс, которым никто не пользуется, и не знает, какой реквизит в конфигурации его создал. Разработчик 1С знает реквизиты, но не видит, сколько раз к индексу обращались. Я написала утилиту на Python, которая сводит эти два взгляда вместе: берёт статистику PostgreSQL, описание хранения базы из платформы и выгрузку конфигурации и по каждому подозрительному индексу называет объект 1С и свойство «Индексировать», от которого он появился.
Проверила я её на учебной конфигурации «Нано-УТ» на сервере 1С 8.3.27 и PostgreSQL 17.10. Утилита нашла индексы без единого обращения, дубль, который я создала вручную, и два индекса, которые целиком покрываются другими. Потом я сняла свойство «Индексировать» в конфигурации, обновила базу и посмотрела, что сделала платформа. Все цифры в статье получены на моём стенде 22 октября 2026 года.
На Инфостарте про индексы в 1С уже писали: есть обработка «Структура базы на PostgreSQL», обработка «Структура хранения данных и рекомендации по индексам» и заметка о восстановлении индексов СУБД (ссылки в разделе «Источники»). Моя утилита отличается тем, что связывает счётчики обращений с флагами конфигурации и отдельно ищет индексы, которые повторяют уже существующие.
Стенд
| Условие | Значение |
|---|---|
| Платформа | 1С:Предприятие 8.3.27.2130 (x86), отдельный экземпляр кластера (ragent на портах 1840/1841), серверная база idxaudit |
| СУБД | Postgres Pro 1C 17.10 в контейнере Docker. PostgreSQL 15 и 16 не проверялись |
| Конфигурация | «Нано-УТ 2.0» - наша учебная торговая конфигурация (справочники, документы, регистры сведений и накопления). Добавлен общий модуль ИндексАудитСтенд: выгрузка структуры хранения и заполнение базы |
| Данные | 12 товаров, 5 контрагентов, 120 проведённых документов «ПродажаТовара» по 3 строки, документ начальных остатков |
| Компьютер | Intel Core i5-2400 3,1 ГГц (4 ядра, 2011 год), 7,9 ГБ ОЗУ, SATA SSD, Windows 11 Pro; Docker Desktop, ВМ на 4 ядра. Компьютер рабочий: во время замеров были открыты браузер и приложение Claude |
База маленькая: индексы занимают килобайты. Времена в разделе про запись на другом железе получатся другими, а поведение платформы и логика поиска от железа не зависят.
Какие индексы создаёт платформа
В базе стенда 227 индексов, из них 176 платформа создала с признаком UNIQUE. Ключ индекса - это список колонок, по которым он упорядочен. Объявить свой индекс уникальным платформа может потому, что последней колонкой ставит в ключ ссылку на объект (_IDRRef), а она у каждой строки своя. Ту же уникальность ссылки уже обеспечивает первичный ключ, поэтому такой UNIQUE не отклонит ни одной строки, которую не отклонил бы он. Признак UNIQUE у служебного индекса 1С поэтому не помогает отличить индекс, который защищает данные, от индекса только для поиска, и утилита на него не опирается. Первичный ключ платформа создаёт как ограничение PRIMARY KEY: _document62ng_pkey. Для документа «ПродажаТовара» в исходной базе три служебных индекса по номеру и дате:
| Индекс | Ключ |
|---|---|
_document62_1 |
_numberprefix, _number, _idrref |
_document62_2 |
_number, _idrref |
_document62_3 |
_date_time, _idrref, _marked |
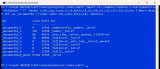
Лишние индексы появляются, когда у реквизита включено свойство «Индексировать» или «Индексировать с доп. упорядочиванием». Я включила его у пяти реквизитов документа «ПродажаТовара» (Контрагент, Склад с доп. упорядочиванием, ВидЦены, Заказ, Комментарий) и у двух измерений регистра сведений «ЦеныНоменклатуры», обновила конфигурацию базы и запустила нагрузку: 120 продаж и 30 повторов типовых запросов (документы за период, остатки на дату, документы одного контрагента). Платформа создала пять новых индексов на документе и два на регистре, а индекс _document62_3 пересоздала с добавлением склада в ключ. На рисунке показаны индексы документа и число обращений к каждому после нагрузки. Выгрузка сделана запросом collect_indexes.sql из архива; команда PowerShell на снимке читает файл-выгрузку со стенда от 22.10.2026.
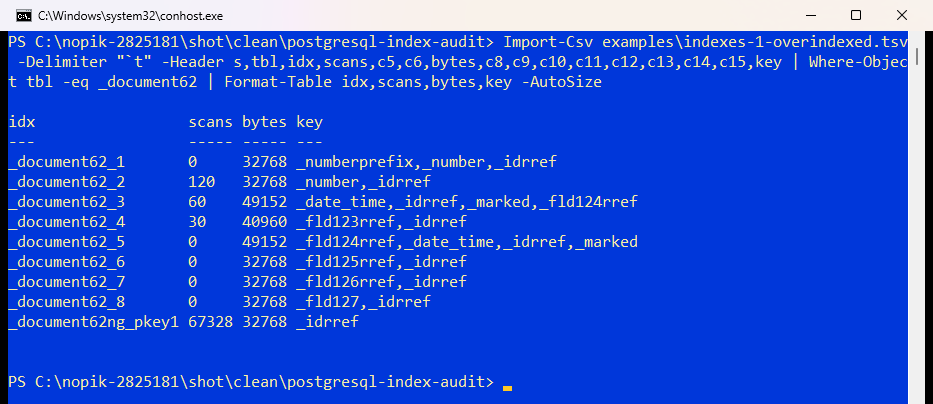
Индекс _document62_4 (контрагент) использован 30 раз: на нём держится запрос «документы контрагента». Индексы по складу с упорядочиванием, виду цены, заказу и комментарию не использованы ни разу. К таблице регистра _inforg235 обращений нет совсем: ни один запрос нагрузки не читал цены.
Статистика PostgreSQL и её окно
Число обращений к индексу PostgreSQL ведёт сам. Оно лежит в представлении pg_stat_user_indexes, в поле idx_scan (от английского index scan, «просмотр индекса»):
Счётчик копится с момента, когда статистику последний раз сбрасывали. Эту дату хранит pg_stat_database.stats_reset, и утилита печатает её в начале отчёта. Перед нагрузкой я вызвала pg_stat_reset(), поэтому окно наблюдения здесь - один прогон. В рабочей базе окно должно покрывать и самые редкие отчёты: квартальные и годовые.
Что именно увеличивает счётчик, я проверила отдельным опытом на том же PostgreSQL 17.10 (скрипт queries/idx_scan_check.sql в архиве). Одна таблица на 200 000 строк, один индекс, после каждого обращения печатаются план и счётчик. idx_scan вырос при поиске по битовой карте (Bitmap Index Scan), при поиске только по индексу (Index Only Scan), при сортировке по индексу без условия и даже тогда, когда планировщик только оценивал запрос (EXPLAIN без выполнения) со значением за пределами собранной статистики: в этом случае он сам заглядывает в индекс. Значит, ноль в idx_scan означает, что за время наблюдения к индексу не обращался никто, включая планировщик.
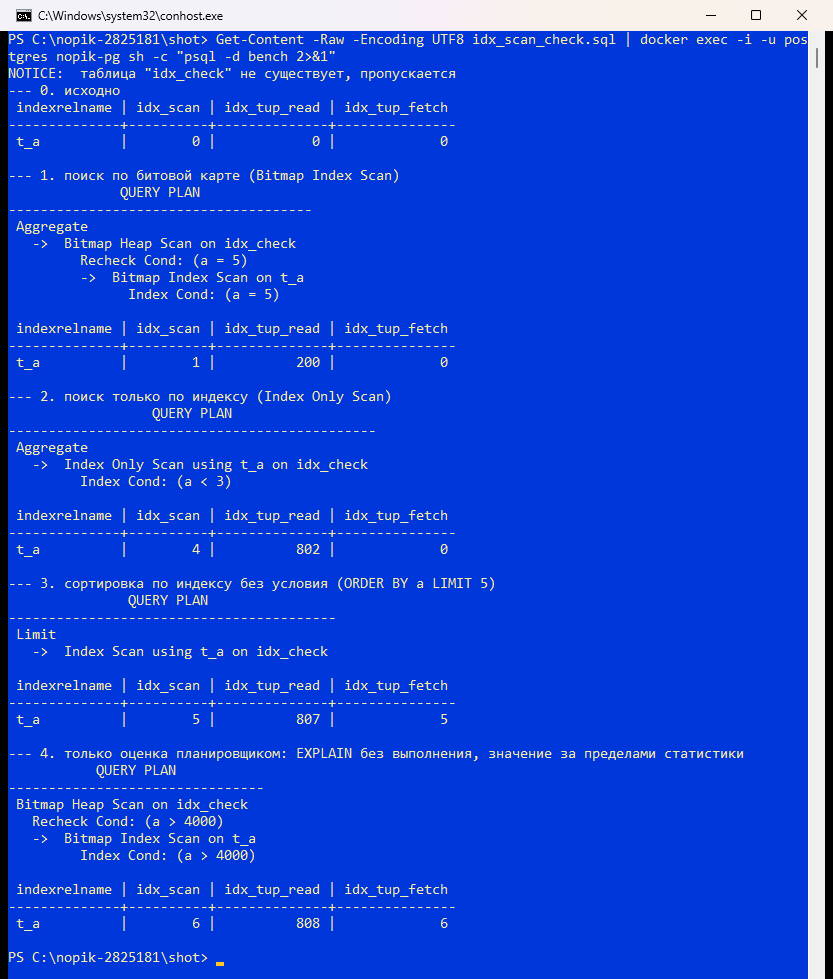
При этом ноль - только повод разобраться. Счётчики обнуляются не только по pg_stat_reset(): PostgreSQL сбрасывает их после аварийной остановки и после восстановления из резервной копии. На стенде я это видела сама: после того как Docker был остановлен без корректного завершения, контейнер прошёл восстановление, и все счётчики базы стали нулевыми. Чтения на реплике в счётчиках основного сервера не видны: у реплики своя статистика. Индекс может быть нужен и без единого поиска, если на нём держится ограничение (UNIQUE, внешний ключ). Наконец, планировщик пользуется индексом для оценок, поэтому после удаления индекса планы других запросов могут измениться.
Связь индексов с метаданными 1С
Имена _Document62 и _Fld124RRef выдаёт платформа. Соответствие между ними и объектами конфигурации возвращает встроенная функция ПолучитьСтруктуруХраненияБазыДанных: таблица значений с именами таблиц, полей и индексов платформы. Я сохраняю её в текст из серверного модуля:
Полный модуль лежит в архиве (1c/StorageStructure.bsl); платформа проверила его командой проверки модулей, а вызов из внешнего соединения я выполнила на стенде. В выгрузке видно, что _Fld124RRef - реквизит «Склад», _Document62 - «Документ.ПродажаТовара», а индекс _Document62_5 платформа создала сама. У служебных колонок вроде _NumberPrefix в структуре нет ни имени, ни метаданных, и утилита показывает их по имени колонки.
Таблиц, которых нет в структуре (v8users, binarydata и другие служебные таблицы платформы), в базе стенда от 166 до 170 индексов. К метаданным конфигурации они не относятся, поэтому утилита сворачивает их в одну строку отчёта.
Чтобы назвать само свойство, утилита читает XML-выгрузку конфигурации (Конфигуратор, «Выгрузить конфигурацию в файлы») и берёт значения Indexing у реквизитов, измерений и ресурсов. Путь метаданных в выгрузке и в структуре хранения строится одинаково, так что поле «Склад» документа находится по строке Документ.ПродажаТовара.Реквизит.Склад.
Прогон утилиты на базе с лишними индексами
Нужны две команды: первая выгружает индексы через psql, вторая строит отчёт. Утилита ничего не меняет в базе, она только читает файлы.
python index_auditor.py collect --psql "docker exec -i -u postgres nopik-pg psql -d idxaudit" --out indexes.tsv
python index_auditor.py audit --indexes indexes.tsv --storage storage.tsv --config-dir cf-over
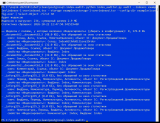
На снимке утилита запущена на выгрузках со стенда от 22.10.2026, которые лежат в архиве (examples). Показаны первые 30 строк отчёта.
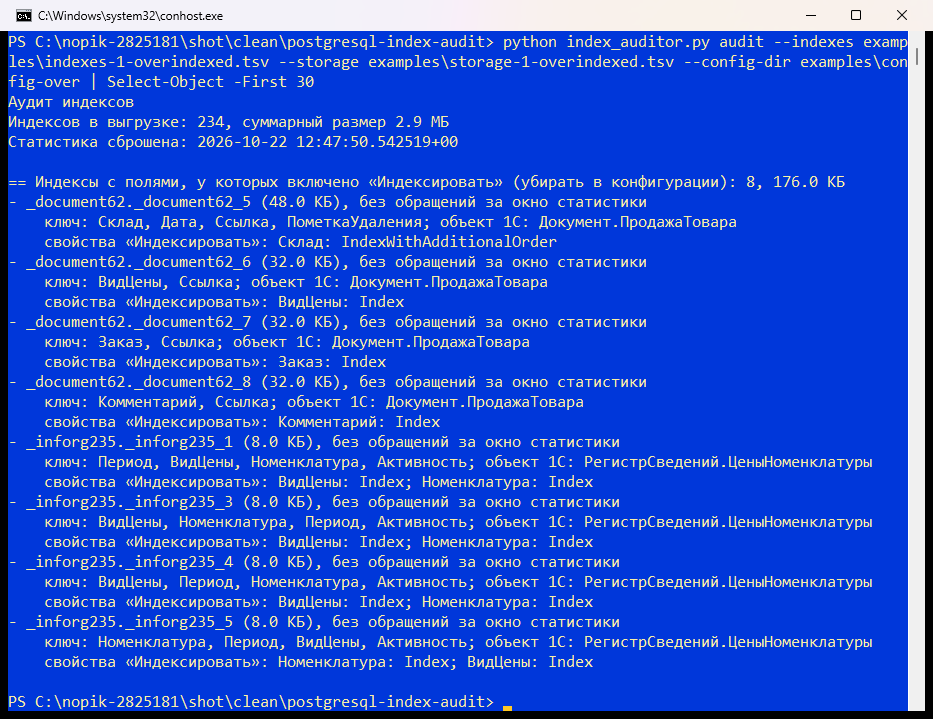
В разделе про индексы с включённым «Индексировать» восемь индексов, 176 КБ: четыре на документе (_document62_5, _6, _7, _8) и четыре на регистре цен. Часть индексов регистра платформа создаёт и без флагов (_inforg235_1 и _3 были в исходной базе), поэтому утилита пишет осторожно: «в ключе есть поля с включённым свойством», а решение по каждому принимает человек. Индексы _document62_6, _7 и _8 существуют только из-за флагов у реквизитов ВидЦены, Заказ и Комментарий, и к ним никто не обращался.
Индексы, которые повторяют уже существующие
В базе стенда платформа не создала ни одного дубля. Дубли появляются, когда администратор добавляет индекс вручную. Я добавила в базу три индекса командой CREATE INDEX в psql:
manual_sklad_dupс тем же ключом, что у_document62_5(склад, дата, ссылка, пометка удаления);manual_sklad_prefixтолько по складу;manual_kontr_prefixтолько по контрагенту.
Первый из них - точная копия служебного индекса 1С. Два других тоже лишние, хотя ни с чем не совпадают. Индекс похож на телефонный справочник: если справочник отсортирован по фамилии, а внутри фамилии по имени, то искать в нём просто по фамилии так же быстро. Отдельный справочник «только по фамилиям» ничего не добавляет. Служебный индекс _document62_5 отсортирован сначала по складу, поэтому поиск по складу он уже обслуживает, и ручной индекс по складу его только повторяет. Так же ручной индекс по контрагенту повторяет начало служебного _document62_4, где контрагент стоит первой колонкой.
Оговорка: короткий индекс меньше длинного, и для части запросов PostgreSQL может выбрать именно его, например при низкой избирательности условия или для сортировки только по складу. Поэтому утилита называет такой индекс кандидатом на удаление, а решает человек. Перед удалением посмотрите планы типовых запросов (EXPLAIN) с ним и без него, лучше на копии базы.
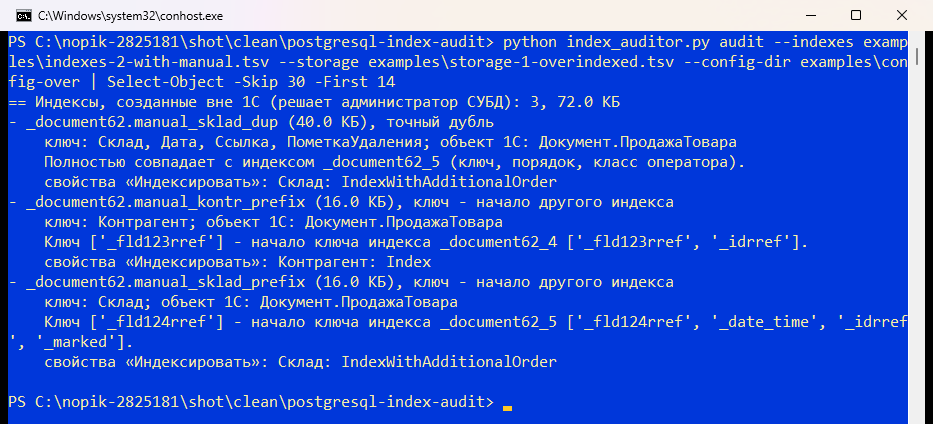
Из пары одинаковых индексов утилита оставляет тот, который есть в структуре хранения 1С, и называет лишним чужой. Порядок колонок утилита учитывает: ключ (b, a) началом ключа (a, b, c) не считается, это проверяет тест. Индексы с условием WHERE, индексы по выражениям и индексы не вида btree утилита не сравнивает. Уникальные индексы и индексы под ограничениями утилита в кандидаты не включает, даже если они повторяют начало другого. Лишними они бывать могут, например UNIQUE поверх первичного ключа с тем же ключом, но удаление такого индекса меняет правила для данных, и решать это должен человек.
Как убрать лишнее: свойство вместо DROP INDEX
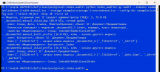
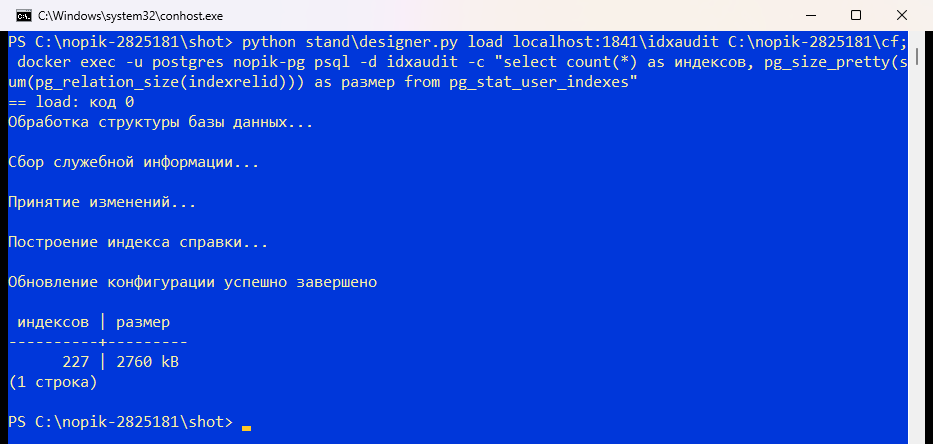
Индекс, который создала платформа, правильно убирать так: снять свойство «Индексировать» и обновить конфигурацию базы. Иначе платформа создаст его снова при следующей реструктуризации. Ручной индекс, созданный администратором вне 1С, убирают обычной командой DROP INDEX: его нет в структуре хранения, и платформа о нём не знает. Ручные индексы бывают и полезны, когда для нужного запроса платформа индекс не строит. Я загрузила в базу конфигурацию без флагов и посмотрела индексы. Снимок сделан сразу после загрузки: сверху ответ Конфигуратора, снизу запрос в psql.
| Показатель | С флагами | После снятия флагов |
|---|---|---|
Индексов в схеме public |
234 | 227 |
| Размер индексов, байт | 3 047 424 | 2 826 240 |
Индексов таблицы _document62 |
9 | 4 |
| Документов «ПродажаТовара» | 240 | 240 |
| Строк в выдаче трёх типовых запросов | 5880 | 5880 |
Платформа пересоздала таблицу _document62 целиком: имя ограничения первичного ключа изменилось (_document62ng_pkey1 снова стало _document62ng_pkey), и все три индекса, которые я добавила вручную, исчезли вместе со старой таблицей. Это результат моего стенда: здесь платформа пересоздала таблицу. Пересоздаёт ли она таблицу при другом изменении структуры, зависит от изменения, и ручные индексы при этом могут как пропасть, так и остаться. После каждого обновления конфигурации проверяйте, на месте ли ваши ручные индексы.
Счётчики idx_scan у новой таблицы начались с нуля: окно наблюдения для неё открылось заново.
Времена двух прогонов нагрузки, 225,6 и 679,7 с, сравнивать нельзя: второй прогон шёл в базе, где уже были проведённые документы, а проведение в «Нано-УТ» дорожает по мере роста истории документов.
Цена лишних индексов на запись
Чтобы не ссылаться на общие слова, я отдельно измерила стоимость индексов без 1С, на таблице в той же СУБД. В таблицу вставляется 300 000 строк, затем обновляется 100 000 строк по колонке без индекса и ещё 100 000 строк по колонке с индексом. Опыт идёт на таблице с 0, 2, 4 и 8 дополнительными индексами. Кроме времени я смотрела на объём журнала предзаписи (WAL, от английского write-ahead log): в него PostgreSQL сначала записывает каждое изменение, чтобы не потерять его при сбое, и каждый дополнительный индекс увеличивает этот журнал. Ниже медианы трёх прогонов:
| Дополнительных индексов | Вставка, мс | Журнал WAL при вставке, МБ | Обновление колонки без индекса, мс | Обновление колонки с индексом, мс | WAL при таком обновлении, МБ | Размер индексов, МБ |
|---|---|---|---|---|---|---|
| 0 | 3114 | 47,1 | 996 | 848 | 20,0 | 10,7 |
| 2 | 5783 | 95,6 | 1388 | 2530 | 36,0 | 31,7 |
| 4 | 9772 | 136,6 | 2410 | 3402 | 48,0 | 52,0 |
| 8 | 19 061 | 228,0 | 3265 | 5805 | 78,9 | 99,0 |
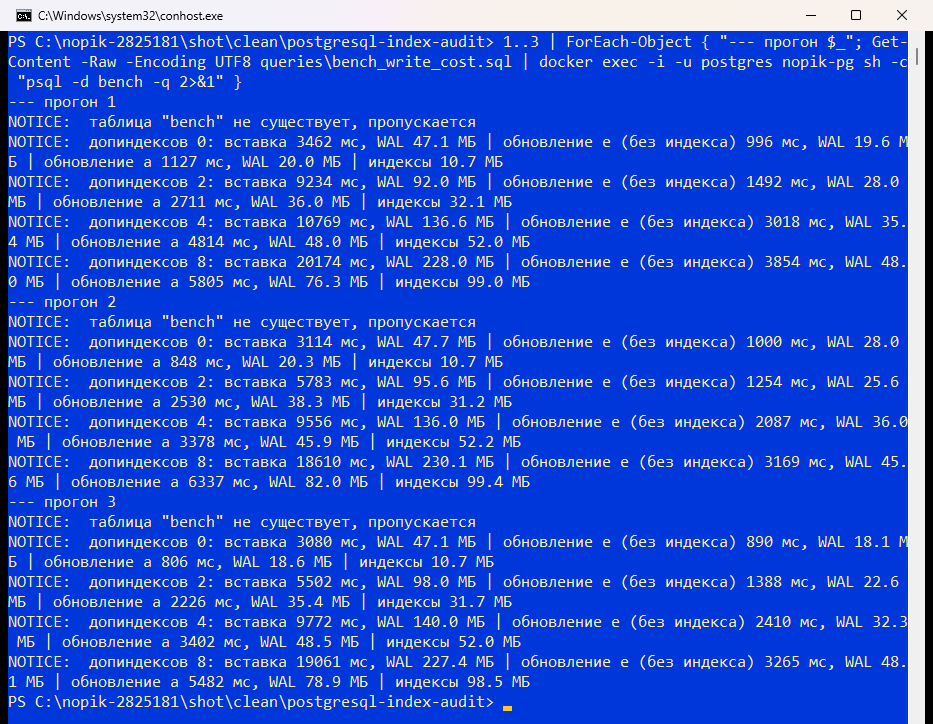
С восемью дополнительными индексами вставка заняла 19 061 мс против 3114 мс без них, то есть в шесть раз дольше, а журнал WAL вырос в 4,8 раза. Разброс на рабочем компьютере большой: в предыдущей серии из трёх прогонов тех же запросов медианы вставки были 3873 и 15 947 мс, то есть в 4,1 раза. Поэтому я пишу диапазон: в четыре-шесть раз дольше. Объём WAL в обеих сериях получился одинаковым с точностью до процентов (47,3 и 47,1 МБ без индексов, 227,7 и 228,0 МБ с восемью). Обновление колонки без индекса тоже подорожало (996 против 3265 мс); причину я не выясняла.
Отдельно я проверила оптимизацию HOT (Heap-Only Tuples). Когда обновляется колонка, которой нет в индексах, PostgreSQL может положить новую версию строки на ту же страницу таблицы и не трогать индексы. В опыте после обновления колонки без индекса 4281 из 10 000 обновлений прошли как HOT, а после обновления колонки с индексом HOT не было ни одного. Скрипты опытов лежат в архиве.
Эти цифры относятся к таблице без 1С. Стоимость проведения документов в 1С они не показывают: для этого нужен замер на вашей базе до и после снятия свойства.
Что не проверялось
- Рабочая база с миллионами строк и обычной нагрузкой; индексы на сотни мегабайт.
- PostgreSQL 15 и 16, Linux, реплики (статистика на реплике своя), секционирование.
- Конфигурации с расширениями и типовые конфигурации: у них своя структура индексов и своё поведение при перестройке таблиц.
- Платформа ниже 8.3.27.
- Влияние снятия свойства на планы запросов: утилита этого не оценивает.
Итог
Индекс без обращений - только повод разобраться. Если его создала платформа, удалять его командой СУБД нельзя: убирать его надо свойством «Индексировать» в конфигурации. Ручной индекс удаляют командой DROP INDEX, проверив планы запросов. На стенде утилита нашла четыре индекса документа без обращений, ручной дубль и два ручных индекса, которые повторяют начало служебных. После снятия флагов платформа вернула таблицу к трём служебным индексам, а данные и результаты запросов остались прежними. Перед снятием свойства проверьте, за какой срок накоплена статистика, и запустите редкие отчёты на копии базы.
Источники
- PostgreSQL 17, представления статистики pg_stat_all_indexes и pg_stat_user_indexes
- PostgreSQL 17, многоколонночные индексы и порядок колонок
- PostgreSQL 17, HOT-обновления (Heap-Only Tuples)
- Infostart, «Структура базы на PostgreSQL» (соответствие метаданных и таблиц, размеры индексов)
- Infostart, «Структура хранения данных и рекомендации по индексам» (размер таблиц и индексов, статистика, неиспользуемые индексы)
- Infostart, «Восстановление индексов СУБД» (создание индексов по структуре хранения базы 1С)
Файл к статье
Архив postgresql-index-audit-companion.zip (стенд от 22.10.2026):
index_auditor.py- утилита, командыcollectиaudit, только стандартная библиотека Python;queries/collect_indexes.sql- выгрузка индексов со статистикой;bench_write_cost.sqlиhot_update_check.sql- опыты на PostgreSQL;1c/StorageStructure.bsl- выгрузка структуры хранения базы 1С;examples- выгрузки со стенда (три состояния базы) и файлы конфигурации с флагами;verify.pyиtest_index_auditor.py- 15 тестов логики и 15 проверок на выгрузках;stand- модуль стенда, нагрузка, вариант конфигурации с лишними индексами;evidence- журналы прогона.
Архив проверен из чистой распаковки: python verify.py проходит без базы и платформы. README.md описывает порядок работы с вашей базой.

Вступайте в нашу телеграмм-группу Инфостарт

