Выгрузка конфигурации в XML за 35 секунд, и каждый байт совпадает
Интеграция - Файловый обмен (TXT, XML, DBF), FTP
Кофе даже не успевает остыть
Кто хранит конфигурацию в git, гоняет проверки в CI или работает в EDT, знает эту паузу. Нужна выгрузка в XML - запускаешь, идёшь за кофе, возвращаешься, а она ещё идёт. На типовой Бухгалтерии это больше четырёх минут: сначала загрузить файл конфигурации в базу, потом выгрузить из базы.
Я написал свой движок, который читает файл конфигурации напрямую, без базы, и выгружает его в XML. На той же Бухгалтерии это 35 секунд. Результат совпадает с выгрузкой платформы байт в байт, все 90 385 файлов. Ниже - цифры, как удалось ускорить, как проверяли и что неожиданного нашлось по дороге. В конце - несколько вопросов к вам: хочу понять, нужно ли это кому-то, кроме меня.
Откуда вообще взялся движок, я рассказывал на Хабре в статье "Я просто хотел тёмную тему". Коротко: хотел тёмную тему в среде разработки, а пришлось научиться читать файл конфигурации.
Цифры
Мерил на типовой Бухгалтерии предприятия 3.0.171.23: файл 1,02 ГБ, почти 15 тысяч объектов верхнего уровня, 90 385 файлов в выгрузке. Ryzen 5 7500F (6 ядер), 64 ГБ памяти, SATA SSD, Windows 11, платформа 8.5.1.1529.
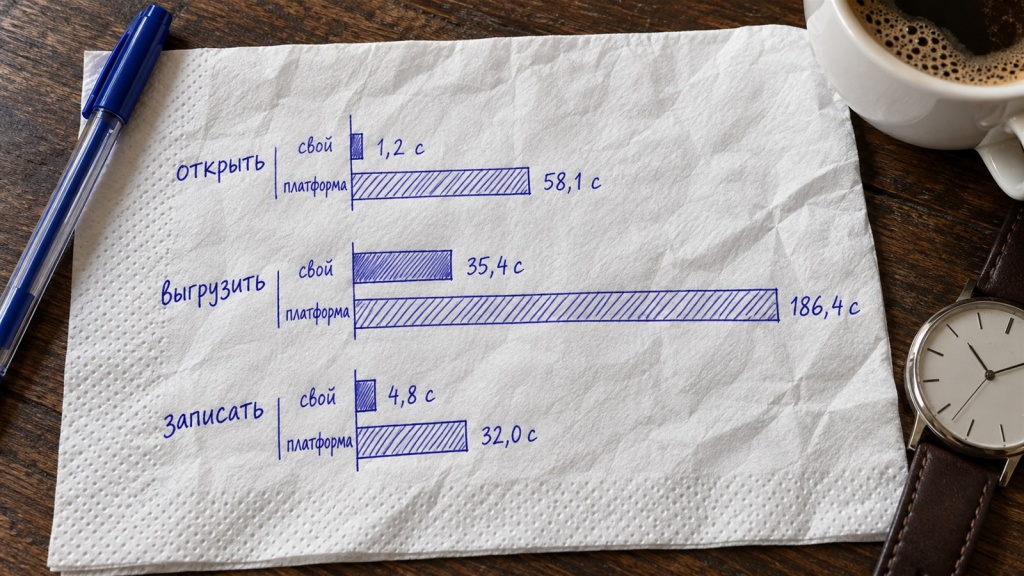
Открыть файл - в 48 раз быстрее, выгрузить всё в XML - в 5,3 раза, поменять свойство и записать файл - в 6,7 раза
У движка в таблице медиана трёх прогонов, у платформы - один прогон каждой команды (они долгие, и базу каждый раз надо создавать заново). Время - процесс целиком: запуск, чтение файла, запись результата. Во время замера на машине шли другие сборки, без них выгрузка всей Бухгалтерии занимает 32 секунды.
Сравнение не совсем честное, и лучше сказать это сразу. Платформа работает с конфигурацией только через базу: чтобы открыть файл, его надо загрузить в базу, чтобы получить файл - сохранить из базы. Движку база не нужна, он читает и пишет сам файл. Поэтому "открыть" я сравниваю с загрузкой в базу, а "записать" - с сохранением из базы. Если база у вас уже есть и конфигурация в ней свежая, платформе остаётся только выгрузка, и разница - те самые пять раз.
Почему так быстро
Чудес нет, есть три обычные вещи.
Работа по ядрам. Объекты верхнего уровня выгружаются независимо друг от друга, так что их можно раздать по потокам. Тут же вылезла первая мелочь: один большой регламентированный отчёт выгружается три-пять секунд, и если он попадает в очередь последним, все потоки уже свободны, а он один держит конец выгрузки. Поэтому крупные объекты раздаются первыми - размер оцениваем по сжатому объёму их записей. Сам переход на потоки дал больше всего: было 3 минуты 58 секунд, стало 32 секунды.
Ничего не делать дважды. Индексы имён строятся один раз на всю выгрузку, а не на каждый объект. Созданные каталоги запоминаются, чтобы не спрашивать у диска, есть ли они уже.
Один квадратичный обход. Табличные документы (макеты) поначалу записывались так: на каждый номер строки перебирались все строки. На мелких макетах незаметно, а у Бухгалтерии есть макеты на тысячи строк. Поиск строки по номеру через таблицу вместо перебора: было 68 секунд процессорного времени только на макеты, стало 17.
Открытие файла ускорено так же: описания объектов разбираются параллельно, а вставляются в дерево в прежнем порядке, чтобы дерево не зависело от того, какой поток успел первым.
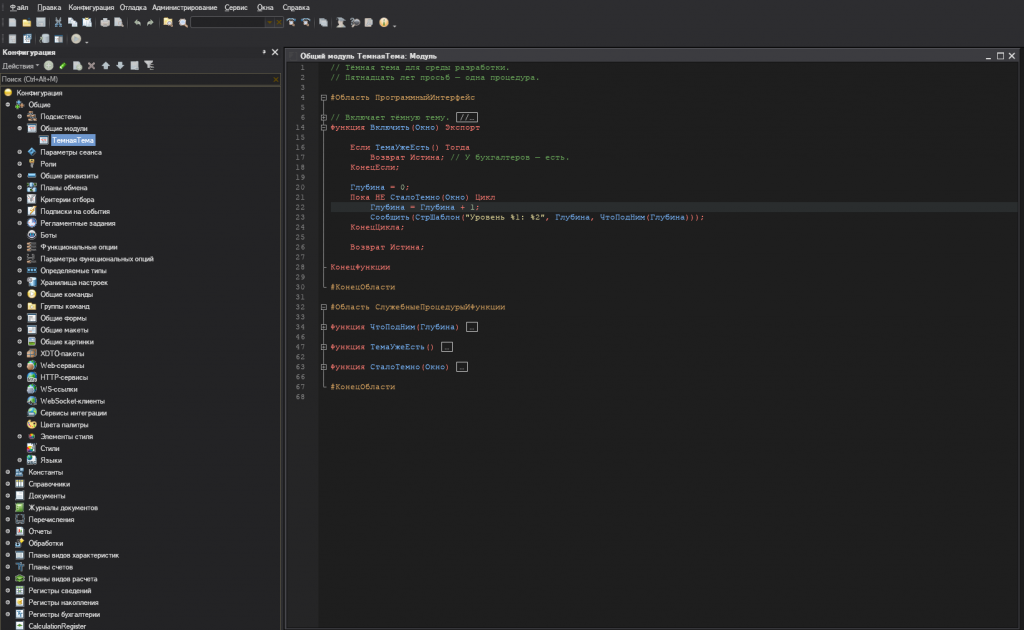
Открытый файл в окне движка: дерево, модуль, свойства. Конфигурация на снимке демонстрационная
Как проверяем, что это та же выгрузка
Быстро выгрузить что-то похожее - несложно. Сложно выгрузить то же самое. Правило у меня одно: без потерь или ошибка.
После каждого изменения вся Бухгалтерия выгружается заново и сравнивается с выгрузкой платформы файл за файлом, байт за байтом. Не "по смыслу то же", а именно байты: порядок элементов, пробелы, переводы строк. Сейчас совпадают 90 385 из 90 385 файлов.
Сама сверка поначалу шла 13 минут, и это быстро стало главным тормозом: проверять хочется после каждой правки. Файлы теперь читаются по потокам, и сверка занимает 2 минуты 17 секунд.
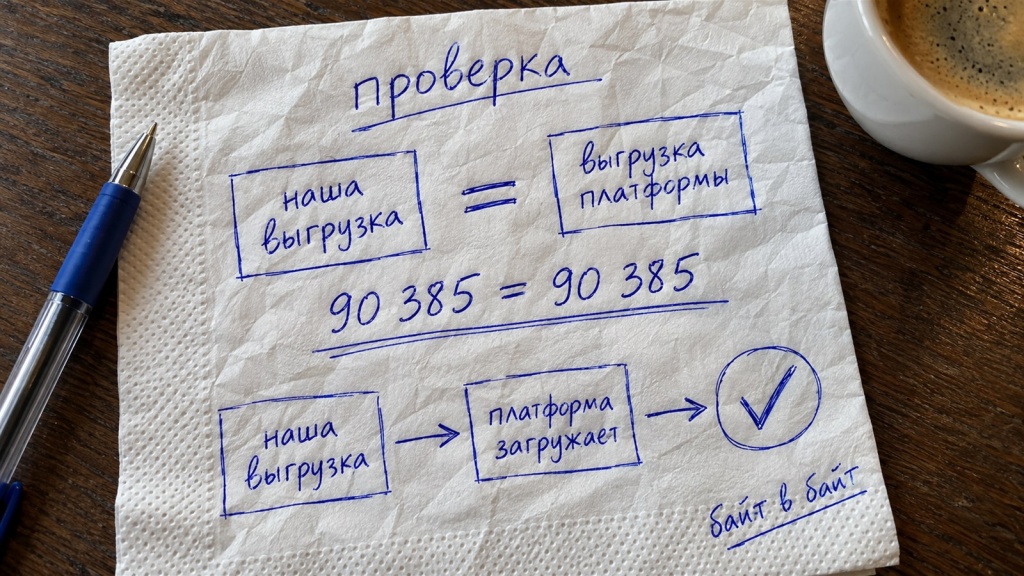
Проверка в обе стороны
Самым неприятным местом оказался порядок. В нескольких видах объектов элементы в выгрузке идут не по алфавиту, не по идентификатору и не в порядке объявления. Оказалось, платформа складывает их в хэш-таблицу и выгружает в порядке её обхода. Чтобы совпасть байт в байт, пришлось повторить устройство этой хэш-таблицы: число корзин, правило роста, хэш строки. Подробно я писал об этом в статье на Хабре.
Обратная дорога: загрузка из XML
Выгрузка без загрузки - половина дела: для git и CI нужно уметь собрать файл конфигурации обратно.
С загрузкой правило строже. Движок обязан понять каждый элемент и каждый атрибут XML. Если хоть что-то не понял, файл конфигурации не пишется вообще, а в отчёте - список отказов с причинами. Молча пропущенный флажок в одной форме - это потом чья-то сломанная конфигурация и испорченная пятница.
Позавчера отказов было почти пять тысяч. Сегодня загрузка Бухгалтерии проходит целиком: 7 573 формы, 77 266 записей, ноль отказов. Небольшая конфигурация клиента ЭДО тоже выгружается и загружается полностью.
Проверка загрузки идёт через платформу, по кругу:
- Движок собирает файл конфигурации из выгрузки.
- Платформа загружает этот файл в базу.
- Платформа выгружает его обратно в XML.
- Сравниваем с выгрузкой, которую платформа делает сама.
Совпадают 90 385 из 90 385 файлов.
По скорости загрузка пока не выигрывает: около четырёх минут, примерно как у платформы (загрузка XML в базу и сохранение файла - 229 секунд). Загрузка пока идёт в один поток, выгрузка и открытие - по ядрам. Ускорять её буду следующей.
Что теряет сама платформа
Самая неожиданная находка - на четвёртом шаге круга. Сначала я сравнивал результат с исходной выгрузкой и получал 26 расхождений. Искал ошибку у себя - не нашёл. Тогда загрузил исходный XML в базу самой платформой, выгрузил обратно, и получил те же 26 расхождений.
То есть часть данных при загрузке XML теряет или меняет сама платформа. Примеры:
- у плана обмена без поля даты обмена платформа добавляет его при загрузке, и порядок полей в выгрузке становится другим;
- у поля табличного документа теряется вид указателя;
- у поля PDF значение "None" в положении строки состояния после загрузки читается как другое значение.

Ведро с дырочкой: 26 файлов меняются ещё до того, как за дело берётся наш движок
Вывод для всех, кто строит проверки на круге "выгрузили - загрузили - выгрузили": сравнивать надо не с исходной выгрузкой, а с кругом, который сделала сама платформа. Иначе её собственные потери будут выглядеть как ваши ошибки.
Что взять себе
Даже если движок вам не нужен, вот что пригодилось бы в любом похожем проекте:
- Мерить процесс целиком. Запуск, чтение, запись - всё, что ждёт человек. Медиана нескольких прогонов, а если на машине что-то ещё работает, так и написать.
- Сравнивать байты. "По смыслу то же" прячет ошибки, которые потом всплывут в чужой конфигурации.
- Крупное - первым. При раздаче работы по потокам самый долгий кусок не должен оказаться в конце очереди.
- Искать квадратичные обходы. Один перебор внутри перебора съедал три четверти времени на макетах.
- Проверять эталон. Прежде чем чинить расхождение у себя, прогнать тот же круг платформой.
Что дальше
Пока это инструмент одного человека. Полностью, в обе стороны, он проверен на Бухгалтерии и клиенте ЭДО. На других конфигурациях расхождения ещё бывают: на Управлении торговлей 11.5 около сотни файлов выгрузились с ошибкой, потому что там встречаются вещи, которых в Бухгалтерии нет. Такие файлы движок должен отвергать с причиной, а не выгружать неверно, - это я тоже чиню.
Ни код, ни программу пока не выкладываю: сначала хочу понять, кому это нужно и в каком виде.
Вопросы к вам:
- Пользовались бы вы выгрузкой и загрузкой из командной строки в CI вместо платформы?
- Что нужнее: командная строка, библиотека или окно для просмотра и быстрой правки рядом со штатной средой?
- На какой конфигурации проверить следующей? Назовите конфигурацию и версию: типовые прогоню сам и напишу в комментариях, сколько файлов совпало.
Пишите в комментариях.
Изображение для анонса создано нейросетью.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

