Из 90 запросов, которые три нейросети написали по памяти к типовой УТ 11.5, 35 упали с ошибкой выполнения. Меня беспокоят не они. Ошибку платформа показывает сразу, с номером строки, и чинится она за минуту. Беспокоят 12 запросов, которые выполнились без единого замечания и вернули не те строки. Проверять запрос нейросети на то, выполнится ли он, почти бесполезно: ошибка выполнения это лучшее, что с таким запросом может случиться.
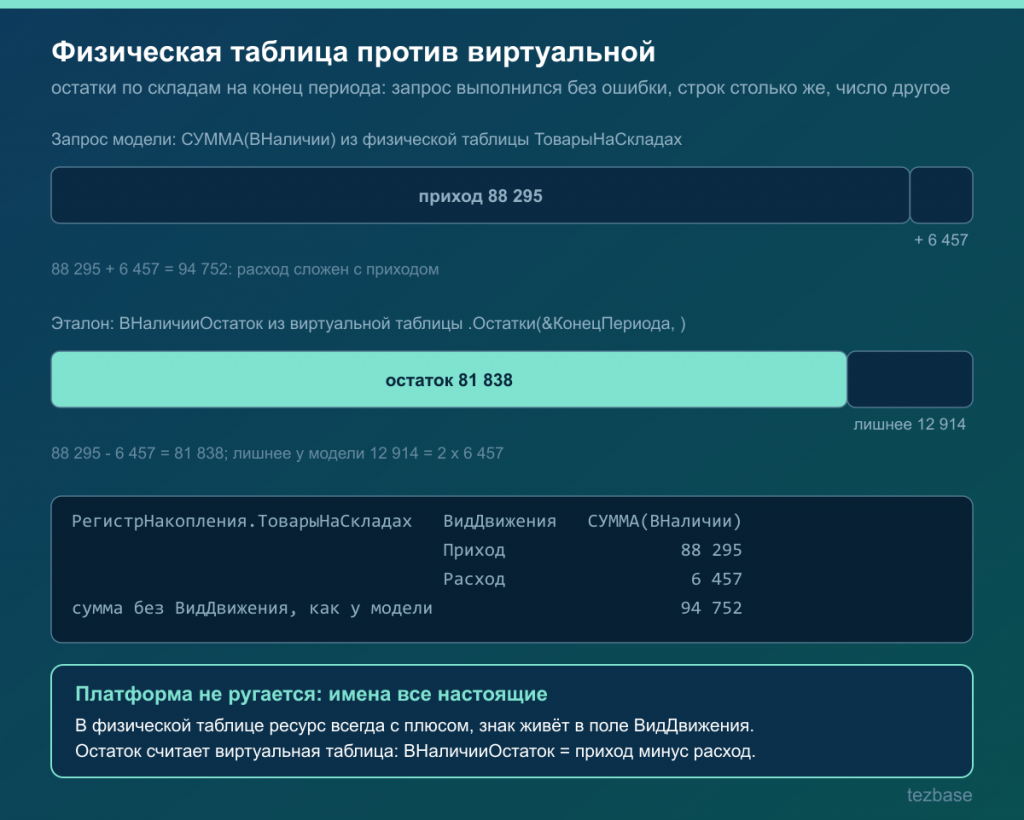
Вот как выглядит худший случай. Задание: остатки товаров в наличии на конец периода по складам. Запрос младшей модели выполнился за доли секунды и вернул одну строку: склад, 2 898 позиций, 94 752 штуки в наличии. Правильный ответ 81 838. Число строк совпало, число позиций совпало, сумма правдоподобная. Разница в 12 914 штук ровно в два раза больше расхода за период: модель сложила приход с расходом вместо того, чтобы вычесть.
Чтобы такие вещи ловить не глазами, я собрал стенд: 30 заданий на языке запросов к типовой УТ, у каждого эталонный запрос. Запрос модели выполняется на базе, результат сверяется с эталоном построчно. Ниже что показал прогон трёх моделей, где они ошибаются и почему описание метаданных в промпте помогло не всем.
Почему этот запрос не ловится глазами
Вот что написала модель на задание про остатки:
ВЫБРАТЬ
	ТоварыНаСкладах.Склад КАК Склад,
	КОЛИЧЕСТВО(РАЗЛИЧНЫЕ ТоварыНаСкладах.Номенклатура) КАК КоличествоПозиций,
	СУММА(ТоварыНаСкладах.ВНаличии) КАК ВНаличии
ИЗ
	РегистрНакопления.ТоварыНаСкладах КАК ТоварыНаСкладах
ГДЕ
	ТоварыНаСкладах.Период <= &КонецПериода
	И ТоварыНаСкладах.ВНаличии <> 0
СГРУППИРОВАТЬ ПО
	ТоварыНаСкладах.Склад
Имена все настоящие: регистр есть, ресурс ВНаличии есть, склад и номенклатура есть. Запрос читается как рабочий. Ошибка в модели данных: в физической таблице регистра накопления ресурс всегда положительный, а знак живёт в поле ВидДвижения. Приход 88 295 и расход 6 457 лежат в одной колонке с плюсом, и сумма по ней даёт 94 752. Остаток считает виртуальная таблица:
ВЫБРАТЬ
	О.Склад КАК Склад,
	КОЛИЧЕСТВО(РАЗЛИЧНЫЕ О.Номенклатура) КАК КоличествоПозиций,
	СУММА(О.ВНаличииОстаток) КАК ВНаличии
ИЗ
	РегистрНакопления.ТоварыНаСкладах.Остатки(&КонецПериода, ) КАК О
ГДЕ
	О.ВНаличииОстаток <> 0
СГРУППИРОВАТЬ ПО
	О.Склад
Остатки на конец периода: запрос модели по физической таблице и эталон по виртуальной
На живой базе с годами движений такая ошибка раздула бы остаток в разы, и её, наверное, заметили бы. Здесь она 16 %, и на базе, где движений пока мало, прячется в правдоподобном числе. Тот же приём модель повторила в задании про остатки по организациям и получила те же 94 752 вместо 81 838.
Отсюда главное правило стенда: сверяются значения строк с эталоном. То, что запрос выполнился, и число строк ничего не доказывают.
Как устроен стенд
Стенд это внешняя обработка на управляемых формах и файл с заданиями. Заданий 30, они покрывают то, на чём спотыкаются чаще всего: справочники и их реквизиты, перечисления и ПРЕДСТАВЛЕНИЕ, срезы периодического регистра, виртуальные таблицы остатков и оборотов, ключи аналитики в регистрах продаж, табличные части документов, соединения, строковые функции. У каждого задания три части:
- текст задачи обычными словами, как её поставил бы бухгалтер или аналитик: "сколько позиций номенклатуры имеют больше одного штрихкода";
- имена колонок результата, чтобы было с чем сверять: "Количество (число)";
- эталонный запрос, который я проверил на базе.
Параметров два, &НачалоПериода и &КонецПериода, их стенд подставляет сам из полей формы. Промпт стенд собирает тоже сам: правила ответа плюс все задания. Его можно скопировать в любой чат, а ответ вставить обратно. Второй путь для тех, у кого модель стоит локально или доступна по адресу: стенд отправляет задания по одному на OpenAI-совместимый адрес (Ollama, LM Studio, облачный сервис) и собирает ответ сам.
Сверка идёт так. Стенд выполняет эталон и запрос модели на одной базе с одними параметрами. Колонки ищет по именам из задания, а если модель назвала их иначе, но число колонок совпало, сверяет по порядку. Порядок строк не важен. Числа сравниваются с округлением до двух знаков, NULL в числовой колонке считается нулём. Если эталон отдаёт значение типа Строка, а модель ссылку, ссылка сравнивается своим представлением. Строки сравниваются как мультимножество: каждая строка модели должна найти себе пару в эталоне, и лишних быть не должно.
Статусов пять: "верно", "не те строки", "ошибка" с текстом ошибки платформы, "нет ответа" и "эталон не выполнился". Последний нужен для чужих баз: на релизе, где нет какого-то регистра, падает уже эталон, и такое задание в счёт ошибок модели не идёт.
Прежде чем мерить модели, я проверил сам стенд тремя прогонами. Эталоны, поданные как ответ, дают 30 верных из 30. Ответ без запросов даёт 30 "нет ответа". Набор с намеренной порчей (старый регистр цен вместо нового, перечисление строкой, снятый отбор групп, опечатка в СГРУППИРОВАТЬ) ловится ровно на испорченных заданиях. Ещё две правки в том же наборе, ссылка вместо представления и колонки под другими именами, проходят как верные, так задуманы правила сверки. Проверка, которая всегда говорит "верно", ничего не проверяет, поэтому отрицательный контроль здесь обязателен.
Результат трёх моделей
Это не рейтинг моделей: одна база, тридцать заданий, один прогон. Модели здесь нужны, чтобы было на чём показать, какие ошибки стенд ловит. Я взял три модели одного семейства разного размера, дальше называю их старшей, средней и младшей: Claude Opus 5.5, Claude Sonnet 5 и Claude Haiku 4.5. Каждая отвечала в отдельном сеансе только по тексту промпта, открывать базу, другие файлы и интернет ей было запрещено. Второй прогон шёл с флажком "с описанием объектов": к каждому заданию стенд дописывает реквизиты, измерения, ресурсы и табличные части нужных объектов прямо из метаданных базы, с типами. Это примерно то, что модель получает, когда её подключают к базе через MCP (Model Context Protocol, протокол, по которому нейросеть получает данные и инструменты из внешних программ).
База: УТ 11.5.22 с тестовыми продажами за июнь-август 2026 года, период замера 01.06.2026-31.08.2026.
| Модель | Промпт | Выполнились без ошибки | Вернули верные строки | Выполнились, но строки не те | Ошибка выполнения |
|---|---|---|---|---|---|
| Opus 5.5 | только задания | 25 | 25 | 0 | 5 |
| Opus 5.5 | с описанием объектов | 26 | 26 | 0 | 4 |
| Sonnet 5 | только задания | 17 | 10 | 7 | 13 |
| Sonnet 5 | с описанием объектов | 29 | 26 | 3 | 1 |
| Haiku 4.5 | только задания | 13 | 8 | 5 | 17 |
| Haiku 4.5 | с описанием объектов | 10 | 9 | 1 | 20 |
Каждая пара "модель и промпт" прогнана один раз. Ответы модели от раза к разу меняются, поэтому разницу в один-три запроса я за эффект не считаю. Уверенно видна только разница у средней модели: 10 верных против 26.
У старшей модели нет ни одного тихого промаха: всё, что выполнилось, вернуло верные строки. Все пять ошибок у неё одной природы, о ней ниже. У двух младших без описания объектов на каждые два-три выполнившихся запроса приходится один с неверными данными. Именно эти запросы и опасны: они молча подставляют правдоподобное число в отчёт.
Описание объектов сработало совсем по-разному. Средней модели оно дало больше всех: верных стало 26 вместо 10, ошибок одна вместо 13. Старшей почти ничего, её ошибки были не про имена. Младшей не помогло: выполнилось меньше, ошибок стало больше, верных на один больше. Разбор, почему так, ниже в разделе про гипотезы.
Что модели путают в типовой
Имена, которые звучат правильно
Самый массовый класс. Модель знает, как устроена УТ "в целом", и достраивает имя по аналогии: реквизит пользователя Недействительный вместо Недействителен, регистр ВыручкаСебестоимостьПродаж без "И", реквизит вида цен Валюта вместо ВалютаЦены. Средняя модель уверенно пишет ресурс Количество у регистра "Товары на складах", где он называется ВНаличии, и на этом одном имени теряет семь заданий про остатки и обороты:
ВЫБРАТЬ
	ОстаткиТоваровНаСкладах.Склад КАК Склад,
	КОЛИЧЕСТВО(РАЗЛИЧНЫЕ ОстаткиТоваровНаСкладах.Номенклатура) КАК КоличествоПозиций,
	СУММА(ОстаткиТоваровНаСкладах.КоличествоОстаток) КАК ВНаличии
ИЗ
	РегистрНакопления.ТоварыНаСкладах.Остатки(&КонецПериода, ) КАК ОстаткиТоваровНаСкладах
ГДЕ
	ОстаткиТоваровНаСкладах.КоличествоОстаток <> 0
СГРУППИРОВАТЬ ПО
	ОстаткиТоваровНаСкладах.Склад
Такие ошибки безобидны: платформа отвечает "Поле не найдено" с указанием места. Хуже, когда выдуманное имя существует. В УТ 11.5 два регистра цен: старый ЦеныНоменклатуры и новый ЦеныНоменклатуры25, куда цены пишутся в свежих релизах. Обе младшие модели взяли старый. Запрос выполнился, срез последних вернул ноль строк, и в отчёте было бы "цен нет" при 28 938 позициях с ценами в новом регистре. Структура базы тут не спасает: в метаданных есть оба регистра, и по ним не видно, какой заполнен. Средняя модель с описанием объектов исправила почти всё, кроме этого: три её тихих промаха из трёх как раз задания про цены. Старшая модель с описанием объектов читала оба регистра через ОБЪЕДИНИТЬ ВСЕ. На базе, где заполнен один из них, это работает, и стенд засчитал ответ верным. На базе, где заполнены оба, такой запрос смешал бы старые цены с новыми: стенд прав про свою базу и ничего не говорит про вашу.
Ключи аналитики вместо номенклатуры
В регистре "Выручка и себестоимость продаж" нет измерения Номенклатура и нет измерения Партнер. Есть АналитикаУчетаНоменклатуры и АналитикаУчетаПоПартнерам, ссылки на справочники ключей, у которых номенклатура и партнёр лежат реквизитами. Правильная группировка идёт через точку: Выр.АналитикаУчетаНоменклатуры.Номенклатура. Средняя модель писала ВыручкаИСебестоимостьПродаж.Номенклатура напрямую и заодно придумала отбор по перечислению ВидыСебестоимостиПродаж, которого в типовой нет. Без описания объектов ни одна из двух младших моделей не решила ни одного из четырёх заданий по регистру продаж. С описанием средняя решила все четыре: в описании регистра видно, что АналитикаУчетаНоменклатуры имеет тип Справочник.КлючиАналитикиУчетаНоменклатуры, и дальше модель сама дошла до точки.
Виртуальные таблицы
Сюжет с остатками из начала статьи не единственный. Приход и расход по складам младшая модель тоже считала по физической таблице, но на этот раз с разбором вида движения: ВЫБОР КОГДА ВидДвижения = "Приход". Платформа это не пропустила: вид движения это значение системного перечисления, со строкой его не сравнить. Здесь падение снова спасло.
Интереснее, что сделало описание метаданных. В описании у регистра остатков перечислены ресурсы ВНаличии и КОтгрузке и отдельной строкой виртуальные таблицы. Младшая модель взяла имя ресурса буквально и поставила его в виртуальную таблицу:
ВЫБРАТЬ
	Остатки.Склад КАК Склад,
	КОЛИЧЕСТВО(РАЗЛИЧНЫЕ Остатки.Номенклатура) КАК КоличествоПозиций,
	СУММА(Остатки.ВНаличии) КАК ВНаличии
ИЗ
	РегистрНакопления.ТоварыНаСкладах.Остатки(&КонецПериода, ) КАК Остатки
ГДЕ
	Остатки.ВНаличии <> 0
СГРУППИРОВАТЬ ПО
	Остатки.Склад
У виртуальной таблицы остатков поле называется ВНаличииОстаток, у оборотов ВНаличииПриход и ВНаличииРасход. Без описания эта же модель писала запрос к физической таблице, он выполнялся и врал. С описанием она перешла на виртуальную таблицу, и запрос стал падать. Для пользователя это шаг вперёд, для счёта верных ответов нет.
Перечисления и ПРЕДСТАВЛЕНИЕ
Два задания проверяют одно и то же знание с двух сторон. В первом нужно отобрать товары по перечислению: правильно ЗНАЧЕНИЕ(Перечисление.ТипыНоменклатуры.Товар), младшая модель написала Перечисление.ТипыНоменклатуры.Товар без ЗНАЧЕНИЕ и получила "Поле не найдено". Во втором тип нужно вернуть строкой, как его видит пользователь. Правильно ПРЕДСТАВЛЕНИЕ(Н.ТипНоменклатуры), модель вызвала метод объекта прямо в запросе:
ВЫБРАТЬ
	Номенклатура.ТипНоменклатуры.Представление() КАК ТипНоменклатуры,
	КОЛИЧЕСТВО(*) КАК Количество
ИЗ
	Справочник.Номенклатура КАК Номенклатура
ГДЕ
	НЕ Номенклатура.ЭтоГруппа
	И НЕ Номенклатура.ПометкаУдаления
СГРУППИРОВАТЬ ПО
	Номенклатура.ТипНоменклатуры
Язык запросов методов объектов не знает, это синтаксическая ошибка. Опаснее обратный вариант, который стенд ловит при порче: сравнить перечисление со строкой "Товар". Такой запрос выполняется и возвращает ноль, потому что ссылка никогда не равна строке.
Диалект SQL поверх языка 1С
Когда модель не уверена, она переходит на SQL: СРЕДН вместо СРЕДНЕЕ, ДЛИНА вместо ДЛИНАСТРОКИ, ИМЕЯ вместо ИМЕЮЩИЕ, ПОРЯДОК ПО вместо УПОРЯДОЧИТЬ ПО, ПУСТАЯ(Артикул), НАЧАЛО МЕСЯЦА(Период). У младшей модели таких ошибок больше всего в режиме с описанием: длинный промпт с метаданными на сотню тысяч знаков, похоже, вытесняет из её внимания сам язык.
Псевдоним "В"
Все пять ошибок старшей модели одинаковые, четыре в заданиях по продажам и одна на справочнике видов цен:
ВЫБРАТЬ ПЕРВЫЕ 10
	В.АналитикаУчетаНоменклатуры.Номенклатура КАК Номенклатура,
	СУММА(В.КоличествоОборот) КАК Количество,
	СУММА(В.СтоимостьБезНДСОборот) КАК Себестоимость
ИЗ
	РегистрНакопления.ВыручкаИСебестоимостьПродаж.Обороты(&НачалоПериода, &КонецПериода, , ) КАК В
СГРУППИРОВАТЬ ПО
	В.АналитикаУчетаНоменклатуры.Номенклатура
УПОРЯДОЧИТЬ ПО
	Себестоимость УБЫВ
Модель правильно выбрала регистр, виртуальную таблицу, ключ аналитики и ресурс. И назвала таблицу "В", а это ключевое слово языка запросов (оператор В из "ГДЕ Ссылка В (...)"). Платформа отвечает "Ожидается имя" на месте псевдонима. С описанием объектов остались четыре по продажам: виды цен модель на этот раз назвала "ВЦ". Это случай, заслуги описания тут нет: оно подсказывает, что есть в базе, про ключевые слова языка в нём ничего.
Признаюсь, что на этой же ошибке споткнулся я сам. Когда я писал эталоны для заданий по продажам, я назвал регистр "В" в четырёх запросах подряд, и первый прогон эталонов упал ровно так же. Короткий псевдоним по первой букве таблицы кажется безопасным, пока таблица не начинается на И, В или ИЗ.
Гипотезы, которые не подтвердились
"Дать модели структуру базы, и она перестанет выдумывать". Я ждал, что описание объектов поднимет все три модели примерно одинаково. Вышло три разных ответа. Средняя модель выиграла больше всех: 26 верных вместо 10, потому что её ошибки были почти целиком про имена, а имена описание и даёт. Старшая получила 26 вместо 25: имена она знала и так, а её единственная ошибка, псевдоним "В", к метаданным отношения не имеет. Младшей лучше не стало: выполнилось 10 запросов вместо 13, ошибок 20 вместо 17, верных 9 вместо 8. Три запроса на одном прогоне могли бы оказаться и шумом, но поменялся характер ошибок: вместо выдуманных имён пошли SQL-слова и ресурсы без суффикса в виртуальных таблицах. Описание подсказывает имена. Правил языка в нём нет: что у виртуальной таблицы поля с суффиксом, что вид движения не строка, какой из двух регистров цен живой. А в сто тысяч знаков промпта маленькая модель, похоже, теряет даже то, что знала без него. Вывод для практики: подключать модели метаданные через MCP имеет смысл, но проверять после этого всё равно надо, и на своей модели: чужая таблица, включая эту, про вашу модель ничего не скажет.
"Хватит сверить число строк". Первой версией сверки я хотел сравнивать число строк и суммы по числовым колонкам. На заданиях 1-3 средняя модель вернула ровно столько строк, сколько эталон (две, одну и две), и ни одна из них не совпала. Задание про остатки вернуло одну строку при одной строке эталона и неверную сумму. Сверка по строкам целиком оказалась единственной, которая это видит.
"Эталон и есть истина". Средняя модель в первых трёх заданиях взяла тип номенклатуры через вид номенклатуры, минуя карточку. В тестовой базе там, где тип в карточке заполнен (7 803 позиции), он совпадает с типом вида во всех случаях. Но у 49 238 позиций тип в карточке пустой при заполненном виде, и числа разошлись. Стенд прав относительно этой базы, но ошибка модели здесь спорная. Если эти три задания не считать, тихих промахов у средней модели без описания 4 вместо 7, а по трём моделям 9 из 90 вместо 12. Отсюда граница инструмента: эталон проверен на данных, и если данные кривые, "не те строки" может означать и кривые данные при правильном запросе. Поэтому в стенде видны оба запроса рядом, эталон и ответ модели, и решение остаётся за человеком.
"Виртуальная таблица оборотов вернёт строку с нулём". Это моя ошибка при подготовке стенда. Первые задания по продажам считали выручку, и три из них вернули ноль строк. В тестовой базе выручка нулевая, а виртуальная таблица оборотов не отдаёт записи, где все выбранные ресурсы равны нулю. Пришлось перевести задания на себестоимость и количество, которые заполнены. Если будете писать свои задания, проверьте, что эталон на вашей базе вообще возвращает строки: пустой эталон стенд помечает как непоказательный.
Как запустить стенд у себя
Стенд выложен отдельной карточкой: "Стенд проверки запросов нейросети". В архиве обработка и файл заданий в JSON. Порядок такой:
- Откройте обработку в копии базы УТ 11.5. Запросы модели выполняются с вашими правами, и запрос без отборов по большой таблице может идти долго, поэтому рабочая база в разгар дня плохое место для замера.
- Задайте период так, чтобы в него попали продажи и движения. Эталоны считают ваши данные, и задание с пустым эталоном ничего не проверяет.
- Нажмите "Сформировать промпт", при желании с флажком "С описанием объектов", и отдайте текст модели. Ответ целиком вставьте на страницу "Ответ модели". Формат ответа модели стенд объясняет в самом промпте: строка "### номер", под ней запрос.
- Если модель стоит локально, укажите адрес, например http://localhost:11434/v1/chat/completions для Ollama, и нажмите "Спросить модель по всем заданиям". Стенд отправит задания по одному и сам соберёт ответ.
- "Проверить ответ". В таблице статус по каждому заданию, внизу текст задания, запрос модели и эталон рядом.
На релизах, где регистра ЦеныНоменклатуры25 ещё нет, четыре задания про цены получат статус "эталон не выполнился" и в счёт модели не пойдут. Задания хранятся на отдельной странице в JSON: можно добавить свои, например под доработки своей конфигурации, со своим эталоном. Сверка 30 заданий на тестовой базе занимала у меня от 0,5 до 1 секунды, первая после перерыва около 6 секунд.
В нашем замере локальной модели нет: на машине стоит Ollama, но без загруженной модели, а мерить по чужим таблицам я не хочу. Адрес по умолчанию в стенде указан как раз под неё, и это первое, что я прогоню следующим.
Другие наши инструменты
- Выгрузка метаданных для LLM - если нужно дать модели структуру своей конфигурации файлом, без подключения к базе.
- Выгрузка данных 1С для нейросети - когда в чат с моделью надо отдать сами данные: Markdown для чата, JSON для программ.
- Журнал регистрации, свёрнутый для нейросети - когда модели надо показать, что происходило в базе, а журнал в чат целиком не влезает.
- Локальная LLM на встроенном языке 1С - чтобы посмотреть, как модель устроена изнутри, на коде, который открывается в конфигураторе.
- Чек-ап СУБД под 1С - если запросы, хоть свои, хоть от модели, стали работать медленно, и надо понять, сервер это или база.
Вопрос
Если вы уже пускаете нейросеть писать запросы к своей базе, чем вы проверяете результат до того, как число попадёт в отчёт? Прогоните стенд на своей модели и напишите в комментариях, сколько вышло "выполнились, но строки не те": особенно интересны локальные модели и базы на свежих релизах УТ.
Вступайте в нашу телеграмм-группу Инфостарт