Заметочки про 1С:Предприятие 8 (редакция 22.06.2012)
Разработка - Механизмы платформы 1С




Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
| Наименование | Скачано | Купить файл | По подписке PRO |
|---|---|---|---|
|
КодВОднуСтроку.epf
.epf 7,47Kb
628
|
628 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 1
.epf 7,28Kb
1231
|
1231 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 2
.epf 8,52Kb
544
|
544 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 3 без оптимизации
.epf 9,72Kb
477
|
477 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 3 с оптимизацией
.epf 10,34Kb
467
|
467 | 2 500 руб. Купить | 1 SM Скачать |
|
Гостинец от Ish_2
.epf 9,91Kb
422
|
422 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 4
.epf 8,13Kb
449
|
449 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 5
.epf 7,78Kb
375
|
375 | 2 500 руб. Купить | 1 SM Скачать |
|
COM MONITOR
.epf 23,63Kb
369
|
369 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 6 для COM Monitor
.epf 271,79Kb
511
|
511 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 7
.epf 9,47Kb
294
|
294 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 8
.erf 13,23Kb
270
|
270 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 9
.erf 12,69Kb
247
|
247 | 2 500 руб. Купить | 1 SM Скачать |
|
Пример 10
.epf 10,76Kb
52
|
52 | 2 500 руб. Купить | 1 SM Скачать |
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
| Только качественный контент |

- Про циклы в одну строку
- Про быстрые массивы
- Про длинные строки
- Про типы данных. Динамическая настройка колонок табличного поля
- Про типы данных. Расчет сумм по выделенным ячейкам табличного поля
- Про хитрые запросы. Не стандартное использование итогов
- Про хитрые запросы. Тэта-соединения 1
- Про хитрые запросы. Тэта-соединения 2
- Про хитрые запросы. Тэта-соединения 3. Строки неограниченной длины
- Про пакетные запросы. Индексы во временных таблицах
- Про СКД и запросы с итогами
- Про дерево значений
- Про таблицу значений
- Про работу с COMОбъект("V81.Application") или как разогнать 1С в 1000 раз
- Про работу с НастройкаПериода, ЗаполнитьЗначенияСвойств и вообще
- Про итоги в регистрах накопления
- Про танцы с бубном
- Про использованные материалы
- Про Разукрашку
- Последний штрих
Если вы это всё уже знаете, то, пожалуйста, не кидайте в автора грязью. Танки грязи не боятся. 
Но всё-таки я надеюсь вас чем-нибудь удивить.
В подтверждение заметок описанных в статье прикладываю примеры и материалы. Всегда можно проверить.
Для вступления думаю достаточно. Начнем.
Первым номером нашей программы выступает код добавления (копирования) строк из одной таблицы значений в другую ТЗ или из одной табличной части в другую ТЧ. Ну, и т.д. Т.е. строки из обоих источников объединяются, совпадающие по имени колонки заполняются.
Для каждого СтрокаТЗ Из Таблица1 Цикл ЗаполнитьЗначенияСвойств(Таблица2.Добавить(), СтрокаТЗ) КонецЦикла;
Соответственно код добавления элементов из массива в массив будет такой.
Для каждого ЭлементМассива Из Массив1 Цикл Массив2.Добавить(ЭлементМассива) КонецЦикла;
Всего одна команда в цикле - что может быть проще?
Наверное, вы уже обратили внимание на запись циклов в одну строку. Так программный код выполняется несколько быстрее. Всё дело в том, что в строках есть дополнительные данные, которые используются, например, при отладке. Меньше строк - меньше дополнительных данных. Это прекрасно видно, если смотреть замер производительности в режиме отладки - цикл в строке Для из 10000 повторов записанный обычной структурой будет выполнен 10001 раз, а записанный в 1 строку будет выполнен 1 раз. Разумеется, что при этом результат выполнения программного кода будет абсолютно одинаковый, а вот время выполнения будет разное. Не верится? Смотрим "Пример 1".
Скачать Пример 1...
Следует заметить, что править такую форму записи очень сложно. Поэтому, если команды отрабатываются 1 раз, то нет особого смысла записывать их в 1 строку друг за другом.
Также "тонким" моментом будет использование команды ОбработкаПрерыванияПользователя(). Если в цикле, записанном в 1 строку, используется данная команда, то вероятность срабатывания прерывания выполнения программы по Ctrl+Break становится не четким. Ну, может за исключением тех случаев, когда в цикле кроме этой других команд нет.
Хочу сразу обратить ваше внимание на комментарии awa к этой статье. Всё сразу станет понятнее.
Обработку для сворачивания программного кода в 1 строку можно скачать здесь.
Теперь посмотрим что-нибудь простенькое. Например, разбор строки с разделителями в массив элементов. В типовых конфигурациях есть функция РазложитьСтрокуВМассивПодстрок(). Предлагаю рассмотреть альтернативное решение. Вот код для строковых значений.
// РазбираемаяСтрока - строка исходного текста
// Разделитель - разделитель элементов строки
ЗначениеИзСтрокиВнутр("{""#"",51e7a0d2-530b-11d4-b98a-008048da3034,{0,{""S"",""" + СтрЗаменить(СтрЗаменить(РазбираемаяСтрока, """", """"""), Разделитель, """},{""S"",""") + """}}}");
Вот код для числовых значений.
ЗначениеИзСтрокиВнутр("{""#"",51e7a0d2-530b-11d4-b98a-008048da3034,{0,{""N""," + СтрЗаменить(РазбираемаяСтрока, Разделитель, "},{""N"",") + "}}}");
Посмотреть, как это работает можно здесь, здесь и здесь.
В (150) комментарии к статье было высказано предположение, что данный метод не эффективен, поэтому был добавлен "Пример 7". Действительно, на коротких строках предложенное в (150) комментарии решение с разбором строки эффективнее, но сложнее в исполнении. Ещё более эффективное решение и ещё более сложное в исполнении читаем ниже...
Скачать Пример 7...
Так, так, так. А вот довольно шустренький программный код для сворачивания элементов массива. Результат записывается в НовыйМассив.
НовыйМассив = Новый Массив; Соответствие = Новый Соответствие;
Для каждого ЭлементМассива Из Массив Цикл Соответствие.Вставить(ЭлементМассива) КонецЦикла;
Для каждого КлючИЗначение Из Соответствие Цикл НовыйМассив.Добавить(КлючИЗначение.Ключ) КонецЦикла;
Для сравнения в "Пример 4" приведено 4 варианта реализации сворачивания массива: через массив, через таблицу значений, через соответствие и вариант, реализованный в типовых конфигурациях 1С. Поэкспериментируйте и выберите тот, что вам больше понравится.
Скачать Пример 4...
Если вдруг понадобится отсортировать элементы в массиве, то быстро это можно сделать так:
СписокЗначений = Новый СписокЗначений;
СписокЗначений.ЗагрузитьЗначения(Массив);
СписокЗначений.СортироватьПоЗначению();
Массив = СписокЗначений.ВыгрузитьЗначения();
В некоторых случаях больше подойдет сортировка не по значению, а по представлению.
Получить строку из пробелов нужной длины можно собирая пробелы в цикле. Но можно использовать следующую конструкцию:
// Получаем строку пробелов длиной 10000 символов
СтрокаПробелов = СтрЗаменить(Формат(0, "ЧЦ=100; ЧН=; ЧВН=; ЧГ="), "0",
СтрЗаменить(Формат(0, "ЧЦ=100; ЧН=; ЧВН=; ЧГ="), "0", " "));
Интересное наблюдение при работе со строками большой длины можно сделать в "Пример 5". Использование трехуровневой буферизации может дать ускорение в десятки и даже тысячи раз. Код может выглядеть так:
Данные = "";
Результат = "";
Результат1 = "";
Результат2 = "";
// Получаем Данные и записываем в Результат
Пока ПолучитьДанные(Данные) Цикл
Результат2 = Результат2 + Данные;
Если СтрДлина(Результат2) > 100 Тогда
Результат1 = Результат1 + Результат2;
Результат2 = "";
Если СтрДлина(Результат1) > 10000 Тогда
Результат = Результат + Результат1;
Результат1 = "";
КонецЕсли;
КонецЕсли;
КонецЦикла;
Результат = Результат + Результат1 + Результат2;
Конечно, и здесь цикл можно записать в одну строку, но это не сделано только для сохранения читаемости программного кода в статье.
Скачать Пример 5...
В (302) комментарии к статье приведен интересный код для разбора длинных текстовых строк, позволяющий проводить предварительную обработку данных, например, перед помещением их в массив. Применительно к задаче помещения данных в массив на больших объемах данных он работает конечно медленнее, чем код описанный в разделе Про быстрые массивы, но возможность предварительной обработки данных дорогого стоит. Предлагаю рассмотреть альтернативное решение без использования объекта ТекстовыйДокумент. Оно конечно сложнее в исполнении, но эффективнее в работе и также позволяет добавить предварительную обработку данных, например, перед помещением их в массив.
ДлинаСтроки = СтрДлина(РазбираемаяСтрока);
Если ДлинаСтроки > 1000 Тогда
// Порежем строку на блоки для более эффективного поиска
МассивСтрок = Новый Массив;
Индекс = 1;
Пока Индекс <= ДлинаСтроки Цикл
МассивСтрок.Добавить(Сред(РазбираемаяСтрока, Индекс, 1000));
Индекс = Индекс + 1000;
КонецЦикла;
мИсходныйКод = МассивСтрок[0];
ГраницаКода = МассивСтрок.ВГраница();
Иначе
мИсходныйКод = РазбираемаяСтрока;
ГраницаКода = 0;
КонецЕсли;
мСтрок = Новый Массив;
ИндексКода = 0;
ДлинаРазделителя = СтрДлина(Разделитель);
НеПоследняяСтрока = Истина;
Пока НеПоследняяСтрока Цикл
Позиция = Найти(мИсходныйКод, Разделитель);
Пока Позиция = 0 Цикл
Если ИндексКода = ГраницаКода Тогда
// Последний элемент
Позиция = СтрДлина(мИсходныйКод);
НеПоследняяСтрока = Ложь;
Прервать;
КонецЕсли;
ИндексКода = ИндексКода + 1;
мИсходныйКод = мИсходныйКод + МассивСтрок[ИндексКода];
Позиция = Найти(мИсходныйКод, Разделитель);
КонецЦикла;
мСтрок.Добавить(Лев(мИсходныйКод, Позиция));
мИсходныйКод = Сред(мИсходныйКод, Позиция + ДлинаРазделителя);
КонецЦикла;
Возврат мСтрок;
Посмотреть как это работает можно здесь и здесь.
Если вы подумали, что эта статья только об оптимизации производительности, то это не так. Статья об оптимизации производительности здесь, и не смотря на то, что статья посвящена 7.7, многие приемы оптимизации работают и в 8.х.
Про типы данных. Динамическая настройка колонок табличного поля
Иногда бывает нужно проверить тип данных какого-либо ревизита. Для типов данных без квалификаторов проверку типа данных легко сделать с помощью ОписаниеТипов. А вот для типов данных Число, Строка и Дата можно использовать другую конструкцию с использованием массива типов. Вот пример для динамической настройки табличного поля. В примере использованы оба способа сравнения типов.
ТипЧисло = Тип("Число");
ОписаниеТипаБулево = Новый ОписаниеТипов("Булево");
мВыводитьПодвал = Ложь;
ТабличноеПоле.СоздатьКолонки();
КолонкиИсточника = ТабличноеПоле.Значение.Колонки;
// Отобразим булево как галочки, а отрицательные числа красным
Для каждого КолонкаТЧ Из ТабличноеПоле.Колонки Цикл
ИмяКолонкиТЧ = КолонкаТЧ.Имя;
ТипЗначенияКолонки = КолонкиИсточника[ИмяКолонкиТЧ].ТипЗначения;
Если ТипЗначенияКолонки = ОписаниеТипаБулево Тогда
КолонкаТЧ.ДанныеФлажка = КолонкаТЧ.Данные;
КолонкаТЧ.Данные = "";
ИначеЕсли ИмяКолонкиТЧ <> "НомерСтроки" Тогда
МассивТипов = ТипЗначенияКолонки.Типы();
Если МассивТипов.Количество() = 1 и МассивТипов[0] = ТипЧисло Тогда
КолонкаТЧ.ВыделятьОтрицательные = Истина;
КолонкаТЧ.ОтображатьИтогиВПодвале = Истина;
КолонкаТЧ.ГоризонтальноеПоложениеВПодвале = ГоризонтальноеПоложение.Право;
мВыводитьПодвал = Истина;
КонецЕсли;
КонецЕсли;
КонецЦикла;
ТабличноеПоле.Подвал = мВыводитьПодвал;
К вопросу "Почему не воспользоваться методом СодержитТип?". Метод СодержитТип не дает однозначного ответа на вопрос "Какой тип реквизита?". Он только подтверждает, что реквизит может быть, например, числом. А если реквизит составного типа?
Как это работает можно посмотреть здесь.
Про типы данных. Расчет сумм по выделенным ячейкам табличного поля
В некоторых типовых конфигурациях 1С и публикациях в интернете используется очень удобный сервис "расчет сумм по выделенным ячейкам табличного поля". К сожалению все попавшие на глаза варианты реализации работают "неверно" при подсчете сумм по накладывающимся выделенным областям. При подсчете суммы из ячеек в персекающихся областях учитываются несколько раз.
Предлагаю простенькую функцию, в которой данный "эффект" устранен.
Функция РасчетСуммыПоЯчейкам(ТабличноеПоле) Экспорт
Сумма = 0;
КоличествоСумм = 0;
СоответствиеЯчеек = Новый Соответствие;
ОписаниеТипов = Новый ОписаниеТипов("Число");
Для Каждого ВыделеннаяОбласть Из ТабличноеПоле.ВыделенныеОбласти Цикл
Для Индекс1 = ВыделеннаяОбласть.Лево По ВыделеннаяОбласть.Право Цикл
Для Индекс2 = ВыделеннаяОбласть.Верх По ВыделеннаяОбласть.Низ Цикл
Область = ТабличноеПоле.Область(Индекс2, Индекс1, Индекс2, Индекс1);
Значение = ОписаниеТипов.ПривестиЗначение(Область.Текст);
СоответствиеЯчеек.Вставить(Область.Имя, Значение);
КонецЦикла;
КонецЦикла;
КонецЦикла;
Для каждого Ячейка Из СоответствиеЯчеек Цикл
Значение = Ячейка.Значение;
Если Значение <> 0 Тогда
Сумма = Сумма + Значение;
КоличествоСумм = КоличествоСумм + 1;
КонецЕсли;
КонецЦикла;
КоличествоВыделено = СоответствиеЯчеек.Количество();
Если КоличествоВыделено > 1 Тогда
ТекстИтогов = " Выделено ячеек: " + КоличествоВыделено
+ " Просуммировано ячеек: " + КоличествоСумм
+ " Итого по выделенным ячейкам: " + Сумма;
Иначе
ТекстИтогов = "";
КонецЕсли;
Возврат ТекстИтогов;
КонецФункции // РасчетСуммыПоЯчейкам()
Использование метода ПривестиЗначение вместо встречающегося в типовых конфигурациях преобразования через Попытка, дает в среднем ускорение на преобразовании типов в 4 раза. А использование отложенного вызова функции расчета суммы всего лишь на 0.2 секунды с легкостью решает проблему с задержками при выделении пользователем большого количества ячеек.
Посмотреть как это работает можно здесь и здесь.
Ещё про работу с типами данных можно почитать ниже...
Про хитрые запросы. Не стандартное использование итогов
А что сейчас? А сейчас запросы. Не все конечно, а несколько каких-нибудь простеньких и интересненьких. Например, построение запросом двухуровневого дерева структуры задолженности для формы элемента справочника Контрагенты. Исходим из того, что чем меньше команд, тем быстрее работает. Ну, обычно быстрее. Ведь 1С это все-таки интерпретатор.
Итак, строим запросом дерево по структуре задолженности как на картинке ниже, смотрим закладку Задолженность. На закладке добавлено табличное поле с деревом значений Задолженность.

Получаем в детальных строках договоры контрагентов, а в итоговых строках организации. Приведенный ниже в качестве примера программный код будет работать в УТ и УПП. Для остальных конфигураций код запроса нужно немного подправить.
Запрос = Новый Запрос(
"ВЫБРАТЬ РАЗРЕШЕННЫЕ
| ДоговорыКонтрагентов.Организация КАК Организация,
| ДоговорыКонтрагентов.Ссылка КАК СтруктураДоговоров,
| -ЕСТЬNULL(ВзаиморасчетыОстатки.СуммаВзаиморасчетовОстаток, 0) КАК Сумма
|ИЗ
| Справочник.ДоговорыКонтрагентов КАК ДоговорыКонтрагентов
| ЛЕВОЕ СОЕДИНЕНИЕ РегистрНакопления.ВзаиморасчетыСКонтрагентами.Остатки(
| , Контрагент = &Контрагент) КАК ВзаиморасчетыОстатки
| ПО ДоговорыКонтрагентов.Ссылка = ВзаиморасчетыОстатки.ДоговорКонтрагента
|ГДЕ
| ДоговорыКонтрагентов.Владелец = &Контрагент
|
|УПОРЯДОЧИТЬ ПО
| Организация,
| СтруктураДоговоров
|ИТОГИ
| Организация КАК СтруктураДоговоров,
| СУММА(Сумма)
|ПО
| Организация");
Запрос.УстановитьПараметр("Контрагент", Ссылка);
Задолженность = Запрос.Выполнить().Выгрузить(ОбходРезультатаЗапроса.ПоГруппировкам);
Получилось простенько и симпатично.
В итогах Организация используется без агрегатной функции - это возможно потому, что по Организации выполняется группировка. Ещё примеры построения двухуровневого дерева можно посмотреть здесь.
Про хитрые запросы. Тэта-соединения 1
Кажется тема с запросами получилась интересной. Тогда ещё один примерчик "Пример 2", который можно подержать в руках - изменение курсов валют с группировкой по месяцам.

Запрос = Новый Запрос(
"ВЫБРАТЬ РАЗРЕШЕННЫЕ
| КурсыВалют.Период КАК Период1,
| МАКСИМУМ(ЕСТЬNULL(КурсыВалют1.Период, КурсыВалют.Период)) КАК Период2
|ПОМЕСТИТЬ Соединения
|ИЗ
| РегистрСведений.КурсыВалют КАК КурсыВалют
| ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.КурсыВалют КАК КурсыВалют1
| ПО КурсыВалют.Валюта = КурсыВалют1.Валюта
| И КурсыВалют.Период > КурсыВалют1.Период
| И (КурсыВалют1.Валюта = &Валюта)
|ГДЕ
| КурсыВалют.Валюта = &Валюта
|
|СГРУППИРОВАТЬ ПО
| КурсыВалют.Период
|;
|
|////////////////////////////////////////////////////////////////////////////////
|ВЫБРАТЬ РАЗРЕШЕННЫЕ
| КурсыВалют.Период КАК Период,
| НАЧАЛОПЕРИОДА(КурсыВалют.Период, МЕСЯЦ) КАК ПериодДляИтогов,
| КурсыВалют.Курс,
| КурсыВалют.Курс - КурсыВалют1.Курс КАК ИзменениеКурса
|ИЗ
| РегистрСведений.КурсыВалют КАК КурсыВалют
| ВНУТРЕННЕЕ СОЕДИНЕНИЕ Соединения КАК Соединения
| ВНУТРЕННЕЕ СОЕДИНЕНИЕ РегистрСведений.КурсыВалют КАК КурсыВалют1
| ПО Соединения.Период2 = КурсыВалют1.Период
| И (КурсыВалют1.Валюта = &Валюта)
| ПО КурсыВалют.Период = Соединения.Период1
| И (КурсыВалют.Валюта = &Валюта)
|ИТОГИ
| ПериодДляИтогов КАК Период,
| СУММА(ИзменениеКурса)
|ПО
| ПериодДляИтогов");
Запрос.УстановитьПараметр("Валюта", Валюта);
КурсыВалют = Запрос.Выполнить().Выгрузить(ОбходРезультатаЗапроса.ПоГруппировкам);
Аналогично можно построить и другие запросы, в которых отслеживается изменение значений показателей, например, изменение цен.
Скачать Пример 2...
Про хитрые запросы. Тэта-соединения 2
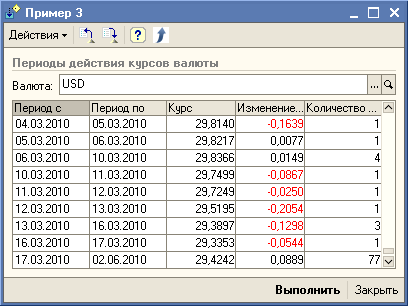
"Продолжаем разговор". В качестве ещё одного примера работы с запросами добавлен "Пример 3", в котором реализовано получение периодов действия установленных значений периодических регистров сведений. Перечитал предыдущее предложение - получилось немного тяжеловато, ну, да ладно. Предложенное решение в "Пример 3" может быть использовано, например, при решении задач по расчету заработной платы или при начислениях в ЖКХ.
Фишка этого запроса в том, чтобы убрать повторяющиеся данные из цепочки, а оставить только точки перехода с датами, когда данный переход был выполнен.
Т.е. для цепочки значений 0, 0, 1, 1, 1, 0, 0, 0, 1
должны остаться только значения 0, 1, 0, 1 и соответственно даты, когда значения в цепочке поменялись.
И несколько слов об оптимизации тэта-соединений. Во вложении 3 варианта реализации с использованием запросов, поэтому в статье текстов этих запросов нет - очень объемно получается. При больших объемах информации оптимизированный вариант запросов дает значительное ускорение, особенно в файловой версии. Это собственно и не удивительно, оптимизатор SQL сервера делает своё дело. Автором одного из вариантов является Ish_2 - это вариант "Гостинец".
Скачать Пример 3 без оптимизации...
Скачать Пример 3 с оптимизацией...
Скачать Гостинец от Ish_2...
Суть оптимизации сводится к уменьшению количества записей используемых в соединениях, аналогами которых являются нарастающие итоги. Подробнее про подобный подход можно почитать здесь.
Также интересный эффект получается при использовании индексов для временных таблиц. Попробуйте поиграть с объемами данных и галочками "Использовать индексы в запросе". Обещаю весьма неожиданный результат.
Так уж получилось, что большинство комментариев к данной статье посвящено именно этому запросу. Видимо в нем есть тайное знание доступное теперь всем желающим.
Ещё про запросы можно посмотреть здесь, а про запросы с датами можно посмотреть здесь.
Про хитрые запросы. Тэта-соединения 3. Строки неограниченной длины
Делал загрузку прайсов из Excel. Если прайс и справочник Номенклатура маленькие, то конечно всё работает сравнительно быстро. Несколько секунд и сопоставление выполнено вне зависимости от того выполняется ли поиск в одном запросе или используется поиск по реквизитам справочника в цикле. Но в моём случае и справочник и прайс содержат десятки тысяч позиций. Всё бы ничего, но уж очень медленно получается при поиске соответствий Номенклатуры по полному наименованию.
Постановка задачи: найти элементы справочника Номенклатура, полное наименование которых совпадает с наименованием в прайсе поставщика. При больших объемах данных решение напрашивается само собой - использовать запрос.
Не буду долго рассуждать о поиске варианта решения. Сразу покажу запрос, который показал себя наиболее эффективным. ТаблицаДляПоиска это таблица значений, в которой 1 колонка заполненная значениями, загруженными из прайса.
Запрос = Новый Запрос(
"ВЫБРАТЬ
| ПОДСТРОКА(ТаблицаДляПоиска.НоменклатураXLS, 1, 40) КАК НоменклатураXLS_Индекс,
| ТаблицаДляПоиска.НоменклатураXLS КАК НоменклатураXLS
|ПОМЕСТИТЬ ТаблицаДляПоиска
|ИЗ
| &ТаблицаДляПоиска КАК ТаблицаДляПоиска
|
|ИНДЕКСИРОВАТЬ ПО
| НоменклатураXLS_Индекс
|;
|
|////////////////////////////////////////////////////////////////////////////////
|ВЫБРАТЬ
| СправочникНоменклатура.Ссылка КАК Номенклатура,
| СправочникНоменклатура.НаименованиеПолное КАК НоменклатураНаименование
|ИЗ
| Справочник.Номенклатура КАК СправочникНоменклатура
| ВНУТРЕННЕЕ СОЕДИНЕНИЕ ТаблицаДляПоиска КАК ТаблицаДляПоиска
| ПО ПОДСТРОКА(СправочникНоменклатура.НаименованиеПолное, 1, 40) = ТаблицаДляПоиска.НоменклатураXLS_Индекс
| И ПОДСТРОКА(СправочникНоменклатура.НаименованиеПолное, 1, 1000) = ТаблицаДляПоиска.НоменклатураXLS
|ГДЕ
| СправочникНоменклатура.ЭтоГруппа = ЛОЖЬ
| И СправочникНоменклатура.Услуга = ЛОЖЬ");
Запрос.УстановитьПараметр("ТаблицаДляПоиска", ТаблицаДляПоиска);
РезультатЗапроса = Запрос.Выполнить();
Решение лежало на поверхности. Правда?
Про пакетные запросы. Индексы во временных таблицах
Сегодня с утра была пятница. Пришло время открыть великую тайну-у-у-у.
В пакетных запросах в качестве источника данных часто выступает временная таблица. У временной таблицы есть возможность создавать индексы. В каких случаях создание индекса может ускорить выполнение запроса, а в каких наоборот?
Начнем с того, что посмотрим, когда не нужно создавать индексы. Ведь на создание индекса тратится время и ресурсы. Если индекс не будет использоваться, то его создание только замедлит выполнение запроса. Нет смысла создавать индексы, если временная таблица очень маленькая. Нет смысла создавать индексы, если временная таблица соединяется с другой таблицей по полям, которые во второй таблице уже проиндексированы.
Так когда же имеет смысл создавать индексы? Оказывается всё очень просто. Индексы имеет смысл создавать в случае, если выполняется условие сравнения на равенство. В качестве примера можно посмотреть запрос в предыдущем пункте Заметочек. Там как раз используется индекс именно в подобной ситуации.
Возможно со временем индексы будут использоваться и при других вариантах сравнения. Поживем, увидим.
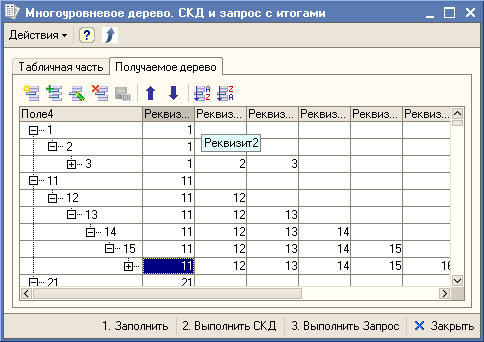
В комментариях к публикациям Как выгрузить итоги запроса в одну колонку ? и Запросики для восьмерочки развернулась настоящая битва между Ish_2 и tango. Просто жуть какая-то. Но вопросы были подняты очень интересные. Я очень внимательно следил за ходом обсуждения и после очередного комментария с примером обработки от Ish_2, появилась обработка, которая демонстрирует построение многоуровнего дерева в одной колонке "Поле4" с использованием как запроса с итогами, так и СКД. За основу была взята обработка, приложенная к комментарию.
Ах, да. "В чем же фишка?" - спросите вы. Всё просто. Из СКД сложное многоуровневое дерево в дерево значений выгружается быстрее. На контрольном примере разница составила в 30 раз. При использовании запроса сам запрос выполняется сравнительно быстро, а вот скорость выгрузки результата запроса в дерево значений оставляет желать лучшего.
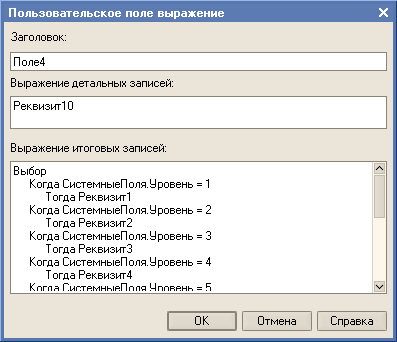
Так как программного кода как такового при использовании СДК нет, то не совсем очевиден способ реализации. Куда смотреть? Смотреть нужно в пользовательских полях.
Собственно весь вывод данных в обработке при использовании СКД построен на пользовательских полях. Это сделано для того, чтобы сохранить нужную последовательность колонок в дереве значений. Если порядок следования реквизитов не важен или реквизиты не нужны в результирующем дереве значений, то и добавлять реквизиты в пользовательские поля не нужно.
Скачать Пример 8...
Но как вы, наверное, догадываетесь, "Пример 8" это не единственный вариант реализации многоуровневого дерева в одной колонке с использованием СКД. Поэтому был добавлен "Пример 9", в котором "Поле4" строится не через пользовательские поля, а через ресурсы. Чем он лучше варианта в "Пример 8"? Работает немного быстрее предыдущего примера и названия колонок в результирующем дереве значений получаются более "ожидаемые".
Особенностью реализации "Пример 9" является расположение ресурсов в группировках. Это сделано только для того, чтобы управлять порядком следования колонок в результирующем дереве значений. Иначе колонки с группировками будут расположены впереди, а уже за ними колонка "Поле4". Чтобы можно было управлять порядком расположения реквизитов необходимо вначале сформировать группировки по реквизитам, а затем реквизиты описать как ресурсы. При необходимости формирования определенного порядка следования колонок в результирующем дереве необходимо для некоторых группировок заменить состав выбранных полей с Авто на требуемый. Если порядок следования реквизитов не важен или реквизиты не нужны в результирующем дереве значений, то и добавлять реквизиты в ресурсы не нужно.
Скачать Пример 9...
Возможность выбора варианта реализации многоуровнего дерева в одной колонке дерева значений есть. В данной публикации приведено 4 способа. Выбирайте. Реализуйте.
Уже были рассмотрены примеры заполнения дерева значений с использованием запроса и СКД. Сейчас предлагаю рассмотреть несколько иной вариант работы с деревом значений.
Краткое описание исходных условий для этого варианта. Работаем с деревом значений имеющим 2 уровня. Для первоначального отображения формируется только первый уровень строк дерева и добавляется по одной пустой строке на втором уровне для отображения плюсиков возле строк. Первый уровень свернут. Далее, при разворачивании пользователем строки первого уровня, пустая строка второго уровня заменяется на необходимый набор данных. Необходимый набор данных получаем, например, запросом в виде таблицы значений.
Что мы получаем при использовании такого варианта работы с деревом? Быстрое первоначальное отображение дерева для пользователя. Что ещё? Немного больше кода при работе с деревом.
Вот тут мы и попляшем немного вокруг вопроса: "Как поместить необходимый набор данных в строки второго уровня?" Есть варианты.
Наиболее очевидный вариант описан в начале этой статьи в части "Про циклы в одну строку". Но он не единственный. Предлагаю рассмотреть ещё один кусочек кода, который намного производительнее при большом количестве строк в необходимом наборе данных.
Процедура ДеревоЗначенийПередРазворачиванием(Элемент, СтрокаДереваЗначений, Отказ)
Если СтрокаДереваЗначений.УровеньРазвернут Тогда
Возврат;
КонецЕсли;
СтрокиГруппировки = СтрокаДереваЗначений.Строки;
СтрокиГруппировки.Очистить();
ТаблицаЗначений = ПолучитьНаборНеобходимыхДанных(СтрокаДереваЗначений);
Если ТаблицаЗначений.Колонки.Количество() * 2 > ТаблицаЗначений.Количество() Тогда
Для каждого СтрокаТаблицыЗначений Из ТаблицаЗначений Цикл
ЗаполнитьЗначенияСвойств(СтрокиГруппировки.Добавить(), СтрокаТаблицыЗначений);
КонецЦикла;
Иначе
Для Индекс = 1 По ТаблицаЗначений.Количество() Цикл
СтрокиГруппировки.Добавить();
КонецЦикла;
Для каждого Колонка Из ТаблицаЗначений.Колонки Цикл
СтрокиГруппировки.ЗагрузитьКолонку(ТаблицаЗначений.ВыгрузитьКолонку(Колонка.Имя), Колонка.Имя);
КонецЦикла;
КонецЕсли;
СтрокаДереваЗначений.УровеньРазвернут = Истина;
КонецПроцедуры // ДеревоЗначенийПередРазворачиванием()
Циклы также можно оформить в одну строку, но для сохранения читаемости кода этого не сделано. На контрольном примере предложенный вариант заполнения был производительнее в 4 раза. Конечно же всё зависит от исходных данных и на других данных результаты могут быть другие, но о том, что 1С всё таки интерпретатор не стоит забывать. Правило "Чем меньше команд, тем быстрее работает программа" остается актуальным и по сей день.
Скачать пример...
Ещё про дерево значений можно посмотреть здесь...
Увидел публикацию Преобразование ТаблицыЗначений во Временную таблицу автора sashapere, в которой ТаблицаЗначений с колонками неопределенного типа подготавливается для использования в запросах. Т.е. проверяются типы значений в колонках, а затем создается новая таблица значений с колонками нужного типа и данные переносятся в неё. Такую таблицу значений уже можно использовать в запросах, передавая её в качестве параметра или источника данных для ПостроителяЗапросов и ПостроителяОтчетов.
Мне показалось, что код не очень эффективен и это можно сделать быстрее. Вот что из этого получилось.
КолонкиТаблицыЗначений = ТаблицаЗначений.Колонки;
Для Индекс = 0 По КолонкиТаблицыЗначений.Количество() - 1 Цикл
МассивЗначений = ТаблицаЗначений.ВыгрузитьКолонку(0);
// Получаем типы значений, которые используются в колонке
Соответствие = Новый Соответствие;
СтТипЗначения = ТипЗнч(Неопределено);
Для каждого Значение Из МассивЗначений Цикл
ТипЗначения = ТипЗнч(Значение);
Если СтТипЗначения <> ТипЗначения Тогда
СтТипЗначения = ТипЗначения;
Соответствие.Вставить(ТипЗначения);
КонецЕсли;
КонецЦикла;
// Преобразуем соответствие в массив типов значений
МассивТипов = Новый Массив;
Для каждого КлючИЗначение Из Соответствие Цикл
МассивТипов.Добавить(КлючИЗначение.Ключ);
КонецЦикла;
// Удаляем старую колонку без установленного типа значения
ИмяКолонки = КолонкиТаблицыЗначений[0].Имя;
КолонкиТаблицыЗначений.Удалить(0);
Если МассивТипов.Количество() = 0 или МассивТипов.Количество() = 1 и МассивТипов[0] = ТипЗнч(Неопределено) Тогда
// Устанавливаем тип значения по умолчанию для колонок, в которых не установлены значения
// По умолчанию Строка
КолонкиТаблицыЗначений.Добавить(ИмяКолонки, Новый ОписаниеТипов("Строка"));
Иначе
// Создаем и заполняем колонку с установленным типом
ТаблицаЗначений.ЗагрузитьКолонку(МассивЗначений,
КолонкиТаблицыЗначений.Добавить(ИмяКолонки, Новый ОписаниеТипов(МассивТипов)));
КонецЕсли;
КонецЦикла;
Допускаю, что и этот код тоже можно оптимизировать. Нет предела совершенству. Поэтому предлагаю сравнить с другими вариантами в "Примере 10". Авторы двух добавленных вариантов sashapere и i132.
Про работу с COMОбъект("V81.Application") или как разогнать 1С в 1000 раз
Очень интересная публикация OLE - монитор автора ghostishe, в которой приложена обработка COM MONITOR. Мне как раз необходимо было сверить справочники в двух базах данных. В предложенной обработке всё понятно, но скорость получения данных из подключенной базы мне показалась крайне низкой. После небольшого эксперимента удалось получить такие же данные как в этой обработке, только в 30 раз быстрее, а после небольшой модификации удалось поднять скорость получения данных из подключенной базы ещё в 5 раз. Добавил "Пример 6". В предлагаемом примере разница во времени выполнения по сравнению с исходным образцом может составить от 15 до 1500 раз - это зависит от состояния базы данных и от объема получаемых данных. Чем больше данных нужно получить, тем больше может получиться разница.
Итак, что и как сравниваем. Во вложении 2 обработки: COM MONITOR и Пример 6 для COM Monitor.
COM MONITOR - во вложении, это почти оригинальная обработка, в которую добавлены команды для выполнения замера времени получения данных из подключенной базы. COM MONITOR работает в двух режимах: с закрытым окном подключенной базы данных и с открытым. Т.к. с открытым окном обработка работает очень медленно, то для сравнения берем только замер с закрытым окном.
Пример 6 для COM Monitor - эта обработка построена на основе COM MONITOR, ну, или почти так. Во всяком случае основной функционал (идею) постарался сохранить. Пример 6 для COM Monitor работает в двух режимах: с использованием дополнительной обработки и без неё. При установке соответствующего флажка используется дополнительная внешняя обработка, которая запускается в подключенной базе данных. Данные внешней обработке передаются через COMSafeArray, который в дальнейшем и обрабатывается. Обратно данные передаются аналогичным образом. Ни каких внешних компонент, всё по честному. AutoIt используется только чтобы вернуть фокус в 1С:Предприятие, а WScript для замера времени выполнения.
Скачать COM MONITOR от ghostishe...
Скачать Пример 6 для COM Monitor...
А теперь главный вопрос: за счет чего получается столь значительное ускорение? Ответ прост: за счет снижения количества разыменований. Да, да. На такой пустяковой операции как разыменование можно добиться столь значительного ускорения. Чем меньше точек в тексте модуля, тем выше скорость его выполнения. Разница особенно заметна при использовании COMОбъект(). Т. к. кроме разыменования здесь немаловажную роль играет передача данных между приложениями, то именно этот момент и решает применение дополнительной обработки. Данные между приложениями передаются всего 2 раза: туда и обратно.
Запускайте, тестируйте, удивляйтесь. 
Про работу с НастройкаПериода, ЗаполнитьЗначенияСвойств и вообще
Вводные данные, ну, или описание исходной задачи были следующие:
- Есть форма Основная, в которой есть возможность настраивать период. Для настройки периода используется объект НастройкаПериода, который вызывается на редактирование по кнопке.
- Также ещё есть форма Настройка, в которой также можно редактировать период, но не только через объект НастройкаПериода, а ещё и через поля ввода дат начала и окончания периода.
- Необходимо чтобы настройки указанные в форме Настройка можно принять и перенести в форму Основная или отказаться от сделанных изменений.
Казалось бы, всё просто, нужно в форме Настройка создать ещё один объект НастройкаПериода и заполнить его свойства. Например, так:
Функция СкопироватьНустройкуПериода(НастройкаПериодаИсходный)
НастройкаПериодаРезультат = Новый НастройкаПериода;
ЗаполнитьЗначенияСвойств(НастройкаПериодаРезультат, НастройкаПериодаИсходный);
Возврат НастройкаПериодаРезультат;
КонецФункции
Вот тут и начинается самое интересное. При использовании команды ЗаполнитьЗначенияСвойств свойства объекта НастройкаПериодаРезультат заполняются неверно, т.е. свойства, конечно, заполняются, но не так как в исходном объекте. А в некоторых случаях вообще возникает ошибка.
Почему нельзя просто присвоить? НастройкаПериодаРезультат = НастройкаПериодаИсходный; Потому, что получится не новый объект, а ссылка на исходный объект.
Один из вариантов создания нового объекта НастройкаПериода может быть таким:
Функция СкопироватьНустройкуПериода(НастройкаПериодаИсходный)
Возврат ЗначениеИзСтрокиВнутр(ЗначениеВСтрокуВнутр(НастройкаПериодаИсходный));
КонецФункции
С этим разобрались и новый объект НастройкаПериода у нас есть - можно редактировать. Теперь в случае отказа можно просто ничего не делать. Закрыть форму Настройка и всё.
Теперь рассмотрим сохранение (перенос) измененных данных периода в основную форму. Если редактирование периода было выполнено через объект НастройкаПериода, то всё просто.
НастройкаПериодаИсходный = НастройкаПериодаРезультат;
А вот в случае редактирования дат периода не всё так однозначно. Потому что способ, который используется в типовых конфигурациях, в некоторых случаях опять же дает неожиданный результат. Т.е. иногда срабатывает, а иногда нет. Вот код с заплаткой.
НастройкаПериодаИсходный = НастройкаПериодаРезультат;
Если ДатаНачала <> НастройкаПериодаИсходный.ПолучитьДатуНачала()
или ДатаОкончания <> НастройкаПериодаИсходный.ПолучитьДатуОкончания() Тогда
НастройкаПериодаИсходный.УстановитьПериод(ДатаНачала, ?(ДатаОкончания = '00010101', ДатаОкончания, КонецДня(ДатаОкончания)));
// Заплатка
Если ДатаНачала <> НастройкаПериодаИсходный.ПолучитьДатуНачала()
или ДатаОкончания <> НастройкаПериодаИсходный.ПолучитьДатуОкончания() Тогда
НастройкаПериодаИсходный = Новый НастройкаПериода;
НастройкаПериодаИсходный.ВариантНачала = ВариантГраницыИнтервала.КонкретнаяДата;
НастройкаПериодаИсходный.ВариантОкончания = ВариантГраницыИнтервала.КонкретнаяДата;
НастройкаПериодаИсходный.ДатаНачала = ДатаНачала;
НастройкаПериодаИсходный.ДатаОкончания = ДатаОкончания;
КонецЕсли;
КонецЕсли;
Как видно из кода, заплатка в качестве периода устанавливает ПроизвольныйПериод. Ах, да. Не видно. Но всё равно в качестве периода устанавливается ПроизвольныйПериод.
Я прекрасно понимаю, что здесь рассмотрен некоторый частный случай, который в типовых конфигурациях не встречается. Но. Есть ли что-то особенное в постановке задачи? По моему нет. Так почему же такой подход не используется в типовых конфигурациях? Не связано ли это с тем, что разработчики типовых конфигураций фирмы 1С не смогли победить объект НастройкаПериода.
В качестве примера приведу "Универсальный отчет", в котором также есть как Основная форма, так и форма Настройки. При этом если изменить период в форме Настройки, он тут же изменяется и в Основной форме. Т.е. закрыв форму Настройки можно отказаться от всех сделанных изменений кроме изменений периода. Вот такие пироги.
Про итоги в регистрах накопления
Пришло время испытать публикацию MMF на довольно большой базе данных. Обнаружился очень интересный факт. Таблица итогов по регистру остатков ЗаказыПокупателей была больше таблицы самого регистра в 50 раз и составляла 20% от всей базы УПП. Все попытки побороть это явление "цивилизованными" способами привели к уменьшению таблицы итогов лишь в 2.5 раза, при этом таблица самого регистра накопления выросла в 2 раза. Тогда было принято решение отключить расчет итогов по этому регистру. На производительности и функциональности это ни как не сказалось, а вот на размерах базы данных и на размерах архивных копий отразилось самым положительным образом.
Т.к. через интерфейс это сделать не получилось, то вот, собственно, код:
РегистрыНакопления.ЗаказыПокупателей.УстановитьПериодРассчитанныхИтогов('00010101');
С методической точки зрения, возможно, это не самое лучшее решение. Но меня поразила его эффективность и простота.
Для просмотра внутренней структуры файловой базы данных 1С:Предприятия 8 предлагаю обратить внимание на Tool_1CD.
Пришло время разучить новый танец. Ни когда раньше такого не делал, но вот пришлось.
Что есть? Конфигурация на базе типового решения 1С:Бухгалтерия предприятия 8 (2.0.31.36) - Учет в МФО (релиз 2.0.31.36), разработчик Фирма "Альянс-Информ". База работает на платформе 8.2.13.219.
Что хотим? Перейти на платформу 8.2.15.294.
Казалось бы, что ничего сложного нет. Установить платформу, запустить базу, сконвертировать базу при запуске и работать в своё удовольствие. Но не тут то было. После конвертации база почему-то начинает падать при запуске на любой версии платформы, начиная с 8.2.14.519. При этом на 8.2.13.219 всё работало как в режиме Конфигуратор, так и в режиме 1С:Предприятие.
Восстанавливаем архив, лезем в конфигуратор и видим, что конфигурация на поддержке без возможности изменения, т.е. типовая. Нужно что-то делать. Но что? Тестирование/исправление, реструктуризация, выгрузка/загрузка - все ранее применявшиеся движения шаманского танца не помогли. После конвертации база падает при запуске.
Что дальше? Разучим новые движения незамысловатого шаманского танца. Начинаем сначала. Заходим в конфигуратор платформы 8.2.13.219 пустой базы. Восстанавливаем архив базы данных из DT-файла. Сохраняем конфигурацию в CF-файл в меню Конфигурация - Сохранить конфигурацию в файл. Включаем возможность изменения в меню Конфигурация - Поддержка - Настройка поддержки. Обновляем конфигурацию базы данных (F7) или в меню Конфигурация - Обновить конфигурацию базы данных. Выходим из конфигуратора. Заходим в конфигуратор платформы 8.2.15.294. Выбираем ту же базу. Соглашаемся с предложением сконвертировать базу данных. Загружаем выгруженный ранее CF-файл в меню Конфигурация - Загрузить конфигурацию из файла. Обновляем конфигурацию базы данных (F7) или в меню Конфигурация - Обновить конфигурацию базы данных. Вот собственно и всё. Получаем работающую базу под платформой 8.2.15.294 с типовой конфигурацией на поддержке без возможности изменения. Т.е. всё то, что и хотелось получить первоначально.
Вывод. В арсенале настоящего шамана может быть много разных танцев, но архивную копию делать нужно.
При подготовке статьи использованы также материалы других авторов. Если вам понравились их обработки, то можете поставить плюсик на их публикациях. Думаю, что они не будут против. Все ссылки есть в статье.
Для раскрашивания текстов модулей в статье была использована Разукрашка.
Пользуйтесь Разукрашкой для раскрашивания кода и запросов 1С:Предприятия, а также кода Delphi.
Прошу воспринимать это не как рекламу, а как добрый совет для авторов других публикаций.
Идя навстречу пожеланиям читателей, фиксирую изменения в различных редакциях публикации.
07.09.2010. Добавил в заметочки "Про получение строки пробелов длиной 10000 символов"
12.10.2010. Добавил в заметочки "Про работу с COMОбъект("V81.Application") или как разогнать 1С в 1000 раз"
12.01.2011. Добавил в заметочки "Про СКД и запросы с итогами" и два примера реализации многоуровнего дерева значений в одной колонке с помошью СКД
03.08.2011. Добавил в заметочки "Про дерево значений"
29.08.2011. Добавил в заметочки "Про типы данных. Расчет сумм по выделенным ячейкам табличного поля". Обновил Пример3_2.epf. Теперь Гостинец.epf "отдыхает"
05.10.2011. Добавил в заметочки "Про типы данных. Динамическая настройка колонок табличного поля"
12.10.2011. Добавил в заметочки к разделу "Про циклы в одну строку" обработку для формарования программного кода в одну строку.
13.10.2011. Добавил в заметочки "Про итоги в регистрах накопления"
17.11.2011. Добавил про разбор длинных строк в массив с возможностью предварительной обработки данных. Обновил Пример 7.
19.01.2012. Добавил в заметочки "Про работу с НастройкаПериода, ЗаполнитьЗначенияСвойств и вообще"
31.01.2012. Добавил в заметочки "Про танцы с бубном"
09.03.2012. Добавил в заметочки "Про хитрые запросы. Тэта-соединения 3. Строки неограниченной длины"
23.03.2012. Добавил в заметочки "Про пакетные запросы. Индексы во временных таблицах"
22.06.2012. Добавил в заметочки "Про таблицу значений"
01.06.2010 /Константинов Алексей Викторович/
Редакция от 22.06.2012

Вступайте в нашу телеграмм-группу Инфостарт
См. также
Механизмы платформы 1С Разработчик Бесплатно (free)
Разберем 15 мифов о работе платформы «1С:Предприятие 8» – как распространенных, так и малоизвестных. Начнем с классики: «Код, написанный в одну строку, работает быстрее, чем многострочный». Так ли это на самом деле?
16.07.2025 45544 TitanLuchs 109
Работа с интерфейсом WEB-интеграция Механизмы платформы 1С Бесплатно (free)
Веб-интерфейсы повышают качество внешнего вида приложений 1С, предсказуемы с точки зрения верстки, позволяют организовать удобные и высокопроизводительные рабочие места для пользователей. Расскажем об особенностях разработки веб-интерфейсов на React внутри 1С, двустороннем взаимодействии 1С и JavaScript, а также сборке веб-приложения в одностраничный файл.
19.06.2025 18566 zeegin 15
Механизмы платформы 1С Работа с интерфейсом Разработчик Стажер 1С:Предприятие 8 Бесплатно (free)
Про ООП в 1С и о том, как сделать свой код более кратким и выразительным при помощи использования текучего интерфейса (fluent interface).
03.02.2025 25958 bayselonarrend 127
Механизмы платформы 1С Разработчик 1С:Предприятие 8 Бесплатно (free)
В этой статье подробно рассматривается работа с JSON в XDTO в 1С:Предприятие. Вы узнаете, как сериализовать и десериализовать объекты XDTO в JSON, интегрировать 1С с веб-сервисами и API, а также корректно обрабатывать данные при обмене. Разбираются особенности работы с коллекциями, использование функций восстановления и частые ошибки при работе с JSON и XDTO.
30.01.2025 33152 user2122906 10
Механизмы платформы 1С Файловый обмен (TXT, XML, DBF), FTP Разработчик 1С:Предприятие 8 Бесплатно (free)
Этот материал познакомит вас с механизмом XDTO (XML Data Transfer Objects) в 1С и научит эффективно использовать его возможности. Мы разберёмся, как работать с XML-схемами, создавать модели данных, манипулировать объектами XDTO, а также сериализовать и десериализовать их в XML. Вы узнаете, как использовать XDTO для интеграции с внешними системами, избегать типичных ошибок и оптимизировать код. К концу вы будете уверенно применять XDTO для решения сложных задач обмена данными и автоматизации процессов.
17.01.2025 55508 user2122906 13
Механизмы платформы 1С WEB-интеграция Разработчик 1С:Предприятие 8 Бесплатно (free)
В платформе 8.3.27 появилась возможность использовать WebSocket-клиент. Давайте посмотрим, как это все устроено и чем оно нам полезно.
14.01.2025 46659 dsdred 110
Механизмы платформы 1С Разработчик 1С:Предприятие 8 Бесплатно (free)
Особенности "Знач" и разбор документации к нему.
10.01.2025 26355 VAAngelov 60
Механизмы платформы 1С Разработчик Стажер 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Эта небольшая статья - некоторого рода шпаргалка по файловым потокам: как и зачем с ними работать, какие преимущества это дает.
23.06.2024 40353 bayselonarrend 24
Замер код записан в 4 строки. Завершено за 3,329 сек.
Замер код записан в 1 строку. Завершено за 0,5 сек.
У меня получилось приблизительно в 6 раз. Но здесь нужно учитывать только время переходов. Если в цикле будут команды, которые выполняются медленно, то и результаты будут иными.
Замер код записан в 6 строк. Завершено за 1,532 сек.
Замер код записан в 1 строку. Завершено за 0,859 сек.
Почти в 2 раза. Тоже не плохо.
Но, по большому счету, и раньше было известно, что 1С для всяких сильно вычислительных и переборных задач совсем не подходит. В реальной же жизни, как правило, скорость работы 1С упирается в скорость работы с БД, и на этом фоне оптимизация просто кода 1С приносит практически незаметные результаты.
Функция ТочноеВремя()

	Script = Новый COMОбъект("MSScriptControl.ScriptControl");
	Script.Language = "javascript";
	Возврат Script.eval("new Date().getTime()");

КонецФункции

Процедура КнопкаСформироватьНажатие(Кнопка)

	Старт = ТочноеВремя();

	А = 0;
	Для Сч = 1 По 1000000 Цикл
		А = А + 1;
	КонецЦикла;

	Сообщить("В несколько строк:" + (ТочноеВремя() - Старт) + " мск");

	Старт = ТочноеВремя();

	А = 0;Для Сч = 1 По 1000000 Цикл А = А + 1;КонецЦикла;

	Сообщить("В одну строку:" + (ТочноеВремя() - Старт) + " мск");

КонецПроцедуры ПоказатьРезультат(вне отладки):
В несколько строк:1 531 мск
В одну строку:1 078 мск
Но я бы объяснил это не лишними повторениями или переходами между командами, а наличием возможных точек останова и возможностью указания строки ошибки.
Правда, не знаю, как выполняется клиентский код в тонком и веб-клиентах 8.2.
(17) Ну давай посчитаем. В твоем тесте цикл выполняется миллион раз, в варианте шести строк внутри цикла 4 строки, т.е. за время выполнения теста происходит обработка отладочного кода (1) четыре миллиона раз. Именно этих четырех миллионов вызвовов команды (1) нет в варианте с одной строкой. Уходит на это примерно пол-секунды (на моем рабочем компе разница между тестами 0.4 секунды). В обычной жизни для вывода пользователю результатов запроса из БД надо выполнить не более нескольких тысяч строк (с учетом всех циклов), что на три порядка меньше, чем в тесте. Т.е. способом "пишем всю программу в одну строку" ты будешь ловить миллисекунды.
Я отнюдь не отрицаю, что эффект есть, я просто говорю, что, как правило, он совсем не стоит внимания. Возможно, в исключительных случаях, и бывает, что таким способом можно получить хоть немного заметную экономию времени. Но скорее всего, это тяжелые алгоритмические или переборные задачи, которые, в таком уж случае, гораздо эффективнее писать на других, компилируемых, языках. С++, например. Выигрыш по времени выполнения чисто алгоритмической программы на С++ по сравнению с 1С может достигать нескольких тысяч раз.
РазбираемаяСтрока = СтрЗаменить(РазбираемаяСтрока, """", """""");А если серьезно, то у меня такой способ разбора строк встречается часто. Взял из модуля, где разбираются строки вида ЭлементыФормы.КоманднаяПанель.Кнопки.Подменю.Кнопки.Действие.Подсказка
Главное ведь сам прицип. Если принцип понятен, то модифицировать команду под разбор, например, строки чисел уже не составит труда.
(Подсказка: S заменить на N и убрать некоторые кавычки)
Вот мои замеры (10 млн итераций):
Замер код записан в 6 строк. Завершено за 25,652 сек.
Замер код записан в 1 строку. Завершено за 14,771 сек.
11 секунд выигрыша в моем случае - большой плюс.
Предложенный способ оптимизации действительно отношу к особенностям компилятора/интерпритатора, а не к оптимизации кода в полном смысле этого слова.
Но все равно плюс автору за статью.
2. Зачем в одной колонке нужно иметь разные типы ?
3. Не понял текста запроса после "Объединить Все" .
- Второй запрос будет пустым . зачем это нужно ?
4.
"ИТОГИ
| Организация КАК СтруктураДоговоров,
| СУММА(Сумма)
|ПО
| Организация");"
- После опции ИТОГИ употреблена не агрегатная функция , а "Организация" .
Что это ?
В двух словах - там по периодическому регистру сведений КурсыВалют вычисляются периоды действия курсов и ещё ряд показателей, при этом исключаются записи в которых курс установлен такой же как в предыдущей записи.
Нет. Я имел ввиду несколько иное представление именно периодических регистров сведений: КурсыВалют, ЦеныНоменклатуры и т.д. Где это может использоваться? Например, здесь
Дело , конечно, в том , что при соединении по неравенству в первом запросе размер "промежуточной" таблицы запроса резко возрастает.
Например , получение первой временной таблицы Периоды при помощи кодинга может дать многократный выигрыш по быстродействию .
Здесь фишка в другом - убрать повторяющиеся данные из цепочки, а оставить только точки перехода с датами, когда данный переход был выполнен.
Т.е. для цепочки 0, 0, 1, 1, 1, 0, 0, 0, 1
должны остаться только 0, 1, 0, 1
Отметив возможное замедление , продолжим "ковырять" первый запрос пакета.
В нем фильтрация по &Валюта применена дважды , причем один раз в условии соединения. На мой взгляд , эффективнее и понятнее будет следующий запрос для получения временной таблицы "Соединения"
Выбрать РАЗРЕШЕННЫЕ КурсыВалют.Период
Поместить Периоды
из Регистр.КурсыВалют
Где КурсыВалют.Валюта=&Валюта;
ВЫБРАТЬ
Периоды.Период как Период1,
Максимум (ЕСТЬNULL(Периоды1.Период, Периоды.Период)) КАК Период2
Поместить Соединения
Из
Периоды КАК Периоды
Левое Соединение Периоды КАК Периоды1
Периоды.Период > Периоды1.Период
Сгруппировать по
Периоды.Период
- Конечно можно и получше нарисовать. Ну, там в трехмерной проекции...
- А я бы нарисовал немного в профиль
- Да потому, что у вас всё в профиль
© Миссия Клеопатра
Добавил вариант с оптимизацией. Работает немного побыстрее, но понять, что делается в двенадцати пакетном запросе мне кажется сложнее. :)
Пример 3 хорош лишь как любопытная демонстрация запросной техники , но ни в коем случае не образец решения задачи. Лучше бы явно это указать в теме.
Действительно , выгрузив таблицу регистра в таблицу значений мы за ОДИН проход получим выходное дерево многократно быстрее.
Скромно поинтересуюсь : а можно посмотреть пример 3 - оба варианта до оптимизации и после.
Первый запрос не изменился. Во втором поля выборки, два внутренних соединения, Итоги - как были так и остались.
Теперь и ты отведай моего гостинца .
1. Текст запроса сокращен в 1,5 раза.
2. Быстродействие запроса увеличилось в 1,5 раза
В прикрепл.файле "Гостинец" твоя обработка "пример № 3" с измененным текстом запроса.
На небольших объёмах проверять бессмысленно.
Создай 1 000 - 10 000 различных курсов по одной валюте и сравни результаты.
выигрыш в быстродействии должен быть никак не меньше 1.5 раза.
На мой вкус, "Гостинец" в первой строке выдает как раз правильный результат :
"Изменение курса" в первой строке не имеет смысла , т.к. пред.курс неизвестен.
(68) ,(107) Саша и Артур , просьба :
Пожалуйста , протестируйте и сравните на предмет быстродействия:
1. Прикрепленную обработку в (60) Гостинец.epf
2. В текущей теме в разделе "файлы" четвертый файл "пример с оптимизацией" Пример 3_2.epf.
Нужно в БП , а потом в УТ создать ежедневные разные курсы по одной валюте за 12 лет и запустить обработки 1 и 2. Сравнить время выполнения .
Не откажите хорошему человеку. Вы нас рассудите с Алексеем.
P.s. Было бы хорошо - и для файлового варианта и для клиент-серверного.
Сравнивать нужно с первоначальным примером.
Практической пользы - практически ноль. Ну, одна за 17 секунд, другая за 15...
Ну и фигли? ;)
Нажал я кнопочку "Загрузить" и пишу этот коммент (а менеджер по асе девочку охмуряет).
Один фиг загрузит быстрее, чем вышеизложенное ;)
- Ну, и что? Зато моя работает правильно.
А если серьезно, то мне понравилось решение в "Гостинец", иначе не появился бы "Пример3_3".
В SQL версии
"Гостинец" работет немного быстрее как в вариантах с индексами, так и без индексов
В файловой версии
При использовании индексов "Гостинец" также быстрее
"Пример3_3" быстрее без индексов, но это скорее исключение - может дело в базе или в расположении звезд
Мне, например, гораздо интереснее - почему с индексами в файловой версии работает значительно медленнее чем без индексов.
Почему при ЯВНО заданном индексе для врем.таблице в файловой базе наблюдаются жесткие тормоза ?
И почему при НЕЯВНО заданном индексе (ведь наверняка его создал оптимизатор запроса) тормозов не наблюдается.
С индексами
Время выполнения Гостинец.epf - 0,484 сек
Время выполнения Пример3_2.epf - 0,469 сек
Без индексов
Время выполнения Гостинец.epf - 0,343 сек
Время выполнения Пример3_2.epf - 0,516 сек
Вариант 3. Обычное соединение. Завершено за ~35,5 сек.
Вариант 3. Оптимизированное соединение. Завершено за ~12,5 сек.
Гостинец. Оптимизированное соединение. Завершено за ~12,5 сек.
Починенный Гостинец. Оптимизированное соединение. Завершено за ~12,5 сек.
Разница в производительности очень не значительная :(
Рассматривается файловый вариант. Исследуются две обработки
"Гостинец.epf"
и "Пример 3_2" , скачанный в текущей теме сегодня в 18-20 мск.
Количество ежедневных курсов (подряд) с 1998 года по сегодняшний день составило в тестовой базе БП 1.6 - 4400 шт.
Замер времени исполнения запроса производился средствами ТВОЕЙ обработки.
Каждая обработка запускалась 3 разF.
Время выполнения Гостинец.epf - ~ 11.7 сек
Время выполнения Пример3_2.epf - ~ 17.7 сек
Выигрыш 1.5 раза.
Кто нас рассудит ? Помогите , люди добрые !
Итак дома загрузил курсы в БП 1.6 - 8491 запись в регистре сведений Курсы валют по EUR и USD с 01.01.1999
Время выполнения Гостинец.epf - ~ 12.3 сек
Время выполнения Пример3_2.epf - ~ 12.6 сек
Время выполнения Пример3.epf - ~ 35.5 сек
На самом такими темпами нужно ждать 1с 8.5 или 9.0, где будет реализована возможность редактирвания ВРЕМЕННЫХ таблиц и что-то типа UPDATE.
(57) там можно в меньше, чем 15 строчек уложиться...вопрос только в производительности... А производительсноть повышается 3 способами:
1. Наращивание железа
2. Оптимизация рутинных операций путем переписывания на assemblere (или другом языке)
3. Написанием сложного и длинного алгоритма, возможно с применением математических моделей.
Прагматика должна опираться на исходные положения :
1. Данные хранятся только на сервере.
2. Любое обращение к данным есть запрос.
3. Эффективнее преобразовывать данные там , где они хранятся. Без перегонки на клиента.
4. Переводя решение на SQL -запрос , мы делаем его технологичнее (отвязываемся от слабости клиента).
Эти исходные положения диктуют совершенно определенный взгляд на решение любой задачи.
Тошнота от циклов , if-ов , case-ов, рекурсий - нормальная реакция здорового мозга.
Понятно , что без кодинга совсем не обойтись. НО.
Корявая попытка написать запрос полезнее двух корректно написанных процедур.
Долой кодинг ! Даешь прозрачный запрос !
"Переводя решение на SQL -запрос , мы делаем его технологичнее (отвязываемся от слабости клиента)."(с)
Отвязываясь от "слабости клиента"(с) происходит отвязывание и от мозгов клиента. Если мозгов (алгоритмических возможностей) "запросного" сервера хватает для решения поставленной задачи, то - да. А если не хватает? Упрощаем (извращаем) постановку задачи? Подстраиваем схему БД под средства (запросы) обработки данных? Громоздим "средний уровень"? И всё это ради утверждения "Любое обращение к данным есть запрос"(с). Откажитесь от использования только запросов, и получите "золотую середину"(с). Все так просто... :-)
а) Ничего не утверждаем,
б) ничего не предлагаем
Но :
в) спорим
в) сомневаемся ,
г) отрицаем ,
е) отказываемся ...
С одной стороны , имеете право . Так безопаснее , чем лезть на рожон
с утверждениями и предложениями : не "задолбят".
С другой стороны , блекло и тускло. Всё как обычно...
Игорь.
Для разговора требуется от собеседников, чтобы они читали не только свои сообщения.
Или, читая, не заменяли все слова собеседника на слово - "восьмерка". У Вас это не получается...
Ок.(с) :-)
P.S.
Сделаю еще одну попытку достучаться:
указывать в полях выборки запрос . Разумеется , такая возможность давно реализована в диалектах SQL.
И тогда вместо соединения по неравенству можно следующее, многократно более эффективное :
Выбрать
КВ.Период  как ТекущийПериод,
(Выбрать Первые 1
КВвнутр.Период из РегистрСведений.КурсыВалют как КВвнутр
ГДЕ  КВвнутр.Период<КВ.Период
Упорядочить ПО КВвнутр.Период Убыв) как ПредыдущийПериод
ИЗ РегистрСведений.КурсыВалют как КВРазумеется.
И в 1С++ тоже.
Все чаще ловлю себя на мысли, что с 1С++ (в связке с FormEx, разумеется) не осталось ничего, о чем стоит помечтать.
Пора, наверное, на восьмерку. Освежить, так сказать, мечтательный раздел мозга.
Ежели честно: там был околотемный флад. Хотя и не такой уж фладистый ;)
Короче: стандартный спор упертых семерочников со мной широкообразованным ( :D ), начиная от 2.0 до 8.2 ;)
Как видишь, ничего особенного, кроме отхода от темы ветки, который поддержали кстати и ув. модераторы.
Приношу автору извинения.
А мысли мои по поводу 8.2 повторяются здесь
Время выполнения Пример3_3.epf - ~ 1.7 сек
Последний запрос ( чем отличается Пример3_3 от гостинца)- никакой прибавки к быстродействию не даёт.
Львиную долю времени (90%) занимает запрос соединения по неравенству.
Если из первого запроса "Гостинца" убрать строку "Индексировать по Период1,Период2"
то мы и получим быстродействие 1.5 сек.
В свою очередь , если мы добавим строку "Индексировать по Период1,Период2" в твой Пример 3_3 ,то получим те самые 11.7 сек (т.е. запрос из-за этой строки выполнился медленне в 8 раз ).
И честно говоря - это очень и очень странно.
Явное создание необходимого индекса многократно тормозит общий пакет запроса. Получается , что оптимизатор запроса лучше создает тот самый индекс.
Явное использование во временной таблице Опции "Индексировать" (т.е. создание индекса) приводит в дальнейшем к очень серьезному замедлению при обращении к этой таблицы. Казалось бы , этого в принципе быть не должно.
Я выложил новые "Пример3" и "Пример3_2". На небольших объемам данных "Пример3" показывает изумительные результаты, а на больших объемах "Пример3_2" держит паритет с "Гостинец". :)
Про временные таблицы вот что я думаю. Для файловой версии во временных таблицах видимо используется какая-то оптимизация, которая, возможно, использует существующие индексы, которые возможно транслируются во временные таблицы.
В таком случае, принудительная индексация имеет смысл только для таблиц без индексов, например, табличных частей документов или для таблиц значений.
Но это пока только догадки. Нужно тестировать.
У Гилева есть статьи на эту тему. Быстродействие запроса зависит от слишком многих факторов, т.к. 1с ПЕРЕВОДИТ свои запросы в запросы SQL. А что там дальше будет... Нужно препарировать выполнение запросов на каждой отдельной конфигурации ПО.
1с в этом случае даёт лишь рекомендации...не использовать соединение вложенных запросов, т.к. это может транслироваться в неоптимальный запрос.
НовыйМассив = Новый Массив; Соответствие = Новый Соответствие;
Для каждого ЭлементМассива Из Массив Цикл Соответствие.Вставить(ЭлементМассива) КонецЦикла;
Для каждого КлючИЗначение Из Соответствие Цикл НовыйМассив.Добавить(КлючИЗначение.Значение) КонецЦикла;
Кусок
Соответствие.Вставить(ЭлементМассива)Соответствие.Вставить(ЭлементМассива, ЭлементМассива)НовыйМассив.Добавить(КлючИЗначение.Ключ)Скачал две обработки.
1. COM Monitor
2. Пример 6 для COM Monitor
Посмотрел последний п.2.
А почему модуль закрыт в п.1 ?
Можно подтвердить факт про разное быстродействие п.1 и п.2 .
Но как я проверю открытый тобой секрет :
ускорение за счет снижения количества разименований ?
2. Результаты тестирования .
Основная база файловая , подключаемая SQL.
Справчочник КОнтрагенты. 5230 объектов.
Время загрузки :
1. COM Monitor ------------------------- 132сек
2. Пример 6 для COM Monitor -------- 21 сек.
Если в п.2 применить дополнительную обработку (извращение по-моему)
то
2. Пример 6 для COM Monitor -------- 9 сек.
Почему вариант с обработкой "извращение"? Это позволяет сократить издержки на передаче данных.
Вообще-то, если бы данные собирались на постоянной основе, то для SQL версии лучше было бы использовать привелегированный общий модуль, чтобы вся обработка данных прошла на сервере, а клиент получил уже готовый результат. Тогда обработка данных прошла бы ещё быстрее.
Я тестировал всё на файловых базах и разница в результатах была гораздо значительнее.
Мне вот что интересно: на чем выполнены твои тесты и почему столь существенная разница в результатах по сравнению с моими?
У меня базы файловые УПП 1.2.29.1, объем каждой базы 13 Гб, платформа 1С 8.1.15.14
ОС Widows XP Pro SP2
ПК CPU IntelCore2 Duo E6750 2.66GHz RAM 4 Гб HDD RAID 0 SATA 2x160 Гб
Тестировал справочник Номенклатура 22000 элементов
Справочник ДоговорыКонтрагентов . Количество объектов 16 665шт.
1. COM Monitor ------------------------- 406сек
(в процессе загрузки интерактивно закрываю открывщееся окно 1сПредприятия SQL-базы)
2. Primer_6_ COM_ Monitor.epf -------- 90 сек.
(без дополнительной обработки)
| Код |
|---|
   мСтрока = Новый Массив;
   Если Не ТипЗнч(Строка) = Тип("Строка") Тогда Возврат мСтрока; КонецЕсли;
   Стр = СокрЛП(Строка);
   Если Стр="" Тогда Возврат мСтрока; КонецЕсли;

   Длина = СтрДлина(Разделитель);
   Пока Истина Цикл Поз = Найти(Стр,Разделитель); Если Поз = 0 Тогда мСтрока.Добавить(СокрЛП(Стр)); Прервать; КонецЕсли; Нашли = СокрЛП(Лев(Стр, Поз-1)); Если Не ПустаяСтрока(Нашли) Тогда мСтрока.Добавить(Нашли); КонецЕсли; Стр = СокрЛП(Сред(Стр,Поз+Длина)); КонецЦикла;
Показать полностью |
у меня - прочти в 4 раза
Вот мои результаты:
Длина тестовой строки: 608207
Количество строк тестовой строки: 12848
Код из комментария. Элементов в массиве: 10 106. Завершено за 9,812 сек.
Код из статьи. Элементов в массиве: 12 848. Завершено за 0,094 сек.
+Организации
-- Договоры
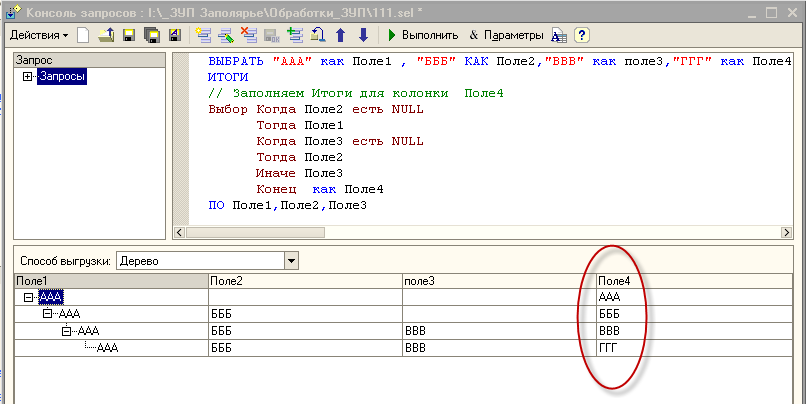
а, скажем , 4- уровневое дерево , чтобы при выгрузке из запроса в одной колонке дерева иметь :
+Контрагент
--Договор
---Номенклатура
----Характеристика
Делал такое ?
Может, я ошибаюсь, но
в исходном примере данные разных типов были в одной колонке,
а в новом примере иерерахия есть только в первой колонке и в ней же одно повторяющееся значение.
И колонок стало 4 против прежних 2. Под условия в 154 не подходит.
и рассматривается ТОЛЬКО двухуровневое дерево после выгрузки из запроса :
+Организации
--Договоры
В (157) приведен пример как в одном запросе получить 4-уровневое дерево.
Для простоты и наглядности все колонки в (157) одного типа.
(157) говорит также о том , что можно в одной колонке выводить итоги и для дерева ЛЮБОГО уровня.
Как вывести разнотиповые итоги в одной колонке в теме автора раскрыто хорошо и понятно.
Похоже, это уже неважно.
У меня пример автора не повторяется. Либо в дереве три колонки, либо при настройке колонок нет иерархии.
Если после выгрузки из запроса сделать Дерево.СоздатьКолонки() , то пользователь увидит 3 колонки.
В том и дело, если я делаю две колонки и не использую "СоздатьКолонки", то в дереве нет иерархии.
Ага, свойство "Иерархия" как раз и не стояло.
Теперь всё понятно стало. (157) полностью решает задачу.
Удобнее для корректировок, быстрее, с пересчетом итогов по группировкам и т.д.
Доп. Функционал накручивается на дерево проще , чем на табличный документ.
Код1 Код2
1
2 1
3 1
4 2
5 4
6 3
1->
+->2->4->5
+->3->6
Вот такое только вручную.
ВЫБРАТЬ 1 КАК Код1, NULL КАК Код2
ПОМЕСТИТЬ ТМП_ИСХ
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ 2 КАК Код1, 1 КАК Код2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ 3 КАК Код1, 1 КАК Код2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ 4 КАК Код1, 2 КАК Код2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ 5 КАК Код1, 2 КАК Код2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ 6 КАК Код1, 3 КАК Код2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ 7 КАК Код1, 6 КАК Код2
;
ВЫБРАТЬ Т0.Код1 КАК Код0, Т1.Код1 КАК Код1, Т2.Код1 КАК Код2, Т3.Код1 КАК Код3
ПОМЕСТИТЬ ТТТ
ИЗ ТМП_ИСХ КАК Т0
ЛЕВОЕ СОЕДИНЕНИЕ ТМП_ИСХ КАК Т1
ПО Т0.Код1 = Т1.Код2
ЛЕВОЕ СОЕДИНЕНИЕ ТМП_ИСХ КАК Т2
ПО Т1.Код1 = Т2.Код2
ЛЕВОЕ СОЕДИНЕНИЕ ТМП_ИСХ КАК Т3
ПО Т2.Код1 = Т3.Код2
ГДЕ Т0.Код2 ЕСТЬ NULL
;
ВЫБРАТЬ
ВЫБОР
Когда Код1 Есть NULL Тогда Код0
Когда Код2 Есть NULL Тогда Код1
Когда Код3 Есть NULL Тогда Код2
Иначе Код3
КОНЕЦ КАК Код33,
Код0, Код1, Код2, Код3
ИЗ ТТТ
ИТОГИ
ВЫБОР
Когда Код1 Есть NULL Тогда Код0
Когда Код2 Есть NULL Тогда Код1
Когда Код3 Есть NULL Тогда Код2
Иначе Код3
КОНЕЦ КАК Код33
ПО Код0, Код1, Код2, Код3 АВТОУПОРЯДОЧИВАНИЕ
;
Еще бы дубли строк убрать и вообще красота
Дано : Граф описан с помощью таблицы "Граф" с колонками Сын,Родитель (Код1,Код2).
Априорно известен уровень графа =4 (такое редко встечается, но пусть)
Нужно : получить в виде дерева на форме изображение графа .
Замечание : быстродействие неважно - Таблица "Граф" очень небольшая(до 100 строк).
Если количество узлов в графе более 100 000 и уровень 5-10 , тогда такое построение запроса неприменимо.
Так ?
Результат твоего запроса (174) изображен на рисунке. Ты бы хотел избавиться от плвторений выделенных красным цветом ?
Так ?
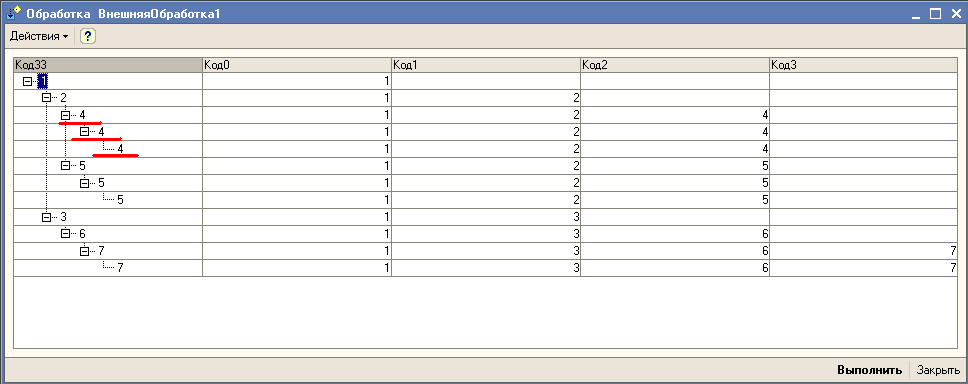
Поэтому см. прикрепленную обработку с твоим и моим вариантом запроса.
Как я понял существуют всего три варианта получить дерево:
1) Формировать программно через код,
2) запросом через итоги,
3) Как иерархический справочник.
В СКД, тоже получаются пустые строки.
В теме "Запрос против рекурсии.." применен именно такой приём и дерево ошибок выводится без пустых строк.
Минус же построения дерева из запроса с итогами - один : чрезвычайно низкое быстродействие.
(185) Вообще говоря, возможны варианты ,и варианты ,и варианты...
Но как только возникает условие : НУЖЕН абсолютный контроль зацикливания - то вариант только один.
Кхе..Кхе..
Я извиняюсь.В чужой теме я задудел в свою любимую дуделку.
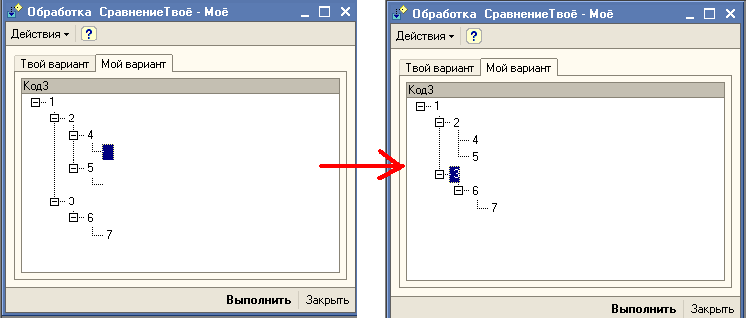
Про граф и уровень его, можно сказать, что максимальный уровень графа равен 4-м, это для примера. Ничто не мешает сделать вложенность и 10 ... 20. По поводу быстродействия нужно проверять.
Ведь запрос не обязательно делать для одной таблицы с данными графа и связывать её саму с собой.
Как вариант можно сформировать последовательные отрезки с наборами графа с увеличением уровня вложености (0-1, 1-2, 2-3, 3-4 ... 19-20 и так далее), а потом все отрезки объединить в один набор, и уже по нему пройтись запросом с итогами.
Хотя скорее всего вариант рекурсии с подзапросами будет выигрывать по скорости.
Не знаю существует ли другой вариант сформировать дерево структуры запросами. Очень, очень жаль что в 1С нет рекурсивных запросов.
Я даже это не проверял - взял в свою статью как есть.
Тут меня огорошили примером : все замечательно работает и без объединений с пустыми запросами.
Т.е. запрос на рисунке приводит к нормальным результатам см. следующий пост.
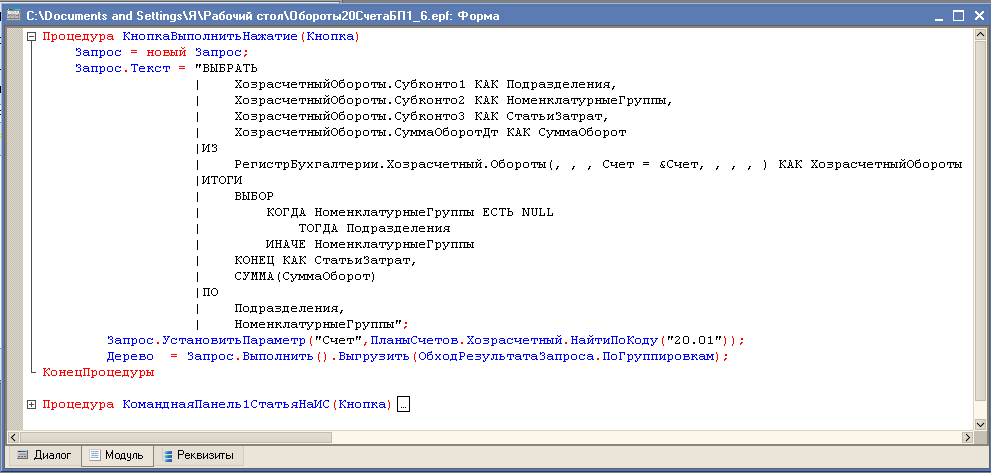
Долго не мог понять, зачем я так сделал. Так вот когда разобрался, то оказалось, что пустой запрос с типами данных необходим только в случае последующей обработки данных в дереве. Точнее в том случае, когда при вводе новых строк строки с необходимыми типами данных не попали в результат запроса.
В частности у меня это используется здесь
Т.е. в этой обработке первоначально запрос формирует только первый уровень дерева, остальные данные подгружаются при необходимости и когда при разворачивании уровней данные добавляются в дерево, типы добавляемых данных должны быть уже предопределены в дереве.
Статью поправлю.

Для меня главное, что так это работает и работает быстро. Так как выпуск новых версий платформы 8.1 не планируется, то можно предположить, что на 8.1 это будет работать всегда. При этом наблюдается 100% повторяемость как для файловой версии, так и для MS SQL. Так что к частному случаю это отнести нельзя.
Кстати, на 8.2 это тоже работает. Т.к. платформа постоянно дорабатывается, то тут в стабильности быть на 100% уверенным быть нельзя.
>> Но мне кажется, что публично предлагать лучше решения, невызывающие ни малейших сомнений ни в 8.1, ни в 8.2.
Значит ли это, что если есть сомнения в том, что программа будет работать под следующей версией Windows, то этой программной нельзя пользоваться. В моей картине мира под сомнение попадает большинство существующих программ.
V8х.ComConnector недоступен в базовых версиях конфигураций 8.х
Тошнота от if-ов, case-ов? Дык они и в запросах есть, причём куда уродливее и нечитабельнее иной раз, особенно когда по таким полям группируют.
В общем, не вижу я прямой связи между тенденцией утолщать клиента и обязательностью всё делать запросами. Спорить времени нету и желания тоже.

На основании этой статьи Вы можете привести свои выводы, предлождения ?
утверждения, интересные 1с-никам ?
свой взгляд на развитие СУБД ?
С удовольствием почитаю.
Или , как обычно, в очередной раз посомневаться , подразумевая
" женщина хорошая , зря не напишет ".
Игорь.
Это уже десятый круг... :evil: :evil: :evil:
Ну, тЫ открой мой "профайл" и прочти, хоть, названия публикаций.
Там есть ВСЕ ответы на вопросы из (215) сообщения воплощенные в РЕАЛЬНЫЕ разработки (публикации). Или тЕБЕ вслух почитать?
P.S. на (201).
"Тошнота от циклов..."(с)
Может это беременность? :)
    ВремяНачала = ТекущаяДата();
ВремяОкончания = ТекущаяДата();Скачайте Пример 1.
У меня получается 0.882 и 0.601 секунды, а у вас?
Мне не нравится как ты суммируешь ячейки.
В цикле записываешь в соответствие , затем в цикле суммируешь.
Да еще и через "Попытку".
    Сумма = 0;
    КоличествоСумм = 0;
    СоответствиеЯчеек = Новый Соответствие;

    Для Каждого ВыделеннаяОбласть Из ТабличноеПоле.ВыделенныеОбласти Цикл
        Для Индекс1 = ВыделеннаяОбласть.Лево По ВыделеннаяОбласть.Право Цикл
            Для Индекс2 = ВыделеннаяОбласть.Верх По ВыделеннаяОбласть.Низ Цикл
                Область = ТабличноеПоле.Область(Индекс2, Индекс1, Индекс2, Индекс1);
                Попытка
                    Значение = Число(Область.Текст);
                Исключение
                    Значение = 0;
                КонецПопытки;
                СоответствиеЯчеек.Вставить(Область.Имя, Значение);
            КонецЦикла;
        КонецЦикла;
    КонецЦикла;

    Для каждого Ячейка Из СоответствиеЯчеек Цикл
        Значение = Ячейка.Значение;
        Если Значение <> 0 Тогда
            Сумма = Сумма + Значение;
            КоличествоСумм = КоличествоСумм + 1;
        КонецЕсли;
КонецЦикла; ПоказатьУжас !
Неужто нельзя было что-то придумать для отказа от "Попытки" ?
Попытка
	Ячейка = ПолеТабличногоДокумента.Область("R" + Формат(ИндексСтрока, "ЧГ=0") + "C" + Формат(ИндексКолонка, "ЧГ=0"));
	Если Ячейка.Видимость = истина Тогда
		Сумма = Сумма + Число(СтрЗаменить(Ячейка.Текст, " ", ""));
	КонецЕсли;
Исключение
КонецПопытки;
В 8.х преобразование простых типов выполняется гораздо хуже чем в 7.7
Значит, в типовых - ужас.
Значит, все делают ужасно.
Не может быть, чтобы преобразование "строка-число" осуществлялось только через "попытку".
Неужто нет встроенных механизмов , преобразующих строки в числа ?
Покажи нам мастер-класс , Алекс !
Неужто нет встроенных механизмов , преобразующих строки в числа ?" заставляют усомнится...кое в чем...вообще-то это не только в 1С, это повсеместно так. Можно обернуть лишь в функцию . Функция ПопыткаПреобразовать(Строка)...и о каком встроенном механизме может идти речь если я подсуну строковую кашу "fdgsdg" или "1.345" или "1.232,2343" и т.д.
Функция СтрокаВЧисло(Знач СтрокаЧисла)
// Уберем хвостовые пробелы и стандартный разделитель
СтрокаЧисла = СтрЗаменить(СокрЛП(СтрокаЧисла), Символы.НПП, "");
// Проверим допустимые символы
КоличествоРазделителей = 0;
Для Индекс = 1 По СтрДлина(СтрокаЧисла) Цикл
СимволЧисла = Сред(СтрокаЧисла, Индекс, 1);
Если Найти("0123456789", СимволЧисла) = 0 Тогда
Если Найти(",.", СимволЧисла) = 0 Тогда
Возврат 0;
ИначеЕсли КоличествоРазделителей > 1 Тогда
Возврат 0;
КонецЕсли;
КоличествоРазделителей = КоличествоРазделителей + 1;
КонецЕсли;
КонецЦикла;
// Преобразование
Возврат Число(СтрокаЧисла);
КонецФункции // СтрокаВЧисло()
Требуется автоматически суммировать все выделенные ячейки в табличном документе
и вывести результат на форму.
Использовать типовой алгоритм суммирования (как в типовых конфигурациях) с использованием "попытки" - запрещено.
Использовать посимвольный разбор текста ячейки - запрещено.
Использование ВК - запрещено.
Разрешено использование только штатных (встроенных) функций.
Какой должна быть процедура суммирования ?
Вычислить("""4""+""-4""") = 0 значит число
upd не, неправильно, не работает, идея была добавлять минус.
Ты написал :
XMLЗначение(Тип("Число"), ?(Лев(СтрокаЧисла,1) = "-", "-0" + Сред(СтрокаЧисла, 2), "0" + СтрокаЧисла)); Заходим в режиме 1сПредприятие в "Табло" набираем
и получим значение 1, вместо 0.
Это ошибка.
Функция СтрокаВЧисло(СтрокаЧисла)
ОписаниеТипов = Новый ОписаниеТипов("Число");
Возврат ОписаниеТипов.ПривестиЗначение(СтрокаЧисла);
КонецФункции // СтрокаВЧисло()
Если все ячейки можно преобразовать к числу, то быстрее в ~1,7 раза.
Если все ячейки нельзя преобразовать к числу, то быстрее в ~6,5 раз.
Если 50 на 50, то быстрее в ~4 раза.
Это только приведение к типу число.
В общем случае получение ссылки по ГУИДЫ выполняется так:
ОбъектДляПоиска.ПолучитьСсылку(Новый УникальныйИдентификатор(Строка(Выборка.Ссылка.УникальныйИдентификатор())))
Но можно использовать XMLСтрока/XMLЗначение
Прикрепил обработку с замерами
Обновил "Пример 6 для COM Monitor". Теперь получается ещё большее ускорение при использовании дополнительной обработки для передачи данных.
Вид сравниваемых данных: Документ "Реализация товаров и услуг".
Количество документов: 81846
Результаты выполнения:
COM MONITOR: 6601.097 сек.
Пример 6 для COM Monitor: 117.772 сек. Ускорение в 56 раз
Пример 6 для COM Monitor с обработкой: 4.377 сек. Ускорение в 1508.1 раза
Допустим разница времени выполнения будет 200 раз. Т.е. не 3 с лишним часа, а всего 1 минуту. Не знаю как для других, а для меня это очень даже приличное ускорение.
Пример обмена через сериализованную таблицу значений.
Пример не самостоятельный - надергал в текстовик куски из кода.. но принцип должен быть понятен.
Я предложил несколько иной подход к решению:
1. Решение проблемы с наложением областей
2. Оптимизация выполнения кода по скорости
3. Использование отложенного расчета по выделенным ячейкам. Т.е. расчет выполняется после окончания выделения области
Возможно, что объединение двух этих методов дало бы ещё больший эффект, но...
Правда ведь, что вывод напрашивается сам собой - нужно пользоваться обработкой КодВОднуСтроку.epf.
Она оставляет исходный код с комментариями и форматированием, а также формирует код в одну строку. При этом сохраняется читабельность кода и работает интерпретатор пошустрее.
Ограничение вывода 1 раз на 1000 итераций увеличило выполнение цикла на 1-2 сек (176 и 178 соответственно). Т.е. значимых тормозов уже не наблюдалось.
Те же 1-2 секунды дало ОбработкаПрерыванияПользователя и вынос тела цикла в отдельную процедуру.
В конфе прикрепленной есть обработка создания документов. В обработке подменю для тестирования. Создает в цикле документы, но не записывает их.
На счет больших строк.
Для работы с большими строками используйте объект ТекстовыйДокумент.
Приложил измененный пример 7.
Пример 7.
Длина тестовой строки: 1233914
Количество строк тестовой строки: 10000
Код из комментария.  Элементов в массиве: 10 000.  Завершено за 37,532 сек.
Код из статьи.  Элементов в массиве: 10 000.  Завершено за 0,094 сек.
Через ПС и Текст.  Элементов в массиве: 10 000.  Завершено за 0,125 сек.
быстродействие почти такое же, что из через внутреннюю строку, но зато легально иногда даже быстрее зависит от строки.
И что не мало важно позволяет обрабатывать данные помещая в массив.
Пример 7.
Длина тестовой строки: 2099999
Количество строк тестовой строки: 1000000
Код из комментария.  Элементов в массиве: 1 000 000.  Завершено за 1 472,631 сек.
Код из статьи.  Элементов в массиве: 1 000 000.  Завершено за 0,778 сек.
Через ПС и Текст.  Элементов в массиве: 1 000 000.  Завершено за 5,34 сек.
Через ПС и Текст (одна строка). Элементов в массиве: 1 000 000. Завершено за 6,058 сек.(305) Даже на одной команде в цикле получилось 12%-ное ускорение. Это конечно не много. Но можно посмотреть на это с другой стороны. Например, так. Сколько будет стоить проапгрейдить все компьютеры в сети, чтобы поднять производительность на 5%? Но это так, лирическое отступление. Для меня же это скрытый резерв, который позволяет не прибегая к глобальным изменениям в коде, а лишь нажатием нескольких кнопок, несколько поднять производительность на некоторых операциях. Я о нём знаю и помню, а Вы?..
про циклы в одной строке
В отладке действительно скорость выполнения цикла отличается в разы.
1 000 000 итераций
Замер код записан в 6 строк. Завершено за 23,39 сек.
Замер код записан в 1 строку. Завершено за 1,203 сек.
А в базе данных в которой нет отладки разница уже не так очевидна.
Замер код записан в 6 строк. Завершено за 1,953 сек.
Замер код записан в 1 строку. Завершено за 1,39 сек.
Тестирую на
У меня для 1000000 циклов результаты такие
1С:Предприятие 8.1.15.14
Замер код записан в 6 строк. Завершено за 0,884 сек.
Замер код записан в 1 строку. Завершено за 0,587 сек.
33,6%
1С:Предприятие 8.2.14.533
Замер код записан в 6 строк. Завершено за 0,85 сек.
Замер код записан в 1 строку. Завершено за 0,499 сек.
41,3%
В вашем замере разница в 28.8%. Вполне укладывается в среднестатистическую погрешность. От ПК тоже многое зависит.
По приведенному примеру. Следует учитывать, что чем больше быстро выполняющихся операций в цикле, тем больше будет эффект. Ну, и наоборот, если в цикле выполняются очень медленные операции, то эффекта возможно вообще не будет.
так как реально циклы с 1 000 000 итерациями для простой арифметике не делают.
Как правило в циклах тормозят именно то что внутри него.
эти примеры доказывают то, что конструкция
Для По Цикл
Конец;
медленнее на 0.3 сек для 1 000 000 итераций чем
Для По Цикл Конец;но это будет ничтожно мало в сравнении полной производительностью определенного кода.
с чего вы взяли что поднимите общую производительность на 5%.
Есть реальные примеры замера производительности с нормальными циклами и в одну строку?
Причем тестировать нужно корректно:
Запуск 1С тест1
Запуск 1С тест2
1С и ОС кешеруют данные и проверять нужно с этим учетом + сама отладка тормозит поэтому код в режиме отладки выполняется дольше.
я не спорю что код в одну строку быстрее но у него огромный минус (не читаемость), а ++ его спорны
т.е в реалии если не оптимизировать то что внутри цикла ни кто из пользователей не заметит ускорения
Если вы хотите оптимизировать нужно пользоваться замером производительности тогда вы получите гораздо лучшей результат.
Вот реальный пример кода вывод области табличного документа.
Ускорения практически ноль.
Замер код записан в 6 строк. Завершено за 10,359 сек.
Замер код записан в 1 строку. Завершено за 10,297 сек.Для тестирования работы обработки возьмем глобальный модуль ЗиК 7.70.315
Вот результат с оптимизацией. Завершено за 16,34 сек.
Вот результат без оптимизации. Завершено за 19,628 сек.
Вот они 16% ускорения на реальной обработке и реальных данных.
Можно сравнить с обработкой с диска ИТС. Завершено за 2670,795 сек.
Я не призываю агульно всё писать в 1 строку.
Ещё раз повторюсь. Для меня это только один из способов оптимизации.
Допускаю, что возможно я чего-то про оптимизацию не знаю. И если у вас есть какой-то другой способ поднять производительность на те же 16%, буду только рад об этом узнать.
Реальный пример это немного другой все таки разукрашивать код нужно не пользователям БД.
а вот выводит отчеты им ближе будет.
Ускорение есть только в части самого цикла при большем количестве итераций.
Но время работы самого цикла незримо мало по сравнению с тем временем которое тратиться на обработку того, что внутри цикла
Согласен программист должен сам решать.
Либо писать так чтобы было читаемо ли в одну строку.
Но в реальных БД ускорения даже в 5% вы точно не получите.
так что сравнивать этот нюанс с
считаю некорректным. Большего результата можно добиться оптимизировав код в режиме замера производительности.
Удачи!
Ну, нет, так нет.
И типовая тоже сгодиться.
Для каких целей вами нужно разукрашивать ВЕСЬ глобальный модуль.
Как правило сфера применения данной обработки это вставка кода в статью на сайте.
Если Вы вставите огромный кусок кода в статью, то её скорее всего читать ни кто не будет.
Реальная задача для вашей обработки это разукраска ну максиму 300 строк.
Сравните производительность с 300 строками. Нужна оптимизация?
.Остатки(&Момент,Номенклатура = &Номенклатура)
вместо
.остатки(&Момент,Номенклатура в (Выбрать Номенклатура из Накладная))
в случае файлового варианта 8.1.15 выигрыш был 50%
И конечно же плюс за оформление, ведь это потраченное время на благо начинающих программюг x]
Совсем не тому учите. На производительность это скажется если отчеты формировать с периодом больше месяца.
А насчет размеров:
ПересчитатьИтоги (RecalcTotals)
Синтаксис:
ПересчитатьИтоги()
Описание:
Выполняет полный пересчет итогов регистра накопления.
Пример:
Регистры.Остатки.ПересчитатьИтоги();
Если это не помогло - в скуле очистить таблицу итогов и снова ПересчитатьИтоги.
Можно и с другой стороны - отключить у всех измерений участие в итогах
Речь ессно идет про оборотный регистр
Вот сегодняшняя статистика по производительности:
Универсальный отчет
Регистр ЗаказыПокупателей. Расчет итогов отключен.
Группировки отчетов Заказ, Номенклатура. Отборов нет.
Формирование отчета по остаткам и оборотам за прошлый год заняло 33 секунды, а это 16 колонок и 80000 строк.
Формирование отчета по остаткам и оборотам за весь период заняло 204 секунды, а это 16 колонок и 240000 строк.
Формирование отчета по текущим остаткам заняло 14 секунд, а это 4 колонки и 50000 строк.
Хотя обычно нужны итоги по конкретному заказу. Так вот формирование отчета с итогами по всем измерениям регистра и отбором по заказу заняло меньше секунды. Если нужно, то сделаю замер с точностью до милисекунд.
А то, что "С методической точки зрения, возможно, это не самое лучшее решение", то это я так же указал в статье.
PS: Статья хорошая (сам писал). Пожалуйста, читайте внимательнее.
Обычно распухание происходит когда регистр "в ноль" не закрывается. Поэтому записей в таблице итогов больше чем в таблице движений (грубо говоря кратно количеству месяцев). Может стоило в эту сторону покопать? Сделать например корректирующий документ который погасит неиспольуемые движения.
Т.к. через интерфейс это сделать не получилось, то вот, собственно, код:
РегистрыНакопления.ЗаказыПокупателей.УстановитьПериодРассчитанныхИтогов('00010101');
Операции->Управление итогами->Установить По = Год своего рождения.
З.Ы. В статье все-таки нужно объяснить - чего же мы сделали, и к чему это может привести.
Итоги все же есть - на текущий момент.
Вот если бы так сделал:
РегистрыНакопления.ЗаказыПокупателей.УстановитьИспользованиеТекущихИтогов(Ложь);
То я бы с удовольствием посмотрел бы на твои замеры
Разницы не чувствую - потому как это одно и то же.
А отключает итоги вот это:
УстановитьИспользованиеИтогов(<Признак>)
Но тогда уже придется без виртуальных таблиц обходится
Я описал проблему, попытки решения и вариант решения, который в результате этих попыток был принят. При этом отметил, что возможно это не самый лучший вариант решения.
Как сказал один товарищ "Нет плохих или хороших решений, есть только принятые и не принятые".
Ты не подумай, я не со своим уставом в твой монастырь, не учу тебя - ни ни. Ну просто (мне так кажется) - это было бы удобно!
Итоги у нас хранятся помесячно, вплоть до периода рассчитанных итогов + текущие итоги (которые с датой 3999.чего-то там). Как получаются остатки, когда мы обращаемся к виртуальной таблице остатков: если дата на которую нужны остатки больше периода рассчитанных итогов, то берутся текущие итоги и из них вычитаются все движения до даты на которую нам нужны остатки. Если же мы хотим получить остатки где-нибудь в прошлом году к примеру, то берется ближайший месяц рассчитанных итогов и к нему добавляются (или вычитаются) движения до нужной даты.
Что должно произойти если мы сбросим период рассчитанных итогов: остатки всегда будут формироваться путем вычитания всех движений (до нужной нам даты) из текущих итогов. Получается что чем дальше в прошлое нам нужны остатки - тем дольше будет выполнятся запрос. Или я не прав и в 1С это работает не так?
Почему? Разве в этом случае не будет производиться скан по полям первой временной таблицы?
Конечно, если поля в обоих таблицах будут проиндексированы, то оптимизатор скорее всего выберет один из индексов. А может решит, что перебор записей будет быстрее, а может поднимет результат запроса из кеша, а может решит, что использование индекса, по которому нет статистики не так эффективно, как использование индекса с высоким показателем выборки уникальных записей.
В любом случае время на создание дополнительного индекса будет потрачено.
Кроме этого есть ещё и такой момент
При этом данная заметочка не касается индексов созданных в базе данных.
Но с тем же успехом можно вообще не использовать индексирования (нигде) - т.к. время тратится, а использование не гарантировано.
Тут вопрос больше о принципах принятия решения:
У меня есть две временные таблицы, во второй поля соединения проиндексированы. При больших объемах данных будет (хочется верить) фильтр по индексу.
Теперь возвращаемся к первой таблице - она не проиндексирована, т.о. всегда будет производиться перебор этой таблицы. А если проиндексировать, то уже чёрный ящик. Если вспомнить про масштабируемость системы, то вопросов выделять или не выделять ресурсы не должно вставать.
Вот это как раз и заставило задуматься :)
Насколько я понял , следует индексировать обе таблицы. Но там пояснения строятся больше на физических таблицах.
"Если вспомнить про масштабируемость системы, то вопросов выделять или не выделять ресурсы не должно вставать."
Тогда зачем спрашивать? Проидексировать всё на свете - вдруг пригодится?
Но я бы так делать не стал. Использование или не использование индексов я бы отнес к тонкой настройке. В этом случае, лучший советчик эксперимент на реальных данных.
И забегая вперед, хотелось бы узнать результаты этого эксперимента.
Что в данном случае подразумевают под "подходящими" нужно обдумать...
Начал писать, но тут подумал - может мы говорим про разные соединения?
Я в данном случае подразумеваю внутреннее соединение.
Если же говорить о левых соединениях, то там действительно индексы для основной таблицы не нужны, поскольку никакой фильтрации по первой таблице не требуется и все равно будет полный обход.
Например, берем базу данных в которой есть 2 регистра: "Продажи" и "ПродажиСебестоимость". В продажах 235000 записей, в себестоимости - 155000. Соединяем их по "Регистратор" и "Номенклатура", используем внутреннее соединение и смотрим показания секундомера.
Вот исходный запрос:
ВЫБРАТЬ
Продажи.Регистратор КАК Регистратор,
Продажи.Номенклатура КАК Номенклатура,
Продажи.Стоимость КАК Стоимость
ПОМЕСТИТЬ Продажи
ИЗ
РегистрНакопления.Продажи КАК Продажи
;
//////////////////////////////////////////////////////////// Показать5.359 - без индексов. Второй вызов
Теперь добавляем индексы.
7.146 - индекс в Продажи по Регистратор и Номенклатура. Первый вызов
7.106 - индекс в Продажи по Регистратор и Номенклатура. Второй вызов
6.091 - индекс в Себестоимость по Регистратор и Номенклатура. Первый вызов
6.01 - индекс в Себестоимость по Регистратор и Номенклатура. Второй вызов
7.718 - индекс в обоих таблицах по Регистратор и Номенклатура. Первый вызов
7.636 - индекс в обоих таблицах по Регистратор и Номенклатура. Второй вызов
Продолжаем экспериментировать и получаем, что после всевозможных комбинирований индексов, самым эффективным был вариант.
5.763 - индекс в Себестоимость по Номенклатура. Первый вызов
Получилось, что в данном случае для оптимизатора запросов лучше не делать индексов для виртуальных таблиц, потому что время на их создание больше, чем эффект от их использования.
В замерах участвовала база УПП 1.3.24.2 на Microsoft SQL Server 2005 Standard Edition
Дерево.КОлонки.Добавить("ВременнаяКолонка");
МассивВсехСтрок = Дерево.Строки.НайтиСтроки(Новый Структура("ВременнаяКолонка",Неопределено),Истина);
Если с помощью этого метода преобразовывать Дерево в Таблицу значений получается выигрыш 10% чем если с рекурсией бегать по веткам дерева (30000строк, 2 уровня)
Правда, вот "Про хитрые запросы. Тэта-соединения 2", пример3 мне кажется, больно заморочено.
Попробовал написать по своему, получилось проще и на SQL работает в 2-4 раза быстрей чем "Гостинец от Ish_2..."
Вот:
ВЫБРАТЬ РАЗРЕШЕННЫЕ
	КурсыВалют.Период КАК Период,
	КурсыВалют.Курс КАК Курс,
	КурсыВалют1.Период КАК Период2,
	КурсыВалют1.Курс КАК Курс2
ПОМЕСТИТЬ
	ВрмКурсы
ИЗ
	РегистрСведений.КурсыВалют КАК КурсыВалют
ЛЕВОЕ СОЕДИНЕНИЕ
	РегистрСведений.КурсыВалют КАК КурсыВалют1
ПО КурсыВалют1.Валюта = КурсыВалют.Валюта
	И КурсыВалют1.Период В (ВЫБРАТЬ
								МИНИМУМ (КурсыВалют2.Период)
							ИЗ
								РегистрСведений.КурсыВалют КАК КурсыВалют2
							ГДЕ
								КурсыВалют2.Валюта = &Валюта
								И КурсыВалют2.Курс <> КурсыВалют.Курс
								И КурсыВалют2.Период > КурсыВалют.Период)
ГДЕ
	КурсыВалют.Валюта = &Валюта
;
ВЫБРАТЬ
	МИНИМУМ(КурсыВалют.Период) КАК ПериодС,
	КурсыВалют.Период2 КАК ПериодПО,
	МИНИМУМ(КурсыВалют.Курс2) КАК Курс,
	МИНИМУМ(КурсыВалют.Курс2) - МИНИМУМ(КурсыВалют.Курс) КАК ИзменениеКурса,
	РАЗНОСТЬДАТ(МИНИМУМ(КурсыВалют.Период), КурсыВалют.Период2, ДЕНЬ) КАК КоличествоДней
ИЗ
	ВрмКурсы КАК КурсыВалют
СГРУППИРОВАТЬ ПО
	КурсыВалют.Период2
УПОРЯДОЧИТЬ ПО
	ПериодС
ПоказатьКроме первой строки и последней все то же самое что и в гостинце 1 версии.
Но первая и последняя у меня правильнее, остальные версии гостинца к сожалению не видел, не могу скачать.
Хочу в "СпискеДокумента" иметь "Итоги по колонке" .
Устанавливаем любой отбор - автоматически пересчитываются итоги.
Что-то нигде не нашел описания простого решения, пришлось открывать "велосипед" самому.
Расскажешь нам : как и что ?

1. Итоги вообще не считаются, а должны. Как сделать, чтобы считались?
2. Итоги то считаются, то не считаются, не зависимо от установленного отбора. Как сделать, чтобы всегда считались?
3. При установке отбора итоги пересчитываются, а не должны. Как сделать, чтобы не пересчитывались?
4. При установке отбора итоги не пересчитываются, а должны. Как сделать, чтобы пересчитывались?
5. Итоги зло, тот кто их считает враг государства. Как его найти? :)
Лучше бы использовать для запроса "ПостроительОтчета".
ПостроительОтчета.ТекстЗапроса =
"Выбрать
Сумма(СуммаДокумента)
ИЗ Документ.ПриходныйКассовыйОрдер как Док
{Где Док.___,
Док.___1,
Док.___2
Док.___3,......}"
Потом в цикле каждому элементу отбора "Построителя" присвоить элементОтбора "Списка" и наконец
ПостроительОтчета.Выполнить();
Ну, вот как-то так я считаю :)
Истина всегда конкретна :
Форма со списком документов в подавляющем числе случаев или не имеет полей ввода или имеет такие поля ввода , после изменений которых должен обновляться СписокДокументов. Наличие же элементов формы , которые никак не связаны со СпискомДокументов в такой форме - сущая экзотика.
Тогда в подаляющем числе случаев выгоднее использовать ОбновлениеОтображения().
Чем мне не нравится событие "ПриПолученииДанных" ?
А тем что оно вызывается трижды при обновлении видимой страницы.
У Радченко это есть. Привожу по памяти :
Вначале получаем данные всех записей выше текущей, затем ниже текущей записи , затем саму запись.
Заметочник, ты не все справки читал...
Кроме этого некоторые выложенные файлики не мои, о чем указано в статье. Соответственно они выложены "как есть".
добавлю тоже в копилку
алгоритм понравился, немного его модифицировал:
- если в ТЗ только одна колонка, то при ее удалении удаляются и все строки;
- собственно, какие то колонки уже м.б. типизированы;
- в большинстве случаев известно, что тип в колонках не составной
В 7.7 было проще................
Для полной универсальности не хватает проверки на тип выделенной области.
А то если в выделение попадает картинка, то имеем ошибку.
Функция РасчетСуммыПоЯчейкам(ТабличноеПоле) Экспорт

    Сумма = 0;
    КоличествоСумм = 0;
    СоответствиеЯчеек = Новый Соответствие;
    ОписаниеТипов = Новый ОписаниеТипов("Число");

    Для Каждого ВыделеннаяОбласть Из ТабличноеПоле.ВыделенныеОбласти Цикл
		Если ТипЗнч(ВыделеннаяОбласть) = Тип("ОбластьЯчеекТабличногоДокумента") Тогда // <- тут
			Для Индекс1 = ВыделеннаяОбласть.Лево По ВыделеннаяОбласть.Право Цикл
Показать1. Печать заголовков колонок на каждой странице отчета.
2. Выбор из стандартных предустановленных вариантов компоновки отчета.
3. Кнопка, которая открывает сформированный отчет (табличный документ) в Microsoft Office Excel или Open Office Calc, т.е. в программе, которая ассоциирована для файлов с расширением .xls.
4. Группа кнопок для управления Периодом. "Выбор периода...", "Предыдущий месяц", "Текущий месяц" и "Следующий месяц".
Сворачивание цикла в одну строку даёт прирост в 1-2%.. Читаемость кода всё же важнее, если время уж не совсем критично.
А вот переход с 8.2 на 8.3 сразу же даёт -25% (минус). Грустно, товарищи :(
пМассив = Новый Массив;
пМассив.Добавить("гшоукще");
пМассив.Добавить("ыва");
пМассив.Добавить("лдщзмит");
пРазделитель = ".";

Количество = 10000;
ирОбщий.НачатьЗамерЛкс(Количество, "Многострочный");
Для Счетчик = 1 По Количество Цикл
	ЗаписьXML = Новый ЗаписьXML;
	ЗаписьXML.УстановитьСтроку();
	Пустая = Истина;
	Для Каждого Элемент Из пМассив Цикл
		Если Не Пустая Тогда
			ЗаписьXML.ЗаписатьБезОбработки(пРазделитель);
		Иначе
			Пустая = Ложь;
		КонецЕсли;
		ЗаписьXML.ЗаписатьБезОбработки(Строка(Элемент));
	КонецЦикла;
	Результат = ЗаписьXML.Закрыть();
КонецЦикла;
ирОбщий.КончитьЗамерЛкс();

ирОбщий.НачатьЗамерЛкс(Количество, "Однострочный");
Для Счетчик = 1 По Количество Цикл
	ЗаписьXML = Новый ЗаписьXML;  	ЗаписьXML.УстановитьСтроку();  	Пустая = Истина;  	Для Каждого Элемент Из пМассив Цикл  		Если Не Пустая Тогда  			ЗаписьXML.ЗаписатьБезОбработки(пРазделитель);  		Иначе  			Пустая = Ложь;  		КонецЕсли;  		ЗаписьXML.ЗаписатьБезОбработки(Строка(Элемент));  	КонецЦикла;  	Результат = ЗаписьXML.Закрыть();
КонецЦикла;
ирОбщий.КончитьЗамерЛкс(); ПоказатьИ получил результаты как с подключенным отладчиком, так и без. В первом случае ускорение естественно немного больше - 40%. Во втором случае ускорение составило 30%.
Окончание замера "Однострочный" - Длительность = 0.14с, Среднее = 0.000014с. Отладчик подключен и неравномерно замедляет выполнение кода!
Окончание замера "Многострочный" - Длительность = 0.194с, Среднее = 0.0000194с
Окончание замера "Однострочный" - Длительность = 0.133с, Среднее = 0.0000133с
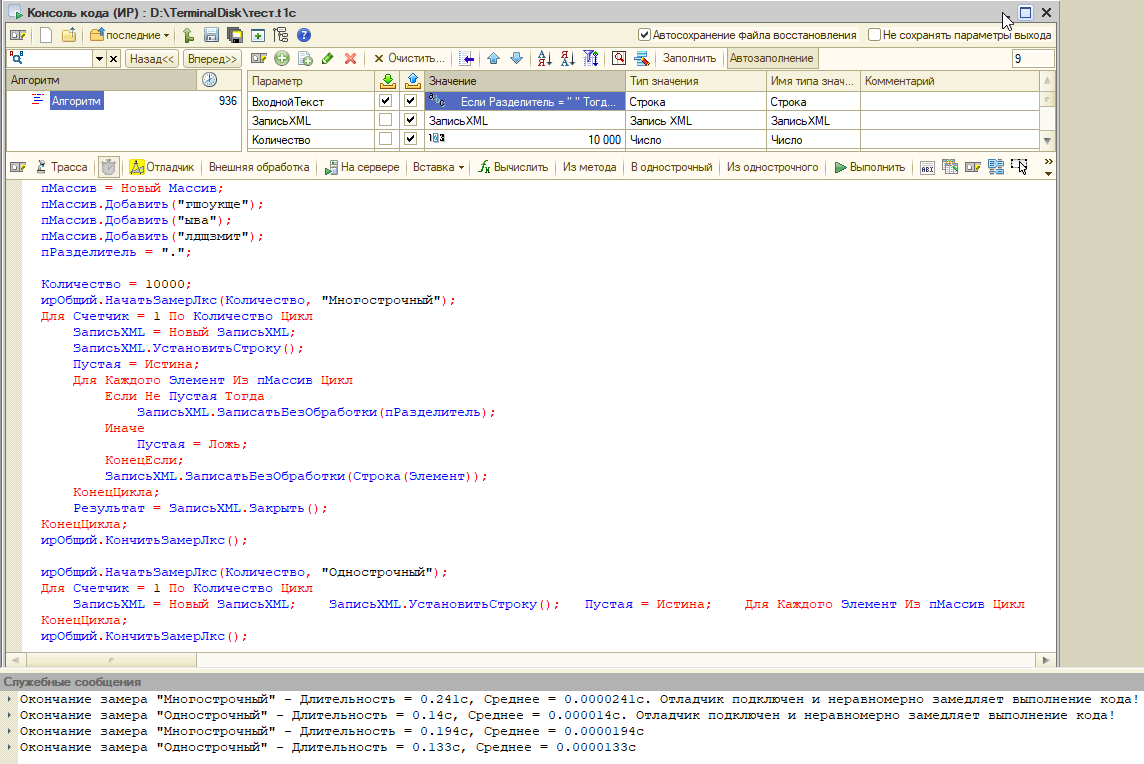
Пример
// Пассивный оригинал расположенного ниже однострочного кода. Выполняйте изменения синхронно в обоих вариантах.
#Если Сервер И Не Сервер Тогда
ЗаписьXML = Новый ЗаписьXML;
ЗаписьXML.УстановитьСтроку();
Пустая = Истина;
Для Каждого Элемент Из пМассив Цикл
Если Не Пустая Тогда
ЗаписьXML.ЗаписатьБезОбработки(пРазделитель);
Иначе
Пустая = Ложь;
КонецЕсли;
ЗаписьXML.ЗаписатьБезОбработки(Строка(Элемент));
КонецЦикла;
Результат = ЗаписьXML.Закрыть();
Возврат Результат;
#КонецЕсли
// Однострочный код использован для ускорения. Выше расположен оригинал. Выполняйте изменения синхронно в обоих вариантах. Преобразовано консолью кода из подсистемы "Инструменты разработчика" (
ЗаписьXML = Новый ЗаписьXML; ЗаписьXML.УстановитьСтроку(); Пустая = Истина; Для Каждого Элемент Из пМассив Цикл Если Не Пустая Тогда ЗаписьXML.ЗаписатьБезОбработки(пРазделитель); Иначе Пустая = Ложь; КонецЕсли; ЗаписьXML.ЗаписатьБезОбработки(Строка(Элемент)); КонецЦикла; Результат = ЗаписьXML.Закрыть(); Возврат Результат;
ПоказатьТаким образом обеспечиваются читаемость и два способа возвращения оригинального кода.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 71130
Создание 01.06.10 14:10
Обновление 11.07.13 08:49
Просмотры 228935
Загрузки 6336
Рейтинг
1115
Комментарии 413
Код открыт Не указано
Рубрики Механизмы платформы 1С
Кому
Системный администратор
,
Разработчик
Тип файла Внешняя обработка (ert,epf)
Платформа 1С:Предприятие 8
Конфигурация 1C:Бухгалтерия
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Абонемент ($m)


