Как построить универсальную подсистему в 1С, которая позволит легко и быстро подключать любое число интеграций от разнообразных потребителей
Интеграция - Мессенджеры и боты
Тема этой статьи – интеграционный шлюз и то, как мы реализовали его в 1С. Сначала будет немного теории и паттернов, а затем практика, которую можно внедрить у себя: структура метаданных, код и описание работы подсистемы.
В нашем мире сейчас очень много микросервисов, микросервисной архитектуры и готовых решений, с которыми нужно интегрироваться. Чтобы не писать свое, к ним нужно подключаться.
Зачастую, когда у вас 10–15, 20 и больше решений, возникает зоопарк из не связанных друг с другом интеграций, которые дублируют код и не переиспользуют какие-то общие вещи. Поддерживать это – огромная боль. Особенно когда меняется какая-то корневая бизнес-логика, которую нужно поменять в пятнадцати местах.
Поэтому у нас и родился такой механизм.
Сначала немного об истории, как мы к этому пришли, затем – про паттерны API GateWay и BFF. После этого перейдем непосредственно к практике: как мы это используем, как система масштабируется, какие используются метаданные и код. В конце поговорим о том, чего нашей подсистеме пока не хватает.
Как развивалась подсистема
Исторически до ковида основной фокус нашей компании был на офлайн-выдаче. Грянул ковид, офисы начали переходить в онлайн, закрываться из-за самоизоляции, и личный кабинет нам понадобился буквально вчера.
Мы написали HTTP-сервис. Примерно за неделю сделали базовый личный кабинет для клиента и методы программного интерфейса, которые позволяли ему работать.
Затем начали появляться новые интеграции. Мы стали использовать внешние чат-боты, голосовых роботов, мессенджеры, рассылки, внешнюю аналитику данных. Для каждого сервиса интеграция шла через отдельный новый HTTP-сервис. Их становилось все больше и больше, появилось дублирование бизнес-логики, служебного кода, валидаций. Каждый программист писал для себя все эти методы внутри своей интеграции.
В результате получилось много обособленных интеграций, которые друг с другом вообще никак не связаны. Каждая новая разработка интеграции без переиспользования кода занимала много времени, потому что фактически это была полная разработка с нуля.
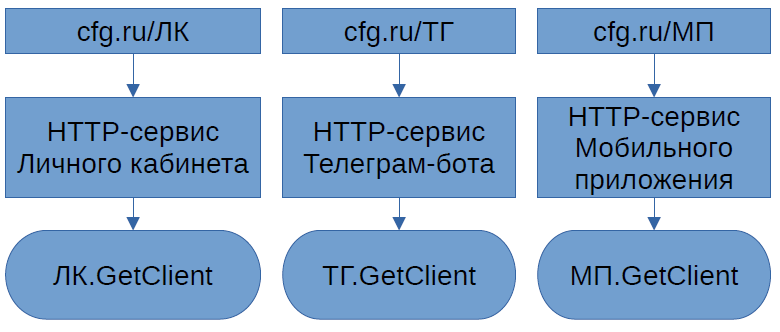
На схеме это выглядело так: личный кабинет, Telegram-бот, мобильное приложение – для примера возьмем три потребителя. У каждого свой HTTP-сервис, у каждого есть свой метод GetClient – уже бизнесовый бэковый метод получения клиента.
Эти методы очень похожи и отличаются совсем небольшими деталями, но у каждого потребителя свой. Если у клиента появляется новое поле, которое нужно отдавать всем, мы дорабатываем три метода, а не один.
Когда таких интеграций становилось пять, семь, десять, эта проблема начинала очень сильно замедлять разработку. Что-то забывали доработать, кто-то падал, кто-то недополучал данные.
Так мы пришли непосредственно к разработке интеграционного шлюза.
Для разработки интеграционного шлюза использовался архитектурный паттерн API GateWay. Кроме того, на стороне 1С мы реализовали BFF-слой, о котором чуть позже поговорим подробнее. Он нужен для того, чтобы сделать работу с нашим интеграционным шлюзом удобнее для фронтов.
Основные плюсы такого подхода – универсализация интеграций, переиспользование методов и серьезное упрощение поддержки, масштабирования и доработок.
Что за GateWay API и BFF?
Что такое API GateWay? Это архитектурный паттерн, при котором существует одна точка входа, один endpoint для всех клиентов интеграции.
Личный кабинет, мобильное приложение, Telegram-боты, голосовые роботы, рассылки, аналитика – все стучатся в одну точку. В одном endpoint уже выполняется маршрутизация по конкретным подсистемам, после чего запрос обрабатывается дальше.
Огромный плюс – упрощение для клиентов, централизация безопасности и трафика. Весь трафик идет через один канал, а не через множество различных.
Кроме того, снижается связанность за счет разделения транспортного уровня и уровня бэка.
Следующий паттерн – BFF, Backend for Frontend. При таком подходе у каждой интеграции есть свои персональные методы для каких-то собственных процессов, но бизнес-логики внутри этих методов нет. Они вызывают общую бизнес-логику.
Например, метод «получить клиента» единый. Он возвращает все данные клиента и дорабатывается в одном месте. При этом каждый потребитель интеграции, каждый внешний клиент, получает только нужный ему объем данных, который трансформируется уже на уровне BFF, причем в том формате, который нужен конкретному потребителю.
Задача BFF-слоя – трансформация формата и, возможно, какая-то алгоритмика, хотя последнее уже спорно.
Плюс такого подхода – независимая эволюция API под каждый фронт. Мы можем менять BFF-слой, при этом общие бэковые методы остаются прежними. Если меняется протокол, достаточно изменить BFF, а бэк остается на месте.
Кроме того, упрощается фронтенд: там становится меньше сетевой и трансформационной логики.
Самая большая проблема – удержать BFF-слой именно в роли оркестратора и слоя трансформации данных. Если мы начинаем писать там бизнес-логику, это уже не BFF, а самостоятельная интеграция, которую опять придется дорабатывать отдельно.
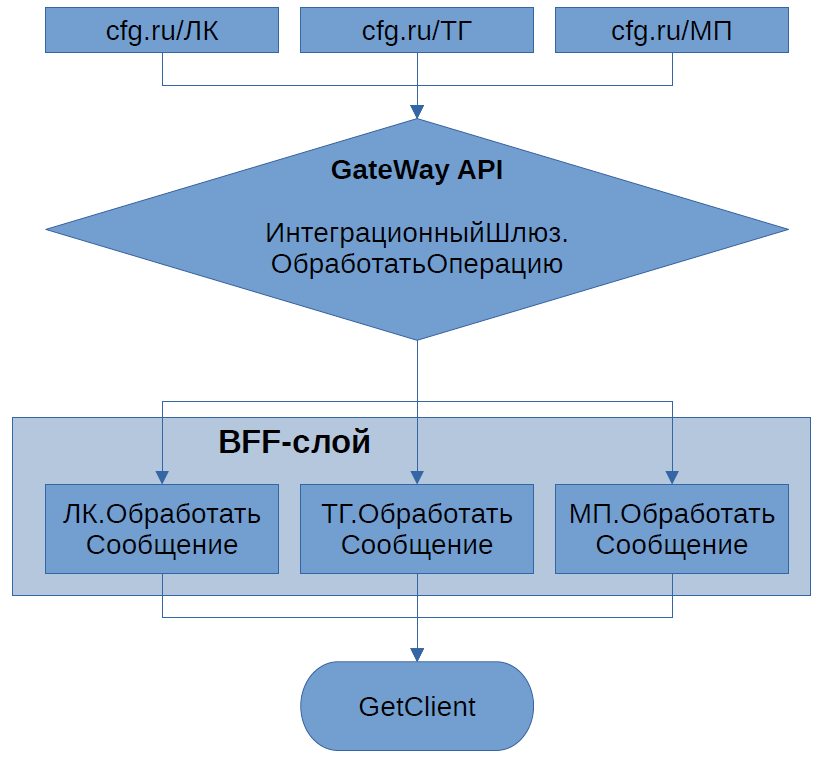
Схема прямых запросов выглядит следующим образом. Все потребители стучатся в одно место – в API GateWay.
В терминах 1С это один общий метод: ИнтеграционныйШлюз.ОбработатьОперацию. Все потребители приходят в этот метод.
Дальше он, исходя из потребителя, определяет, на какой BFF-метод нужно маршрутизировать запрос. Методы обработки сообщения есть в каждой подсистеме, в каждой интеграции. Они расположены в своих модулях и представляют собой тот самый BFF-слой.
Уже внутри этих методов вызывается единый GetClient, который возвращает одинаковые данные для всех потребителей. На уровне обработки сообщения происходит трансформация этих данных до состояния, которое нужно конкретному потребителю.
На выходе личный кабинет, мобильное приложение и Telegram-бот получат по-разному сформированные данные, но из базы они будут получены одним методом.
Какие сторонние технологии используются во всей этой системе?
Во-первых, брокеры сообщений. Это асинхронность и многопоточность. Мы используем и Kafka, и RabbitMQ. В любом случае все в итоге сходится в единый метод ИнтеграционныйШлюз.ОбработатьОперацию.
Что касается аутентификации, на стороне 1С мы ее пока не реализовали. Заглушка под токены есть. Интеграционный шлюз внутри 1С принимает токены, но сейчас мы с ними никак не работаем. При желании все это можно спокойно докрутить.
Мы используем внешний сервис, написанный командой интеграции, который аутентифицирует потребителей, находящихся за рамками нашего сетевого контура. Сама 1С наружу без этих сервисов и прокси у нас не смотрит.
Мониторинг тоже можно писать в 1С, но зачем, когда есть Prometheus и Grafana? Они прекрасно работают и у нас уже очень давно интегрированы. Для мониторинга этих процессов мы используем их же.
При этом без всех внешних компонентов система тоже может успешно работать, особенно во внутреннем контуре.
Например, у нас есть ИИ-агенты, которые не ходят через внешний API GateWay и не используют очереди. Они напрямую стучатся изнутри нашего контура в метод ОбработатьОперацию и получают оттуда необходимые данные в нужном им формате. Для них тоже есть собственный BFF-метод.
Как же это использовать?
Теперь переложим всю эту теорию паттернов проектирования на 1С и ее метаданные.
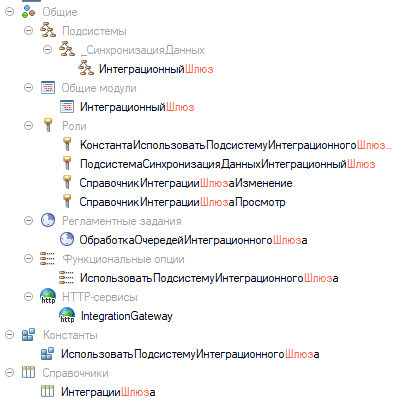
На изображении показаны общие объекты метаданных подсистемы, которые у нас заведены в 1С и которые при желании можно воспроизвести у себя. Набор достаточно простой.
На изображении не указаны BFF-модули для каждой отдельной интеграции. Есть только общий модуль «Интеграционный шлюз», куда все стекается.
Дальше для каждой интеграции создаются собственные общие модули с именем этой интеграции. В них уже происходит трансформация и оркестрация вызовов методов бэка.
Что касается алгоритма работы на стороне 1С, внешний потребитель может вызвать любой метод API напрямую и тем самым вызвать метод обработки сообщения той интеграции, откуда пришел запрос.
Строка вызова общая для всех. Сначала идет адрес публикации, где опубликован непосредственно API GateWay, затем имя модуля. Сейчас интеграция передается не в параметрах тела запроса, а прямо в строке HTTP-обращения. Строка вызова метода выглядит так:
https:
//<адрес публикации http-сервиса IntegrationGateway>
/<Имя модуля интеграции>
/<Имя метода API>
Пример:
~/gateway/ПрограммныйИнтерфейсДляАгентов/ChangeClientPhone
Для примера можно взять публикацию GateWay, API для агентов и метод ChangeClientPhone. Этот метод для агентов уходит в агентский BFF-слой и дальше вызывает общие методы бэка, которые меняют номер телефона клиента.
Такой же метод есть для личного кабинета и Telegram-бота, но все они в итоге выполняют на бэке одно и то же действие.
При этом у них могут быть разные входящие параметры, и каждый BFF-слой эти параметры учитывает.
Обработка входящих сообщений
Есть несколько нюансов обработки входящих сообщений, которые я считаю важными. В заметках к статье есть более полные листинги, здесь выделены ключевые моменты.
Первое – обязательно нужно сквозное логирование.
У нас есть correlation ID. Это ID, который мы генерируем в момент получения или перед отправкой сообщения по интеграции.
Этот correlation ID проходит через все этапы – как 1С, так и внешние системы – и фиксируется везде в логах.
Зная correlation ID конкретного события или сообщения, мы можем проследить весь его путь. Если проблема возникла где-то на транспорте, например сообщение застряло в RabbitMQ, мы увидим, где именно это произошло и какие были тайминги.
У нас были ситуации, когда сообщение было отправлено в одно время, а интеграция получала его через десять секунд. Для RabbitMQ это достаточно долго.
Мы начали искать проблему, нашли проблему с производительностью RabbitMQ, поправили ее, добавили новые ноды, перенастроили систему, и все стало работать нормально. За счет correlation ID такое расследование проводить очень просто.
Есть также X-Request-ID. Это тоже идентификатор сообщения, но внешний, полученный от клиента, то есть от интеграции.
Почему эти идентификаторы разделены? Потому что идентификаторы запросов разных клиентов могут пересекаться друг с другом: они формируются в разных системах совершенно независимо.
А correlation ID внутри нашей системы уникален.
Пара correlation ID и X-Request-ID позволяет проследить путь сообщения не только по нашему внутреннему контуру, но и по контуру партнера.
Кроме того, обязательно нужны замеры. Все входящие запросы у нас логируются через Prometheus и отображаются на дашбордах Grafana.
Мы сразу видим, какой метод сколько выполняется, где начинается деградация. Настроены алерты, чтобы оперативно реагировать, если где-то возникают проблемы.
Еще один важный момент – уровень логирования.
У нас он настраивается отдельно для каждой интеграции. В коде мы пишем логи достаточно часто, но то, будут они действительно записаны или нет, зависит от того, какой уровень логирования выбран в настройках конкретной интеграции.
Если стоит простой рабочий уровень, логируются только ошибки и исключения.
Если включена отладка, начинаем логировать тело запроса и практически каждый шаг.
Такой режим включается на 10 минут или на полчаса, после чего отключается обратно. По этим логам можно проследить весь путь выполнения, не заходя в прод и не включая обычную отладку.
Если заранее об этом подумать, такая схема позволяет очень быстро решать возникающие проблемы.
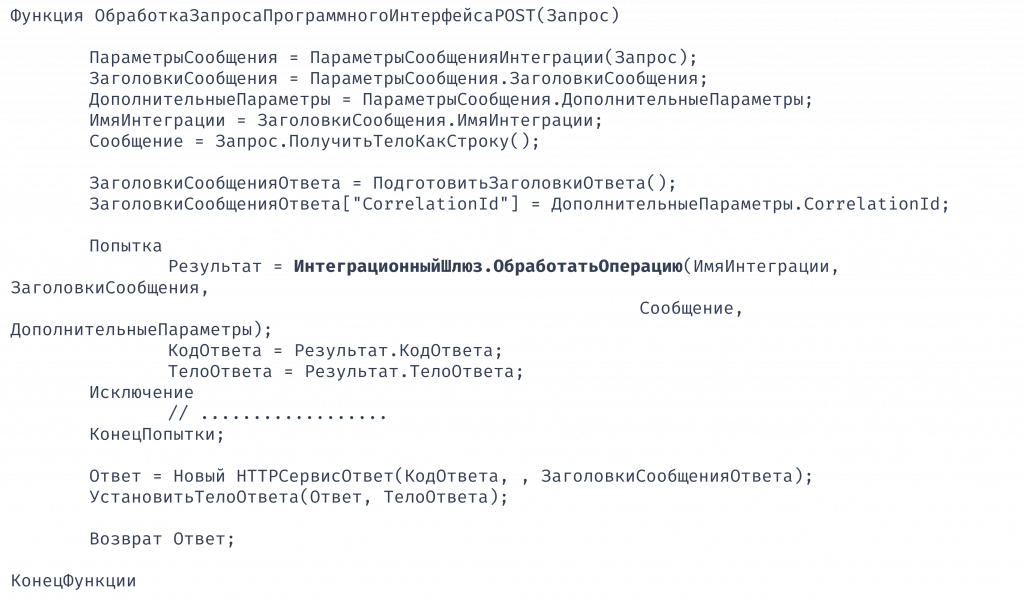
Пример метода на изображении – это прямой POST-запрос к HTTP-сервису интеграционного шлюза.
Он вызывает тот самый метод ИнтеграционныйШлюз.ОбработатьОперацию, который используется и при работе через очереди.
Один из ключевых моментов здесь – correlation ID. Это очень важная вещь, которая, как уже было сказано, позволяет расследовать проблемы.
Сам код достаточно простой. Нам нужны код ответа и тело ответа, а само тело формируется уже на уровне BFF. После этого сформированный ответ возвращается тому, кто выполнил запрос.
Алгоритм работы через очереди
Через очереди все работает следующим образом.
Есть общее регламентное задание – оркестратор, или управляющий поток, как мы его называем.
Для каждого предопределенного элемента справочника интеграций шлюза он запускает собственные дочерние потоки – слушатели очередей – на основании настроек конкретной интеграции.
В справочнике интеграций шлюза создаются предопределенные элементы, которые позволяют работать этой многопоточной системе.
Там настраивается количество потоков, размер, частота запуска, источники данных. Это может быть несколько очередей, их имена – все настраивается там.
Каждое фоновое задание слушает свою очередь.
Но в итоге все равно везде вызывается ИнтеграционныйШлюз.ОбработатьОперацию. Все всегда сходится туда. Именно в этом и заключается идея API GateWay.
При получении сообщения из очереди на основании переданных параметров оно отправляется в метод ОбработатьСообщение нужной интеграции, то есть непосредственно на BFF-слой.
Схема работы с очередями чуть сложнее схемы прямых запросов.
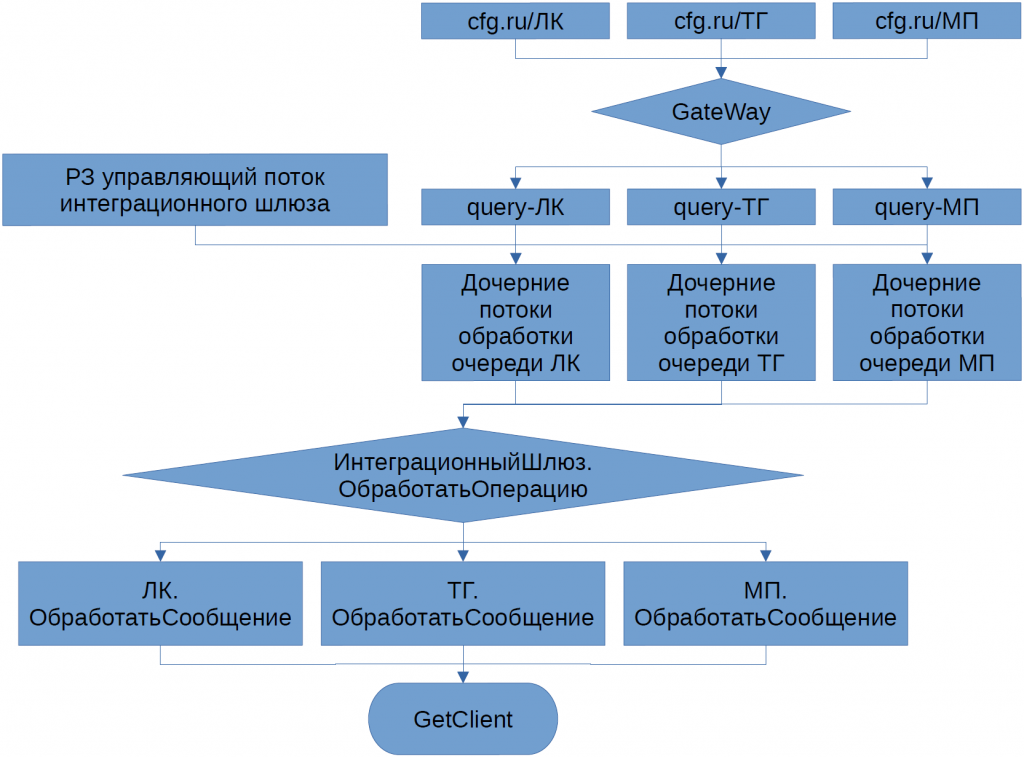
Здесь появляется еще один внешний API GateWay, написанный командой интеграции и находящийся во внешнем контуре, то есть смотрящий непосредственно в интернет.
Его задача такая же – маршрутизация в нужные очереди. Кроме того, он выполняет аутентификацию, поскольку в самой 1С мы ее пока не используем и нам достаточно внешнего сервиса.
Для внутренних нужд агенты пока вообще работают без аутентификации – в экспериментальном режиме.
Дальше работает тот самый управляющий поток-регламент, который поднимает дочерние потоки. Каждый из них обрабатывает свои очереди.
После получения сообщения из очереди во всех потоках и во всех интеграциях вызывается ИнтеграционныйШлюз.ОбработатьОперацию.
Внутри интеграционного шлюза выполняется маршрутизация на BFF-слой, на обработку сообщения конкретной интеграции.
На бэке при этом остается единый метод GetClient, который возвращает одинаковые данные для всех потребителей. Преобразование происходит уже на уровне обработки сообщения.
Это и есть та самая единая точка – API GateWay.
Как уже говорилось, токены мы получаем, но пока не используем.
Под них есть заглушки и готовые обязательные методы, но ни в одной интеграции мы пока эти токены не проверяем.
ИнтеграционныйШлюз.ОбработатьОперацию
Метод ОбработатьОперацию – это как раз метод интеграционного шлюза и та самая единая точка.

Если токены приходят, мы их получаем так, как это определено в подсистеме вызываемой интеграции, после чего вызываем ОбработатьСообщение этой же подсистемы.
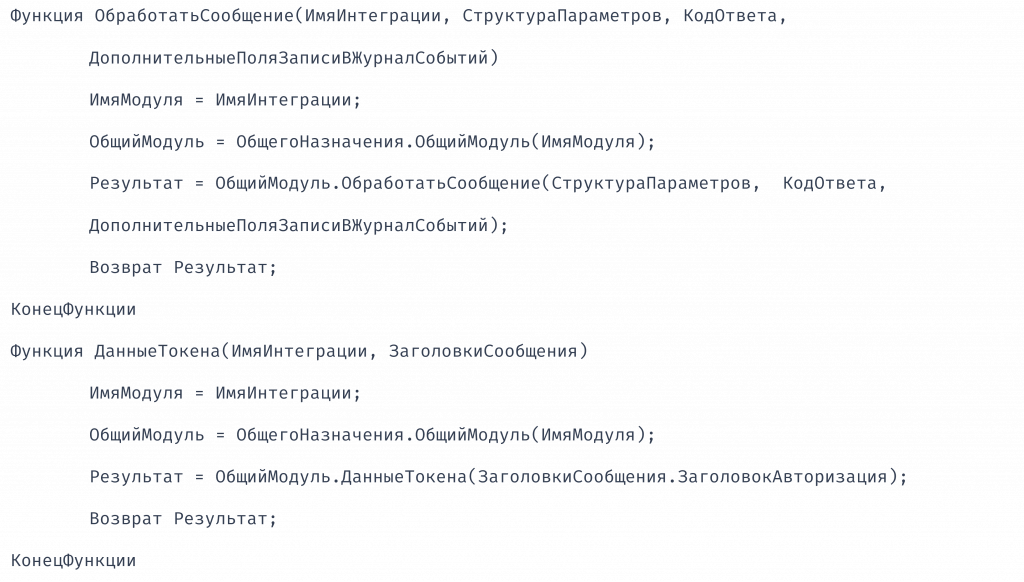
В каждом модуле BFF-слоя для каждой интеграции есть два метода: ОбработатьСообщение и ДанныеТокена.
Это единственные обязательные методы, которые нужны для того, чтобы вся система работала.
Добавление новой интеграции (без очередей)
Если новая интеграция работает без очередей, все достаточно просто.
Мы создаем в справочнике «Интеграционный шлюз» новый предопределенный элемент, затем создаем общий модуль с таким же названием.
В нем определяем два метода: обработку сообщения и данные токена с установленными параметрами. В интеграционном шлюзе также есть конструктор структуры одного из параметров.
С технической точки зрения на этом все.
Дальше начинается бэковая логика. То, как будет организована работа с ней, уже определяется на BFF-слое и зависит от сложности конкретной бизнес-задачи.
Именно технически добавление новой интеграции выглядит как три простых шага.
HTTP-сервис при этом уже опубликован и остается единым.
Как только создан предопределенный элемент, общий модуль и изменения выкачены на прод, внешний потребитель уже может использовать новую интеграцию.
Если добавляются новые методы для уже существующего клиента, это можно делать даже расширением, если в справочнике интеграций шлюза уже есть предопределенный элемент для этого клиента.
Просто выкатываются новые методы. Как только расширение подключено, клиент может ими пользоваться.
Это делается очень быстро и легко.
Добавление новой интеграции (с использованием очередей)
Новая интеграция с очередями сначала добавляется точно так же, но затем нужно настроить RabbitMQ: привязки, биндинги, имена слушателей, уровень логирования.
У нас новые очереди сейчас создаются так, что для этого даже не нужно ходить к администраторам.
Очереди создаются через изменения файлов в Git.
Есть файл, в котором описаны все очереди, и они разворачиваются на основании этого файла настроек.
Добавили еще одну очередь, указали название, описали ее, запушили изменения в Git, запустили pipeline развертывания – очередь появилась, можно пользоваться.
Итого
Внедрение подсистемы выполняется достаточно просто. Она небольшая, обязательного кода там мало.
Бэковую логику мы здесь не рассматриваем, потому что речь именно о транспортном слое и слое трансформации и оркестрации.
Бэковая логика – отдельная история. Как будет устроен программный интерфейс бэка, какие будут бизнесовые методы, как они будут скомпонованы – это уже совершенно другой вопрос.
Если бизнес-логика для какого-то действия уже реализована и нужно просто дать возможность использовать это действие новой интеграции, такая задача делается примерно за полчаса даже джуном.
Операции там простые, особенно думать не нужно: сделать несколько стандартных шагов, вызвать нужный метод, посмотреть формат и трансформировать полученные бэковые данные в нужный формат на BFF-слое, после чего отдать их наружу.
Сейчас один из тимлидов занимается подключением к нашей основной конфигурации подсистемы MCP, чтобы при добавлении новых методов API нам не приходилось отдельно учить агентов этим методам.
Если все описывать в MCP, то при добавлении метода в 1С агент сам получит описание из MCP-подсистемы и начнет им пользоваться.
Есть небольшой практический кейс.
У техподдержки была задача сделать через агентов активацию и деактивацию пользователей.
На уровне 1С у них уже есть обработка, в которой вводятся пользователи и нажимается кнопка «Активировать» или «Деактивировать», например при увольнении сотрудника.
Задача решается чуть дольше, потому что существует legacy-обработка. Но в целом подход очень простой.
Нужно вынести код этой обработки и сделать его экспортным, чтобы тот же алгоритм был доступен внутри конфигурации. Затем завести новый метод. Интеграция для агентов уже существует на уровне интеграционного шлюза и BFF-слоя. После этого можно делать агента.
Реально это занимает один-два часа: вынести существующий функционал, сделать его доступным наружу и подключить через шлюз.
То есть выдача агенту какого-то функционала, который уже существует в 1С, выполняется буквально за часы.
Этот кейс достаточно быстро реализовал джун-разработчик. Он посидел немного дольше, но тем не менее задача получилась простой.
Это очень удобно и быстро. Когда у какого-то отдела возникает потребность автоматизировать через агентов то, что сотрудники уже делают вручную, а мы сейчас очень активно развиваем агентскую систему на n8n, такая задача решается легко.
Чего не хватает?
На мой взгляд, сейчас нашей подсистеме не хватает прежде всего контроля аутентификации.
Внешний сервис – это хорошо, но далеко не у всех есть команда интеграции, которая может написать внешний механизм аутентификации и использовать его.
Если 1С опубликована наружу и к ней напрямую подключаются внешние клиенты, аутентификация становится важной. В этом случае на уровне интеграционного шлюза нужно дорабатывать проверку токенов.
Токены мы уже получаем, но пока никак не проверяем. Значит, нужны проверка токенов и их хранение.
MCP для ИИ-агентов, как уже говорилось, пока подключается у нас только в пилотном режиме.
В дальнейшем он еще сильнее ускорит подключение и добавление новых методов для агентов.
Добавляется новый метод, описывается в протоколе MCP, и агент учится им пользоваться. То есть чат-бот буквально через несколько минут после того, как расширение с этим методом выкачено и доработано описание MCP, уже может использовать новый метод. Через чат его уже можно просить выполнять соответствующие действия, если чат-бот подключен к 1С.
Еще один вопрос – мониторинг и дашборды.
Конечно, все это можно реализовать в самой 1С. Я видел интересные решения, где мониторинг делают непосредственно внутри 1С, например у СДЭК реализованы дашборды в 1С.
Но если уже есть готовые инструменты вроде Grafana и Prometheus для замеров, возникает вопрос, нужно ли обязательно делать все внутри одной системы.
Мы к такому подходу не стремимся. Мы используем для каждой задачи инструменты, которые именно под нее и созданы.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAM EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

